这是一篇专门针对 Jimeng (积木/积梦) 中文文生图模型的详细部署教学博客。包含了我们在实战中遇到的所有"坑"及其解决方案,特别是针对库版本冲突的硬核修复。
1. 什么是 Jimeng?
Jimeng 是由阿里巴巴达摩院研发的、专门针对中文语境优化的文生图模型。它将中文 BERT 与 Stable Diffusion 架构深度结合,无需繁琐的英文翻译,直接输入中文(如"古风、水墨、赛博朋克")即可生成极具东方审美的高质量图像。
2. 部署环境准备
在开始之前,请确保你的机器拥有 NVIDIA GPU(建议显存 8GB 以上)并安装了 Python 3.8+ 环境。
2.1 安装核心依赖库
除了基础的 AI 框架,我们还需要安装阿里云的 oss2 库(用于后续可能的图片云端存储)以及处理库版本冲突所需的补丁工具。
bash
# 升级基础 AI 库
pip install -U modelscope transformers diffusers accelerate torch numpy pillow

# 安装阿里云 OSS 存储库
pip install oss2

# 安装 omegaconf 用于处理特定的模型配置
pip install omegaconf
3. 核心技术痛点:处理版本冲突
注意! 这是部署 Jimeng 模型最关键的一步。由于模型发布较早,它调用的 huggingface_hub 旧版函数 cached_download 在新版库中已被删除。如果不处理,程序会报错 ImportError。
解决方案: 在脚本的最开头手动注入"运行时补丁"。
4. 编写测试脚本
我们将创建一个名为 test_jimeng.py 的脚本。它不仅解决了兼容性问题,还支持一次加载模型、多次交互生成,并具备极强的代码健壮性。
4.1 创建工作目录
bash
mkdir -p ~/workspace/Jimeng && cd ~/workspace/Jimeng4.2 编写 test_jimeng.py
请将以下代码完整复制到文件中:
python
import huggingface_hub
try:
    from huggingface_hub import hf_hub_download
    huggingface_hub.cached_download = hf_hub_download
except ImportError:
    pass

import os
import torch
import numpy as np
from PIL import Image
from modelscope.pipelines import pipeline
from modelscope.utils.constant import Tasks

model_id = 'damo/multi-modal_chinese_stable_diffusion_v1.0'

try:
    print(f"正在启动 Jimeng 引擎并加载权重...")
    # 强制在 GPU 运行
    pipe = pipeline(Tasks.text_to_image_synthesis, model=model_id, device='cuda')

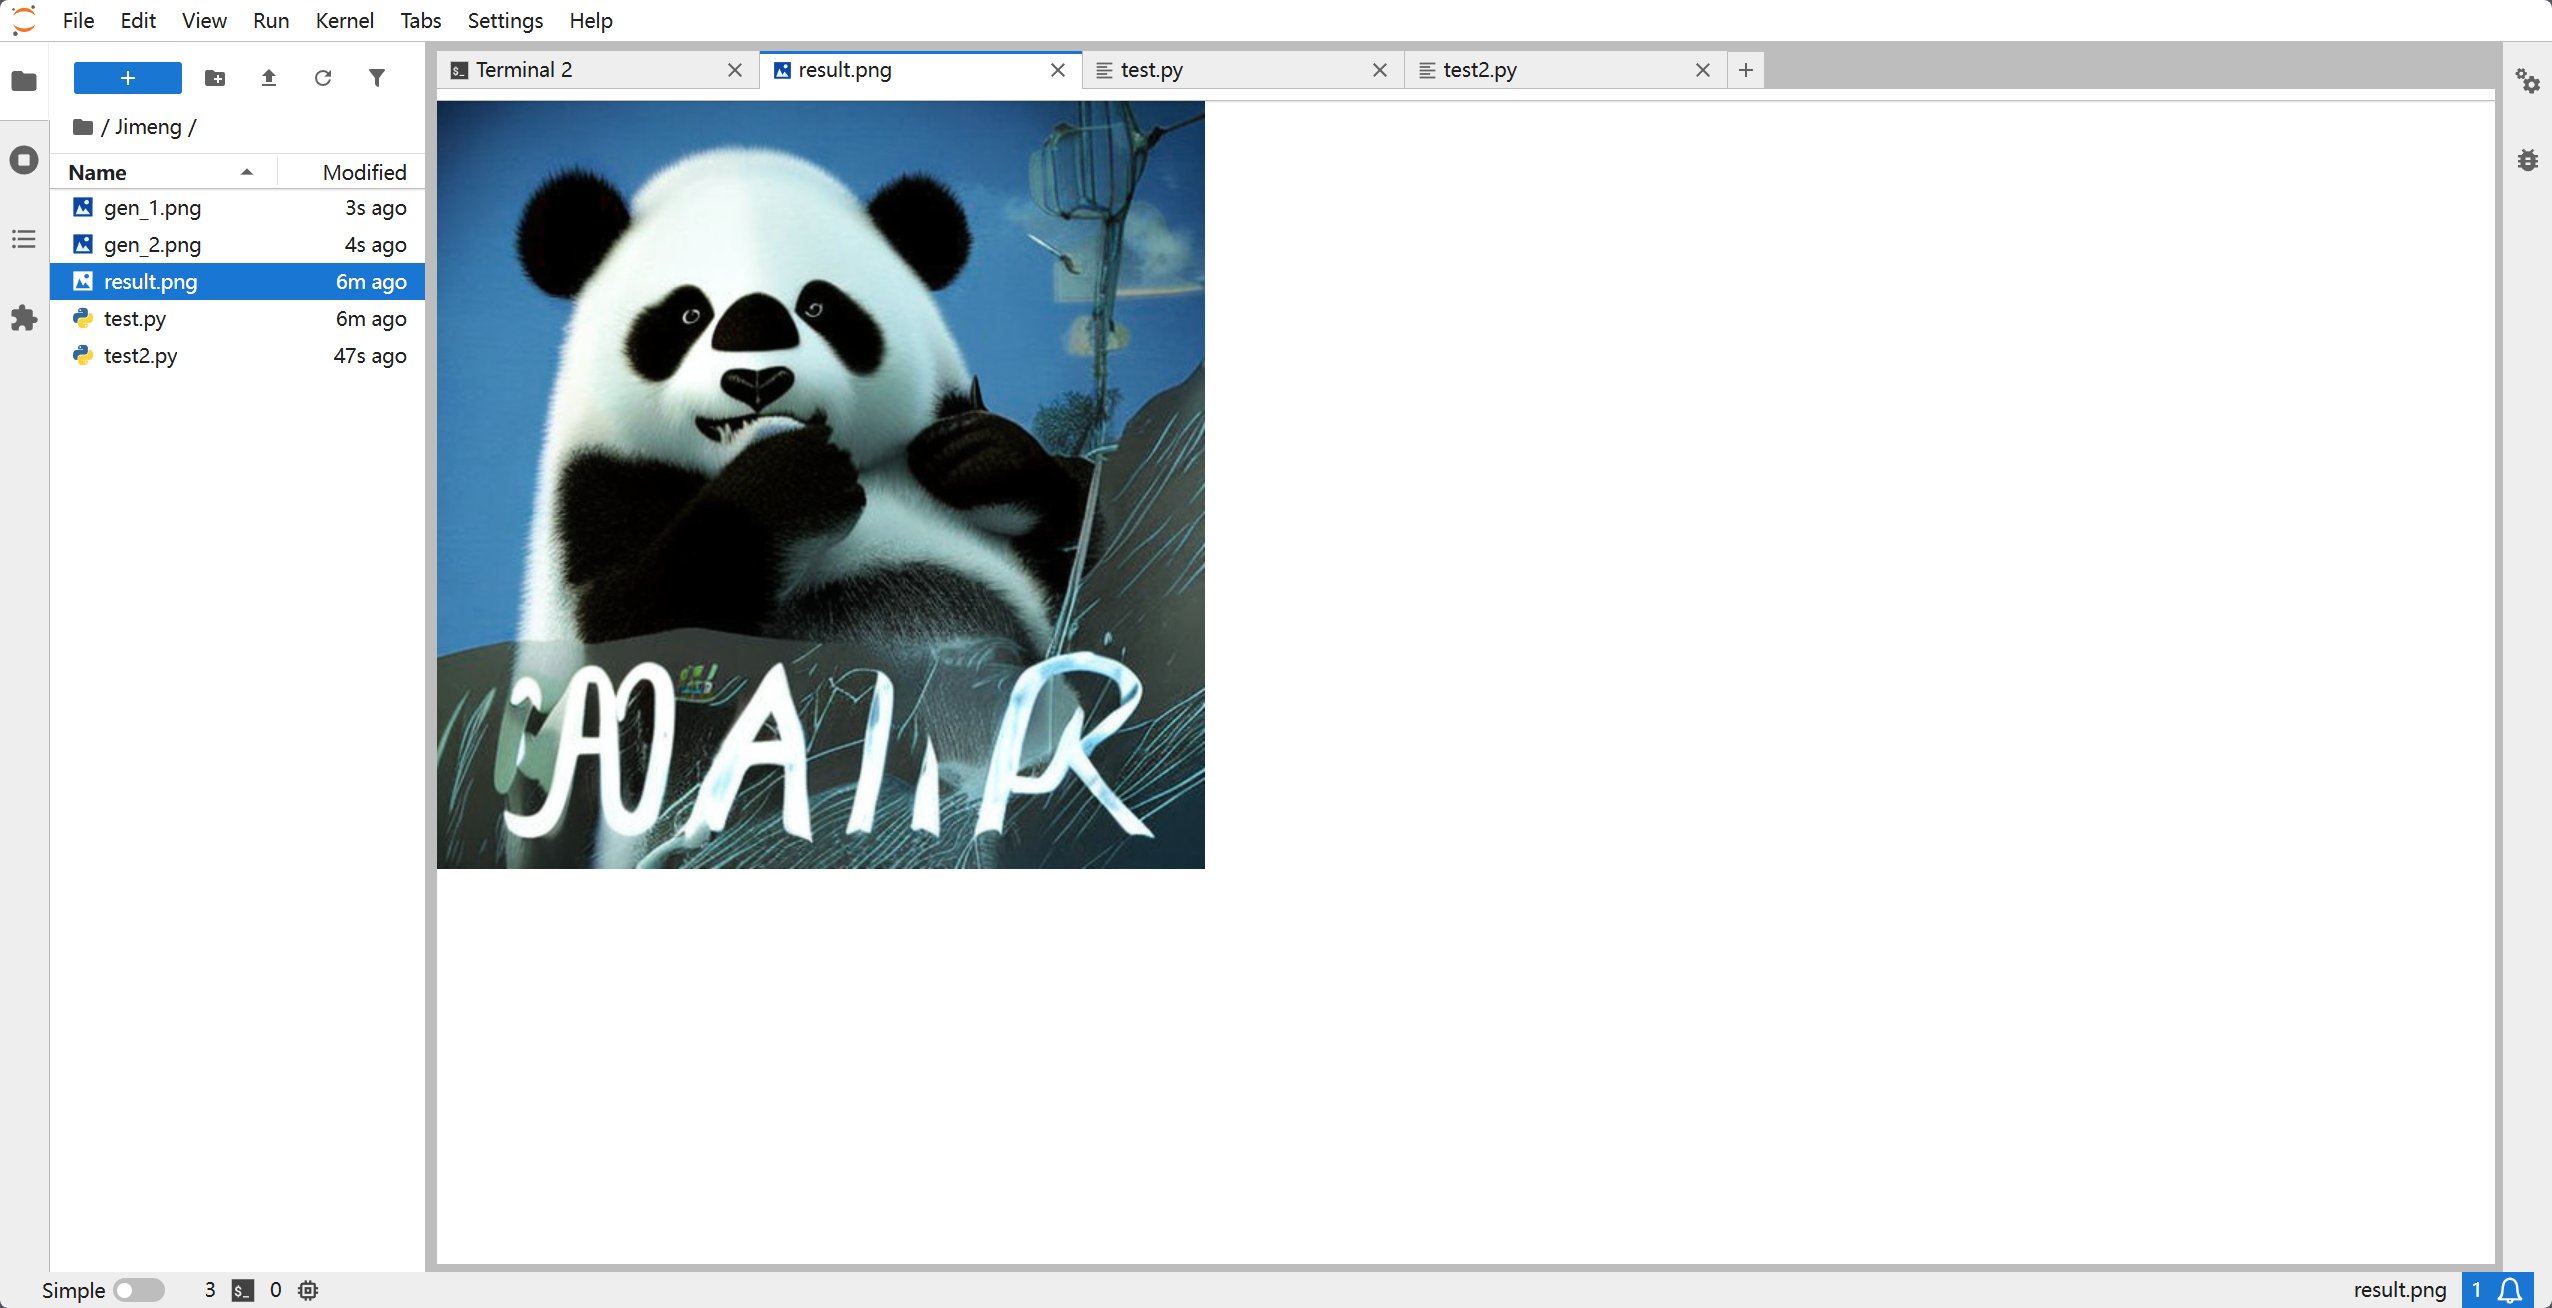
    input_data = {'text': '一个穿着宇航服的大熊猫在月球上吃竹子,赛博朋克风格'}

    print("正在生成图像...")
    output = pipe(input_data)

    # --- 修复逻辑:安全提取并转换图片 ---
    raw_data = None
    if isinstance(output, dict):
        for key in ['output_img', 'output_imgs', 'image', 'images']:
            if key in output:
                raw_data = output[key]
                break
    else:
        raw_data = output

    # 处理列表情况
    if isinstance(raw_data, list):
        raw_data = raw_data[0]

    # 关键修复:使用 is not None 避免真值歧义错误
    if raw_data is not None:
        # 如果是 numpy 数组,转换为 PIL Image
        if isinstance(raw_data, np.ndarray):
            # 如果数组值在 0-1 之间,缩放到 0-255
            if raw_data.max() <= 1.0:
                raw_data = (raw_data * 255).astype(np.uint8)
            final_image = Image.fromarray(raw_data)
        else:
            final_image = raw_data

        final_image.save("result.png")
        print(f"\n恭喜!生成成功。图片已保存至: {os.path.abspath('result.png')}")
    else:
        print("未能在输出中找到图像数据。")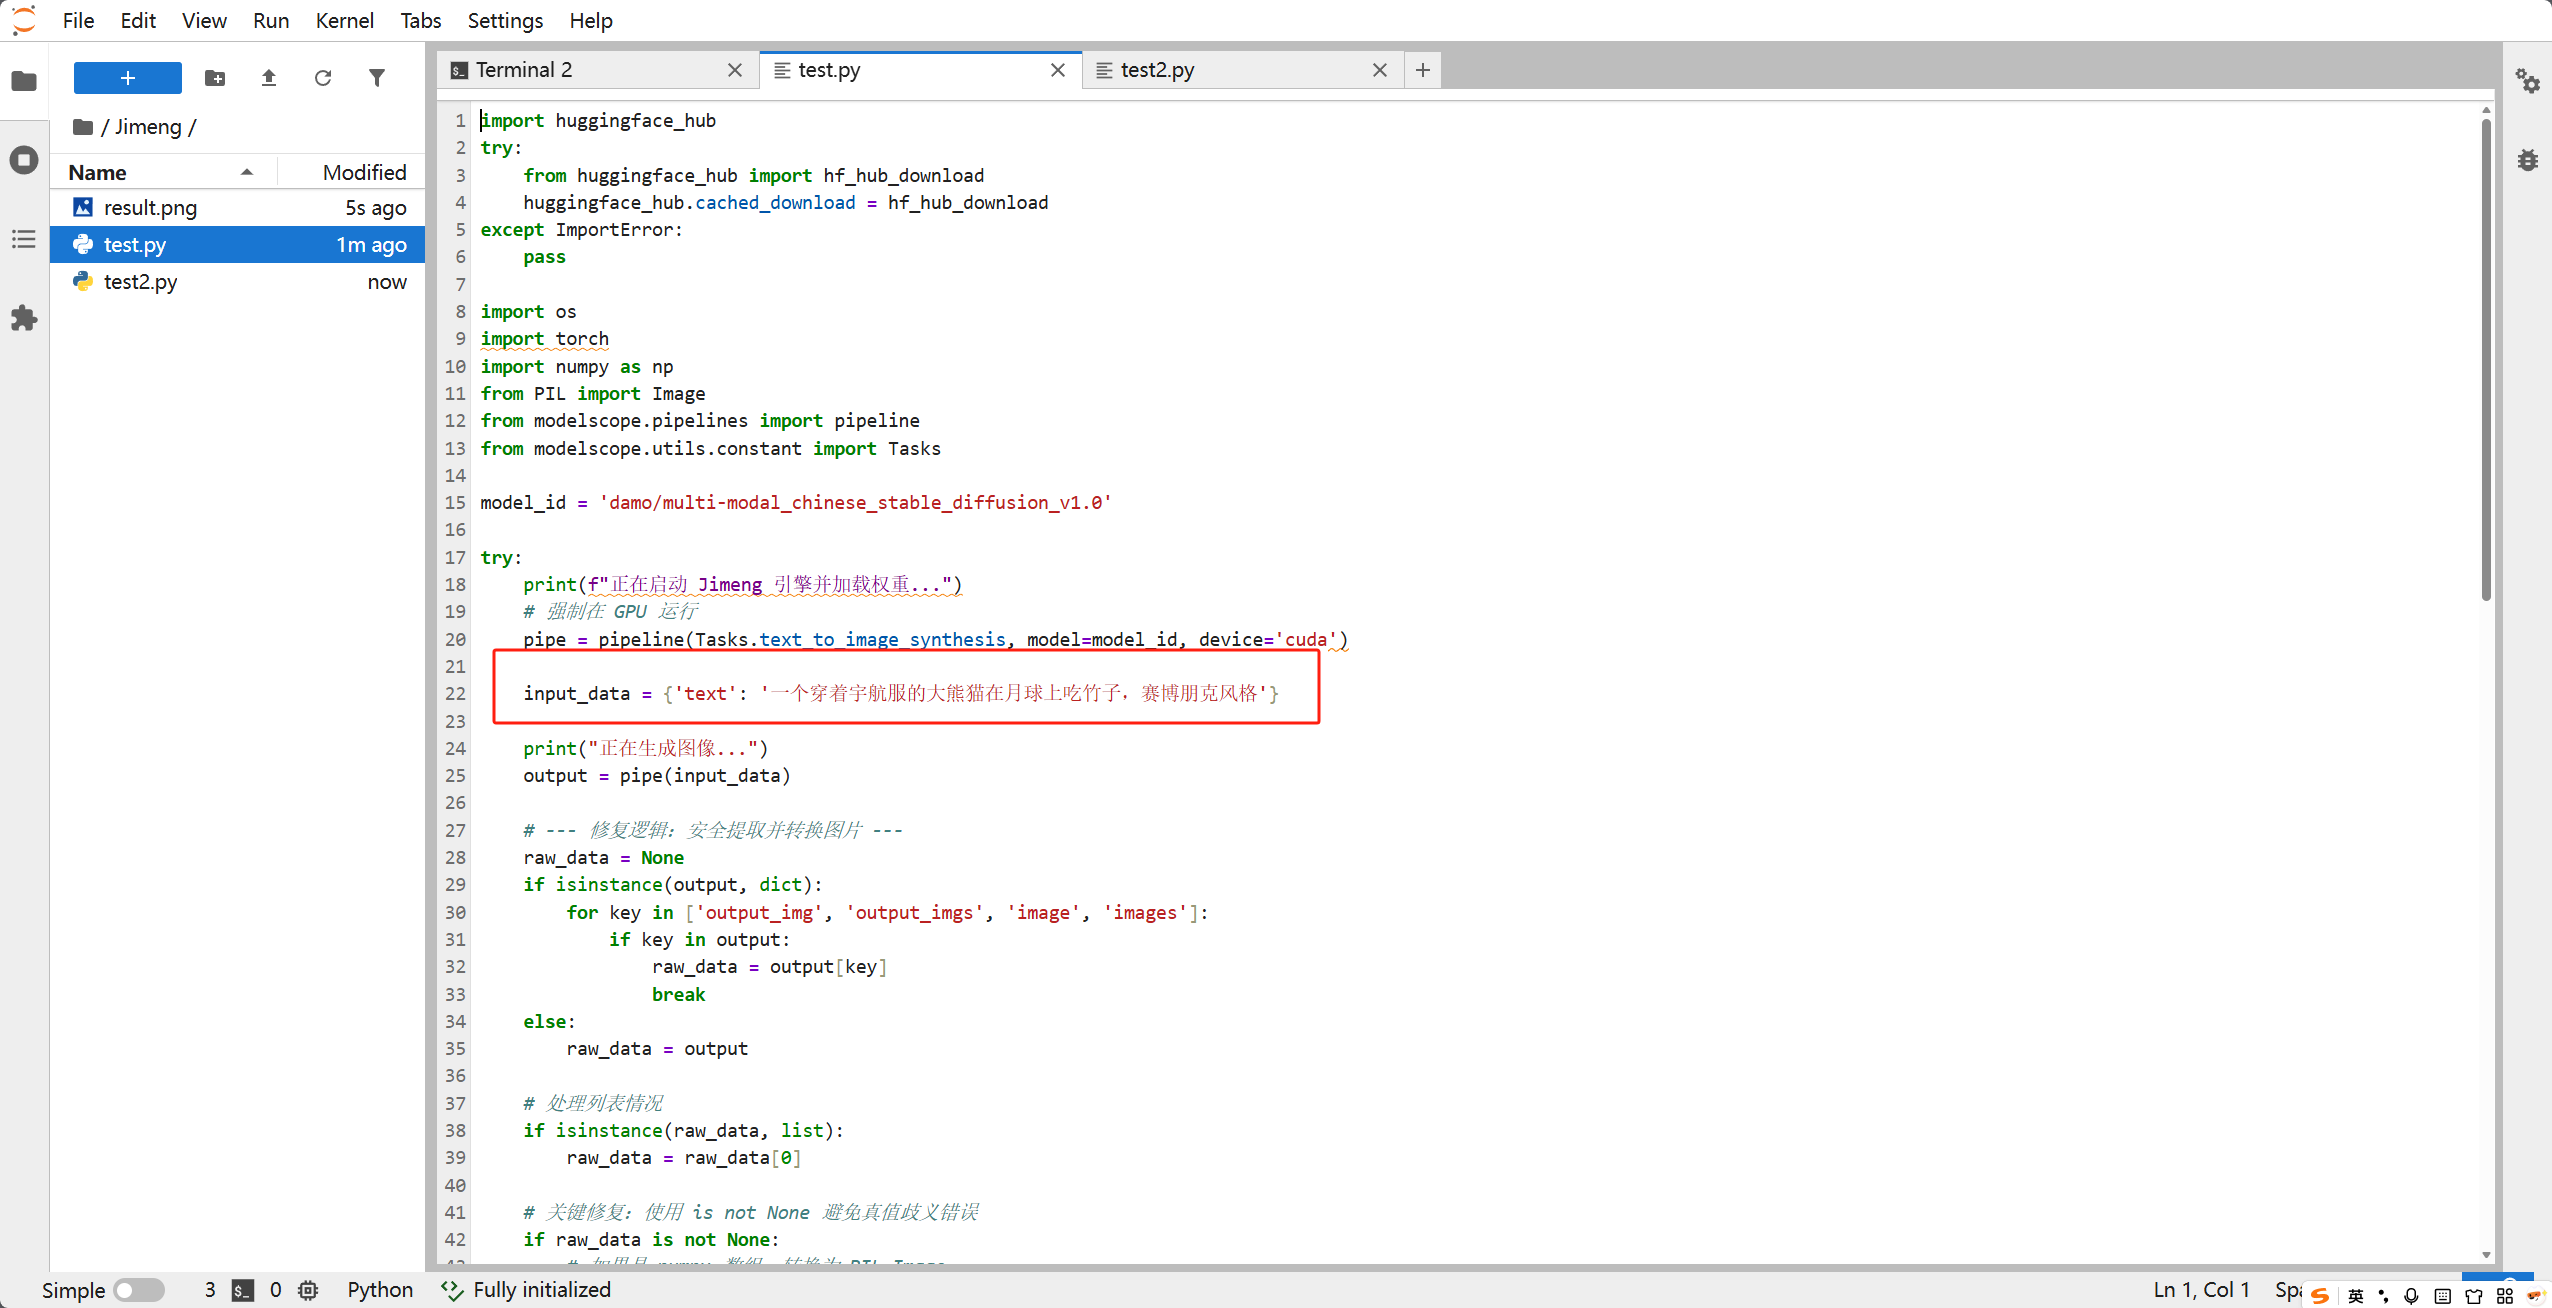
4.3 运行与测试
执行以下命令启动系统:
bash
python test_jimeng.py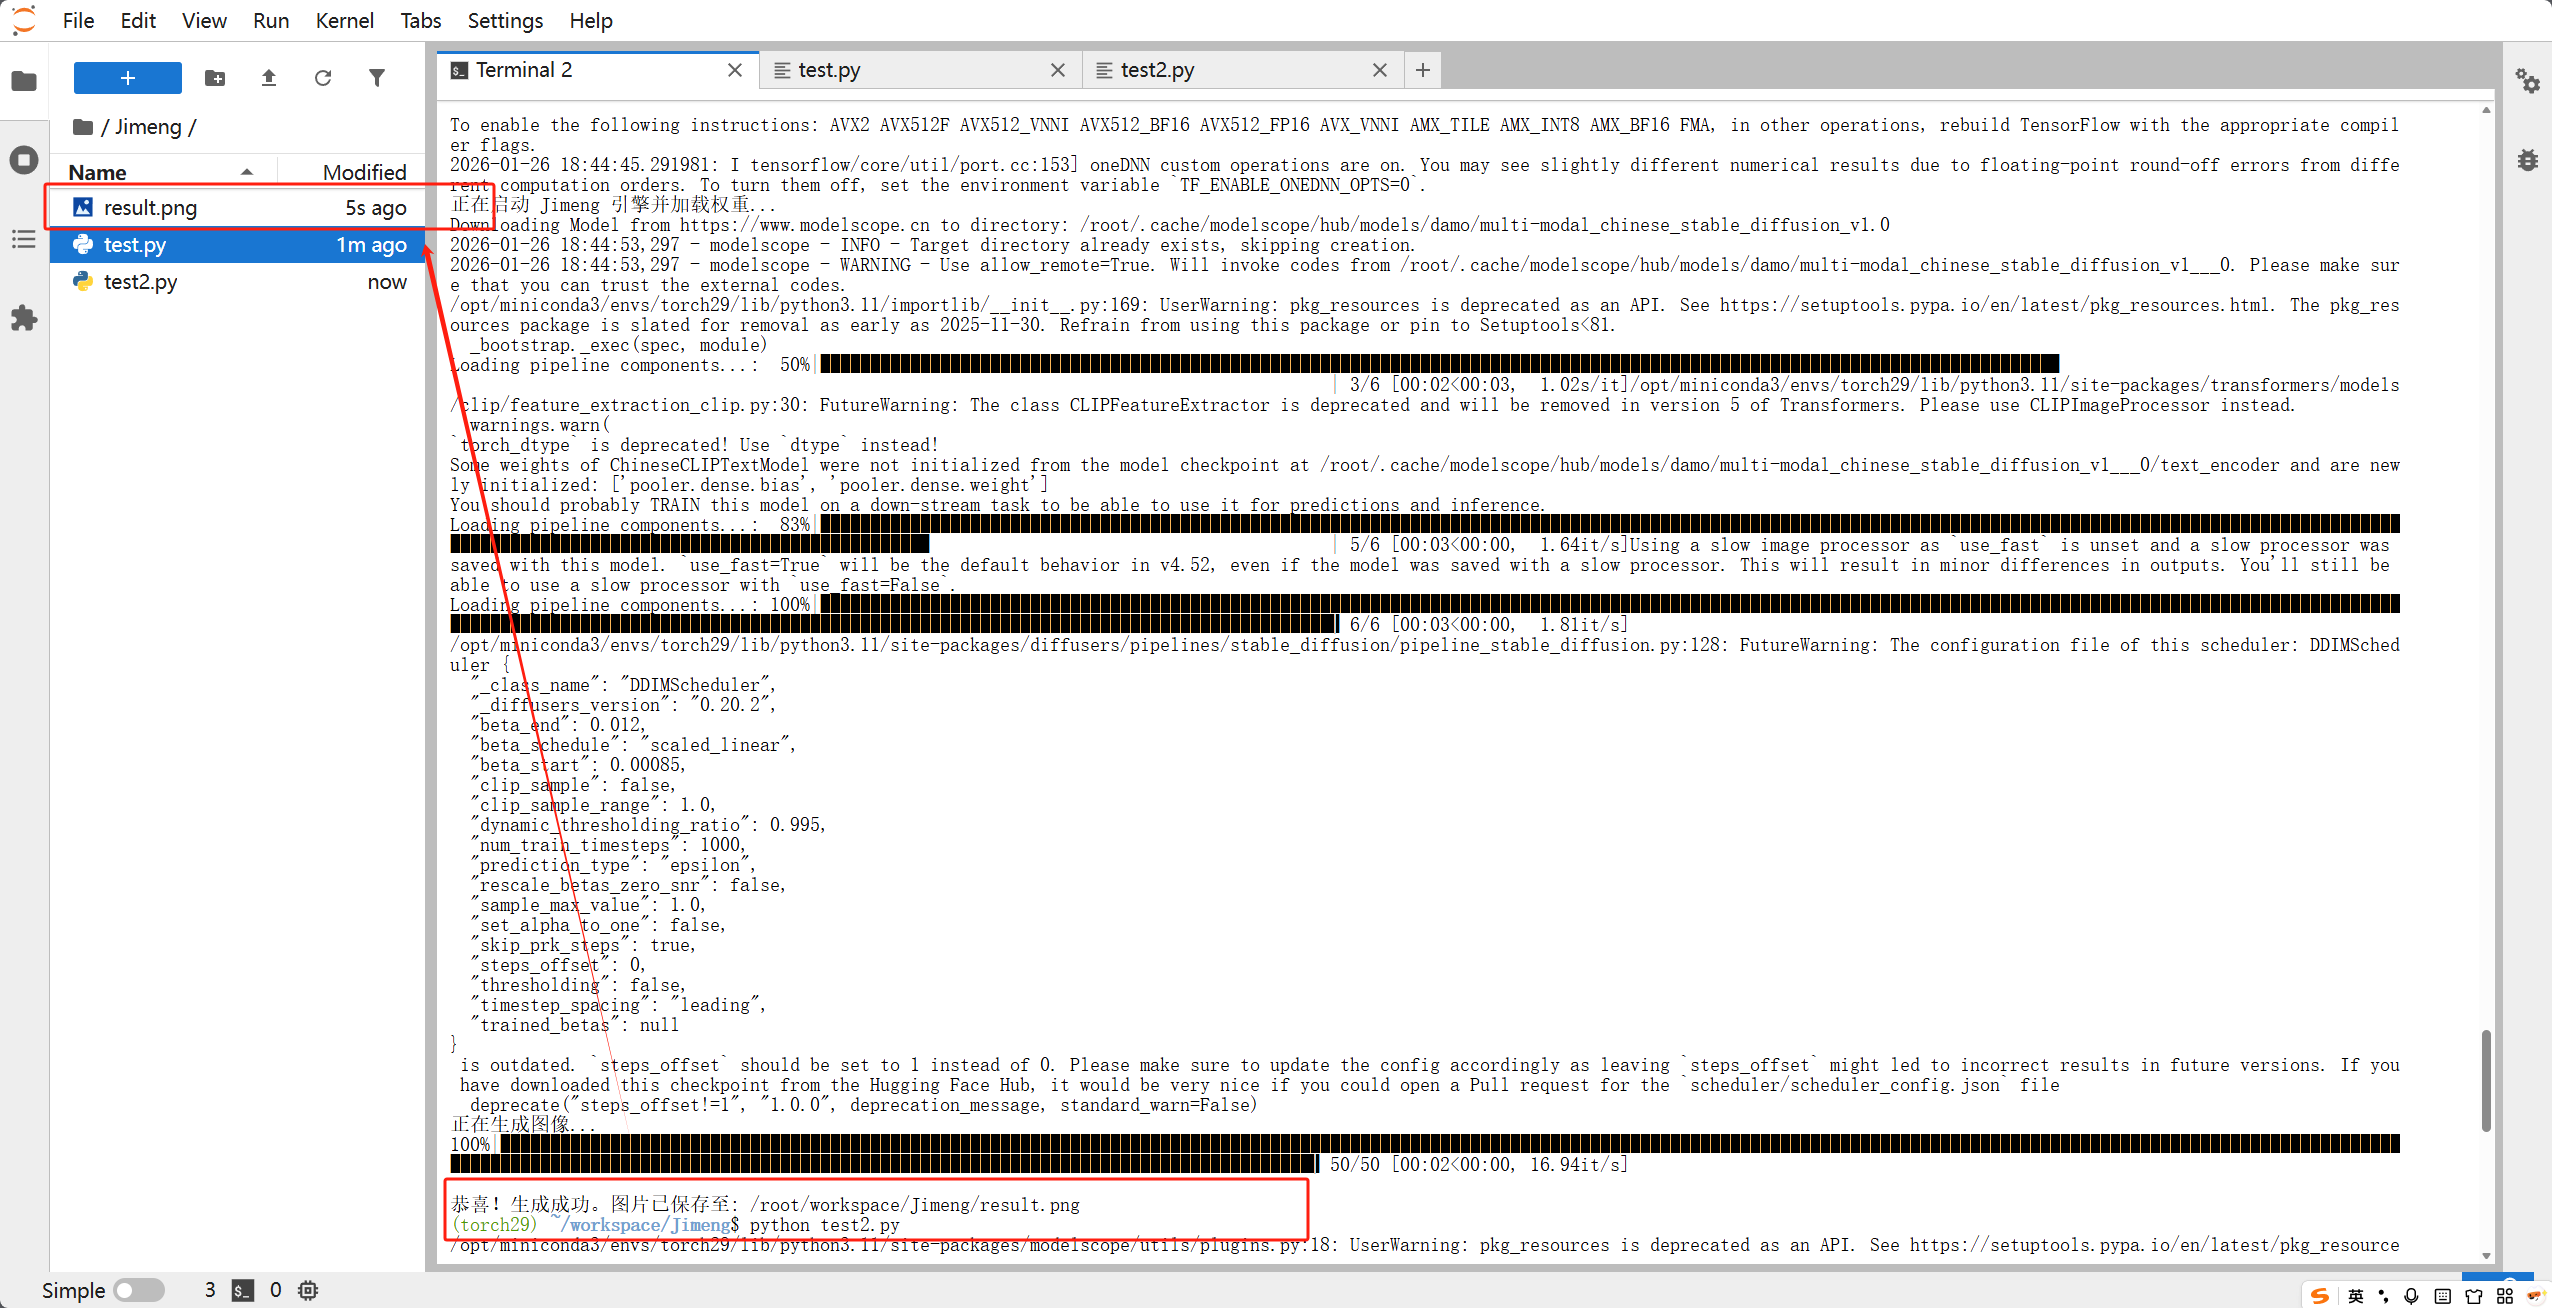
5. 编写交互式使用脚本
python
import huggingface_hub
try:
    from huggingface_hub import hf_hub_download
    huggingface_hub.cached_download = hf_hub_download
except: pass

import os
import torch
import numpy as np
from PIL import Image
from modelscope.pipelines import pipeline
from modelscope.utils.constant import Tasks

print("正在初始化 Jimeng 交互引擎,请稍候...")
model_id = 'damo/multi-modal_chinese_stable_diffusion_v1.0'

# 显式指定任务和设备
pipe = pipeline(Tasks.text_to_image_synthesis, model=model_id, device='cuda')

print("\n" + "="*50)
print("  Jimeng 中文文生图交互系统已就绪!")
print("  输入描述开始创作,输入 'exit' 退出。")
print("="*50)

count = 1
while True:
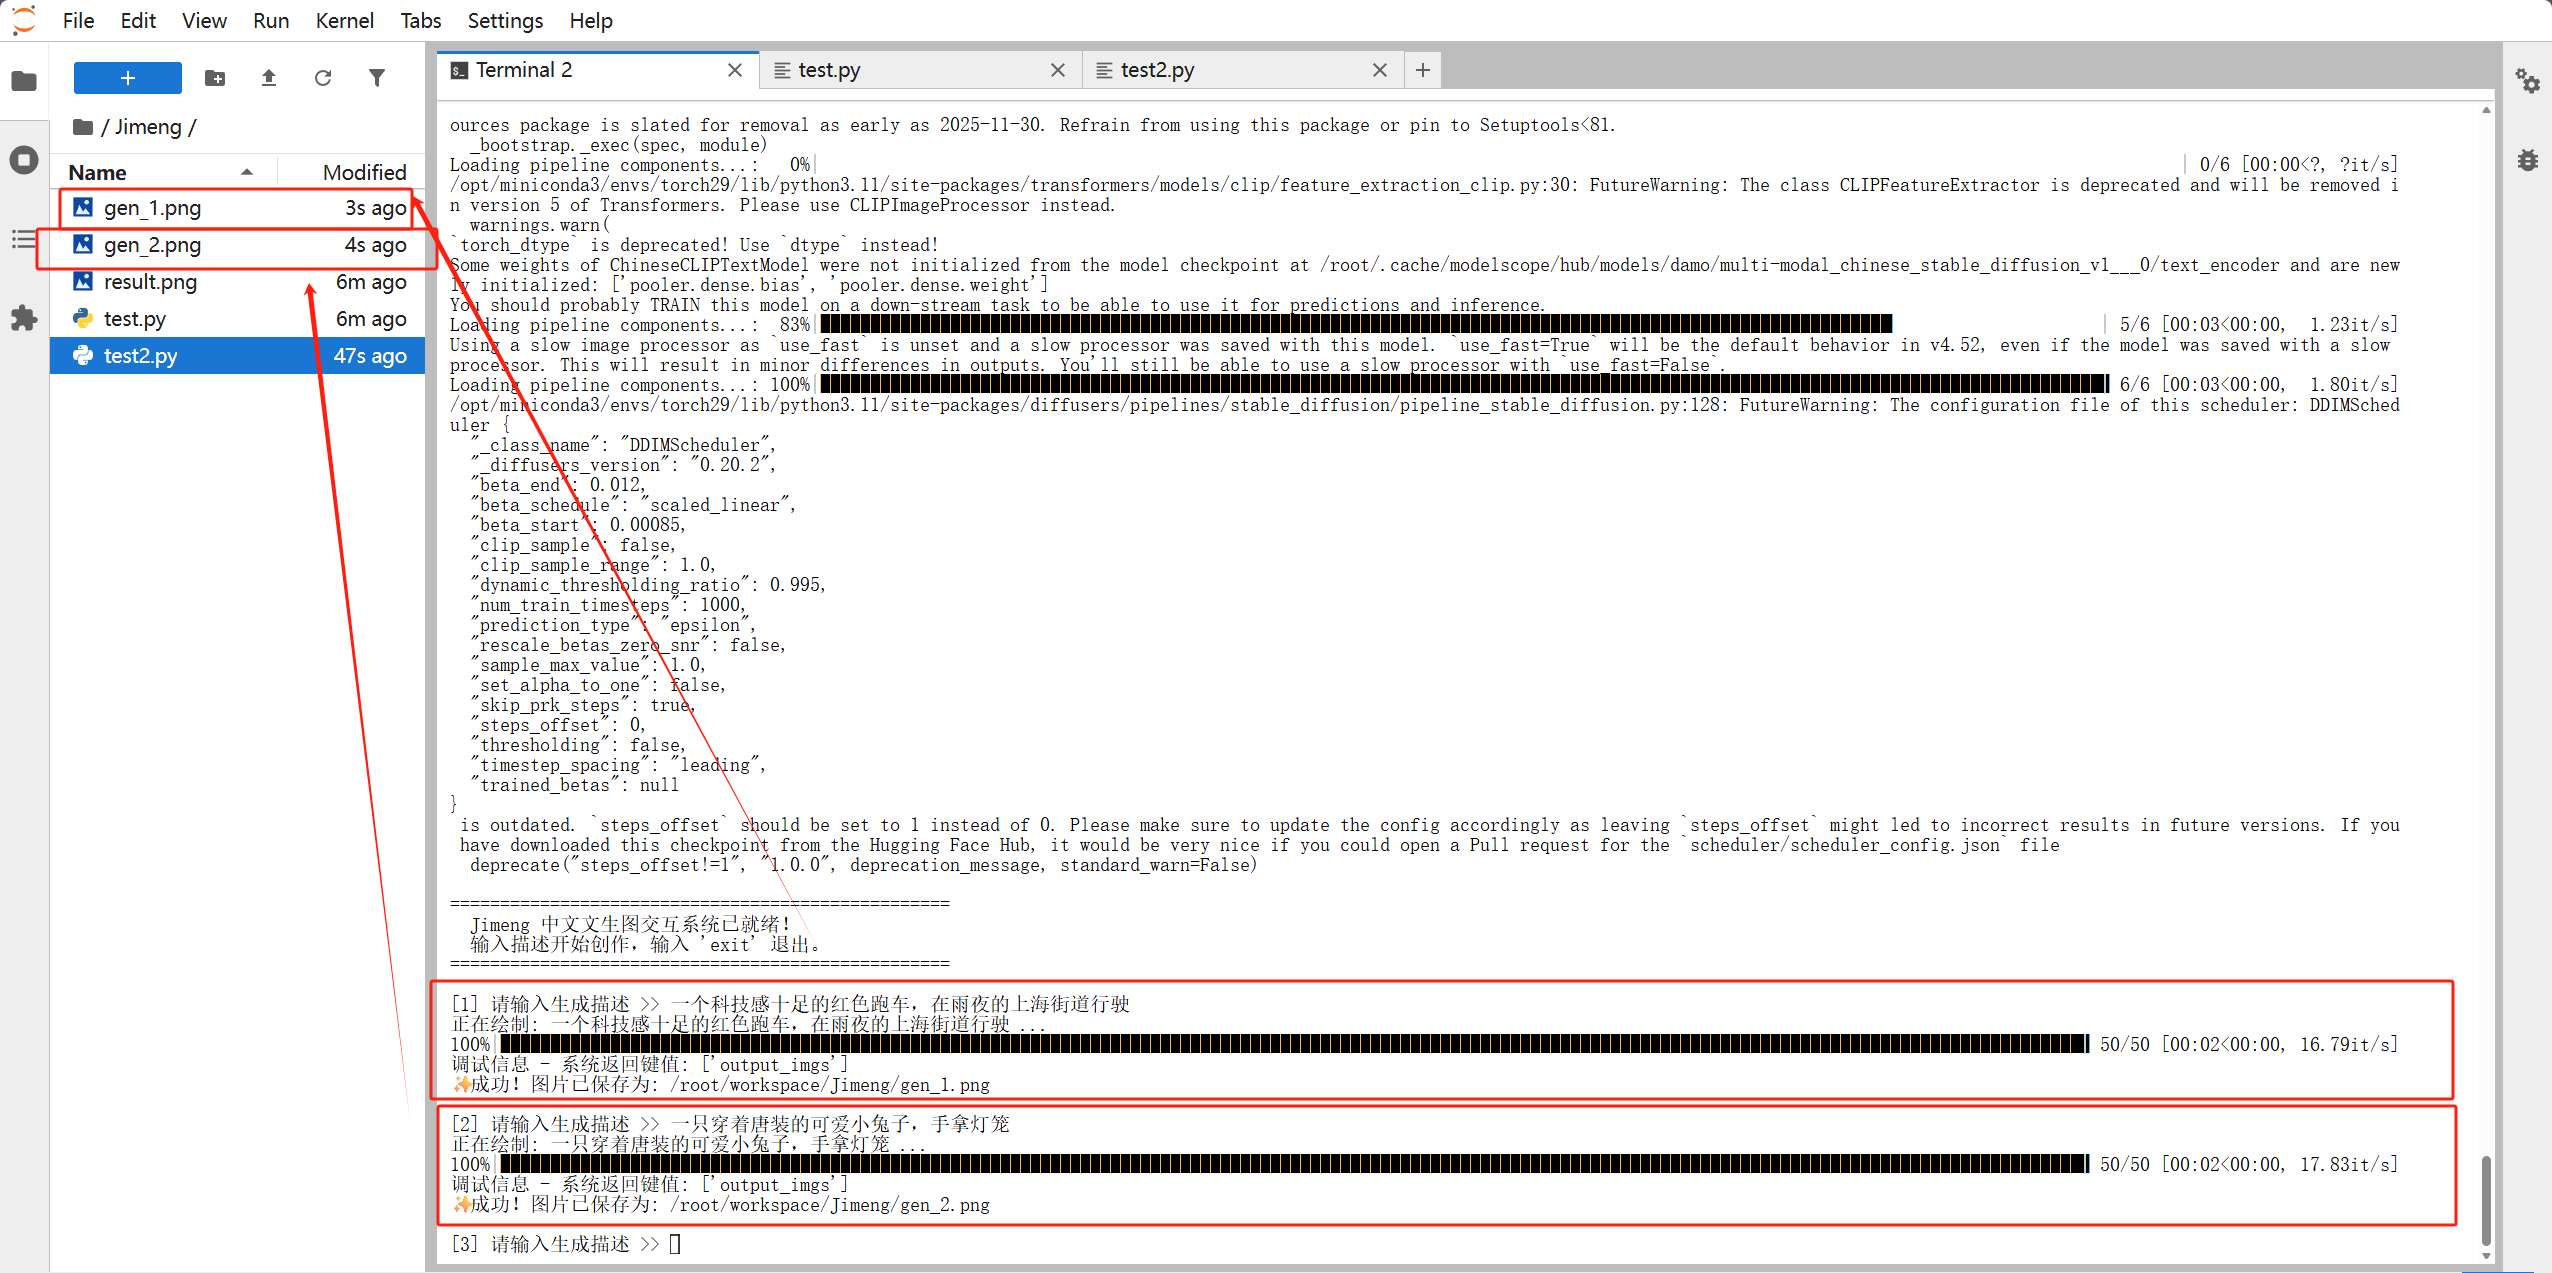
    prompt = input(f"\n[{count}] 请输入生成描述 >> ").strip()

    if prompt.lower() in ['exit', 'quit', '退出']:
        break
    if not prompt: continue

    print(f"正在绘制: {prompt} ...")
    try:
        # 推理
        output = pipe({'text': prompt})

        # --- 健壮的图片提取逻辑 ---
        image = None

        # 情况 A: 返回的是字典
        if isinstance(output, dict):
            print(f"调试信息 - 系统返回键值: {list(output.keys())}")
            # 尝试所有可能的键
            for key in ['output_img', 'output_imgs', 'image', 'images']:
                if key in output:
                    image = output[key]
                    break
            # 如果字典里只有一个值,尝试直接取那个值
            if image is None and len(output) == 1:
                image = list(output.values())[0]

        # 情况 B: 直接返回了对象或列表
        else:
            image = output

        # 如果提取出来的是列表,取第一个
        if isinstance(image, list):
            image = image[0]

        # 转换为 PIL 格式并保存
        if image is not None:
            # 如果是 Numpy 数组,转为 Image 对象
            if isinstance(image, np.ndarray):
                if image.max() <= 1.0: image = (image * 255).astype(np.uint8)
                image = Image.fromarray(image)

            filename = f"gen_{count}.png"
            image.save(filename)
            print(f"✨  成功!图片已保存为: {os.path.abspath(filename)}")
            count += 1
        else:
            print("❌  错误:未能从模型输出中提取到图像数据。")

    except Exception as e:
        print(f"💥  生成过程出错: {e}")

print("系统已退出。")
推荐测试词:
一只穿着汉服的可爱小熊猫,在竹林里喝茶,水墨画风格赛博朋克风格的西安钟楼,霓虹灯光,雨夜,电影质感唯美古风,一位仙女在月光下的荷塘起舞,高画质,精致五官
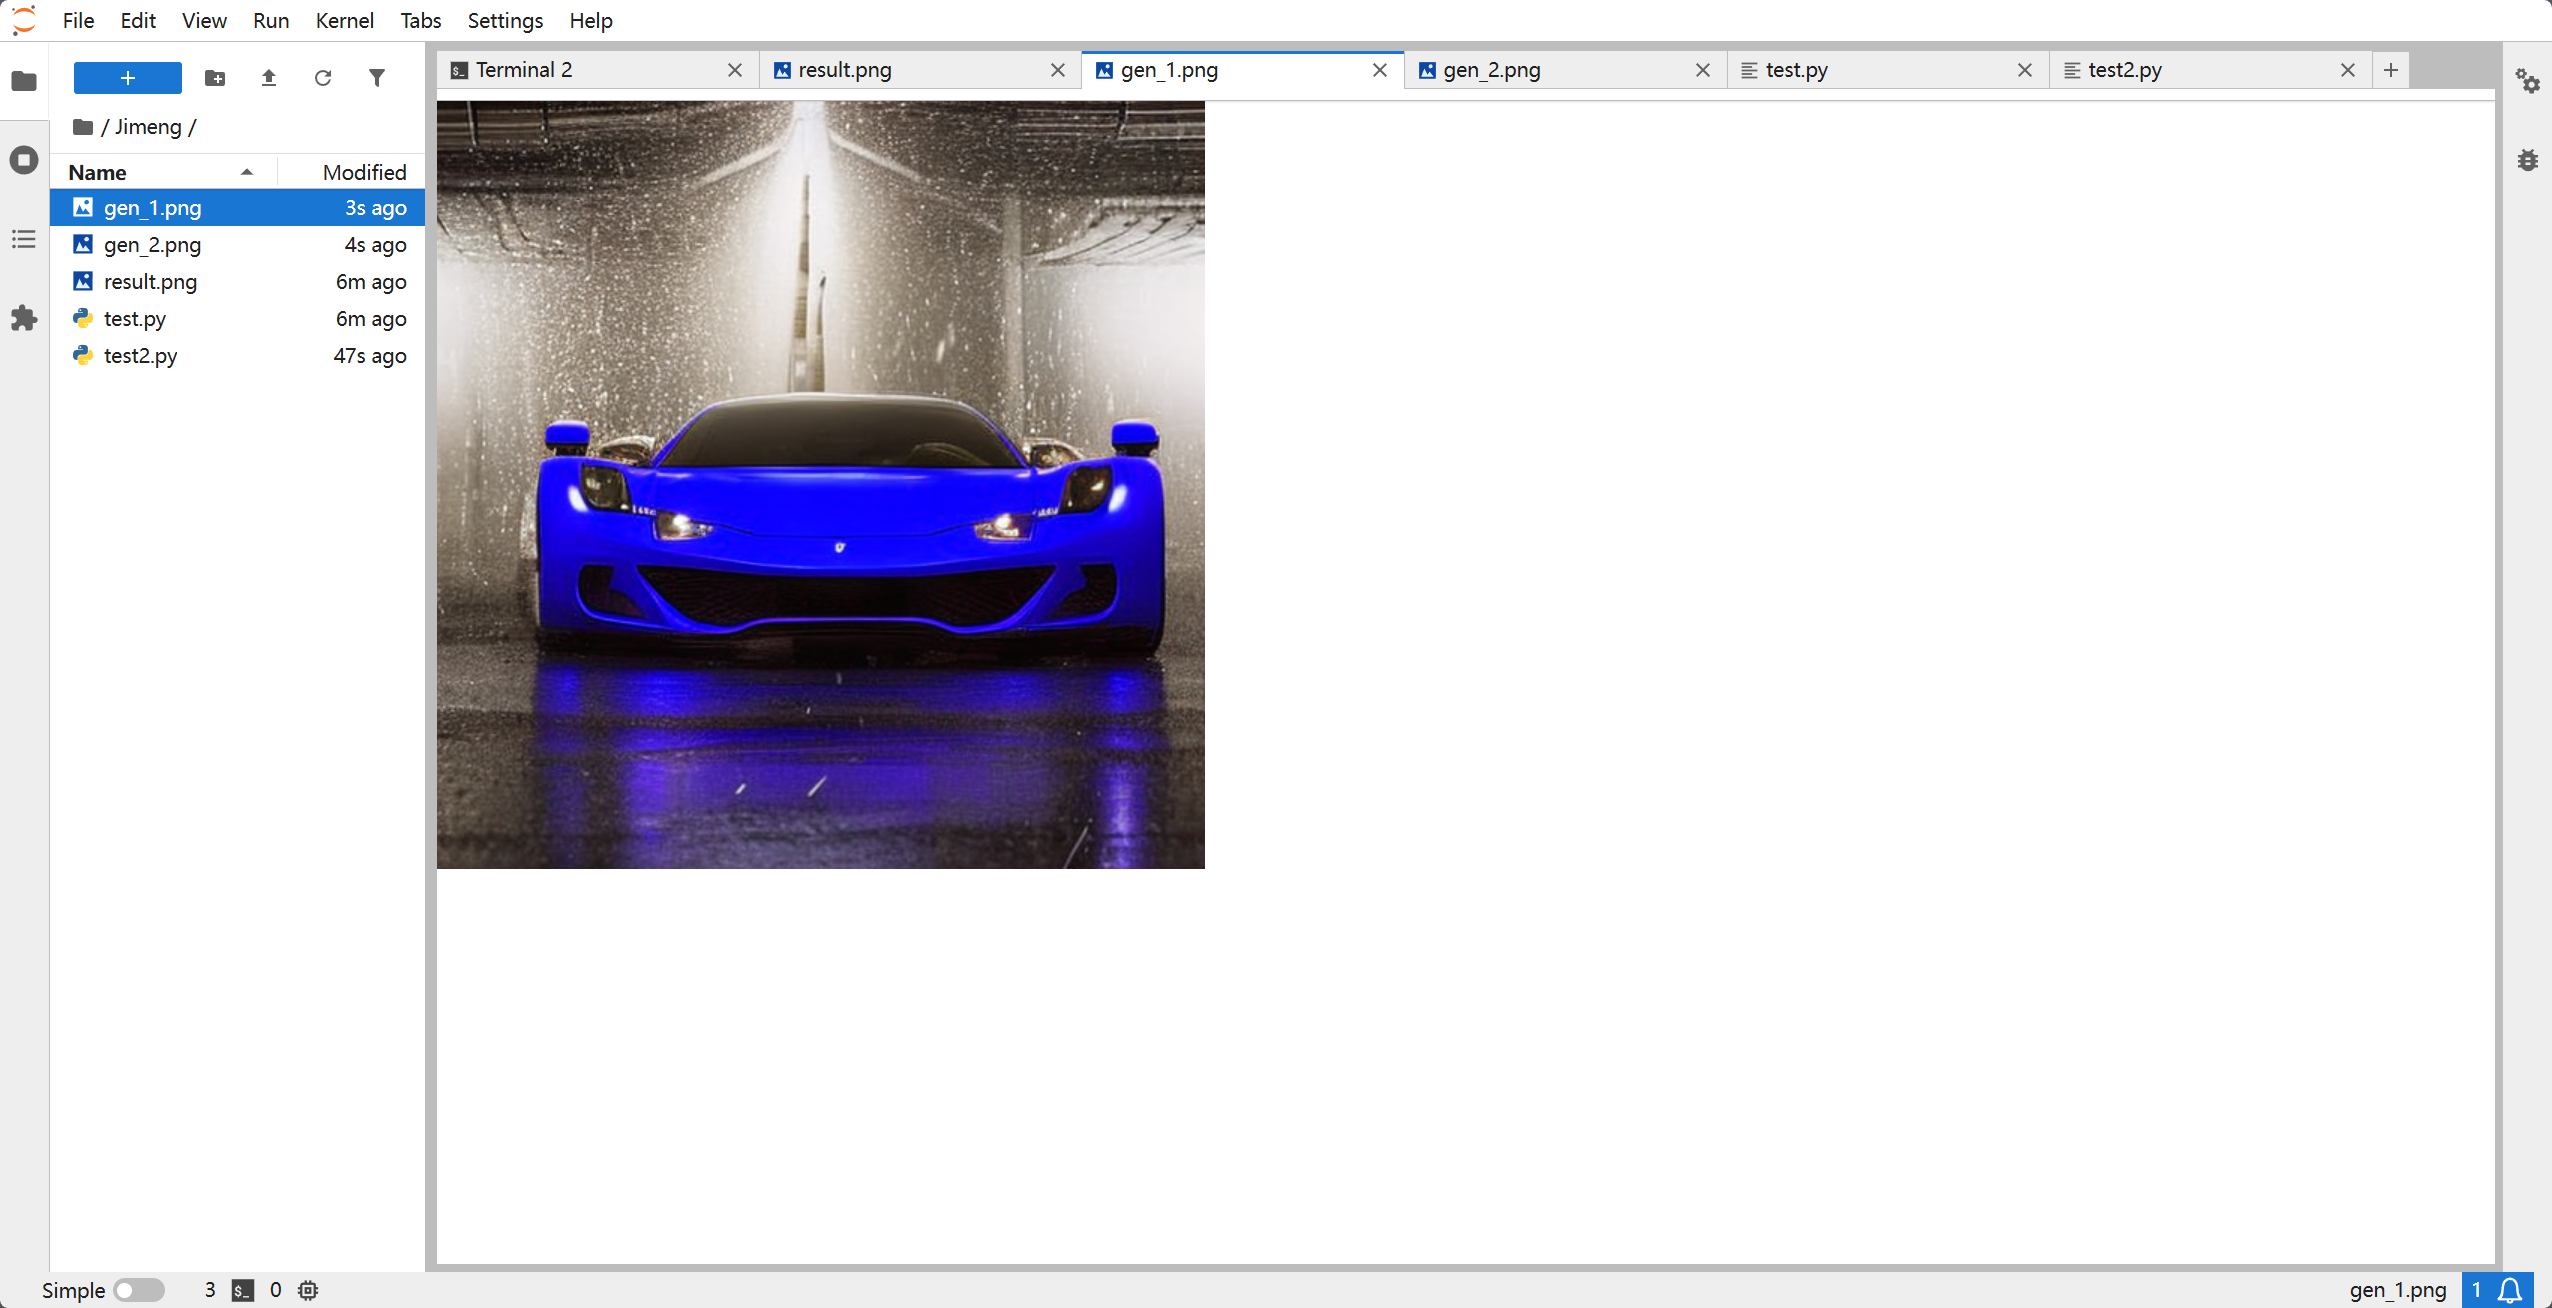
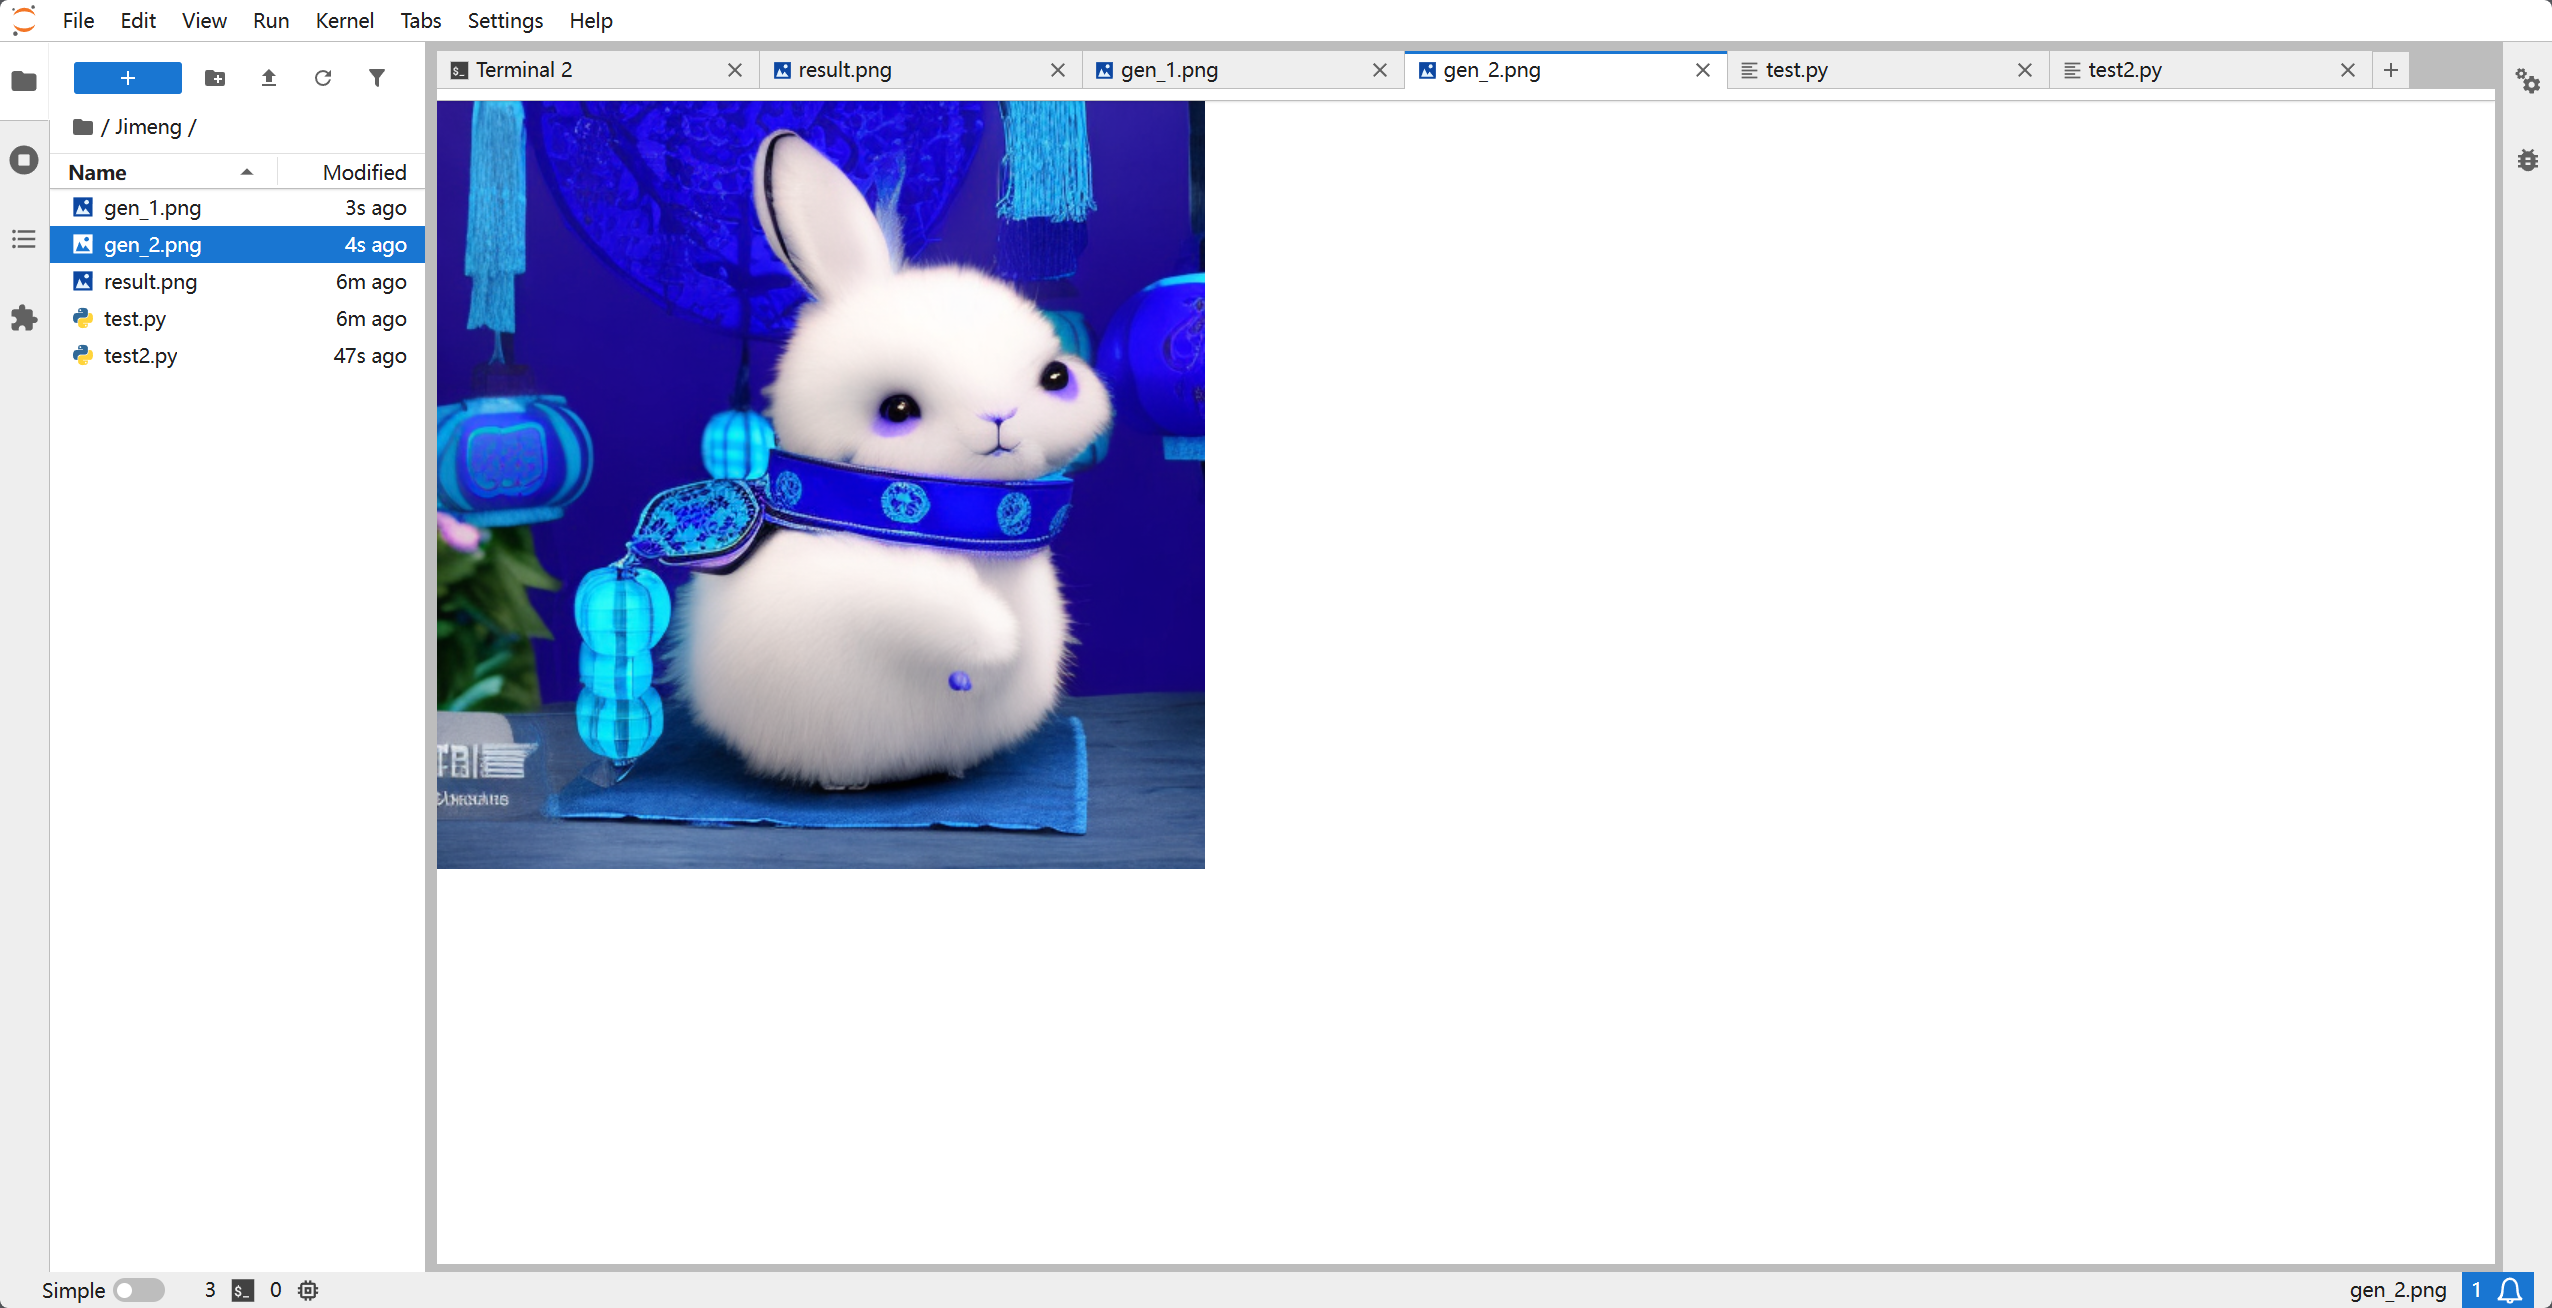
6. 避坑指南(FAQ)
-
报错:'output_img' 找不到
- 原因 :由于版本差异,模型返回的可能是
image或images。 - 解决 :本脚本中使用了
for key in [...]循环自动查找所有可能的键名。
- 原因 :由于版本差异,模型返回的可能是
-
报错:The truth value of an array is ambiguous
- 原因:Python 尝试对 Numpy 数组直接进行真值判断。
- 解决 :在脚本中使用
if raw_data is not None:替代if raw_data:。
-
显存不足 (OOM)
- 原因:GPU 显存被其他程序占用。
- 解决 :执行
nvidia-smi检查进程,并确保没有同时运行多个大型推理任务。
7. 总结
通过本次部署,我们不仅成功运行了 Jimeng 模型,还通过 运行时补丁 的技术手段解决了跨版本库的兼容性难题。这种部署方式非常适合在算力平台上进行快速 Demo 展示或二次开发。
如果你需要将图片自动同步到阿里云,记得结合开头安装的 oss2 库,在保存文件后调用 bucket.put_object_from_file() 即可!
467b867ff6425f44962b.png)