本文档为伪分布式大数据环境(1台虚拟机:hadoop)中Flink组件的功能测试教程,涵盖Flink依赖服务启停、进程验证、WebUI访问、核心测试命令执行及服务关闭等核心场景。严格遵循视频操作流程,结合参考文档中的测试命令,详细说明每个步骤的操作要点、执行命令及预期结果,助力高效完成Flink组件可用性及任务运行功能验证。
一、前期准备:环境基础信息
测试前需确认环境配置符合要求,避免因基础环境问题导致测试流程中断:
- 虚拟机配置:1台虚拟机(命名为hadoop),硬盘配置100GB,已完成伪分布式部署
- 系统账号:优先使用hertz账号(密码:hertz);特殊操作使用root账号(密码:1)
- 工具准备:Mobaxterm远程连接工具(已安装并可正常使用)、本地浏览器(如Chrome、Edge)
二、Flink测试详细步骤
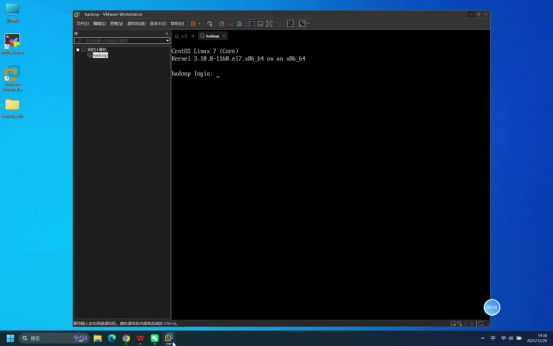
步骤1:确认虚拟机启动状态
操作说明:启动虚拟机,等待系统加载完成,直至出现登录页面。
预期结果:虚拟机正常启动,显示系统登录界面,无启动报错。
步骤2:使用Mobaxterm连接虚拟机
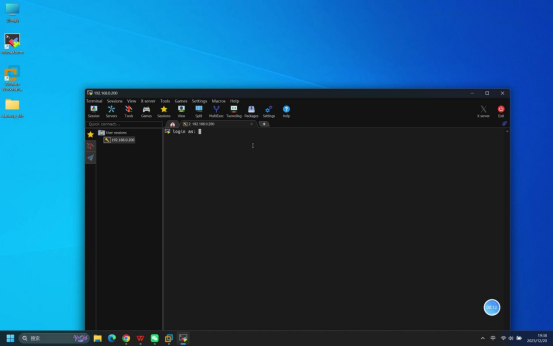
操作说明:打开本地Mobaxterm工具,按照伪分布式部署教程中的详细步骤建立与虚拟机的远程连接。
核心操作要点:
- 新建远程连接,选择SSH连接方式
- 输入虚拟机IP地址(需提前确认正确)
- 选择登录账号类型(默认为普通用户)
预期结果:Mobaxterm连接成功,进入连接等待登录状态。
步骤3:输入账号密码完成登录
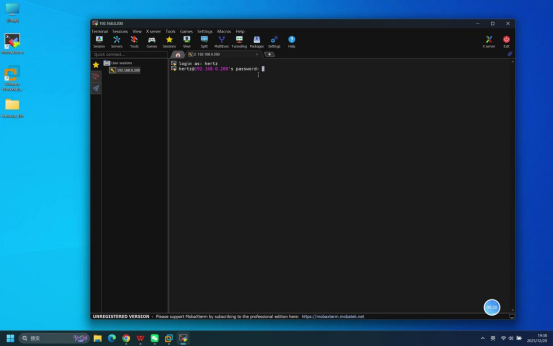
操作说明:在Mobaxterm连接成功后的登录界面,依次完成账号和密码输入。
具体操作:
- 当终端显示账号输入提示时,输入:hertz
- 回车后,终端显示密码输入提示,输入:hertz(密码输入时默认不显示明文)
- 再次回车确认
预期结果:登录成功,终端界面显示当前登录用户及主机信息(如hertz@hadoop \~$)。
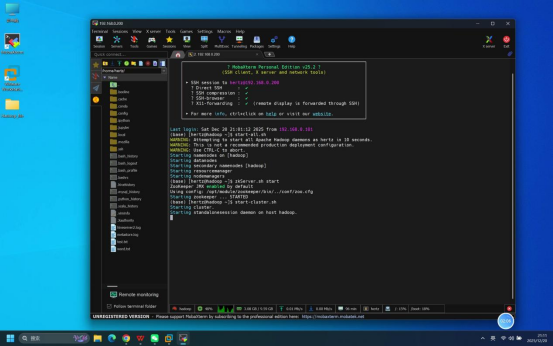
步骤4:启动Flink相关服务
操作说明:在登录成功的Mobaxterm终端中,按依赖顺序启动相关服务(先启动基础依赖服务,待稳定后再启动Flink服务)。
具体命令:
- 启动ZooKeeper服务:zkServer.sh start
- 启动Hadoop服务:start-all.sh(一键启动HDFS和YARN相关进程,为Flink提供资源支持)
- 等待10秒左右(确保依赖服务稳定运行),启动Flink服务:start-cluster.sh(一键启动Flink Standalone集群,含JobManager和TaskManager服务)
说明:启动过程中若出现权限提示,直接回车确认即可;需等待前一个服务启动完成(无报错)后,再执行下一个启动命令。
预期结果:所有服务启动无报错,终端依次显示各服务的启动日志信息。
步骤5:执行jps命令验证进程状态
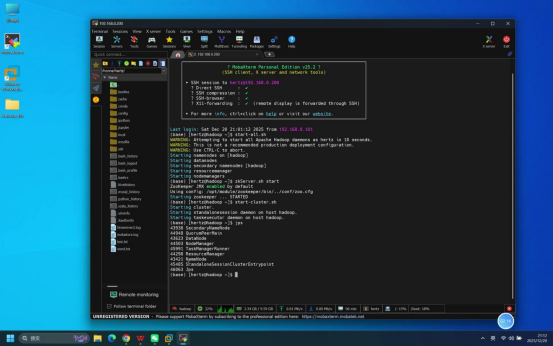
操作说明:服务启动完成后,在终端中输入jps命令,查看当前运行的Java进程。
具体命令:jps
预期结果:终端输出进程列表,包含以下核心进程,说明相关服务启动正常:
- NameNode、DataNode、ResourceManager、NodeManager(Hadoop相关进程)
- QuorumPeerMain(ZooKeeper进程)
- StandaloneSessionClusterEntrypoint(Flink JobManager进程)
- TaskManagerRunner(Flink TaskManager进程)
步骤6:浏览器访问Flink WebUI
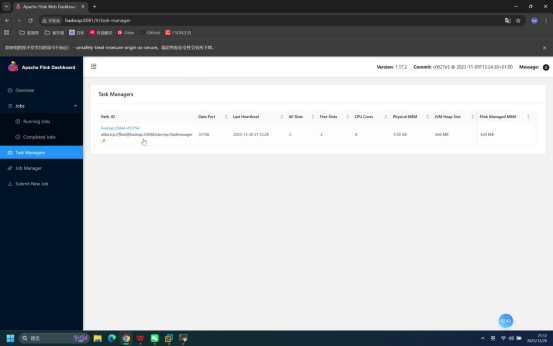
操作说明:打开本地浏览器,输入Flink WebUI访问地址,查看Task Manager等集群信息。
具体操作:
- 打开浏览器(如Chrome)
- 地址栏输入:hadoop:8081
- 进入页面后,定位并查看「Task Managers」模块
预期结果:浏览器成功加载Flink WebUI页面,「Task Managers」模块显示当前运行的TaskManager节点信息(伪分布式下为1个),包含节点ID、状态、资源使用情况等,集群状态正常。
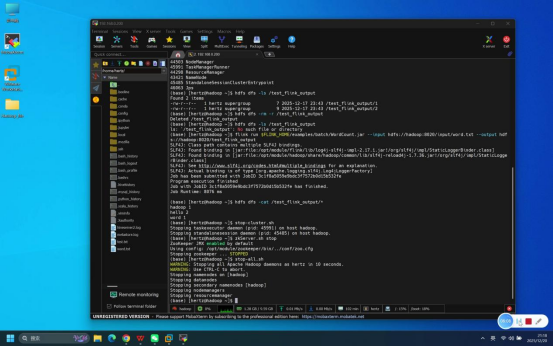
步骤7:执行Flink测试命令
操作说明:回到Mobaxterm终端,执行Flink测试命令,完成任务提交等核心功能验证。
具体操作:
- 确认测试文件:复用Hadoop测试的/input/word.txt文件
- 查看是否存在目录:hdfs dfs -ls /test_flink_output
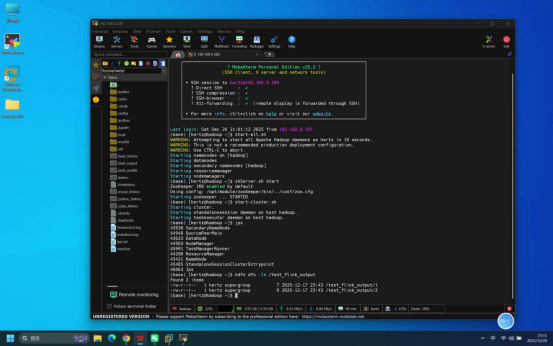
- 清理历史输出目录(若存在):输入命令:hdfs dfs -rm -r /test_flink_output
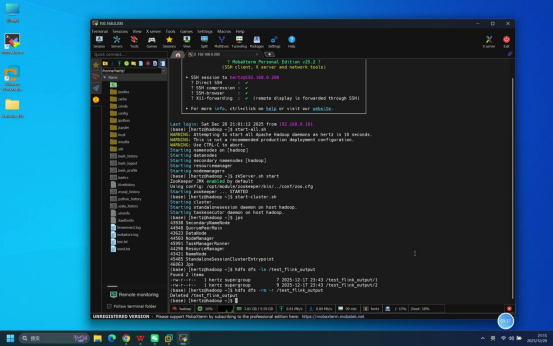
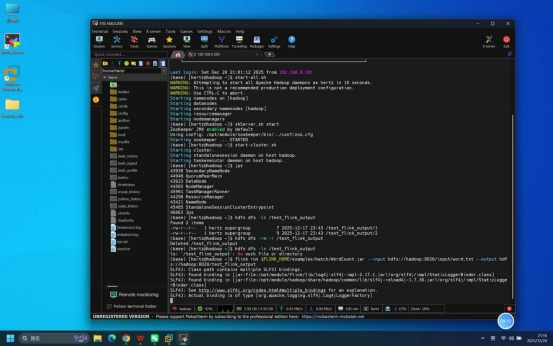
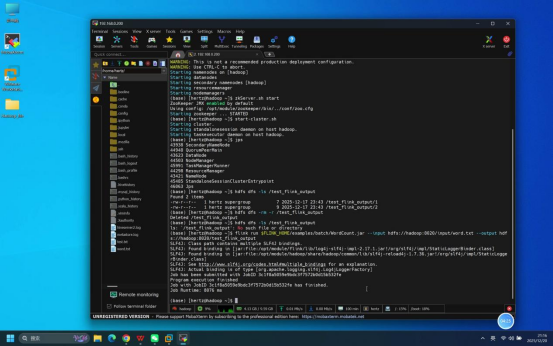
- 提交Flink批处理测试任务:输入命令:flink run $FLINK_HOME/examples/batch/WordCount.jar --input hdfs://hadoop:8020/input/word.txt --output hdfs://hadoop:8020/test_flink_output
- 查看任务执行结果:输入命令:hdfs dfs -cat /test_flink_output/*
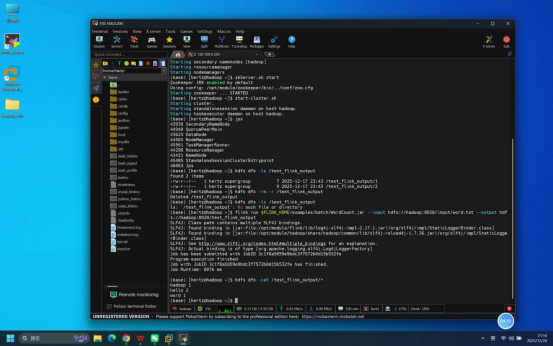
预期结果:所有测试命令执行无报错,Flink批处理任务正常提交并运行完成;查看结果时,终端输出包含"hadoop 1""hello 2""word 1"的统计信息,与Hadoop单词计数测试结果一致。
步骤8:关闭Flink相关服务
操作说明:测试完成后,在终端中按与启动相反的顺序关闭所有相关服务,避免资源占用或数据损坏。
具体操作与命令:
- 关闭Flink服务:输入命令:stop-cluster.sh
- 关闭Hadoop服务:输入命令:stop-all.sh
- 关闭ZooKeeper服务:输入命令:zkServer.sh stop
预期结果:所有服务均正常关闭,无报错提示。