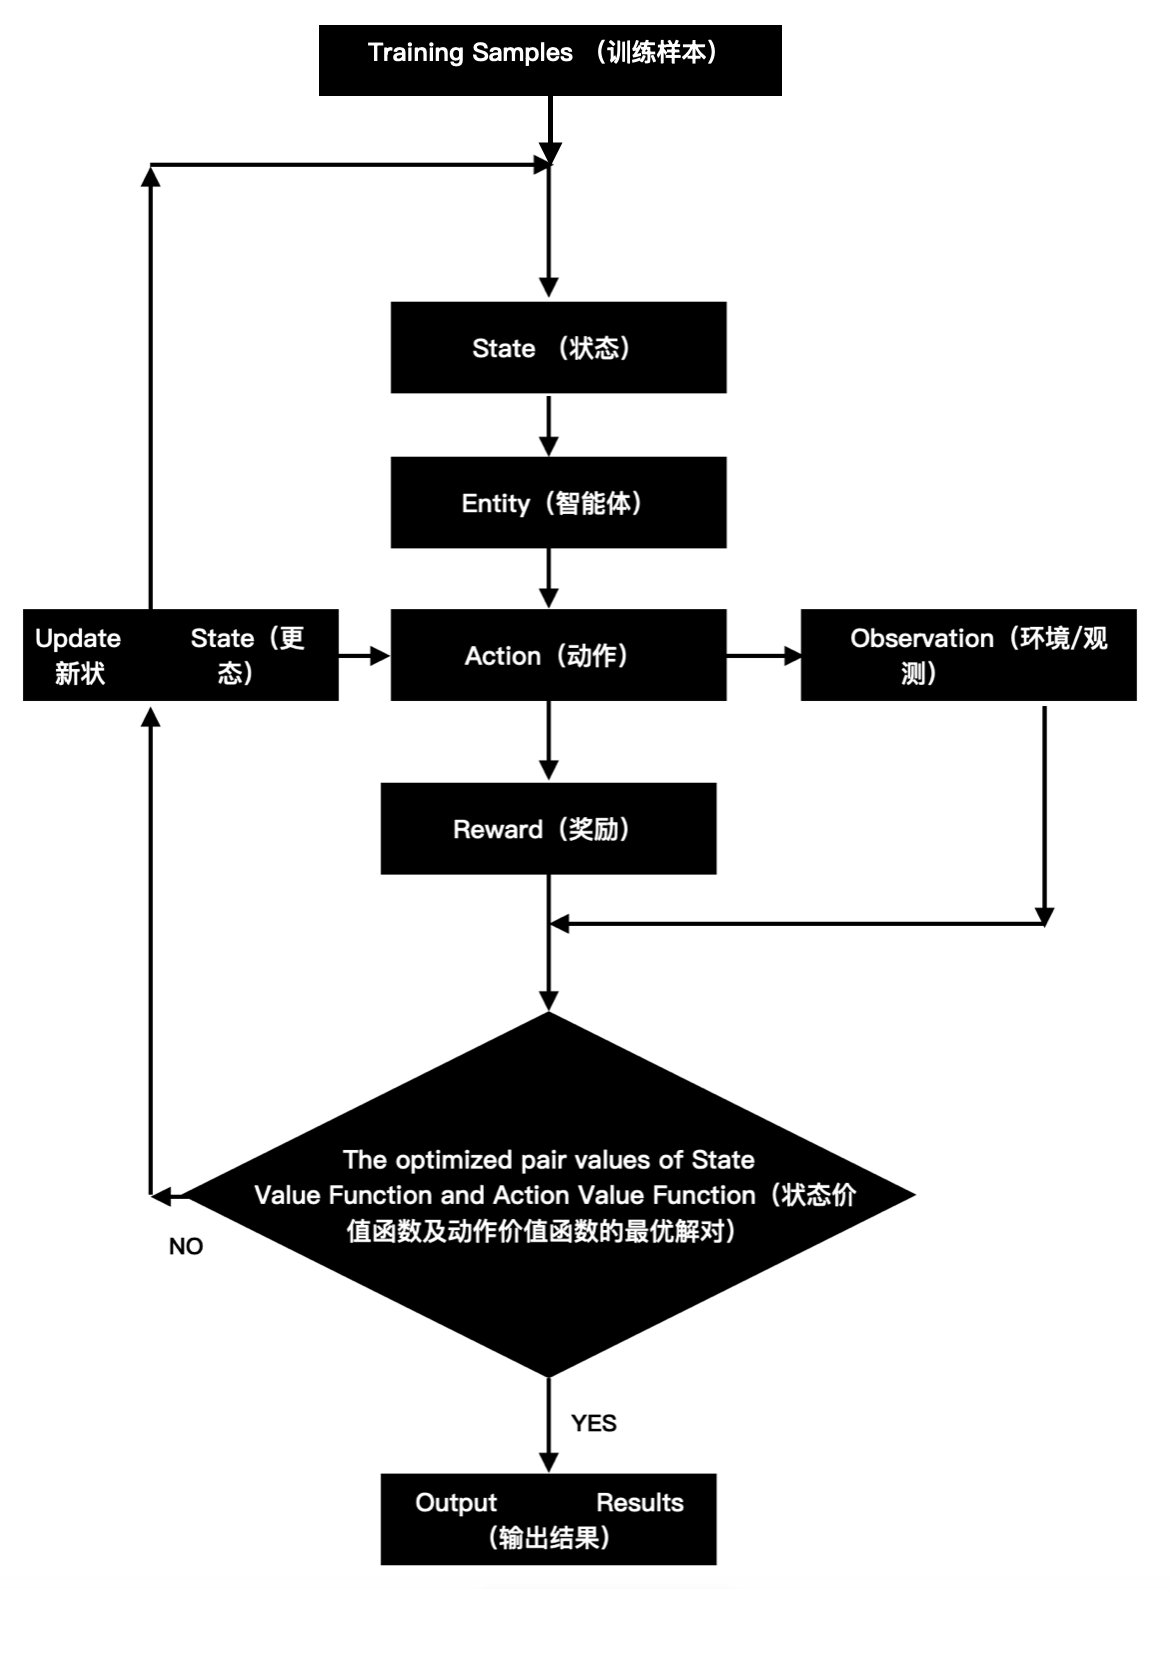
Reinforce Learning Concept Flow Chart (强化学习概念流程图)

在强化学习中,智能体(agent)在一系列的事件步骤上与环境交互。在每个特定时间点,智能体从环境结构一些观测(observation),并且必须选择一个动作(action),然后通过某种机制(有时称为执行器)将其传输回环境,最后智能体从环境中得到奖励(reward)。注意,强化学习的目标是产生一个好的策略(policy)。强化学习智能体选择的"动作"受策略控制,即从一个环境观测映射到动作的功能。

当环境可被完全观测到时,强化学习问题被称为马尔可夫决策过程(Markov Decision Process)。它的核心是无后效性(Memorylessness),未来的状态仅依赖于当前状态和动作,与"过去的状态/动作序列"无关。这种性质让MDP的计算变得可行,它无需存储历史信息。当状态不依赖之前的动作时,我们称该问题为上下文老虎机(contextual bandit problem)。当没有状态,只有一组最初未知奖励的可用动作时,这个问题就是经典的多臂老虎机(multi-armed bandit problem)。

如下图所示:
参考文献:

1 《动手学深度学习PyTorch版》

2 www.alphachain.net.cn

相关推荐
电子元件小说家1 小时前
2026年四季度电感市场观察:AI算力与汽车电子驱动下的选型与验证建议智能硬件
人工智能·汽车
网易CodeWave-小码哥2 小时前
支持多模块 Java 微服务导入|CodeWave SDD V4.5.10 上线
人工智能
AI你一生一世2 小时前
不止于时序存储:DolphinDB 如何成为 AI 时代的工业智能底座
java·人工智能·struts·时序数据库·工业智能·dolphindb·ai基础设施
belldeep2 小时前
python:genesis-world, Genesis-Embodied-AI
人工智能·python·ai·genesis
怕浪猫2 小时前
小程序成长计划上新:10 亿 Token 现在能调 DeepSeek-v4.1-flash了
人工智能·aigc·ai编程
ss2732 小时前
为什么PostgreSQL适合AI场景?
数据库·人工智能·postgresql
七牛云行业应用3 小时前
DeepSeek Super-agent 与 Grok Bot:开源 Agent 架构和聊天助手有何区别
人工智能·ai·架构·ai编程
维克兜率天3 小时前
【维克】趋势型CTA:期货市场的“追涨杀跌“
人工智能·python
u1301303 小时前
GitHub 热榜项目:日榜(2026-11-03)
人工智能·github
天远Date Lab3 小时前
零信任架构实战:基于天远租凭分期报告构建自动化汽车以租代购免押风控网关
网络·人工智能·架构·自动化