分布式训练DP与DDP

动画理解Pytorch 大模型分布式训练技术 DP,DDP,DeepSpeed ZeRO技术_哔哩哔哩_bilibili

单卡运行流程
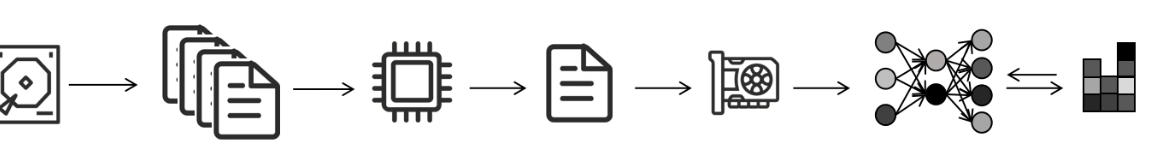
DP(data parallel)

从硬盘读取数据,然后一个cpu进程将数据分成多份,给每个GPU训练,然后计算出梯度 进行网络更新(无效更新),然后再将各个GPU算出来的梯度,返回到gpu0进行梯度平均,再更新网络0,网络0再把更新后的网络参数广播到其他网络上。
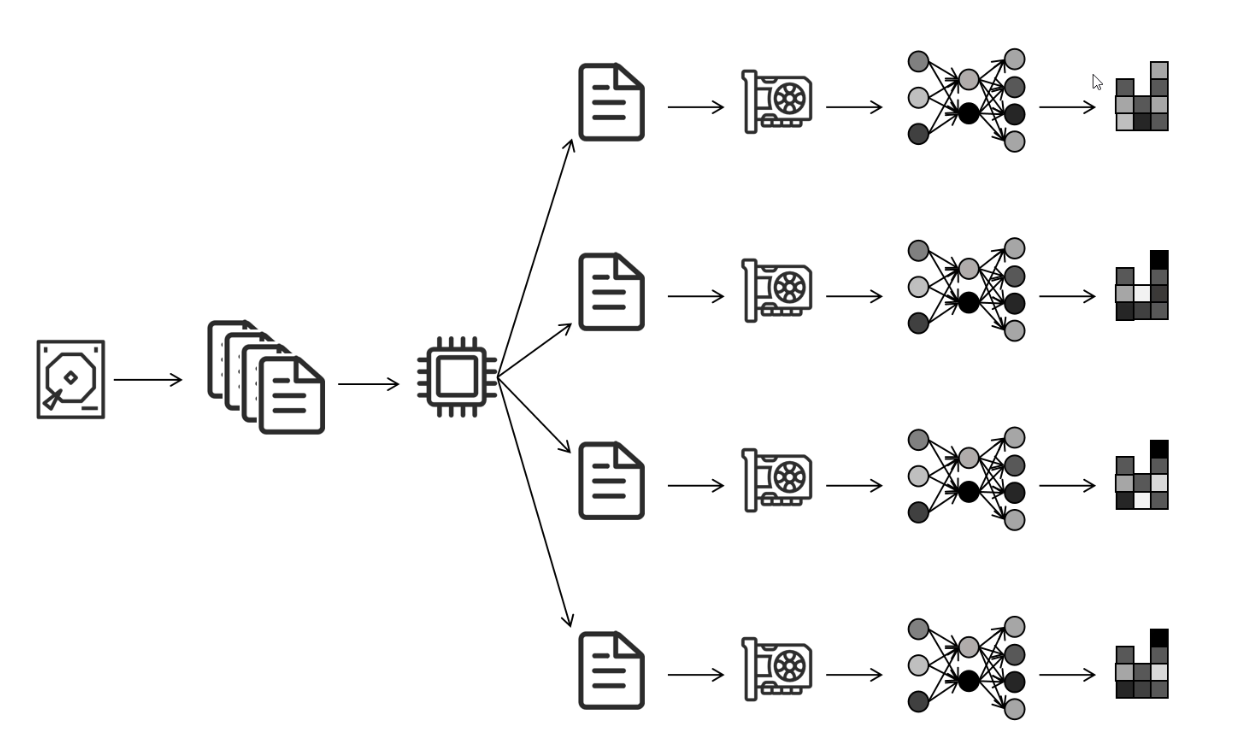
DP存在的问题: 单进程,多线程,Python GIL只能利用一个CPU核。

GPU0负责手机梯度,更新参数,同步参数,通信,计算压力大。(即卡间负载极不平衡)

DDP: 让每个GPU都能进行接收处理以及通讯。
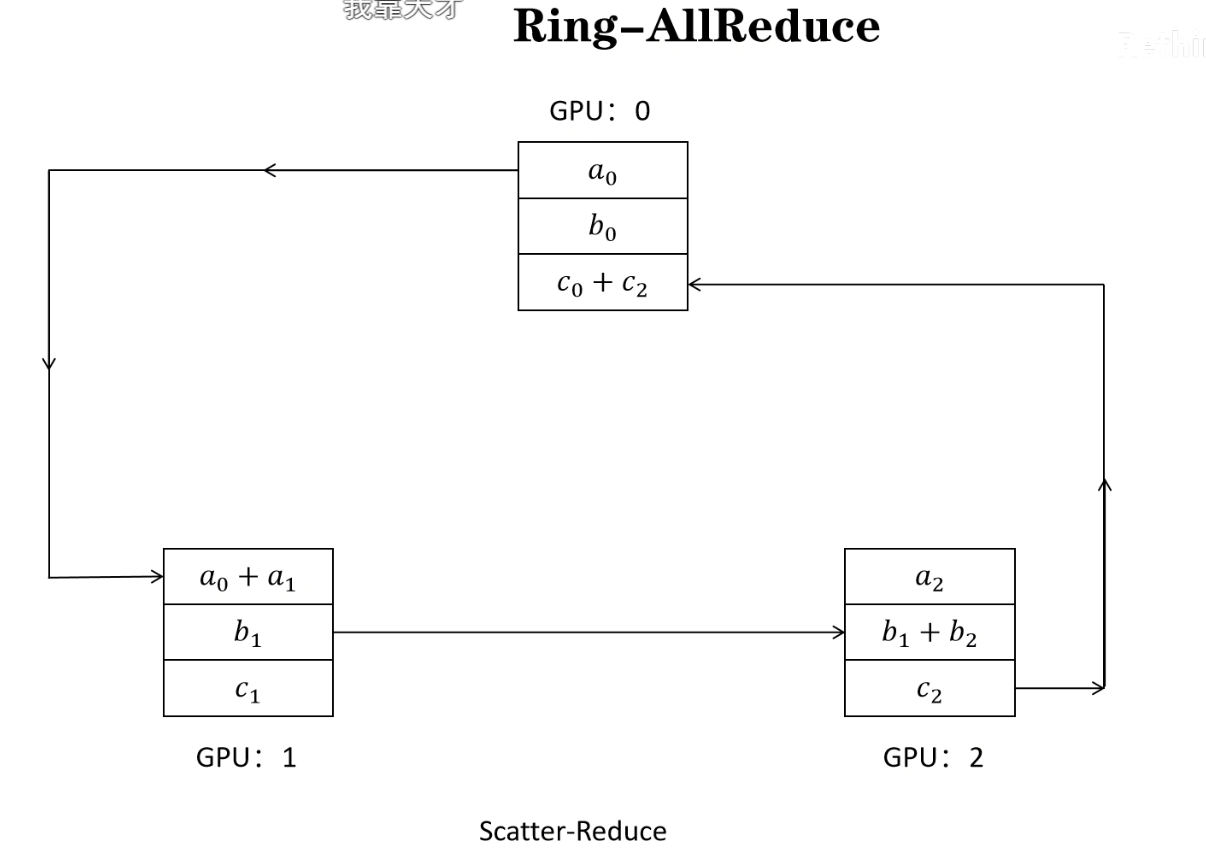
图中scatter的意思是,通过分发,让不同的节点有不同的值,reduce 的意思是 收集所有节点的值,并进行计算。
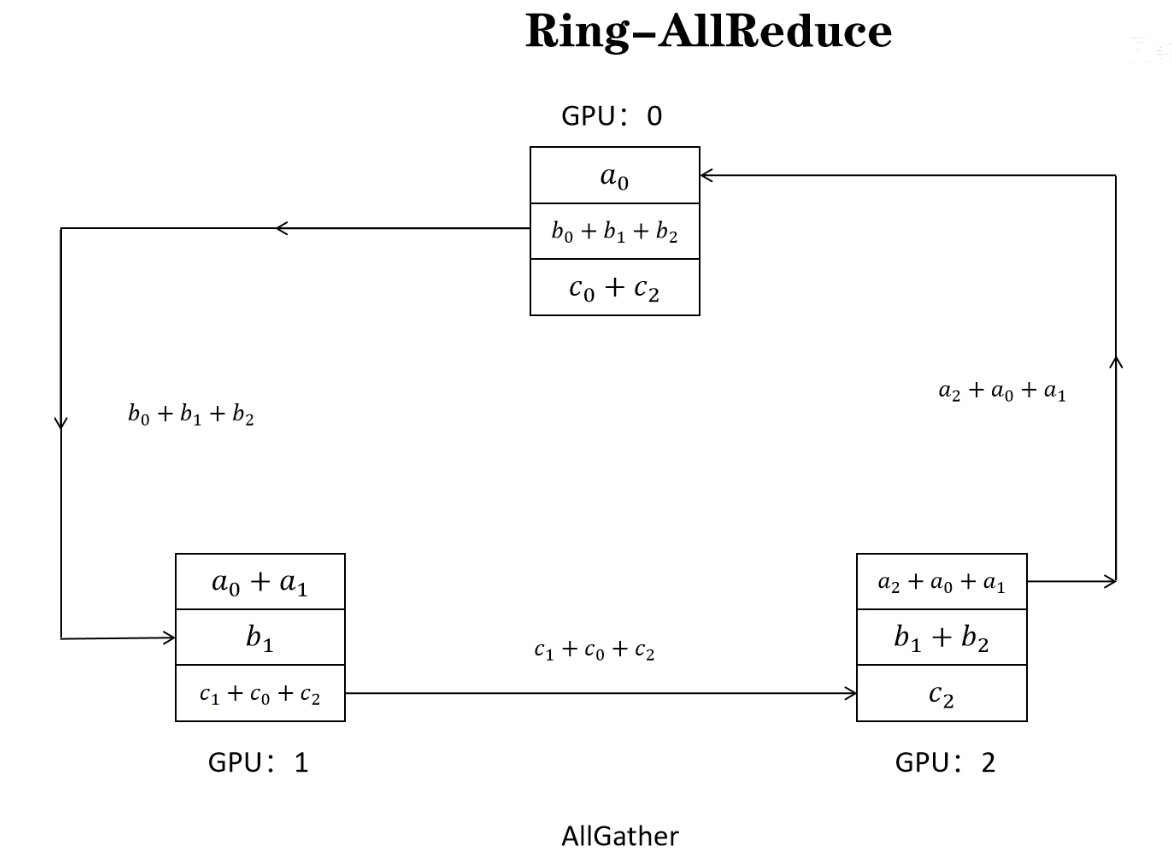
allgather 的意思是,把更新后的值,同步到 各个GPU,最后完成更新。充分利用各个GPU上下行的带宽。
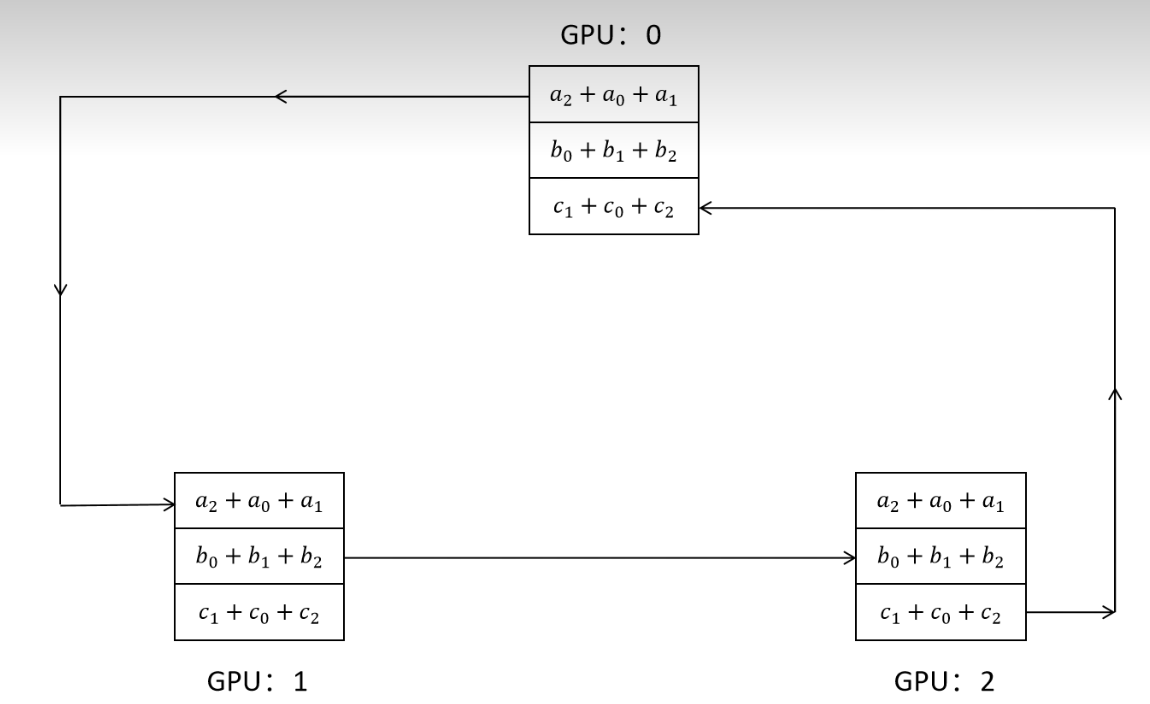
计算参数梯度的个数满一个'桶'的时候,就开始流水并行化更新同步。
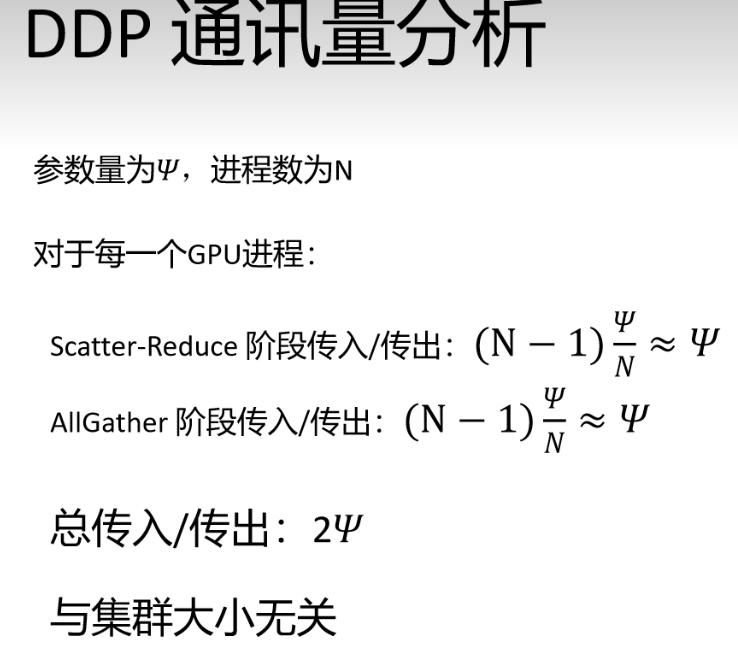
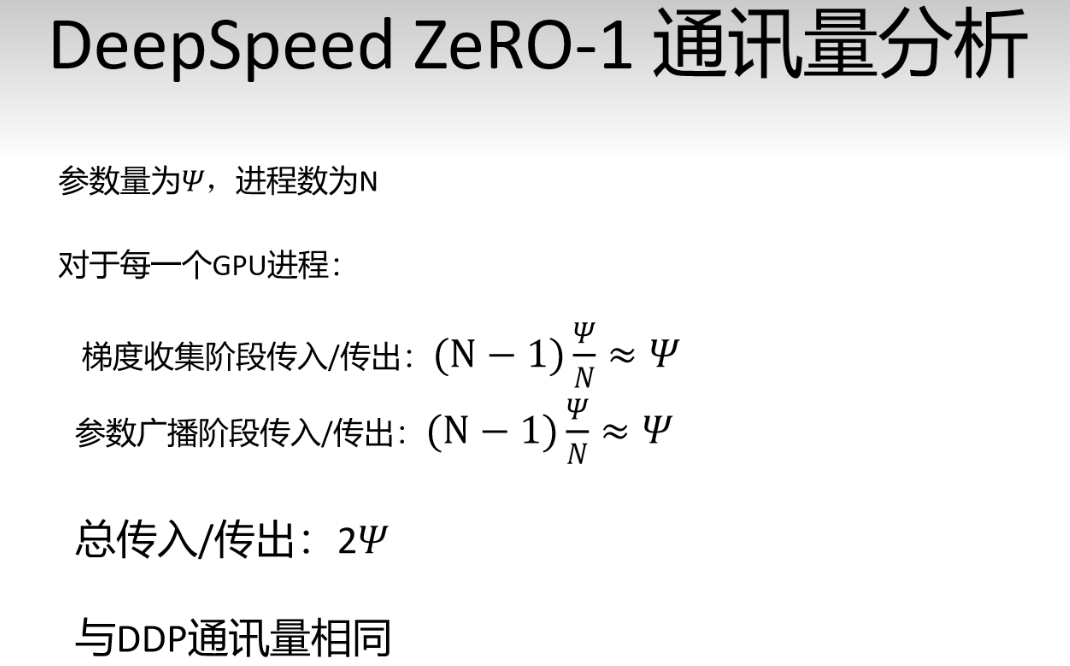
(他会预先分配好,哪些参数该谁更新,这样就避免了一个参数连圈转的发送和接收(相当于原来是A给B给C给D,现在是,A,B,C直接给D了)
相关推荐
snakeshe10103 分钟前
ChatGLM行业垂直领域微调实战:从需求分析到数据集加载完整流程
人工智能
橘子131 小时前
【高级数据库】关系代数基本概念
算法
智联视频超融合平台4 小时前
视频 AI 的误报之战,正在从调参数卷到改架构
人工智能·大模型·边缘计算·视频监控·安防
水如烟5 小时前
孤能子视角:智能的边界不在算法强弱,在可形式化性——从概率法到因果推理,选择池的边界一直在那里
人工智能
万里侯6 小时前
日志聚类之后别把 noise 扔掉:降噪应该改变视图,不抹掉证据
人工智能·微服务·ai·容器·k8s
澹锦汐6 小时前
纯前端秋日银杏与枫叶落叶色板智能聚类器:基于 K-Means 色彩量化与直方图自动配方提取
前端·人工智能·ai·语言模型·vue·react·k-means
电科_银尘12 小时前
【大模型算法与工程 15】手写Self-Attention:Q、K、V与缩放点积
算法
71777713 小时前
国内 AI 研发效能工具怎么选:2026 年基于公开信息的选型框架与 Gitee 实践
人工智能·gitee
Csvn14 小时前
换供应商要改一遍代码?把模型接入收进一层网关(C04)
人工智能·aigc·agent