文章目录
现象
flink 程序一直在重启和失败,限入死循环,导致程序不能正常运行
任务报错信息
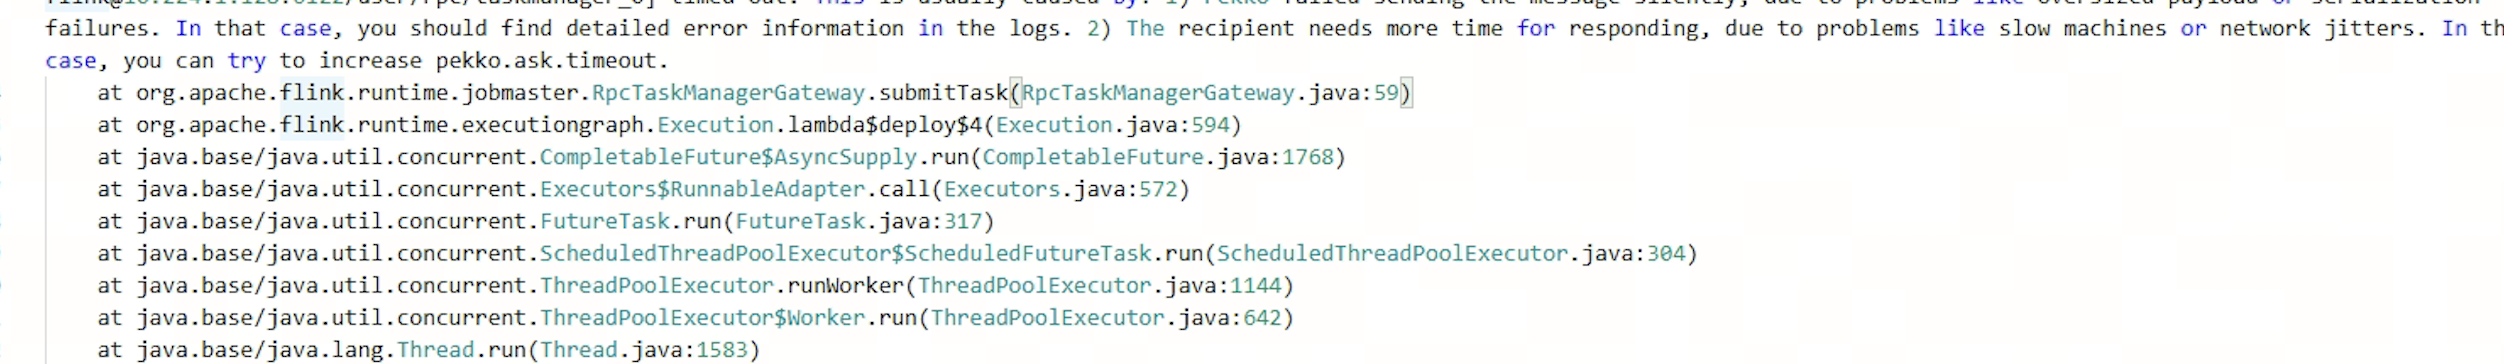
task-manager 的程序日志报错信息
bash
2026-02-02 12:56:57,145 WARN  org.apache.flink.runtime.taskmanager.Task                    [] - Task 'SlidingEventTimeWindows (3/3)#13547' did not react to cancelling signal - interrupting; it is stuck for 30 seconds in method:
 org.rocksdb.RocksDB.closeDatabase(Native Method)
org.rocksdb.RocksDB.close(RocksDB.java:645)
org.apache.flink.util.IOUtils.closeQuietly(IOUtils.java:295)
org.apache.flink.contrib.streaming.state.RocksDBKeyedStateBackend.dispose(RocksDBKeyedStateBackend.java:482)
org.apache.flink.streaming.api.operators.BackendRestorerProcedure.attemptCreateAndRestore(BackendRestorerProcedure.java:184)
org.apache.flink.streaming.api.operators.BackendRestorerProcedure.createAndRestore(BackendRestorerProcedure.java:137)
org.apache.flink.streaming.api.operators.StreamTaskStateInitializerImpl.keyedStatedBackend(StreamTaskStateInitializerImpl.java:399)
org.apache.flink.streaming.api.operators.StreamTaskStateInitializerImpl.streamOperatorStateContext(StreamTaskStateInitializerImpl.java:180)
org.apache.flink.streaming.api.operators.AbstractStreamOperator.initializeState(AbstractStreamOperator.java:266)
org.apache.flink.streaming.runtime.tasks.RegularOperatorChain.initializeStateAndOpenOperators(RegularOperatorChain.java:106)
org.apache.flink.streaming.runtime.tasks.StreamTask.restoreStateAndGates(StreamTask.java:799)
org.apache.flink.streaming.runtime.tasks.StreamTask.lambda$restoreInternal$3(StreamTask.java:753)
org.apache.flink.streaming.runtime.tasks.StreamTaskActionExecutor$1.call(StreamTaskActionExecutor.java:55)
org.apache.flink.streaming.runtime.tasks.StreamTask.restoreInternal(StreamTask.java:753)
分析
思路1
更新参数pekko.ask.timeout 把这个值调大,运行10来天后,还是出现这个报错,此参数不生效
思路2
和这个rocksdb 有关,我花了几天时间一直在研究rocksdb 相关的内容,不过看了几天时间也没看出来问题在哪。这里我一直在想这个rocksdb也不大呀,而且这个日志也是warn的日志,我都有点怀疑和这个关系不大。
初步解决
直接把checkpoint 去掉
加上重启策略
进展
我又在flink 作业界面,多个页面点了下,突然发现exception 页面有几个报错,而且很规律,每天的报错时间都是0点,这里我灵机一动,我想了一下,突然想了一下生产环境具体到底是几点开始没有数据的,想到这里于是我看了一下生产环境,缺失数据的时间点,恰好是0点之后,这里不就对上了嘛,于是我得出一个结论,测试环境每天0点会报错,但是每次都自动恢复了,而生产环境多次恢复,可能就会有偶发的一次恢复失败
解决
查看exception 发现是因为有0点会发生一个参数异常,导致任务发生异常,于是修复此问题,上线观察,观察几天0点的exception 消失
反思
为啥最后这个问题最后解决非常简单,但是找这个问题的路径如此曲折。
记录事故现场不详细
没有详细记录现场缺失数据的时间点, 这个现象已经发生多次,如果把每一次事故记录的时间点都记录准确。就能大大缩短排查问题的时间。
没有认真用Five Whys思路来思考问题
一直在分析后面的表象,没有分析第一步产生的原因,就是为啥会发生重启的现象,这里有一个惯性思维就是flink 作业重启我认为是一个正常现象,实际上这应该是一个异常现象来对待,导致花了很多时间在后面的表象。
Five Whys(又称"五问法"、"五个为什么")是一种简单而有效的问题根本原因分析方法,通过连续追问"为什么"来层层深入,直至找到问题的根源。