问题:
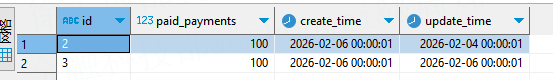
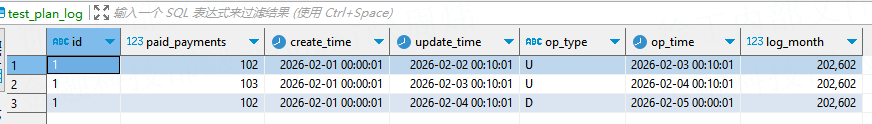
我们mysql有一个大表,千万级数据量,另外为它做了一张历史表,保留历史数据(只保留一个月)。如下图所示:
主表:
历史表:
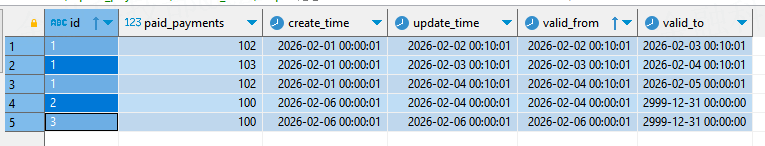
而数据中台的表结构如下:
1、初始取数
sql
取数据:
SELECT id, paid_payments, create_time, update_time,op_type FROM test_plan_log t WHERE update_time <= '${bizDateHour}' and op_time > '${bizDateHour}'
  UNION ALL
  SELECT id, paid_payments, create_time, update_time, 'U' as op_type FROM test_plan t WHERE update_time <= '${bizDateHour}'

统计当前有效数据量用于后面跟目标表数据量核对:
select sum(cnt) from (
SELECT count(*) as cnt FROM test_plan_log WHERE update_time <= '${bizDateHour}' and op_time > '${bizDateHour}'
  UNION ALL
  SELECT count(*) as cnt FROM test_plan m WHERE update_time <= '${bizDateHour}' ) b
bizDateHour比如2026-02-04 00:00:00
取到数据后,直接加载到hive拉链表中就可以。
2、增量取数合并
2.1、增量取数
然后假设每6小时去取增量数据
sql:
sql
-- 选取主表中变化的记录
select t.id , t.paid_payments , t.create_time , t.update_time, 'U' as op_type
from test_plan t where update_time >= '$bizDateHourStart' and update_time < '${bizDateHour}'
union all
select $slctColums,op_type from
    (
      -- 选取历史表中变化的记录
        select $slctColums_opt,op_type from test_plan_log t
        -- 剔除主表中重复的记录(可能是规定的时间段内多次变化,只取主表记录)
        where not exists (
            select 1 from test_plan t2 where t.id = t2.id
        )
    ) t where update_time >= '$bizDateHour - 6h' and update_time < '${bizDateHour}'"
比如2026-02-04 06:00:00之后去取2026-02-04 00:00:00到2026-02-04 06:00:00之间发生变化的数据。
统计数据量的sql还是一样的,不重复了。
2.2、合并到目标表
1、先把选取的数据加载到临时表
2、对临时表数据去重。这一步很关键,这几个小时数据多次变化的话,只能取最新的一条,否则后面的合并sql太最复杂,没必要。
sql
insert overwrite table  hive.tmp_test_plan
SELECT t.*
FROM  hive.tmp_test_plan  t
INNER JOIN (
    SELECT id, MAX(update_time) AS max_time
    FROM  hive.tmp_test_plan
    GROUP BY id
) t2 ON t.id = t2.id AND t.update_time = t2.max_time;
3、把临时表数据合并到主表中:
sql
insert overwrite table hive.dwd_test_plan
--- 选取主表中数据,如果在新数据中有相同id,则把原来的valid_to改成新数据的update_time
SELECT  t.id, t.paid_payments, t.create_time, t.update_time, valid_from,
	if (t.valid_to = to_date('9999-12-31')  AND b.id IS NOT NULL, b.update_time, t.valid_to) AS valid_to
FROM hive.dwd_test_plan t
LEFT JOIN hive.ods_${srcSystem}_${tableName} AS b
ON t.id = b.id
--- 这个条件是避免重复合并,也就是同一时间段数据执行两次合并的情况
and t.valid_from != b.update_time
UNION all
-- 选取新数据
SELECT  t.id, t.paid_payments, t.create_time, t.update_time,t.update_time AS valid_from, TO_DATE('9999-12-31') as valid_to
FROM hive.tmp_test_plan AS t
WHERE
-- 这个条件是避免重复合并,也就是同一时间段数据执行两次合并的情况
NOT EXISTS (
    SELECT 1  FROM hive.dwd_test_plan b
    WHERE t.id = b.id and b.valid_from = t.update_time
)
-- op_type为D的,表示数据删除了,原数据valid_to在第一条sql中已经终止了
and t.op_type != 'D'