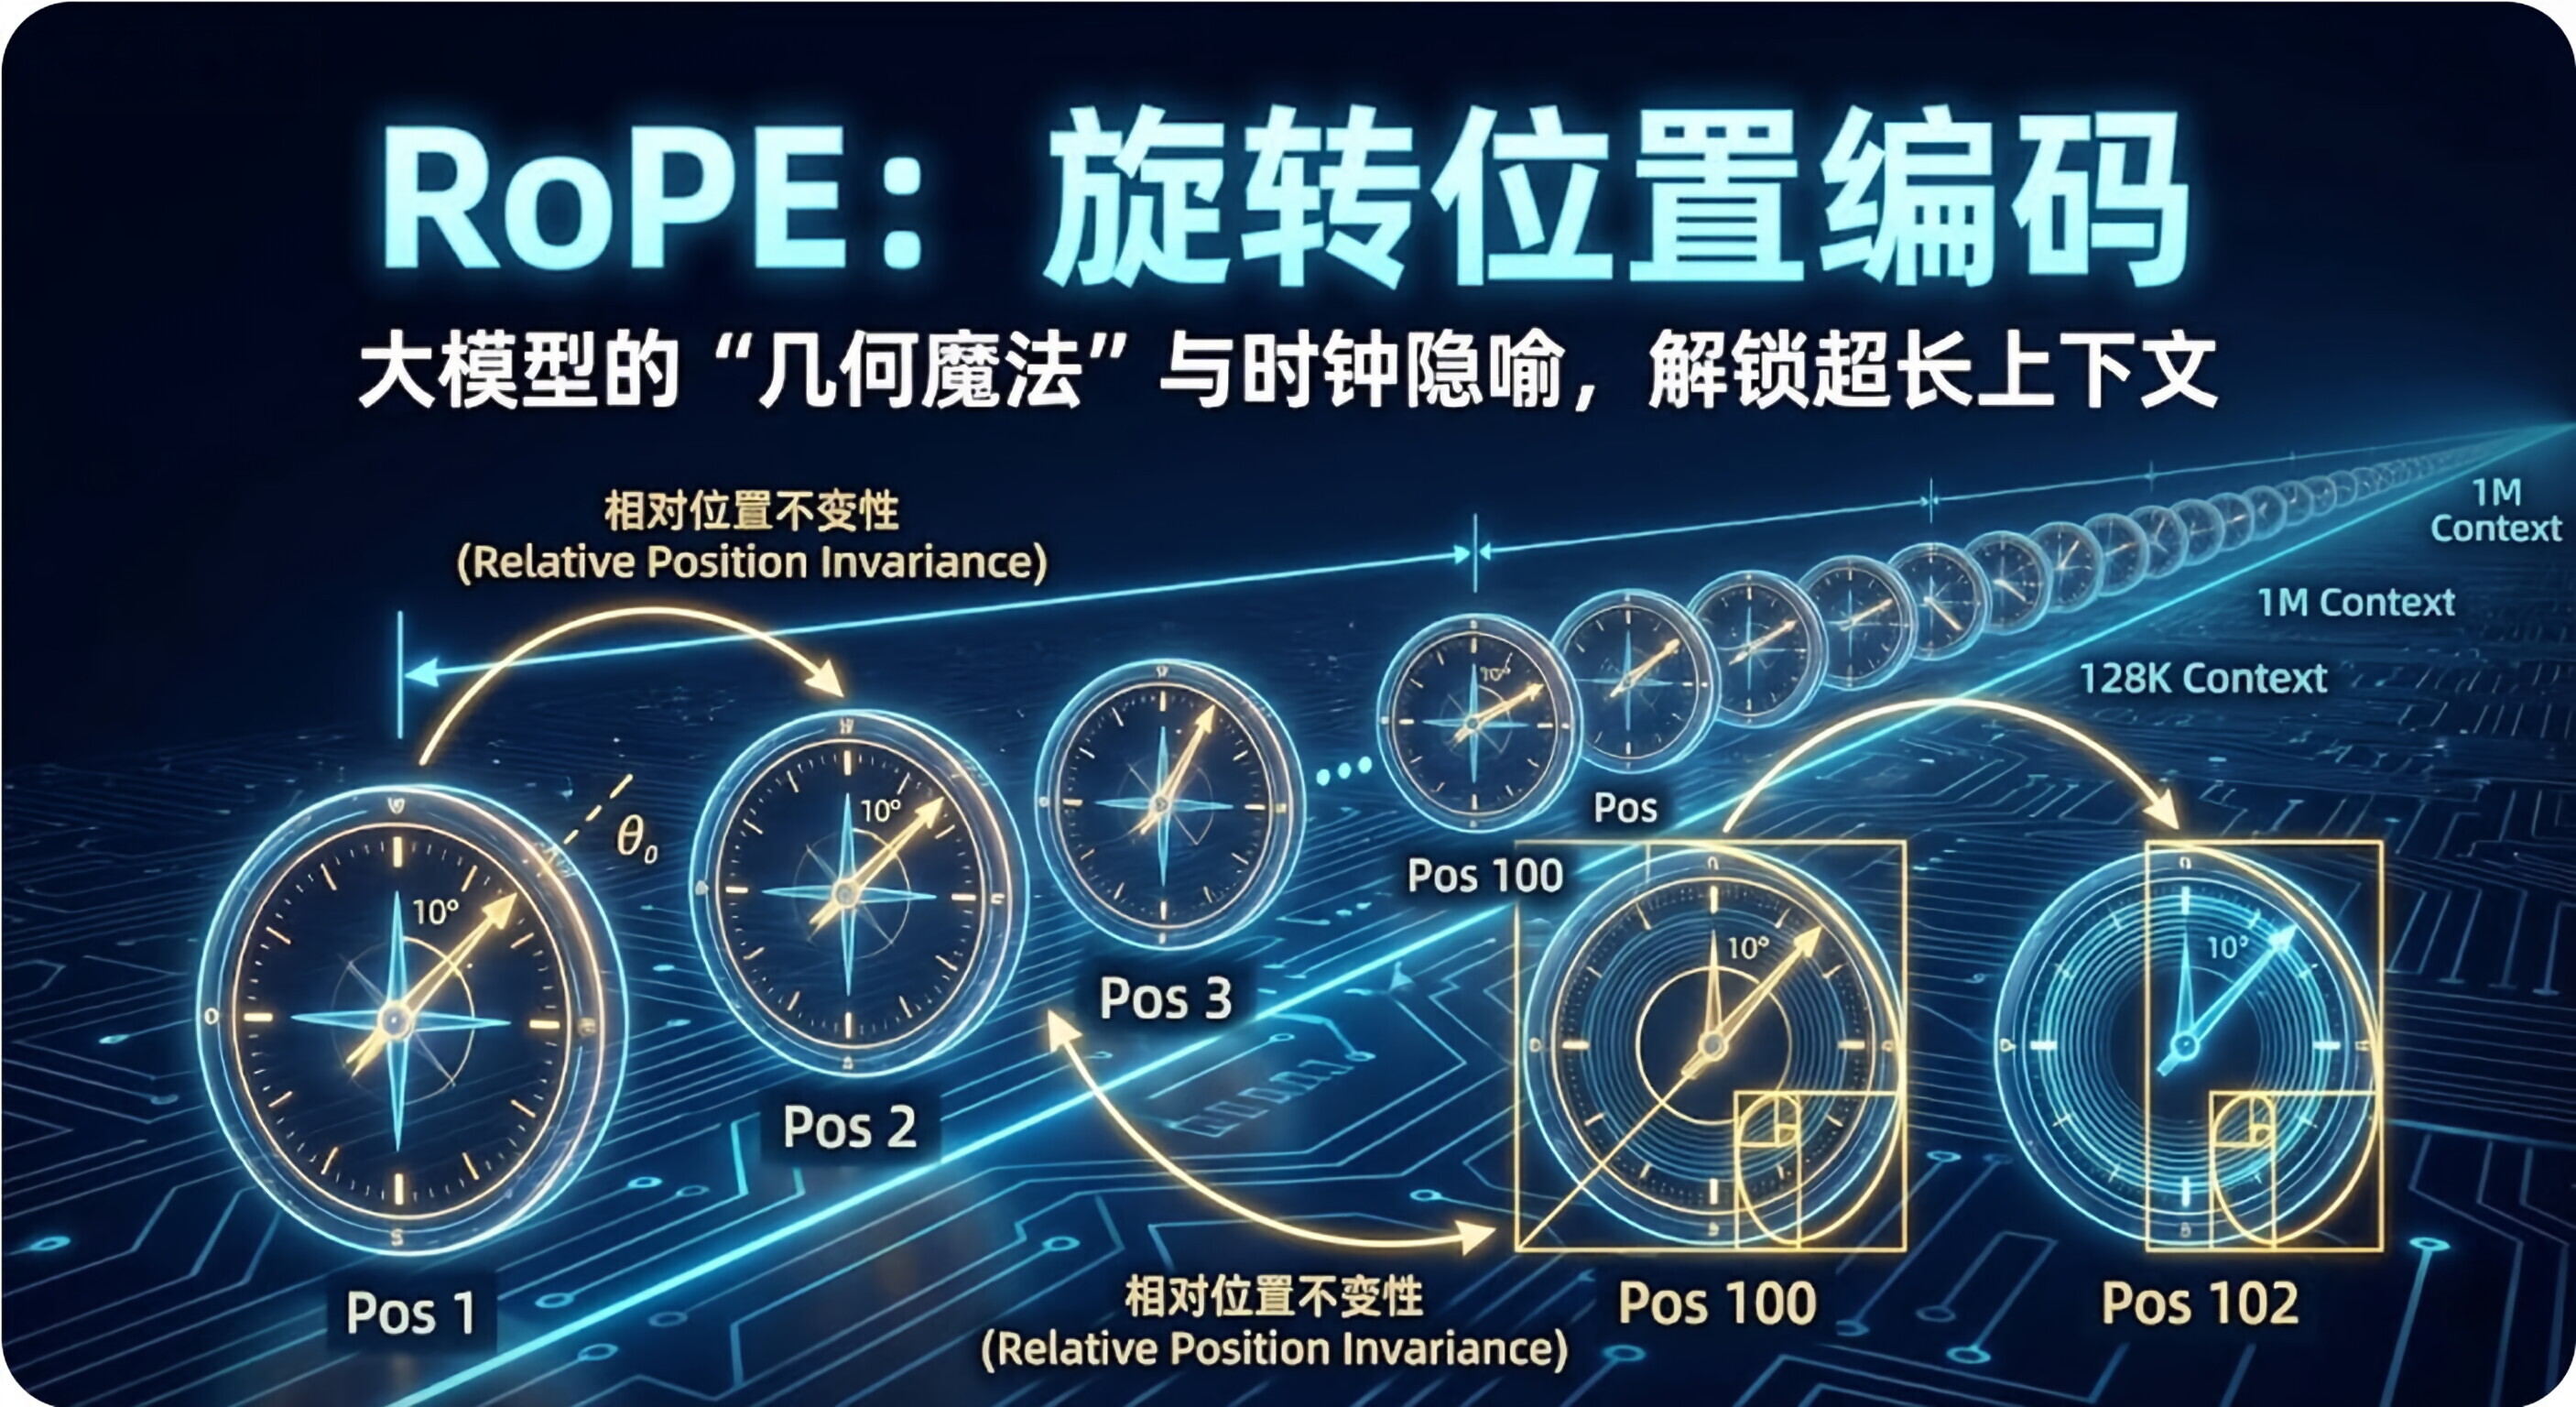
RoPE (Rotary Positional Embedding,旋转位置编码) 是目前大语言模型领域统治级的位置编码技术。
现在的明星模型,如 Llama 3、Qwen (通义千问)、Mistral、PaLM,几乎清一色都在使用 RoPE。
如果说传统的正弦波编码是**"把位置信息加(Add)在词向量上"** , 那么 RoPE 的核心思想就是**"通过旋转(Rotate)词向量的角度来代表位置"** 。
这不仅仅是数学上的技巧,更是一场几何学的魔法。
1.🕰️ 核心直觉:时钟指针的隐喻
为了理解 RoPE,我们先把高维的词向量想象成二维平面上的一根时钟指针。
-
没有位置编码时:
- "苹果"这个词的向量,无论放在句首还是句尾,它的指针指向(角度)和长度都是不变的。
-
RoPE 的做法:
-
它规定:词在第几个位置,就把这根指针顺时针旋转多少度。
-
比如设定旋转单位是 10 度:
-
在第 1 个位置,"苹果"的指针转 10 度。
-
在第 2 个位置,"苹果"的指针转 20 度。
-
在第 100 个位置,"苹果"的指针转 1000 度。
-
-
这就是 RoPE 的本质:用绝对的位置(第几个),算出了绝对的旋转角度。
2.📐 魔法时刻:为什么"旋转"能带来"相对位置"?
你可能会问:"这不还是绝对位置吗?第 100 位就是转 1000 度啊?"
RoPE 的精妙之处在于自注意力机制 (Self-Attention) 的计算方式------内积 (Dot Product)。
当我们计算两个词(Query 和 Key)的相似度(内积)时,数学上有一个神奇的特性: 旋转后的两个向量的内积,只取决于它们之间旋转角度的差值(相对距离),而与它们的绝对角度无关。
-
场景 A:
-
词 A 在第 1 位(转 10 度)。
-
词 B 在第 3 位(转 30 度)。
-
相对差距:20 度。
-
-
场景 B:
-
词 A 在第 100 位(转 1000 度)。
-
词 B 在第 102 位(转 1020 度)。
-
相对差距:还是 20 度!
-
结论 :在模型眼中,场景 A 和场景 B 是一模一样 的。模型不需要知道"我们在第 100 位",它只需要知道"B 在 A 后面两步远的地方"。
这就是相对位置编码 (Relative Positional Encoding) 的终极形态。
3.🚀 RoPE 的三大优势
为什么 Llama 抛弃了经典的绝对位置编码(Add),全都拥抱 RoPE?
A. 完美的"平移不变性" (Translation Invariance)
正如上面所说,只要两个词的距离固定,无论它们搬到句子的哪里,它们的注意力分数都是一样的。这非常符合人类理解自然语言的逻辑("因为"和"所以"的逻辑关系,不应该受它们出现在文章开头还是结尾的影响)。
B. 更好的"外推性" (Extrapolation) ------ 长文本的关键
这是 RoPE 最强的地方。
-
绝对编码 (加法):训练时只见过长度 2048 的文章。测试时来了个 4096 的,模型看到"位置 3000"的编码直接懵了,因为从来没见过这个数值。
-
RoPE (旋转):
-
训练时见过"转 10 度"到"转 20480 度"。
-
测试时来了个"转 30000 度"。
-
虽然角度变大了,但正弦/ 余弦 函数是周期性的!对于模型来说,这依然是熟悉的数学规律,只是转得圈数多了一点而已。
-
结果:RoPE 让模型更容易处理比训练长度更长的文本(虽然也需要配合一些"线性内插"等技巧)。
-
C. 无需增加额外参数
RoPE 不需要像 BERT 那样专门学习一个"位置嵌入矩阵",它只是一个固定的数学公式(旋转矩阵),不占模型参数,计算效率极高。
4.🧠 技术细节:高维怎么转?
你可能会疑惑:"词向量通常有 4096 维,怎么在二维平面转?"
RoPE 的做法是**"分而治之"**:
-
它把 4096 维的向量,两两分组,切成 2048 对。
-
每一对(2个数字)看作一个二维平面,分别进行旋转。
-
不同的维度对,旋转的**频率(速度)**不一样。有的转得快(捕捉局部关系),有的转得慢(捕捉长距离关系)。
总结
RoPE (旋转位置编码) 是现代大模型的**"相对论"** 。
它抛弃了僵硬的"座位号"(绝对位置),转而通过优雅的几何旋转,让模型掌握了**"距离"** 的概念。
当你听说某个模型支持 128k 甚至 1M 的超长上下文时,其背后最大的功臣往往就是 RoPE 及其变种(如 NTK-Aware RoPE, Yarn 等)。它是 Llama 系列成功的基石之一。