当网络监控系统在深夜突兀地发出数百条告警,而真正的故障却在信息洪流中被淹没,运维团队的焦虑便不言而喻。告警风暴------并非预警的胜利,而是效率的灾难:大量低价值、重复或无关的告警不仅消耗团队精力,更导致关键故障响应延迟,延长业务中断时间(MTTR)。根据行业调研,超过65%的运维团队因告警泛滥而无法及时处理核心问题。本文将聚焦OpManager的智能告警配置能力,提供一套系统化、可落地的策略,帮助您从源头精简告警,精准识别根因,让每一次告警都成为可操作的行动信号,而非信息负担。
一、智能告警:从"被动响应"到"精准聚焦"
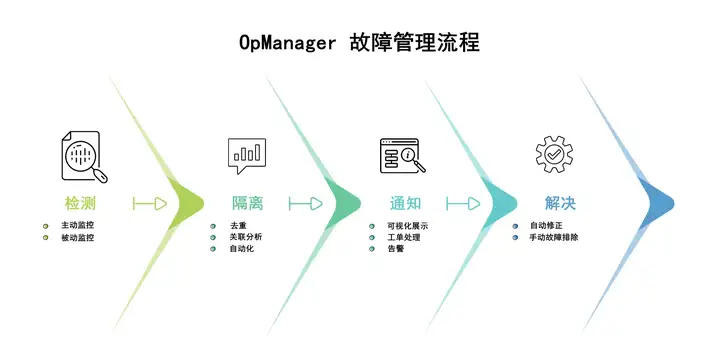
传统监控系统往往采用"全量告警"模式,任何设备异常即触发告警,导致告警数量呈指数级增长。这种模式下,核心问题常被淹没在冗余告警中,MTTR显著上升。智能告警的核心价值在于通过策略性配置,确保告警的精准性与可操作性 ,而非简单削减数量。OpManager的网络故障管理基于业务影响与技术指标的深度关联,实现告警的"去噪"与"提纯"。
二、智能告警配置的四大核心策略
1. 基于业务影响的告警分级
告警不应仅反映技术状态,而需关联业务价值。OpManager支持为设备、服务定义三级告警级别(Attention/关注、Trouble/问题、Critical/严重),并根据业务优先级动态调整阈值。
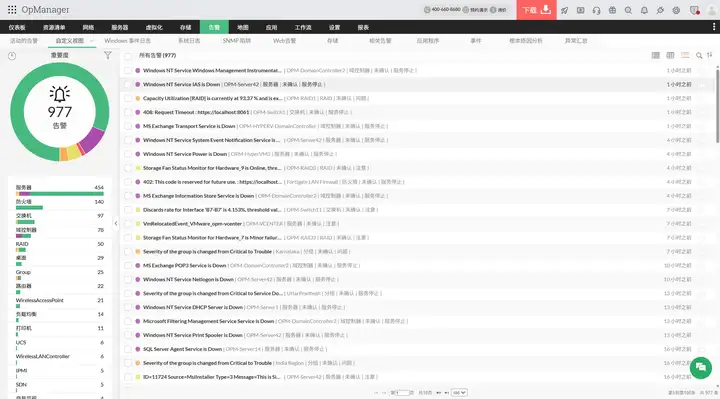
配置实践:为电商核心服务器设置CPU阈值为80%(Critical),而普通办公终端则设为90%。当告警触发时,系统同步显示"该故障将影响订单处理率下降15%",让团队优先处理高业务影响问题。
2. 事件关联与根本原因分析聚合
网络故障常引发连锁告警。OpManager的智能事件关联功能自动识别设备依赖关系,将相关告警聚合为单一"根因告警",避免告警级联。
配置实践:配置核心交换机故障关联规则。当交换机宕机时,系统仅生成一条"核心网络中断"告警,而非触发连接的50台服务器的100+告警,减少95%的冗余信息。
3. 自适应阈值动态优化
固定阈值难以适应网络波动。OpManager的自适应阈值引擎基于历史性能数据(如业务高峰期、季节性波动),自动调整告警阈值,显著降低误报率。
配置实践:为数据中心服务器启用自适应阈值。系统在双11大促期间自动将CPU阈值从75%动态提升至85%,避免因正常业务高峰触发误告警。
4. 预测告警与自动化运维联动
传统告警多为事后响应,难以规避潜在风险。OpManager 的预测告警功能基于历史性能数据、设备趋势分析及 AI 算法,提前识别磁盘空间不足、端口流量饱和、服务器负载异常升高等潜在故障,同步提供针对性优化建议(如日志清理、带宽扩容、资源调度方案)及故障后续影响评估(如是否影响核心业务、关联设备范围)。
告警触发后可直接关联自定义工作流(如自动执行磁盘清理脚本、端口流量分流策略)或生成标准化工单并分配至对应运维团队,实现从风险预测、智能建议到自动化处置的全流程闭环。
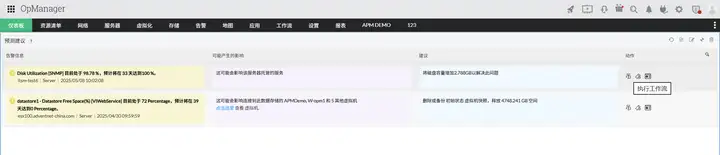
配置实践:为数据中心核心服务器配置磁盘空间预测告警。系统通过分析近 30 天磁盘占用增长率,提前 7 天识别出磁盘使用率将达 90% 的风险,自动推送 "清理过期日志 / 迁移非核心数据" 的优化建议,同时触发预定义工作流 ------ 执行日志清理脚本释放 50GB 空间,并生成工单同步至存储运维团队跟进长期扩容方案,避免因磁盘满导致业务系统宕机。
三、智能告警配置实操路径
1. 多通道告警的精准触达
避免告警淹没,需按严重性匹配通知渠道。OpManager支持邮件、短信、Slack、Teams等多通道配置,并设置优先级规则。
实施步骤:
- 在"通知配置"中,为严重级告警绑定企业微信+短信,确保2分钟内触达值班人员;
- 为注意级告警仅推送至Web控制台,避免非紧急信息干扰;
- 设置"告警升级"规则:30分钟未响应的Critical告警自动升级至团队主管。
2. 告警升级机制的自动化执行
确保关键问题不被遗漏。OpManager的告警升级规则基于时间阈值与严重级别动态触发,自动将未解决告警升级至指定人员,避免因忽视导致业务中断。
实施步骤:
- 设置时间阈值:在\"未清除内间隔\"中配置告警持续时间(如15分钟),超时未处理自动触发升级;
- 定义升级规则:选择告警严重级别(如Critical)、关联业务视图(可选\"无\"覆盖全设备),勾选\"排除已确认告警\";
- 配置通知通道:在邮件/短信字段中设置接收人、主题及内容,确保未解决告警通过多通道精准触达指定人员。
3. 根因分析(RCA)的深度集成
快速定位问题根源,而非仅处理症状。OpManager的RCA功能自动聚合设备、链路、服务多维度数据。
实施步骤:
- 为关键业务服务创建RCA配置:关联服务器、网络设备、应用日志;
- 添加核心指标:CPU、带宽利用率、接口错误率;
- 启用"自动根因推断":当告警触发时,系统自动生成根因报告(如"核心交换机端口故障导致支付服务延迟")。
4. 与ITSM系统无缝集成
将告警转化为工单,打通运维闭环。OpManager支持与ManageEngine ServiceDeskPlus、ServiceNow、Jira等ITSM平台深度集成。
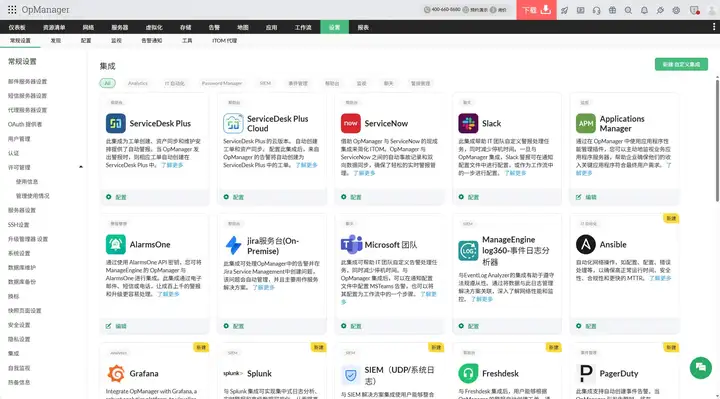
实施步骤:
- 在"集成设置"中配置ServiceDeskPlus连接;
- 定义规则:Critical级告警 → 自动创建P1工单;
- 映射关键字段:将告警的"业务影响"字段映射至工单的"影响范围";
- 验证:测试告警转工单流程,确保SLA响应时间达标。
四、业务级告警:从技术指标到业务价值
智能告警的终极目标是让技术指标服务于业务决策。OpManager的业务服务管理功能实现三步转化:
- 定义服务:将网络设备关联至业务(如"支付服务"关联至核心服务器与负载均衡器);
- 量化影响:为服务设置SLA(如支付成功率≥99.95%);
- 告警关联:告警触发时显示"当前故障将使支付成功率降至99.8%,超出SLA容忍阈值"。
典型案例:当数据库连接池耗尽时,OpManager告警不仅显示"连接池满",更标注"该故障将导致支付失败率上升至4%,预计影响10万用户",团队可立即评估是否启动应急预案。
五、结语:构建高效告警体系,释放运维价值
规避"告警风暴"并非追求告警数量的减少,而是通过智能配置,确保告警的精准性、及时性与业务价值。OpManager的智能告警引擎已帮助全球3000+企业实现:
- 告警量降低70%:消除低价值告警干扰;
- MTTR缩短50%:关键问题响应提速;
- SLA达成率提升:业务连续性保障更可靠;
- 团队效率释放:运维人员从"救火"转向"预防"。
在业务连续性至上的今天,网络告警系统不应是噪音源,而应是导航灯。OpManager通过智能运维的告警配置,助您将信息洪流转化为行动信号,让每一次告警都值得响应。
即刻行动:下载OpManager 30天免费试用版,配置您的智能告警体系,亲历告警风暴的终结。