一、研究背景
实际工程与科学数据(如振动信号、电力负荷、金融时序)常呈现非线性、非平稳特征,单一预测模型难以充分提取多尺度信息。为此,结合自适应信号分解 (CEEMDAN、VMD)与深度学习(Transformer、GRU)成为提升预测精度的有效手段。本代码实现了一套"分解-聚类-再分解-分量预测-重构"的完整流程,旨在提高复杂时间序列的预测性能。
二、主要功能
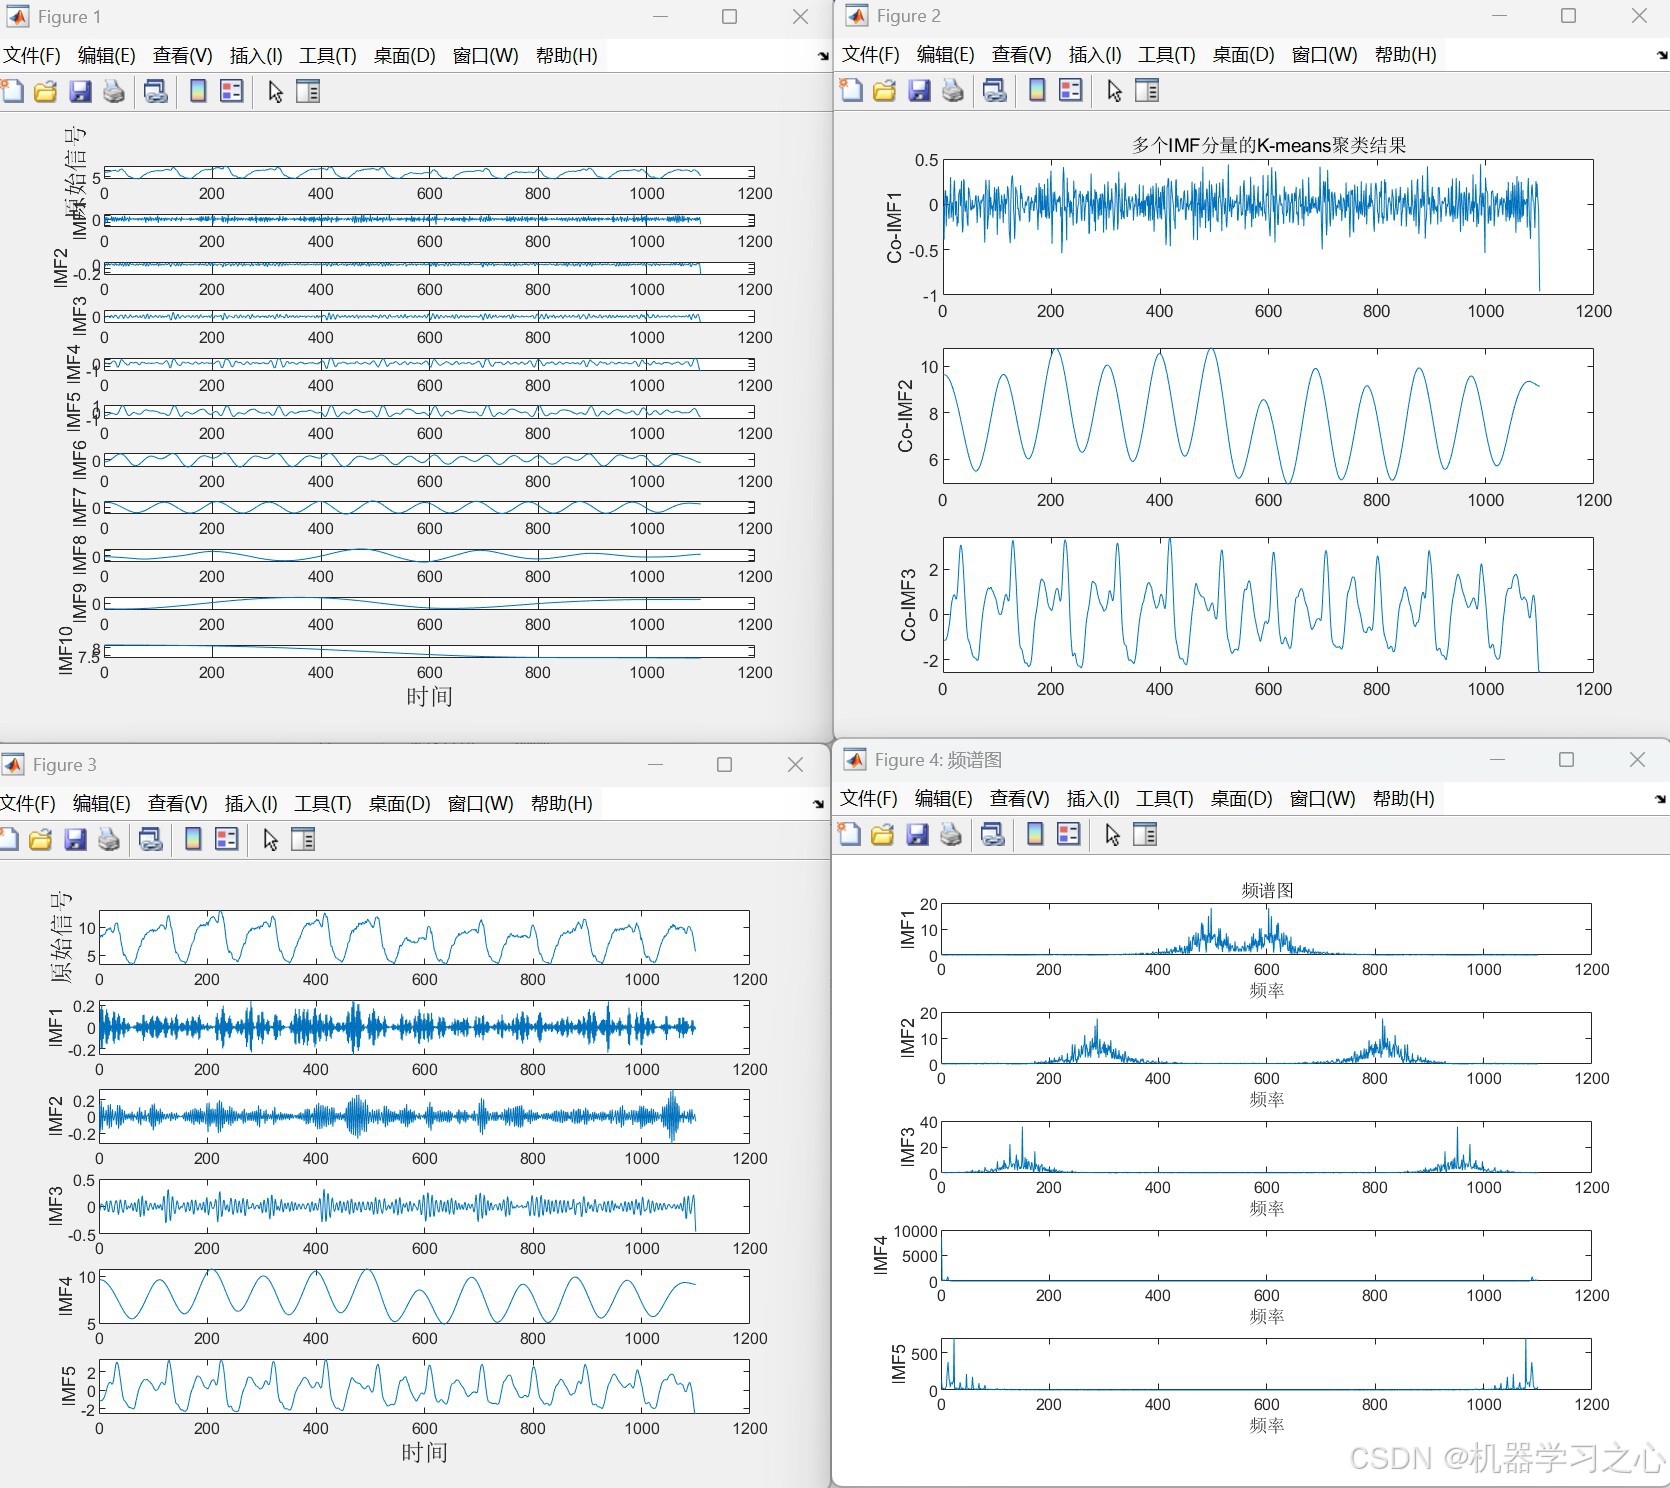
- 对原始信号进行CEEMDAN分解,获得若干本征模态函数(IMF)。
- 计算各IMF的样本熵 ,利用K‑means聚类将IMF合并为高频、中频、低频三组。
- 对高频重组信号实施VMD二次分解,进一步分离复杂模态。
- 对每个最终分量分别构建Transformer‑GRU混合模型进行预测。
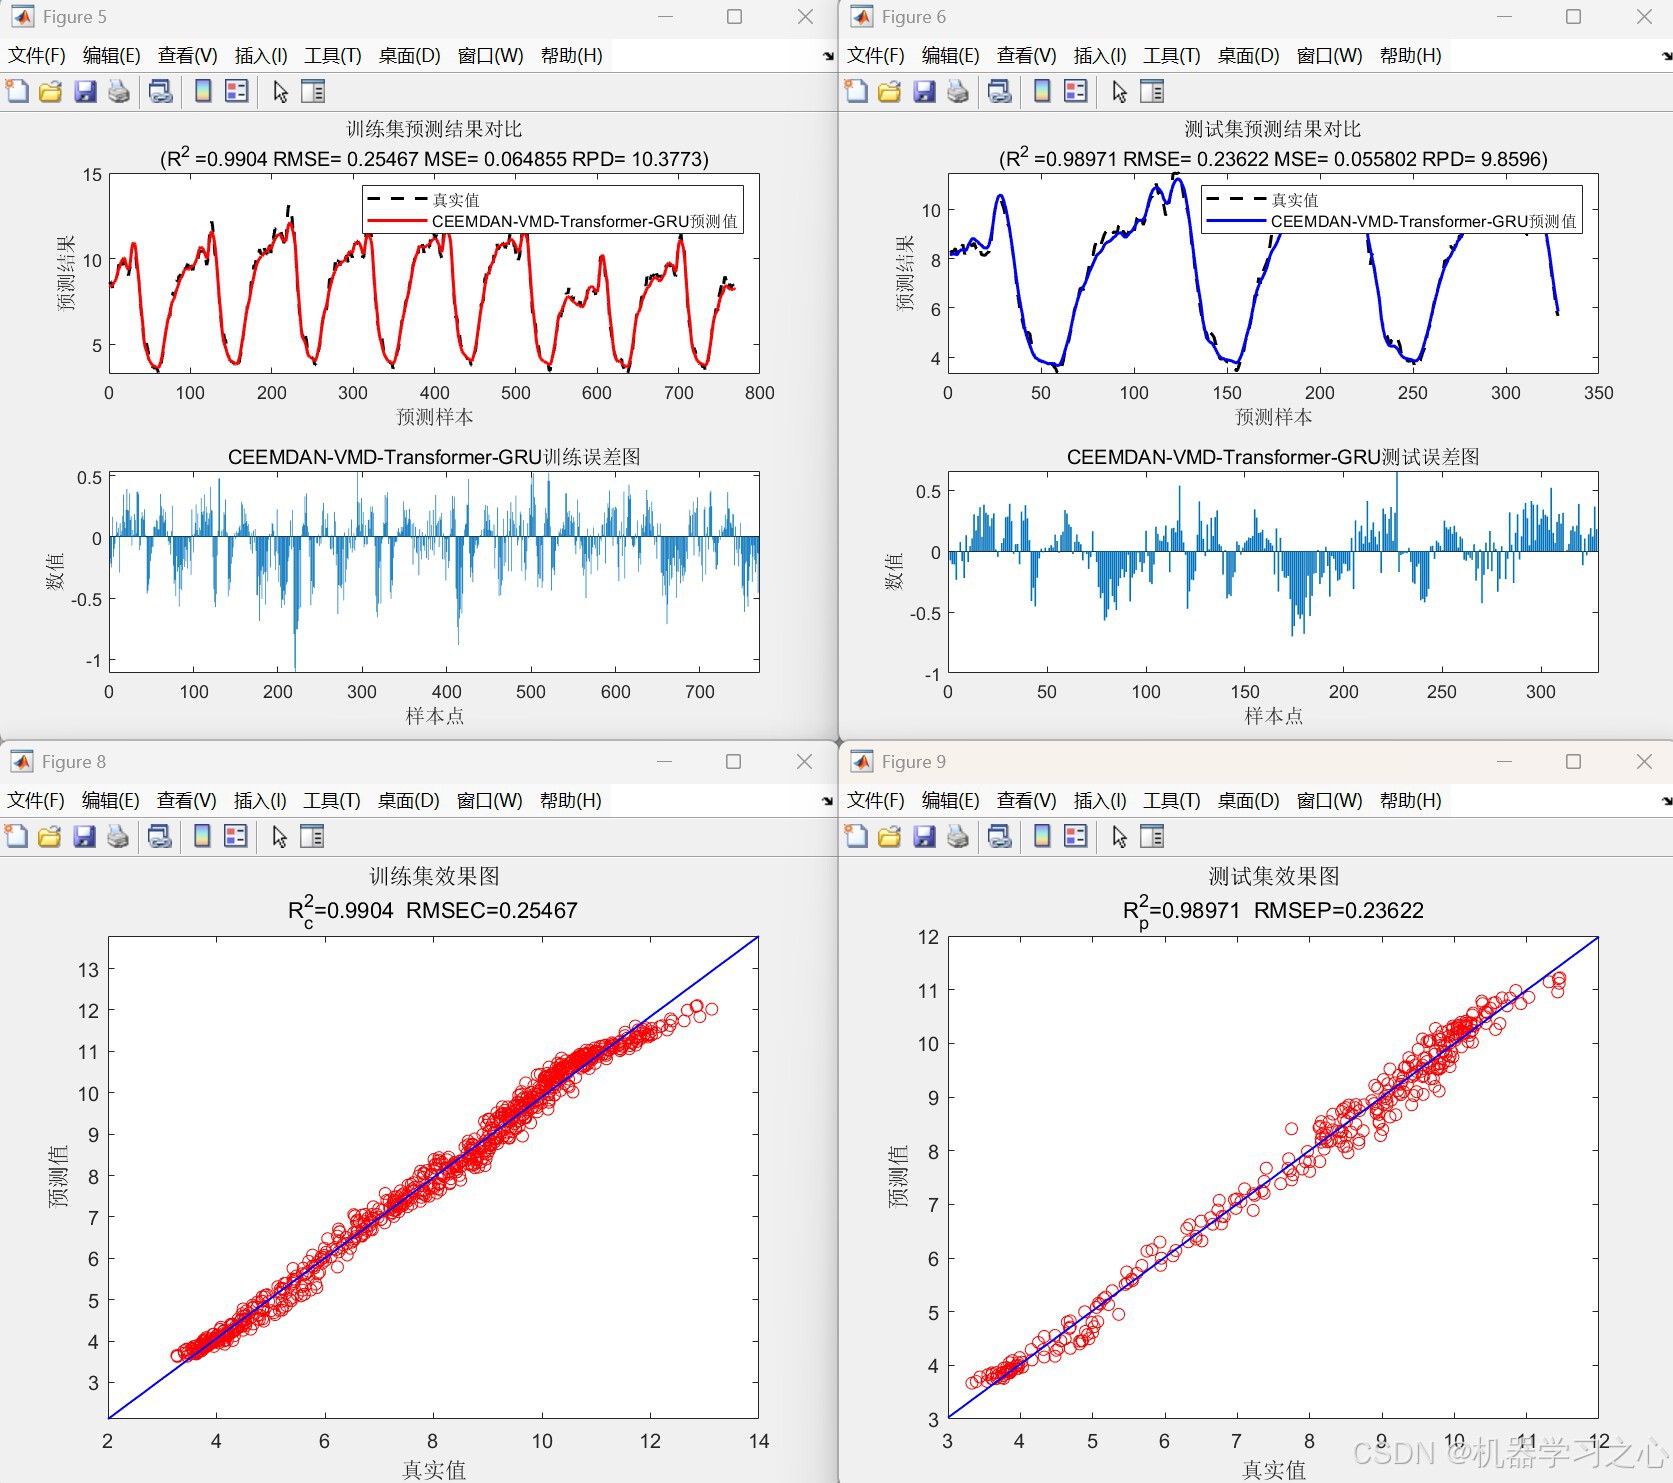
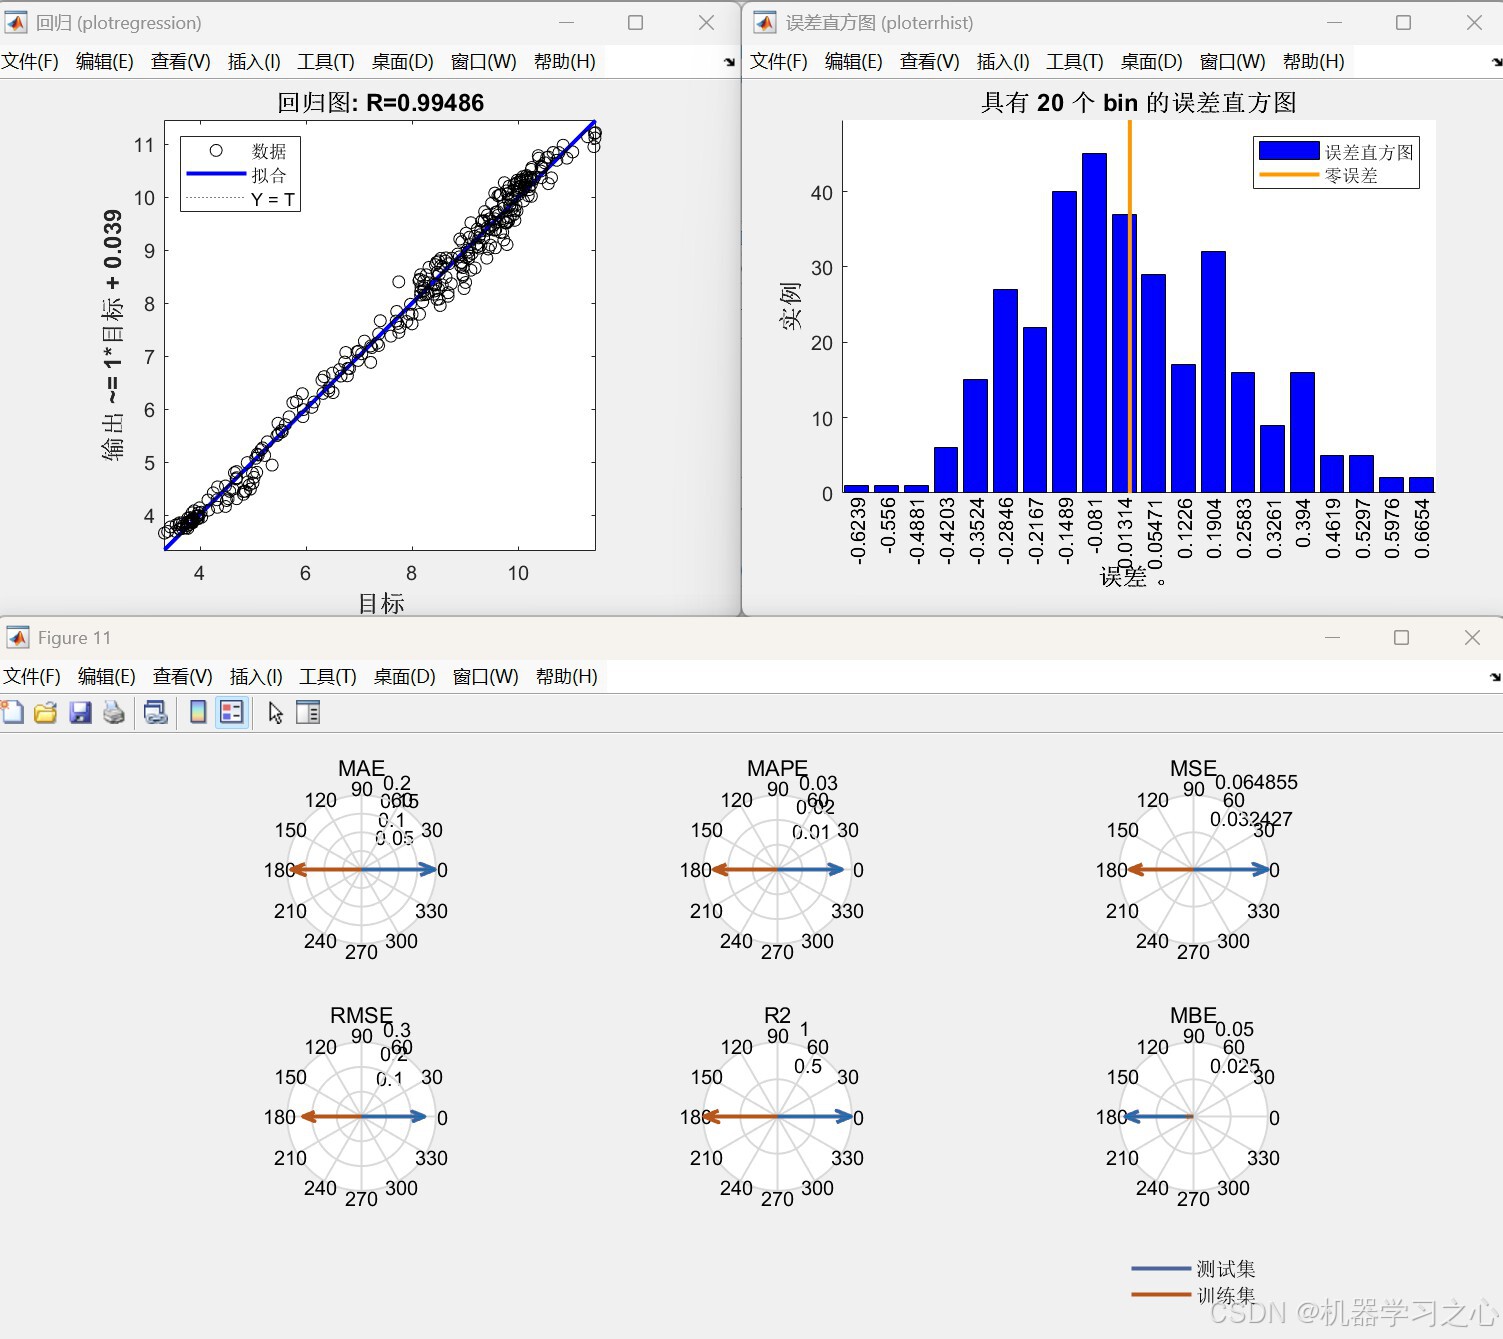
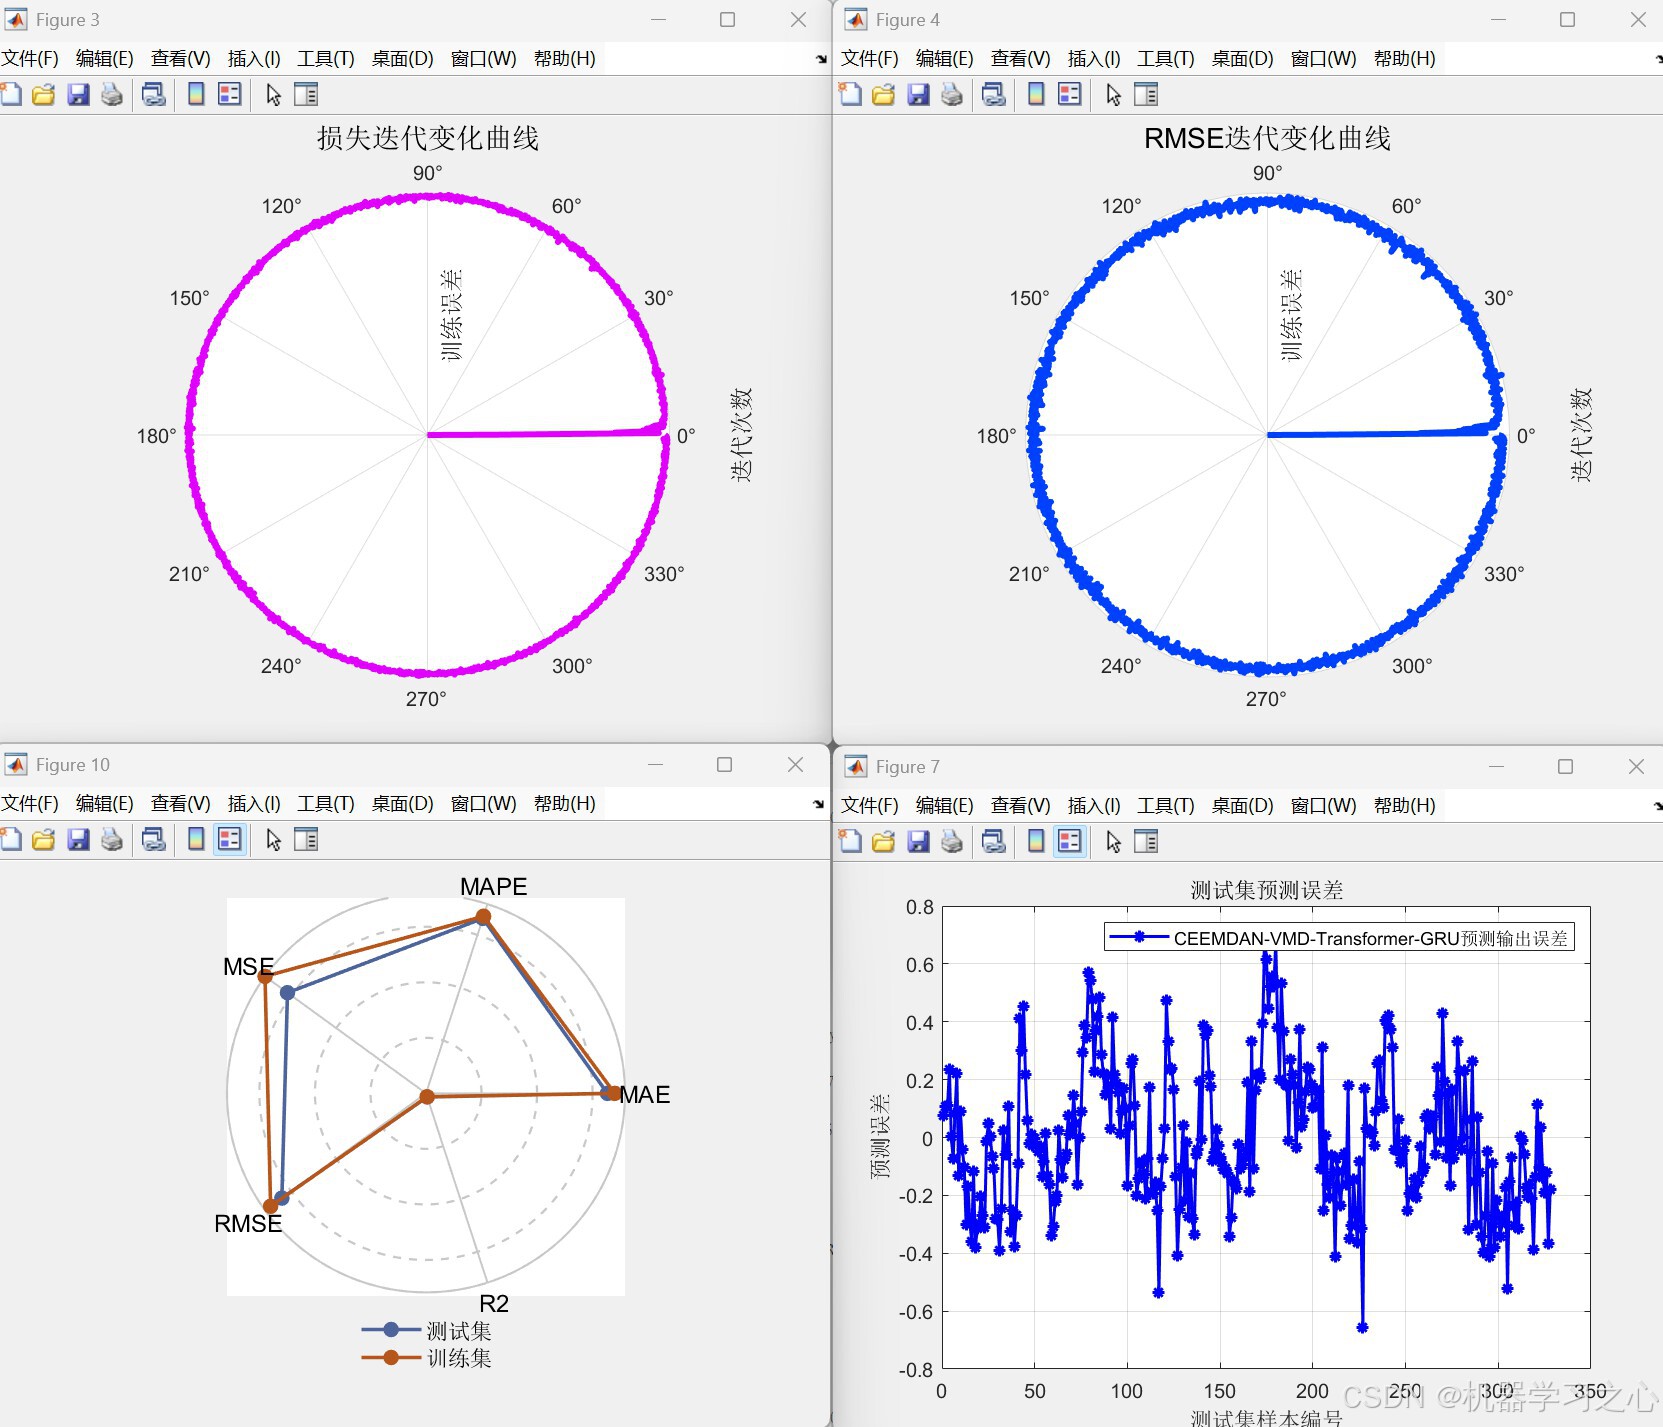
- 叠加各分量预测结果,输出最终预测值,并计算多种评价指标(MAE、RMSE、R²、MAPE等),绘制雷达图、罗盘图等可视化结果。
三、算法步骤
| 步骤 | 内容 |
|---|---|
| 1. 数据导入 | 读取Excel文件,取最后一列作为待预测序列。 |
| 2. CEEMDAN分解 | 参数 Nstd=0.2, NR=500, MaxIter=5000,得到多个IMF分量。 |
| 3. 样本熵计算与K‑means聚类 | 嵌入维数dim=2,相似容限r=0.2×std,计算每个IMF的样本熵;聚类数K=3,将IMF归为高频、中频、低频三类。 |
| 4. 高频分量VMD二次分解 | 对聚类后的高频和信号进行VMD(K=3),得到3个模态,与中频、低频和信号合并。 |
| 5. 各分量独立建模预测 | 对每个分量构建Transformer‑GRU 网络: - 输入:延时步长kim=2的历史数据 - 输出:未来1步预测值 - 网络结构:位置嵌入 + 两层自注意力 + GRU + 全连接回归层 - 训练参数:学习率0.01,L2正则化0.001,最大轮数500,批量256。 |
| 6. 预测结果叠加与评估 | 将所有分量预测值求和,反归一化后计算MAE、MSE、RMSE、R²、RPD、MAPE等指标,并绘制对比图、误差图、雷达图等。 |
四、技术路线
原始信号
CEEMDAN分解
计算样本熵
K-means聚类
高频重组信号
VMD分解
各分量
Transformer-GRU预测
预测值求和
性能评估
五、公式原理
- CEEMDAN:在EMD基础上添加自适应白噪声,通过多次平均消除模态混叠。
- 样本熵 :衡量序列复杂度,公式为 SampEn(m,r,N)=−ln(AB)SampEn(m,r,N) = -\ln\left(\frac{A}{B}\right)SampEn(m,r,N)=−ln(BA),其中mmm 为嵌入维数,rrr 为相似容限。
- K‑means :最小化簇内平方和 ∑i=1k∑x∈Ci∥x−μi∥2\sum_{i=1}^{k}\sum_{x \in C_i} \|x - \mu_i\|^2∑i=1k∑x∈Ci∥x−μi∥2。
- VMD :通过求解约束变分问题自适应分解信号,目标函数为 minuk,ωk{∑k∥∂t(δ(t)+jπt)∗uk(t)e−jωkt∥22}\min_{u_k,\omega_k} \left\{ \sum_k \|\partial_t (\\delta(t)+\\frac{j}{\\pi t})\*u_k(t) e^{-j\omega_k t}\|_2^2 \right\}minuk,ωk{∑k∥∂t(δ(t)+πtj)∗uk(t)e−jωkt∥22}。
- Transformer自注意力 :Attention(Q,K,V)=softmax(QKTdk)VAttention(Q,K,V)=softmax\left(\frac{QK^T}{\sqrt{d_k}}\right)VAttention(Q,K,V)=softmax(dk QKT)V,结合位置编码捕捉长时依赖。
- GRU :包含更新门 ztz_tzt 和重置门 rtr_trt,缓解RNN梯度消失问题。
六、参数设定
| 参数 | 值 | 说明 |
|---|---|---|
| CEEMDAN | Nstd=0.2, NR=500, MaxIter=5000 |
噪声标准差、集成次数、最大迭代 |
| 样本熵 | dim=2, tau=1, r=0.2*std |
嵌入维数、延迟、相似容限 |
| K‑means聚类数 | 3 |
高频、中频、低频三类 |
| VMD分解数 | K=3 |
高频信号二次分解的模态数 |
| Transformer头数 | numHeads=8 |
自注意力头数 |
| GRU隐藏单元 | best_hd=64 |
GRU层神经元数量 |
| 学习率 | 0.01 |
Adam初始学习率 |
| L2正则化 | 0.001 |
防止过拟合 |
| 训练轮数 | 500 |
最大迭代次数 |
| 批量大小 | 256 |
Mini-batch尺寸 |
七、运行环境
- 软件:MATLAB(R2024b以上)
八、应用场景
- 机械故障诊断:振动信号的多尺度分解与趋势预测
- 电力负荷预测:处理非平稳负荷数据,提高预测精度
- 金融时间序列:股票、汇率等复杂波动模式建模
- 气象/环境数据:温度、PM2.5浓度等时序预测
- 生物医学信号:心电、脑电信号分析与预测