强化学习4.1:基于价值——Q-learning

概念

是一种离线策略(off-policy) 的时序差分(TD)强化学习算法,用于学习最优动作价值函数 ,且不需要环境模型

核心思想

通过不断更新 Q 值,使 Q 函数逼近最优值。

更新时使用的目标值基于 贪婪选择 (取下一状态的最大 Q 值),但实际执行动作时可以遵循其他策略(如 ε-贪婪),因此是 离线策略 算法

更新公式
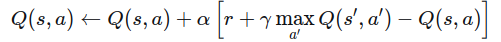
  • s:当前状态

  • a:当前执行的动作

  • r:获得的奖励

  • s′:下一状态

  • α:学习率(0~1,控制更新幅度)

  • γ:折扣因子(0~1,平衡即时与未来奖励)

  • max⁡a′Q(s′,a′):在下一状态所有动作中,选择最大的 Q 值

算法流程

复制代码
初始化 Q(s,a) 为任意值(通常 0)
对每个 episode:
    初始化状态 s
    对 episode 中的每一步:
        根据策略(如 ε-贪婪)从 Q 选择动作 a
        执行动作 a,观察奖励 r 和下一状态 s'
        Q(s,a) ← Q(s,a) + α [ r + γ * max_{a'} Q(s',a') - Q(s,a) ]
        s ← s'
    直到 s 为终止状态

什么时候用 Q-learning?

  • 状态和动作空间 离散且较小(可用表格存储)

  • 想学习 确定性最优策略

  • 环境没有模型,需要从交互中学习

如果状态空间很大(如图像),就需要 深度 Q 学习(DQN)

相关推荐
开开心心就好10 分钟前
两张表格数据对比工具,不用写函数也能查
算法·spring·智能手机·pdf·电脑·intellij-idea·音视频
天天代码码天天36 分钟前
输入一句话,生成一段声音:我做了个 Windows 本地音效工具
人工智能
kaixin_啊啊38 分钟前
【三种鲑科鱼类比较基因组学分析鉴定出参与细胞内寄生菌鲑立克次体抗性的功能候选基因】论文学习
学习
tellmewhoisi41 分钟前
深度学习0:数学知识:(雅可比矩阵)
人工智能·深度学习·矩阵
电科_银尘1 小时前
【大模型算法与工程 02】线性回归与逻辑回归:从损失函数到决策边界
算法·逻辑回归·线性回归
美团技术团队1 小时前
《Agent评测白皮书》业务实践篇:商家 AI 助手的评测与优化闭环实践
人工智能
京东云开发者1 小时前
京东11.11大促系列|Super Agent 进群:今年11.11,多了个会主动干活的"数字人队长"
人工智能
对你无可奈何2 小时前
把零散的模型用起来:Magpie 接入 Trae,再折腾两个池子
人工智能
玄昌盛不会编程2 小时前
LeetCode——2243. 计算字符串的数字和
java·算法·leetcode
七夜zippoe2 小时前
流式输出:让 AI 回答像打字机一样实时返回(SSE 全链路实战)
人工智能·spring·ai·流式输出·ssf