文章目录
- [1. 目标](#1. 目标)
- [2. 架构总览](#2. 架构总览)
- [3. 连接层](#3. 连接层)
-
- [3.1 网络端口](#3.1 网络端口)
- [3.2 网络连接管理](#3.2 网络连接管理)
- [3.3 客户端连接管理](#3.3 客户端连接管理)
- [3.4 网络连接量管理](#3.4 网络连接量管理)
- [4. 服务层](#4. 服务层)
-
- [4.1 服务管理与公共组件](#4.1 服务管理与公共组件)
- [4.2 Parser(语法解析器)](#4.2 Parser(语法解析器))
- [4.3 Optimizer(优化器)](#4.3 Optimizer(优化器))
- [4.4 Cache&Buffer(缓存)](#4.4 Cache&Buffer(缓存))
- [4.5 SQL的整体执行流程](#4.5 SQL的整体执行流程)
- [5. 存储引擎层](#5. 存储引擎层)
-
- 5.1Innodb
-
- [5.1.1 支持功能](#5.1.1 支持功能)
- [5.1.2 Innodb的优势](#5.1.2 Innodb的优势)
- [5.1.3 创建 InnoDB 表](#5.1.3 创建 InnoDB 表)
- 5.1.4最佳实践
- [5.2 MyISAM](#5.2 MyISAM)
-
- [5.2.1 支持功能](#5.2.1 支持功能)
- [5.2.2 MyISAM的优势](#5.2.2 MyISAM的优势)
- [5.2.3 创建 MyISAM 表](#5.2.3 创建 MyISAM 表)
- [5.2.4 MyISAM表存储格式](#5.2.4 MyISAM表存储格式)
-
- [5.2.4.1 静态表格式](#5.2.4.1 静态表格式)
- [5.2.3.2 动态表格式](#5.2.3.2 动态表格式)
- [5.2.3.3 压缩表格式](#5.2.3.3 压缩表格式)
- [5.3 Memory](#5.3 Memory)
-
- 5.3.1特性
- [5.3.2 内存管理](#5.3.2 内存管理)
- [5.4 CSV](#5.4 CSV)
-
- [5.4.1 特性](#5.4.1 特性)
- [5.5 MyISAM和Innodb的区别](#5.5 MyISAM和Innodb的区别)
-
-
- [1. 事务支持与 ACID 特性 (最核心的区别)](#1. 事务支持与 ACID 特性 (最核心的区别))
- [2. 锁的粒度与并发能力](#2. 锁的粒度与并发能力)
- [3. 索引的底层存储结构 (聚集 vs 非聚集)](#3. 索引的底层存储结构 (聚集 vs 非聚集))
- [4. 外键支持 (Foreign Keys)](#4. 外键支持 (Foreign Keys))
- [5. 崩溃后的安全恢复](#5. 崩溃后的安全恢复)
- [6. 文件物理存储形式](#6. 文件物理存储形式)
- [7. `COUNT(*)` 的查询性能](#7.
COUNT(*)的查询性能) - [8.📊 对比速查表](#8.📊 对比速查表)
-
1. 目标
了解MySQL整体架构
了解MySQL架构各层级有哪些组件以及对应的作用
2. 架构总览
MySQL由连接池、NoSQL接口、SQL接口、SQL解析器、优化器、缓存、存储引擎、文件系统 组成。
此外为了方便外部程序访问MySQL,MySQL针对不同编程语言提供了对应的连接工具(MySQL Connector ),例如JDBC等。
具体架构图如下:
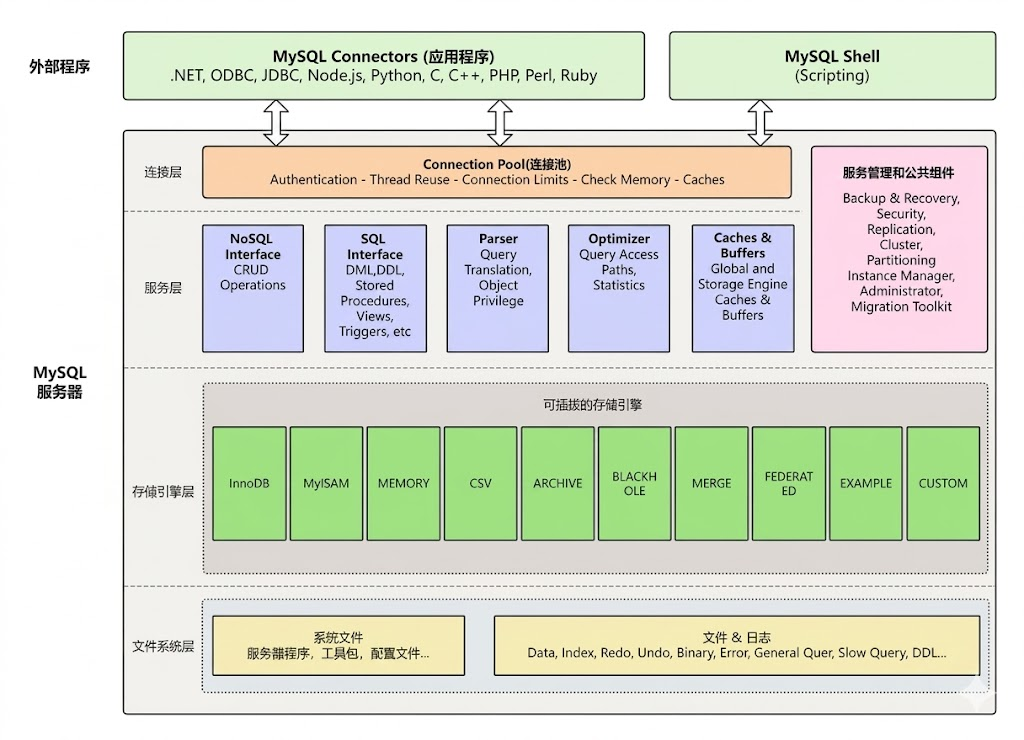
- MySQL Connectors: 为不同的编程语言提供访问MySQL的接口。
- MySQL Shell: 一个高级客户端和代码编辑器,要单独安装,可提供MySQL客户端相关功能,并且可以通过python调用MySQL相关API。
- 连接层: 对客户端连接进行权限校验并且保存客户端连接信息,提供了连接池技术,提升性能,并且提供最大连接数配置,。
- 公共服务、组件: 提供了备份/灾难恢复 、数据安全 、主从复制 、分库分表等实用功能。
- 服务层: 提供了SQL处理,相关API、解析器、优化器,处理SQL语句,并将处理结果给到存储引擎进行具体SQL操作。
- 存储引擎层: 与业务数据和系统文件进行交互,负责数据的增删查改;MySQL采用可插拔存储引擎架构,可通过不同场景使用合适的存储引擎。
- 系统文件层: 包含了MySQL程序及业务的系统文件、数据文件、日志文件。
3. 连接层
3.1 网络端口
一台MySQL服务器可以监听多个端口,客户端可以通过开放的端口与MySQL服务器进行网络连接。
我们可以通过配置文件配置:
shell
[mysqld]		#mysql节点
port=3306	#开放端口1
port=3307	#开放端口2
3.2 网络连接管理
MySQL会和操作系统(Linux、windows...)配合,通过连接管理线程获取从指定端口发来的网络请求,给到MySQL服务端的客户端连接管理线程进行处理
3.3 客户端连接管理
服务端接收到来自网络连接管理线程的请求后,不会实际处理这个MySQL客户端发来的请求,而是去查询线程池中有没有空余线程,如果有,由该空闲线程处理该请求(例如身份校验)。
如果连接池已经满了,那么MySQL服务端会将其放到等待队列,等待空闲线程。
这实际上就是运用池化技术,减少线程的创建和销毁次数,提升资源利用率,用完的线程可以直接回到线程池,继续接任务,而不是直接销毁
此外我们可以灵活控制连接池空闲线程的数量以及每个空闲线程可被分配的栈空间大小:
shell
[mysqld] #mysql节点
thread_cache_size=16 #最大空闲线程数量
thread_stacks=1024	  #每个线程的栈空间大小,单位byte
3.4 网络连接量管理
为了避免MySQL服务端崩溃,我们可以限制MySQL服务端与客户端的连接数量(max_connections)
- 当服务端连接请求等于
max_connections之后,后续来自客户端的连接请求会被拒绝 - 连接被拒绝后,会记录到MySQL服务端的
Connection_error_max_connections变量(递增)中; - mysql实际上运行
max_connectios+1个连接,额外的一个连接只允许mysql连接管理员使用,相当于做了冗余; - 如果达到了
max_connections,mysql主从复制无法进行,数据同步请求操作会被拒绝;
4. 服务层
4.1 服务管理与公共组件
MySQL提供多种服务组件,可针对不同场景使用:
- Backup & Recovery: 备份与恢复
- Security: 安全
- Replication: 主从复制
- Cluster: MySQL集群
- Partitioning: 表分区
- Instance Manager: 实例管理
- Administrator: MySQL管理员
- Migration Toolkit: 迁移工具包
4.2 Parser(语法解析器)
语法分析器的主要作用是将客户端发来的SQL语句中的关键字和自定义字段进行提取、解析,最终将 SQL 语句转换为一棵解析树,分析的过程中包含词法分析 和语法分析 ;
词法分析,主要是对关键字进行提取,比如 select/update/delete/create... ;
语法分析,主要判断 SQL 语句是否满足语法规则,如果语法错误则抛出异常,也就是我们常见的ERROR 1064 (42000): You have an error in your SQL syntax。
sql语句解析流程图:
sql
select sn, name from student where id = 1;
                       |
        ┌──────────────┼──────────────┬──────────────┬──────────────┐
      select         fields          from          tables          where         conditions
                      |                               |                              |
               ┌──────┴──────┐                    student                        equal
               |             |                                                   |
              sn           name                                         ┌────────┴────────┐
                                                                         |                 |
                                                                        id                 1
4.3 Optimizer(优化器)
优化器拿到解析器的解析树后,会根据解析树生成查询计划,一般一个查询·会有多种执行路径,优化器会根据查询计划选择最合适的索引进行查询,提升sql查询性能。
TIPS:
优化后的sql可能和程序员写的sql不一样,但是可以保证查询结果是一致的。
例如:原本sql是
where name = 'ace' and id = 1,优化器为了充分利用索引,把索引id提前:where id = 1 and name = 'ace'
优化器整理出最优查询方案后,会通过存储引擎API,把查询方案给到存储引擎取操作curd
4.4 Cache&Buffer(缓存)
MySQL服务层中的缓存主要是为了提升查询效率,如果一个sql语句被多次使用,那么服务会通过key-value的方式将其存储到内存中,如果数据查询前没有被修改,那么直接返回内存中的数据,若被查询数据被修改,则更新缓存。
这个机制在MySQL5.6中默认不再开启,并且在MySQL8.0中被移除,因为它针对写多读少的场景性能非常低。
4.5 SQL的整体执行流程
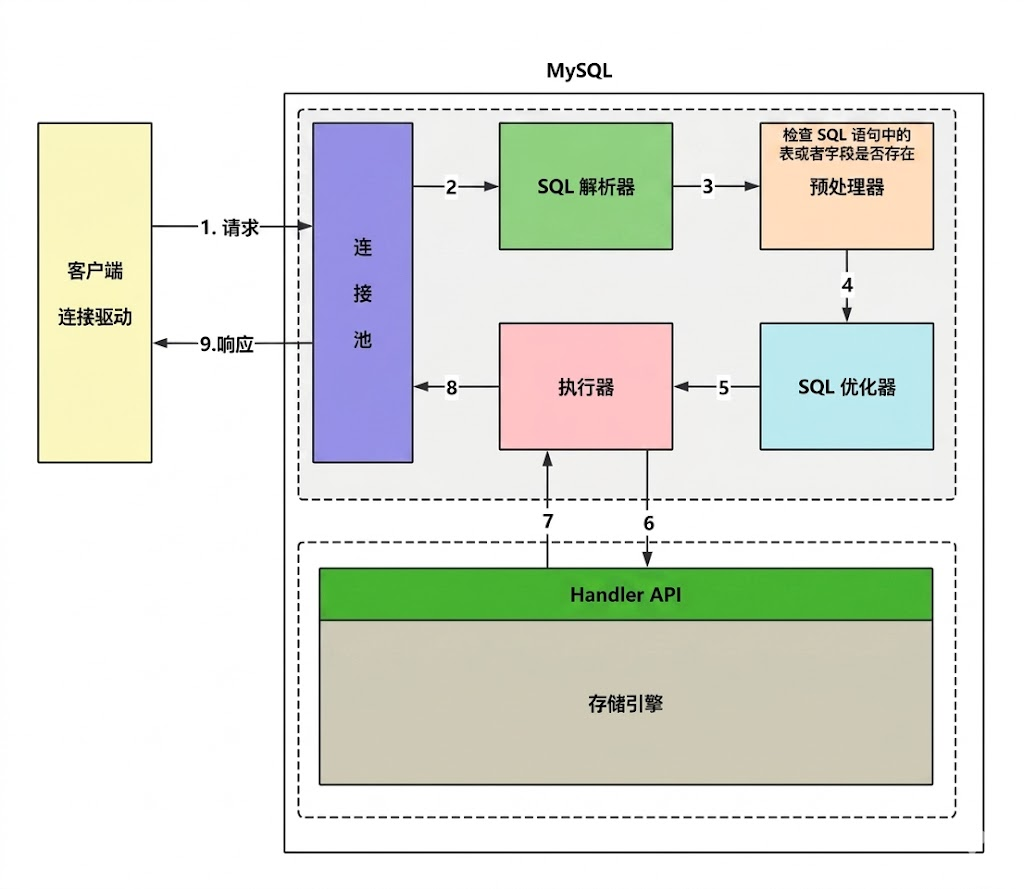
- noSQL \SQL接口(用于接受客户端sql语句与命令并且返回mysql服务的处理后的数据)
- sql解析器(解析sql,包括词法分析(校验关键词是否正确)、语法分析(关键字和自定义字段搭配是否符合语法要求))
- sql预处理(校验表、字段是否在数据库中存在)
- sql优化器(sql解析器会生成一个sql结构数,可以通过不同路径查询到数据,sql优化器会查询最优路径,把最优路径给到sql执行器执行,提升查询效率)
- 服务层
- 存储引擎层
- 文件系统层
5. 存储引擎层
存储引擎是专门与MySQL数据文件交互把查询结果返回的直接处理组件,MySQL中采用可插拔存储引擎架构,服务器运行时我们可以动态的加载和卸载;
我们可以通过SHOW ENGINES;查看我们的MySQL支持哪些存储引擎
5.1Innodb
5.1.1 支持功能
Innodb是兼具可靠性和高性能的通用存储引擎,MySQL8.0之后被作为默认存储引擎
| 分类 | 特性 (Feature) | 支持情况 (Support) | 功能说明 (Description) |
|---|---|---|---|
| 索引数据结构 | B-tree indexes | Yes | B树索引:最常用的索引结构(实际上InnoDB使用的是B+树),用于快速的数据检索、排序和范围查询。 |
| 索引数据结构 | Clustered indexes | Yes | 聚集索引(聚簇索引):表中的数据行在物理磁盘上按照主键的顺序进行存储。叶子节点直接包含行数据,主键查询效率极高。 |
| 索引数据结构 | Full-text search indexes | Yes (MySQL 5.6 及以上版本支持) | 全文搜索索引:一种特殊类型的索引,用于在大量文本数据中进行高效的关键词(自然语言)分词搜索。 |
| 索引数据结构 | Geospatial indexing support | Yes | 地理空间索引支持:支持使用 R-tree 等结构对空间数据创建索引,用于快速执行空间计算(例如"查找附近1公里内的商家")。 |
| 索引数据结构 | Hash indexes | No (InnoDB 内部会使用自适应哈希索引) | 哈希索引:基于哈希表实现的索引,支持极快的 O(1) 等值查询,但不支持范围查询。InnoDB 不允许用户显式创建,但在内部会自动为热点数据创建"自适应哈希索引"。 |
| 索引数据结构 | T-tree indexes | No | T树索引:一种主要为内存数据库优化的树形索引结构。InnoDB 针对磁盘存储优化(使用 B+ 树),因此不支持 T 树。 |
| 事务并发 | Transactions | Yes | 事务支持:完全支持 ACID(原子性、一致性、隔离性、持久性)事务。保证多个 SQL 操作要么全部成功,要么全部回滚(如转账场景)。 |
| 事务并发 | MVCC | Yes | 多版本并发控制:通过保存数据的历史版本来实现。它的主要作用是实现"一致性非锁定读",即读操作不会阻塞写操作,写操作也不会阻塞读操作,极大地提升了并发性能。 |
| 事务并发 | Locking granularity | Row (行级) | 锁粒度:InnoDB 采用的是"行级锁"。在执行修改操作时只锁定受影响的行,而不锁定整张表,最大化地支持了高并发。 |
| 缓存性能 | Data caches | Yes | 数据缓存:InnoDB 拥有缓冲池(Buffer Pool),可以在内存中缓存表数据,大幅减少读取磁盘的次数,提升查询性能。 |
| 缓存性能 | Index caches | Yes | 索引缓存:与数据缓存类似,缓冲池(Buffer Pool)中也会缓存索引页,加快索引树的遍历速度。 |
| 扩展能力 | Compressed data | Yes | 数据压缩:支持对表中的数据和索引进行压缩存储,从而减少磁盘空间占用和 I/O 开销。 |
| 扩展能力 | Encrypted data | Yes (部分功能依赖服务器层实现,后支持静态数据加密) | 数据加密:支持数据落盘时的加密(透明表空间加密/静态数据加密),防止因物理磁盘被盗或泄露导致的数据安全风险。 |
| 扩展能力 | Foreign key support | Yes | 外键支持:用于维护不同表之间的数据引用完整性(级联更新/删除等),确保关联表中的数据一致。 |
| 扩展能力 | Geospatial data type support | Yes | 地理空间数据类型支持:支持存储地理空间信息(如 POINT、LINESTRING、POLYGON 等空间对象)。 |
| 运维高可用 | Backup/point-in-time recovery (Implemented in the server...) | Yes | 备份与时间点恢复:允许将数据库恢复到过去的某一个特定时间点(例如误删数据前的一刻),依赖于服务器层的 binlog。 |
| 运维高可用 | Cluster database support | No | 集群数据库支持:指是否支持多节点共享同一份数据的分布式集群架构(如 MySQL NDB Cluster)。InnoDB 主要是单机存储引擎。 |
| 运维高可用 | Replication support (Implemented in the server...) | Yes | 复制支持:支持主从复制(Master-Slave),用于数据的高可用容灾备份以及读写分离(此功能主要由 MySQL 服务器层实现)。 |
| 运维高可用 | Storage limits | 64TB | 存储限制:单个表空间文件的最大容量限制,InnoDB 最大支持 64TB 的数据量。 |
| 运维高可用 | Update statistics for data dictionary | Yes | 数据字典统计信息更新:系统会自动收集表和索引的统计数据(如行数、索引基数等),以帮助 MySQL 优化器选择最优的查询执行计划。 |
5.1.2 Innodb的优势
- DML操作支持ACID模型:innodb中,事务具有提交、会滚、崩溃恢复功能
- 灾难恢复:若发生意外,服务重启后,不用手动修改,自动回到崩溃前的状态
- 行级锁:锁粒度低,支持高并发和高性能
- 内存缓冲池:Innodb维护了自己的缓冲池,访问数据时,在内存中缓存高频表数据、索引数据;专用数据库中,缓存池的大小是80%物理内存
- 优化主键查询:每个innodb表都有一个主键索引
- 外键约束:为了确保表与表之间的一致性,innodb提供外键约束
- 自适应哈希:对于频繁查询的行数据,会创建自适应哈希索引,提升访问速度
创建innodb表后,默认会在
var/lib/mysql/你的数据库名/表名下生成同表这份图片内容主要介绍了在 MySQL 中创建 InnoDB 表时的底层物理文件结构。以下是转换后的 Markdown 格式:
5.1.3 创建 InnoDB 表
sql
# 选择目标数据库
use test_db

# 创建一个使用 InnoDB 存储引擎的表
CREATE TABLE t_innodb (
    id int(11) PRIMARY KEY AUTO_INCREMENT,
    name varchar(20)
) ENGINE = InnoDB;
当创建一个存储引擎为 InnoDB 的表时,会在 data_dir/test_db 目录下生成一个用来存储真实数据的物理文件,命名格式为 表名.ibd ,以当前为例会在 /var/lib/mysql/test_db 目录下生成一个 t_innodb.ibd 的表空间数据文件。
bash
root@hyy:/var/lib/mysql/test_db# ll
total 568
drwxr-x--- 2 mysql mysql   4096  9月 27 10:34 ./
drwxr-x--- 8 mysql mysql   4096  9月 27 10:27 ../
-rw-r----- 1 mysql mysql 114688  9月  6 15:30 classes.ibd
-rw-r----- 1 mysql mysql 114688  9月  6 15:30 course.ibd
-rw-r----- 1 mysql mysql 114688  9月  6 15:30 score.ibd
-rw-r----- 1 mysql mysql 114688  9月  6 15:30 student.ibd
-rw-r----- 1 mysql mysql 114688 9月 27 10:35 t_innodb.ibd # 创建表后生成的用来存储数据的文件- 在 MySQL 8.0 中表结构的信息也保存在
.ibd文件中。 - sid = Serialized Dictionary Information 序列化字典信息。
- 和 8.0 有所不同的是,在 MySQL 5.X 及以前的版本中使用一个后缀为 .frm 的二进制文件来记录和描述表定义的信息。
5.1.4最佳实践
- 将表中最长查询的列(或多列)设置为主键(或复合主键),没有则创建一个自增列为主键;
- 多表查询,建议给对应表设置外键,添加的外键,推荐为外表的主键索引提升性能;
- 针对多表查询,通过
START TRANSACTION和COMMIT语句括在一起,分组为事务一起提交或回滚; - 不要表级锁,因为innodb本身支持细粒度锁的同时确保性能不受影响,表级锁设置后,性能反而降低;
5.2 MyISAM
MyISAM的表空间很小,但是仅支持表级锁,高并发下读写性能会收到限制。
5.2.1 支持功能
需要特别注意的是,MyISAM 与 InnoDB 在核心特性(如事务、锁粒度、外键)上有极大的区别。我在说明中对这些重点差异进行了强调:
| 分类 | 特性 (Feature) | 支持情况 (Support) | 功能说明 (Description) |
|---|---|---|---|
| 索引数据结构 | B-tree indexes | Yes | B树索引:同样支持最常用的 B-Tree 索引进行快速检索。 |
| 索引数据结构 | Clustered indexes | No | 聚集索引 :不支持 。与 InnoDB 不同,MyISAM 的数据文件和索引文件是物理分离的(称为非聚集索引),索引树的叶子节点只保存数据的物理地址指针,不保存数据本身。 |
| 索引数据结构 | Full-text search indexes | Yes | 全文搜索索引:支持。在 MySQL 早期版本中,MyISAM 是唯一支持全文索引的引擎(直到后来 InnoDB 也支持了)。 |
| 索引数据结构 | Geospatial indexing support | Yes | 地理空间索引支持:支持使用 R-tree 等结构对空间数据创建索引。 |
| 索引数据结构 | Hash indexes | No | 哈希索引:不支持。 |
| 索引数据结构 | T-tree indexes | No | T树索引:不支持。 |
| 事务并发 | Transactions | No | 事务支持 :不支持 。这是另一个致命区别。它不支持 ACID,没有 COMMIT 和 ROLLBACK。如果写入中途断电,可能会导致数据不一致甚至表损坏(需要手动修复)。 |
| 事务并发 | MVCC | No | 多版本并发控制 :不支持。因为它不支持事务和行级锁,自然也无法实现 MVCC 的无锁并发读。 |
| 事务并发 | Locking granularity | Table (表级) | 锁粒度 :表级锁 。这是它和 InnoDB 最大的区别之一。在修改数据时,MyISAM 会把整张表锁住,导致并发写入性能较差。因此它更适合"读多写少"的场景。 |
| 缓存性能 | Data caches | No | 数据缓存 :不支持。MyISAM 本身不会在内存中缓存数据行,读取数据极其依赖操作系统的文件系统缓存。 |
| 缓存性能 | Index caches | Yes | 索引缓存 :支持 。MyISAM 有一个专门的内存区域叫"键缓存(Key Buffer)",它只用来缓存索引,不缓存数据。 |
| 扩展能力 | Compressed data | Yes (压缩后的表只读) | 数据压缩 :支持压缩表以节省空间,但一旦被压缩,该表就变成只读(Read-only)的了,通常用于归档不经常变动的历史数据。 |
| 扩展能力 | Encrypted data | Yes (依赖服务器层) | 数据加密:支持,通过 MySQL 服务器层的加密函数实现。 |
| 扩展能力 | Foreign key support | No | 外键支持 :不支持。无法在引擎层面强制维护两张表之间的引用完整性(级联更新/删除等必须由业务代码自己保证)。 |
| 扩展能力 | Geospatial data type support | Yes | 地理空间数据类型支持:支持存储空间数据对象。 |
| 运维高可用 | **Backup/point (Implemented in the server...) | Yes | 备份与时间点恢复:支持。同样依赖于 MySQL 服务器层(而非引擎层)的 binlog 实现。 |
| 运维高可用 | Cluster database support | No | 集群数据库支持:不支持分布式集群架构。 |
| 运维高可用 | **Replication (Implemented in the server...) | Yes | 复制支持:支持主从复制(主要由 MySQL 服务器层实现)。 |
| 运维高可用 | Storage limits | 256TB | 存储限制:最大支持 256TB 的数据量(比 InnoDB 的 64TB 上限更高)。 |
| 运维高可用 | Update statistics for data dictionary | Yes | 数据字典统计信息更新:系统会自动收集表的统计数据以优化查询。 |
5.2.2 MyISAM的优势
- 存储量:
- Innodb单表最多存储64TB数据,MyISAM单表最多可存储256TB数据,并且MyISAM一个表最多可以存储 2 64 2^{64} 264行数据
- 索引:
- 每个表可以创建最多64个索引,每个索引可以包含16个列
- MyISAM的索引允许使用NULL值
- MyISAM创建表时可以通过
DATA DIRECTORY=PATH和INDEX DIRECTORY=PATH把索引文件和数据文件放到不同路径,提升访问速度 - BLOB和TEXT可以被索引,(但是不建议用,因为性能不高)
- 约束:
- MyISAM中,unique约束不限制值的长度
- mysql可以启动
myisam_recover_options系统变量,重启后可以检测表数据是否损毁,若损坏可自动修复
5.2.3 创建 MyISAM 表
sql
# 在 MySQL 8.0 中 InnoDB 是默认引擎,创建 MyISAM 表需显式指定
CREATE TABLE t_myisam (
    id int(11) PRIMARY KEY AUTO_INCREMENT,
    name varchar(20)
) ENGINE = MyISAM;
物理文件结构说明:
创建 MyISAM 表会根据表名生成三个不同后缀的物理文件:
.MYD(MYData):存储表数据的文件。.MYI(MYIndex):存储表索引的文件。.sdi:在 MySQL 8.0 中,用于存储表结构描述信息(JSON 格式)。
底层文件列表对比 (Shell 示例)
bash
root@hyy:/var/lib/mysql/test_db# ll
total 576
# InnoDB 相关文件
-rw-r----- 1 mysql mysql 114688  9月 27 10:35 t_innodb.ibd

# MyISAM 相关文件
-rw-r----- 1 mysql mysql   2777  9月 27 11:03 t_myisam_398.sdi  # 表结构(8.0+)
-rw-r----- 1 mysql mysql      0  9月 27 11:03 t_myisam.MYD      # 数据文件
-rw-r----- 1 mysql mysql   1024  9月 27 11:03 t_myisam.MYI      # 索引文件
总结:
- InnoDB 倾向于将数据和索引合并存储在
.ibd文件中(聚集索引结构)。 - MyISAM 则是数据(
.MYD)与索引(.MYI)分离存储。
5.2.4 MyISAM表存储格式
MyISAM有三种表存储格式,不同存储格式,性能以及占用内存都不一样。
5.2.4.1 静态表格式
- 静态格式时三种存储格式中最简单、最安全的。
- 不论列是否可变长(例如VARCHAR、VARBINARY),都会以固定长度存储。空间中空闲的部分自动会填充空格或0x00;
- 存储结构规整,访问速度很快,崩溃后易于重建。
- NULL值用1个bit维护,如果为1,则该列为NULL
- 由于每列存储的大小固定,必然存在空间利用率低的情况,整体磁盘占用更多。
5.2.3.2 动态表格式
表中有可变长列(varchar text blog varbinary)时,或创建表时指定ROW_FORMAT=DYNAMIC则为动态存储,这种存储方式内存空间占用比静态格式小很多;
特点:
- 列是字符串切长度大于等于4,存储大小都是动态的;
- 每行开头有一个固定长度标识位,用于存储当前行的长度;
- 每行开头会有一个位图,记录每列是否值为空(比如0,""),如果为空值,则位图进行标记,该列不会存储到磁盘;
- 可NULL的列,提供一个1bit的空间,若为NULL,bit=1;
- 每行、甚至每列会用到最合适的磁盘压缩方式;
常见的压缩方式:
- 列值为0,直接用1个bit表示,不实际存储NULL;
- 数据类型为int,可用tynint,则用tynint;
- 列值包含某一组值,则用枚举类型存储;
5.2.3.3 压缩表格式
- 三种表存储格式中空间占用最小(空间占用明显缩小),需要用myiampack工具进行生成;
- 该类型的表只能读,不能改;
5.3 Memory
Memory存储引擎(以前叫heap),把全量表数据存储到内存中,当服务器宕机或停电,数据会全部丢失
5.3.1特性
| 分类 | 特性 (Feature) | 支持情况 (Support) | 功能说明 (Description) |
|---|---|---|---|
| 索引数据结构 | B-tree indexes | Yes | B树索引:支持B-Tree索引进行快速检索。 |
| 索引数据结构 | Clustered indexes | No | 聚集索引:不支持聚集索引,数据与索引非物理绑定存储。 |
| 索引数据结构 | Full-text search indexes | No | 全文搜索索引:不支持全文索引。 |
| 索引数据结构 | Geospatial indexing support | No | 地理空间索引支持:不支持地理空间索引。 |
| 索引数据结构 | Hash indexes | Yes | 哈希索引:支持哈希索引,可实现快速等值查询。 |
| 索引数据结构 | T-tree indexes | No | T树索引:不支持T树索引。 |
| 事务并发 | Transactions | No | 事务支持:不支持事务,无ACID保障,无法进行事务提交与回滚。 |
| 事务并发 | MVCC | No | 多版本并发控制:不支持MVCC,无多版本数据管理机制。 |
| 事务并发 | Locking granularity | Table | 锁粒度:表级锁,修改数据时会锁定整张表,并发写入性能较差。 |
| 缓存性能 | Data caches | N/A | 数据缓存:无专门的数据缓存机制,数据读取依赖外部缓存或系统缓存。 |
| 缓存性能 | Index caches | N/A | 索引缓存:无专门的索引缓存机制。 |
| 扩展能力 | Compressed data | No | 数据压缩:不支持数据压缩存储。 |
| 扩展能力 | Encrypted data | Yes (Implemented in the server via encryption functions.) | 数据加密:支持数据加密,依赖服务器层的加密函数实现。 |
| 扩展能力 | Foreign key support | No | 外键支持:不支持外键,无法在引擎层面维护表间引用完整性。 |
| 扩展能力 | Geospatial data type support | No | 地理空间数据类型支持:不支持地理空间数据类型存储。 |
| 运维高可用 | Backup/point-in-time recovery (Implemented in the server, rather than in the storage engine.) | Yes | 备份与时间点恢复:支持,依赖MySQL服务器层实现,而非存储引擎层。 |
| 运维高可用 | Cluster database support | No | 集群数据库支持:不支持分布式集群架构。 |
| 运维高可用 | Replication support (Implemented in the server, rather than in the storage engine.) | Limited (See the discussion later in this...) | 复制支持:有限支持主从复制,依赖服务器层实现,存在一定限制。 |
| 运维高可用 | Storage limits | RAM | 存储限制:数据存储于内存中,容量受服务器内存大小限制。 |
| 运维高可用 | Update statistics for data dictionary | Yes | 数据字典统计信息更新:系统会自动收集表和索引的统计数据,用于优化查询执行计划。 |
注意每次重启,Memory表都会被清空,永远不会在磁盘中存储任何数据!
5.3.2 内存管理
- Memory存储引擎删除表中一行数据,不会实际删除对应内存,除非表中数据都被删除,才会自动是否表所有内存
- 可以通过
delete和truncate table删除表中所有行,或者droup table删除表 - 如果要清理内存,可以重建表,保留未删除的行数据:通过
alter table engine=Memory实现
实际Memory表的存储大小取决于所在服务器的内存资源。
可以通过环境变量max_heap_table_size控制Memory表的大小:
sql
# 创建128MB的表(兆字节)
 mysql> SET max_heap_table_size = 128M;
3 Query OK, 0 rows affected (0.00 sec)
5.4 CSV
CSV(Comma-Separated Values)的缩写,以纯文本格式存储表数据
5.4.1 特性
- CSV不支持索引
- CSV不支持表分区
- 每列数据不能为NULL
- 创建一个CSV表后,磁盘中会保存
.CSV(以逗号分隔的数据).CSM(存储表状态和行数).sdi(描述表结构信息)三个文件 - 可以通过
check table和repair table验证表是否损坏,然后修复。
注意:
CSV表修复方式简单粗暴,他会直接截断存储结构损坏的首个位置,即使后续表数据结构正常。
5.5 MyISAM和Innodb的区别
在 MySQL 8.0 中,InnoDB 是默认的存储引擎,但在早期版本或特定场景下,MyISAM 也曾大放异彩。它们之间的区别可以从以下 7 个核心维度进行对比:
1. 事务支持与 ACID 特性 (最核心的区别)
- InnoDB :完全支持 ACID(原子性、一致性、隔离性、持久性)事务。支持
COMMIT、ROLLBACK以及崩溃恢复能力。它还通过 MVCC(多版本并发控制) 来实现高并发下的读取操作。 - MyISAM :不支持事务,也没有 MVCC。如果在写入过程中发生宕机或断电,可能会导致数据不一致,且不支持回滚操作。
2. 锁的粒度与并发能力
- InnoDB :默认采用行级锁(Row-level locking),同时也支持表级锁。行级锁极大提升了多线程并发读写时的性能,适合高并发的业务场景。
- MyISAM :仅支持表级锁(Table-level locking)。哪怕只是修改表中的一行数据,也会将整张表锁住。并发写入时,其他写操作和读操作都会被阻塞,导致高并发写性能较差。
3. 索引的底层存储结构 (聚集 vs 非聚集)
- InnoDB :采用聚集索引(Clustered Index) 。它的数据文件和主键索引是绑定的(都存在
.ibd文件中),索引树的叶子节点直接存储了该行的完整数据。这意味着通过主键查询速度非常快。 - MyISAM :采用非聚集索引(Non-clustered Index) 。它的数据文件(
.MYD)和索引文件(.MYI)是物理分离的。索引树的叶子节点只保存指向数据真实物理地址的指针,拿到指针后还需要进行一次回表查询。
4. 外键支持 (Foreign Keys)
- InnoDB :支持外键约束。能够在数据库引擎层面保证数据的完整性和关联性(如级联更新、级联删除)。
- MyISAM :不支持外键。如果需要维护数据之间的关联关系,必须由应用程序(业务代码)在逻辑层面自己来保证。
5. 崩溃后的安全恢复
- InnoDB :拥有极其强大的崩溃恢复能力。依赖于底层的 Redo Log(重做日志) 和 Undo Log,即使数据库异常宕机,重启后也能自动恢复到一致状态,保证数据不丢失。
- MyISAM :崩溃后极易损坏,虽然提供了修复工具(如
myisam_recover_options),但恢复速度慢,且不能保证数据 100% 恢复。
6. 文件物理存储形式
- InnoDB :在 MySQL 8.0 中,表结构、数据和索引通常统一存储在一个后缀为
.ibd的表空间文件中。 - MyISAM :一张表在磁盘上会生成三个文件:表结构定义文件(8.0 中为
.sdi)、数据文件(.MYD)和索引文件(.MYI)。
7. COUNT(*) 的查询性能
- InnoDB :执行
SELECT COUNT(*) FROM table时,由于 MVCC 的存在,不同事务看到的数据行数是不一样的,因此它必须全表扫描(或扫描某个非聚簇索引)来实时计算总行数,性能较差。 - MyISAM :内部维护了一个专门的变量来存储表的总行数。执行
COUNT(*)(且没有 WHERE 条件时),直接返回该变量的值,查询速度极快(时间复杂度为 O(1))。
8.📊 对比速查表
| 比较维度 | InnoDB 引擎 | MyISAM 引擎 |
|---|---|---|
| 事务支持 | ✅ 支持 (ACID) | ❌ 不支持 |
| 锁的粒度 | 行级锁 (高并发好) | 表级锁 (高并发差) |
| 外键支持 | ✅ 支持 | ❌ 不支持 |
| 索引结构 | 聚集索引 (数据和索引在一起) | 非聚集索引 (数据和索引分离) |
| MVCC支持 | ✅ 支持 | ❌ 不支持 |
| 崩溃恢复 | ✅ 支持 (Redo Log保证) | ❌ 不支持 (需手动修复且易丢数据) |
COUNT(*)速度 |
较慢 (全表或索引扫描) | 极快 (直接读取内置计数器) |
| 物理文件 | .ibd |
.sdi, .MYD, .MYI |
- 默认无脑选 InnoDB:现在的业务系统绝大多数都需要事务保证数据一致性(如订单、支付、用户数据),且并发量不低,InnoDB 是绝对的标配。
- 什么情况选 MyISAM? :在现代开发中极少使用。如果你的表完全不需要事务 ,且处于**"极少更新、海量读取"**的场景(比如一些历史归档日志表、只读的字典表),并且对
COUNT(*)性能有极高要求,可以考虑使用 MyISAM(但即便如此,现在很多人也宁愿通过 Redis 缓存count值而继续使用 InnoDB)。
欢迎👏大家和小编积极讨论交流~~