一,pipeline(属于是一种函数)
1.简单理解其作用
随着大语言模型的发展,初学者如何更快更高效的部署模型并对模型进行调试成为了首当其冲的问题,由此,诞生出了pipeline。
在没有pipeline的时候,我们调用情感分析模型需要用到的代码有这么多:
不使用Pipeline的原始方式(初学者可以跳过这段代码)
from transformers import AutoTokenizer, AutoModelForSequenceClassification
import torch
1. 加载分词器和模型
tokenizer = AutoTokenizer.from_pretrained("distilbert-base-uncased-finetuned-sst-2-english")
model = AutoModelForSequenceClassification.from_pretrained("distilbert-base-uncased-finetuned-sst-2-english")
2. 预处理文本
inputs = tokenizer("I love this library!", return_tensors="pt")
3. 模型推理
with torch.no_grad():
outputs = model(**inputs)
4. 解析输出
predictions = torch.nn.functional.softmax(outputs.logits, dim=-1)
labels = "NEGATIVE", "POSITIVE"
result = labelspredictions.argmax().item()
print(result) # 输出: POSITIVE
当我们使用到了pipeline后,我们只需要用到这么多代码:
from transformers import pipeline
classifier = pipeline("sentiment-analysis")
result = classifier("I love this library!")
print(result) # 输出: {'label': 'POSITIVE', 'score': 0.9998}
pipeline将之前的那四个方法隐藏了起来,我们只要告诉他我们需要什么它提供怎样的功能,需要对什么东西使用这个功能就可以得到我们想要的结果。
我们可以这么来理解pipeline,他就像是我们去餐厅时服务我们的服务员,我们告诉他我们要吃什么,有什么忌口,就可以得到我们想要的食物。
2.pipeline的内部工作流程
内部的工作流程具体有三个步骤:预处理,模型计算,后处理。先通过预处理将用户输入的东西转化成模型能够看懂的数字,然后模型对这些数字进行处理,处理后的结果是logits,然后对这个logits进行后处理,从而反馈出用户能够看懂的结果。
3.pipeline的简单使用
使用它主要分成两步:
第一步:导入并创建Pipeline工具
from transformers import pipeline(从库中导出这个工具)
my_tool = pipeline("任务类型")
第二步:使用这个工具处理文本
result = my_tool("你的文本")
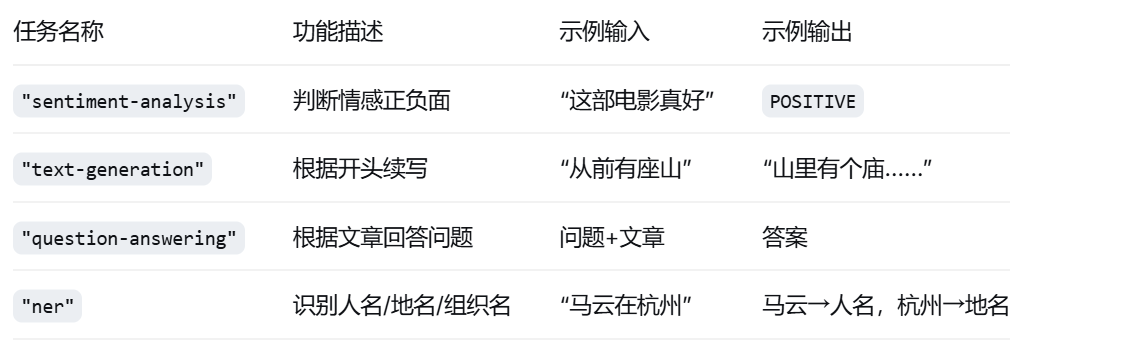
在第一个括号里面填写的是我们想要模型做的工作,常见的有这些:
4.对于pipeline的一些小疑问以及解答
第一点:pipeline调用的是与处理过后的模型,和我们平常使用的豆包,deepseek等是不一样的。
第二点:除了调用pipeline来完成一些我们想让他完成的任务以外,我们还可以调用它做这些事:
1,冒烟测试,快速判断模型是否还活着;2.判断训练是否过拟合(就是模型只会死记硬背,同一个问题换一种说法就不会了);3,对各个方面进行测试;4,对不同版本的模型进行测试;5,测试同一模型不同参数之间的区别。
第三点:使用pipeline测试和使用evalscope测试的区别:pipeline 更适合手动测试模型推理效果、观察不同模型或不同参数配置下的输出差异;而 evalscope 更适合基于数据集和指标进行自动化、批量化、可量化的模型评测。
二,AutoTokenizer
1,pipeline和AutoTokenizer AutoModel
相比于pipeline,AutoTokenizer和AutoModel给我们提供了全套的东西,就是我们使用pipeline时,他会进行预处理,模型计算,后处理,但是我们无法干预其中的任何一个环节,而AutoTokenizer和AutoModel是可以的,这两个东西就像厨房里面的全套厨具,我们可以通过这两个东西对模型进行微调,修改模型结构等一系列的操作。
2,AutoTokenizer(属于是一种类)
2.1简要定义
他是一个自动适配的分词加载工具(分词器的作用就是人类语言文本拆分成一个个"token"(词元),再把这些 token 映射成模型能处理的数字 ID。),我们在使用了AutoTokenizer后,就可以不通过输入提词器的名称来调用提词器,我们只需要输入我们想要使用的模型的名称就可以得到与这个模型相适配的提词器。
2.2具体的任务
第一步:自动匹配用户想用的模型的分词器
第二步:将用户输入的文本分成好多不同的token
第三步:将不同的token映射为相应的token-id
第四步:添加一些特殊的符号,从而便于模型进行理解

第五步:生成模型输入字段
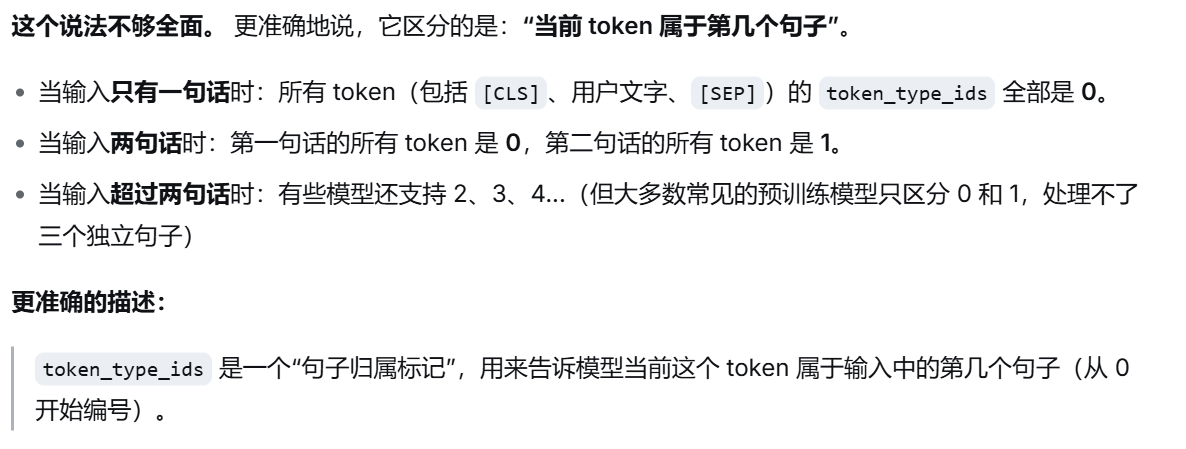
首先来说,模型想要的是一个字典而并非一个列表,经过前四步的处理之后我们得到了这么一个东西:token_ids = 101, 2769, 2769, 1266, 776, 102,这是一个列表并不是模型想要的,所以我们需要对它进行一手转换,变成这样一个有三个字段的字典:model(input_ids=..., attention_mask=..., token_type_ids=...),这三个字段中input_ids表示的是每一个token对应的数字,attention_mask表示的是这是正常的token还是为了补齐长度而添加的东西,通过10进行表示:

然后token_type_ids表示的是这是第一句话的东西还是这是第二句话的东西:
第六步:处理 padding 和 truncation
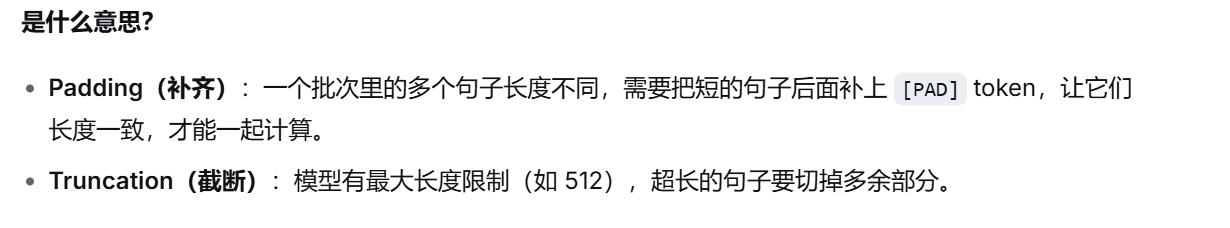
注意:严格意义上是不区分第五步和第六步的,这两步其实是一起的,对字段进行补齐或者截断后,将他们记录在那个字典的第三个字段中。
第七步:将模型输出的结果转化成人能够看懂的文字。