🔥承渊政道: 个人主页
❄️个人专栏: 《C语言基础语法知识》 《数据结构与算法》 《C++知识内容》 《Linux系统知识》 《算法刷题指南》 《测评文章活动推广》 《大模型语言路线学习》
✨逆境不吐心中苦,顺境不忘来时路!✨ 🎬 博主简介:

在学习 Linux 系统的过程中,"进程"是一个绕不开的核心概念.无论我们是在终端中执行一条简单的命令,还是运行一个复杂的后台服务,本质上都离不开进程的参与.可以说,进程是程序在操作系统中运行时的具体表现,也是 Linux 系统进行资源分配、任务调度和运行管理的基本单位.对于初学者来说,进程这个概念看似简单:程序运行起来就是进程.但如果继续深入思考,就会发现其中包含了许多值得理解的内容.例如,程序和进程到底有什么区别?为什么一个程序可以对应多个进程?Linux是如何创建进程的?进程在运行过程中会经历哪些状态?为什么有些进程会变成僵尸进程?父进程和子进程之间又存在怎样的关系?这些问题都是学习 Linux 系统时必须逐步掌握的重点.本文将从基础概念出发,循序渐进地介绍Linux 中进程的本质、进程与程序的区别、进程的状态变化、进程控制块、进程创建与退出、父子进程关系以及常见的进程查看与管理方式.希望通过这篇文章,帮助读者不仅停留在会使用 ps、top、kill等命令的层面,而是能够进一步理解这些命令背后所反映的系统运行机制.掌握进程概念,是深入学习 Linux 内核、系统编程、并发编程以及服务器运维的重要基础.只有真正理解进程是如何被操作系统管理和调度的,才能更好地理解 Linux 系统的运行原理,也能为后续学习线程、信号、进程间通信、任务调度等内容打下坚实基础.废话不多说,下面跟着小编的节奏🎵一起去疯狂的学习吧!

目录
- 1.冯诺依曼体系结构
- [2.操作系统(Operator System)](#2.操作系统(Operator System))
- 3.进程
-
- 3.1进程基本概念与基本操作
-
- 3.1.1描述进程-->PCB
- [3.1.2task_ struct](#3.1.2task_ struct)
- 3.1.3查看进程
- 3.1.4通过系统调⽤获取进程标示符
- 3.1.5通过系统调⽤创建进程-->fork初识
- 3.2进程状态
- 3.3进程优先级
- 3.4进程切换
- 3.5Linux2.6内核进程O(1)调度队列
- 4.命令⾏参数和环境变量
- 5.程序地址空间
1.冯诺依曼体系结构
冯·诺依曼体系结构是一种经典的计算机组织结构,是现代计算机的基础模型之一.它由数学家约翰·冯·诺依曼提出,核心思想是:程序和数据一样,都存放在存储器中,计算机按照存储器中的指令一步一步自动执行.我们常⻅的计算机,如笔记本.我们不常⻅的计算机,如服务器,⼤部分都遵守冯诺依曼体系.
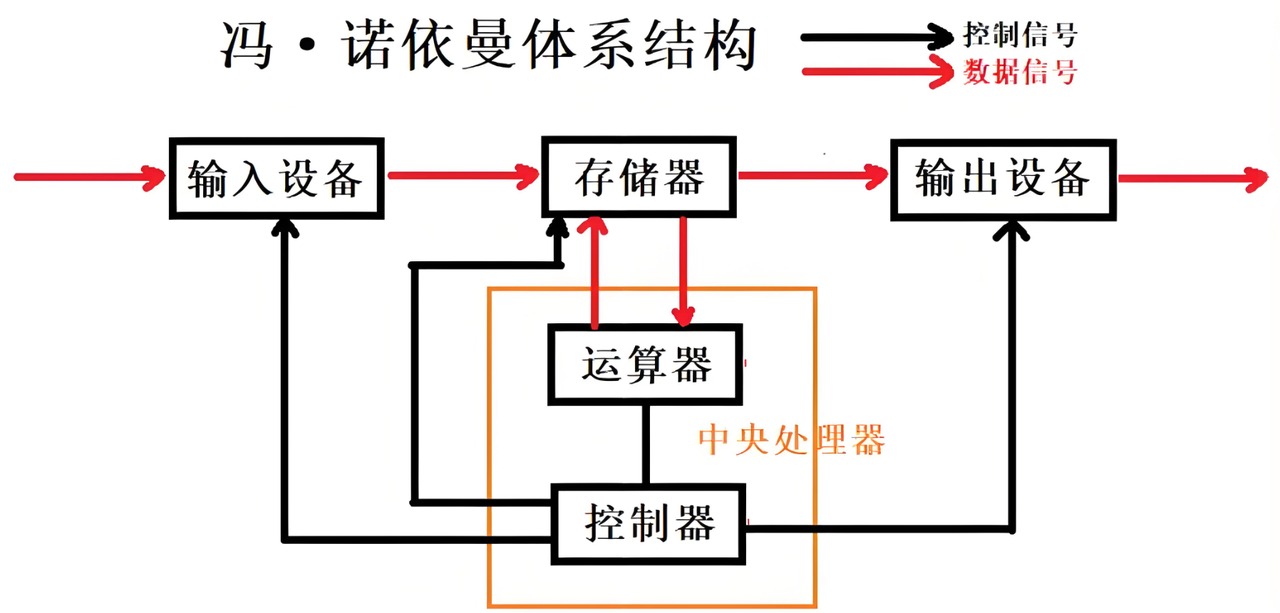
这张图展示的是冯·诺依曼计算机体系结构 ,也叫存储程序计算机结构.它说明了一台计算机的几个核心组成部分,以及它们之间的数据流和控制流.
图中红色箭头表示数据信号 ,黑色箭头表示控制信号.
1.1整体结构
冯·诺依曼体系结构主要由五大部分组成:
- 输入设备
- 存储器
- 运算器
- 控制器
- 输出设备
其中,运算器和控制器合在一起构成中央处理器,也就是 CPU.图中橙色框里的部分就是中央处理器.
通俗的说,截⾄⽬前,我们所认识的计算机,都是由⼀个个的硬件组件组成
- 输⼊单元:包括键盘,⿏标,扫描仪,写板等
- 中央处理器(CPU):含有运算器和控制器等
- 输出单元:显示器,打印机等
1.2输入设备
左侧的"输入设备"负责把外部信息送入计算机.
例如:
键盘、鼠标、扫描仪、麦克风、摄像头等.
图中红色箭头从左边进入输入设备,表示外部数据被输入进来.随后数据继续流向存储器.
也就是说,输入设备的作用是:
把外部数据转换成计算机能够处理的数据,并送入计算机内部.
1.3存储器
中间上方的"存储器"是冯·诺依曼结构的核心部分之一.
它用来存放两类内容:
- 程序指令
- 数据
这是冯·诺依曼体系结构最重要的思想:
程序和数据都存放在同一个存储器中,并且都用二进制形式表示.
例如,一个程序要计算 3 + 5,那么:
- "加法操作"这条指令存在存储器中;
- 数字
3和5也存在存储器中; - 计算后的结果也可能再次写回存储器.
图中可以看到,存储器与运算器之间有红色双向关系,表示数据可以从存储器送到运算器,也可以把运算结果送回存储器.
1.4运算器
橙色框中上方的"运算器"负责进行各种运算.
它主要完成:
- 算术运算:加、减、乘、除;
- 逻辑运算:与、或、非、比较大小等.
比如计算:
text
10 + 20存储器会把 10、20 以及"加法"相关信息送到 CPU,运算器完成计算后得到 30.
运算器不能自己决定什么时候运算、运算什么,它需要接受控制器的指挥.
1.5控制器
橙色框中下方的"控制器"是整台计算机的"指挥中心".
它的作用是:
从存储器中取出指令,分析指令,然后发出控制信号,让各部件协调工作.
比如一条指令要求计算两个数相加,控制器会安排:
- 从存储器中取出指令;
- 解释这条指令是"加法";
- 控制存储器把数据送给运算器;
- 控制运算器执行加法;
- 控制结果写回存储器,或者送往输出设备.
图中黑色箭头从控制器指向输入设备、存储器、输出设备等,表示控制器向这些部件发送控制信号.
1.6中央处理器 CPU
图中橙色框标注为"中央处理器",里面包含:
- 运算器
- 控制器
所以可以总结为:
text
CPU = 运算器 + 控制器CPU 的主要任务是:
取指令、分析指令、执行指令.
其中:
- 控制器负责"指挥";
- 运算器负责"计算".
1.7输出设备
右侧的"输出设备"负责把计算机处理后的结果输出给外部.
例如:
显示器、打印机、扬声器、投影仪等.
图中红色箭头从存储器流向输出设备,再流向右侧,表示处理后的数据最终被输出.
例如:
- 显示器显示计算结果;
- 打印机打印文档;
- 扬声器播放声音.
1.8红色箭头和黑色箭头的含义
图右上角给出了说明:
红色箭头:数据信号
红色箭头表示数据的流动方向.
大致流程是:
text
输入设备 → 存储器 → 运算器 → 存储器 → 输出设备也可以理解为:
数据从外部进入计算机,经过存储和处理后,再输出到外部.
黑色箭头:控制信号
黑色箭头表示控制器发出的控制命令.
控制器会控制:
- 输入设备什么时候输入;
- 存储器什么时候读写;
- 运算器什么时候计算;
- 输出设备什么时候输出.
所以黑色箭头体现的是:
控制器对整个计算机系统的统一指挥.
1.9强调
关于冯诺依曼,必须强调⼏点:
- 这⾥的存储器指的是内存
- 不考虑缓存情况,这⾥的CPU能且只能对内存进⾏读写,不能访问外设(输⼊或输出设备)(数据层⾯)
- 外设(输⼊或输出设备)要输⼊或者输出数据,也只能写⼊内存或者从内存中读取.
- ⼀句话,所有设备都只能直接和内存打交道.
- 在数据层面上,CPU不会和外设之间打交道(输入or输出),CPU读写数据,只会和内存打交道!我们口中的输入和输出,是站在谁的角度考虑问题的?站在内存角度!站在加载到内存中的程序的角度!
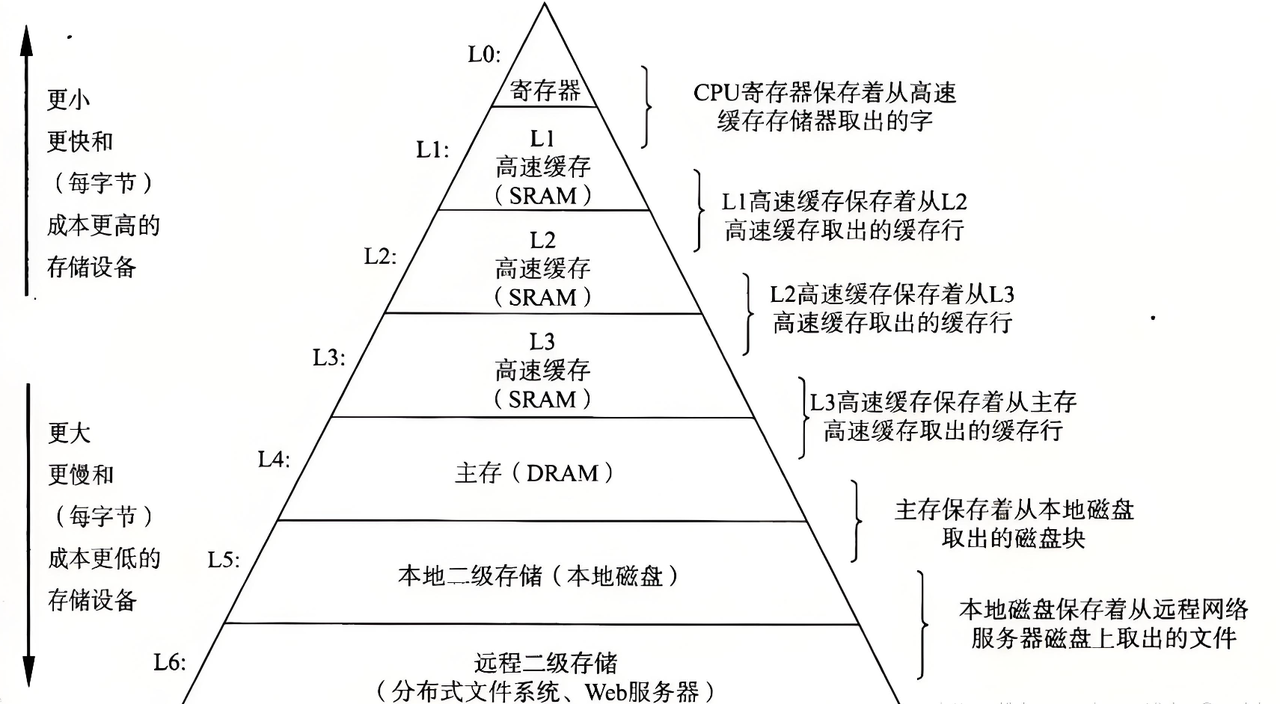
这张图展示的是计算机存储层次结构 ,也叫存储器层次结构.它用一个金字塔表示:越靠近顶部,存储设备越快、越小、越贵;越靠近底部,存储设备越慢、越大、越便宜.
它的核心思想是:
用少量高速存储配合大量低速存储,让计算机看起来既"快"又"容量大".
1.寄存器
寄存器位于 CPU 内部,是 CPU 可以直接访问的最快存储位置.
它通常保存:
- 当前正在运算的数据;
- 指令执行过程中的临时结果;
- 地址;
- 程序计数器等控制信息.
例如 CPU 要计算:
text
a + b通常会先把 a 和 b 从内存或缓存中取到寄存器,再由运算器进行加法运算.
寄存器的特点是:
- 速度最快
- 容量最小
- 成本最高
- 直接服务于 CPU 指令执行
右侧文字说:
CPU寄存器保存着从高速缓存存储器取出的字.
意思是CPU 会把从缓存中取来的数据放到寄存器中,供运算器立即使用.
2.L1高速缓存
L1 高速缓存 ,通常由 SRAM 构成.
L1缓存也在 CPU 内部,离 CPU 核心非常近.
它的作用是保存 CPU 最近最可能使用的数据和指令.
特点:
- 速度仅次于寄存器
- 容量较小
- 延迟很低
- 通常每个 CPU 核心都有自己的 L1 缓存.
右侧文字说:
L1高速缓存保存着从 L2 高速缓存取出的缓存行.
这里的"缓存行"是缓存和下一级存储之间传输数据的基本单位.CPU 不是每次只取一个字节,而是通常一次取一整块数据,这一块就叫缓存行.
3.L2高速缓存
L2 高速缓存 ,也通常由 SRAM 构成.
L2 缓存比 L1:
- 容量更大
- 速度稍慢
- 成本更低一些
它的作用是作为 L1 和 L3 之间的缓冲.
当 CPU 在 L1 缓存中找不到需要的数据时,就会去 L2 查找.
右侧文字说:
L2高速缓存保存着从 L3 高速缓存取出的缓存行.
也就是说,L2 缓存中存放的是从 L3 中取来的一部分数据.
4.L3高速缓存
L3 高速缓存 ,同样通常是 SRAM .
L3 缓存比 L2:
- 容量更大
- 速度更慢
- 通常多个 CPU 核心共享
它的作用是减少 CPU 访问主存的次数.
如果 L1 和 L2 都没有找到需要的数据,CPU 会继续到 L3 查找.如果 L3 命中,就不需要访问更慢的主存.
右侧文字说:
L3高速缓存保存着从主存取出的缓存行.
意思是 L3 缓存里保存的是从主存 DRAM 中取出的一些数据块.
5.主存 DRAM
主存 ,也就是通常说的内存 ,由 DRAM 构成.
例如电脑中的内存条就是主存.
主存的作用是保存正在运行的程序和正在使用的数据.
比如你打开一个浏览器、文档编辑器或游戏,它们运行时的程序代码和数据会被加载到主存中.
主存的特点是:
- 容量比缓存大得多
- 速度比缓存慢
- 断电后数据会丢失
- CPU 不能像访问寄存器那样快地访问它.
右侧文字说:
主存保存着从本地磁盘取出的磁盘块.
也就是说,当程序或文件需要运行时,操作系统会把磁盘上的内容加载到主存中.
6.本地二级存储(本地磁盘)
本地二级存储 *,也就是本地磁盘.
它可以是:
- HDD 机械硬盘
- SSD 固态硬盘
- U 盘等本地持久化存储设备.
它的作用是长期保存数据,例如:
- 操作系统
- 应用程序
- 文档
- 图片
- 视频
- 数据库文件
和主存不同,磁盘通常是非易失性存储:
断电后数据仍然保存.
特点:
- 容量大
- 价格相对低
- 速度比内存慢很多
- 适合长期存储
右侧文字说:
本地磁盘保存着从远程网络服务器磁盘上取出的文件.
意思是如果你从网络服务器下载文件,这些文件可能会被保存到本地磁盘.
7.远程二级存储
远程二级存储,例如:
- 分布式文件系统
- Web 服务器
- 云存储
- 远程数据库
- 网络文件服务器
它不是本机内部的存储,而是通过网络访问的存储.
特点:
- 容量可以非常大
- 成本可以更低
- 访问速度最慢
- 受网络延迟和带宽影响
- 适合共享、备份和大规模存储.
例如你访问网页、下载文件、使用网盘、访问云数据库,本质上都可能涉及远程二级存储.
📌注意:
对冯诺依曼的理解,不能停留在概念上,要深⼊到对软件数据流理解上,请解释,从你登录上qq开始和某位朋友聊天开始,数据的流动过程.从你打开窗⼝,开始给他发消息,到他的到消息之后的数据流动过程.如果是在qq上发送⽂件呢?QQ 聊天的数据流动重点可以这样理解:
1.打开 QQ
QQ 程序原来在硬盘里,双击后:
text
硬盘中的 QQ 程序 → 内存 → CPU 执行 → 显示器显示界面这体现了冯诺依曼结构:程序先进入存储器,CPU 再取指令执行 .
2.登录 QQ
输入账号密码:
text
键盘 → 内存 → CPU 处理/加密 → 网卡 → QQ 服务器服务器验证后返回结果:
text
QQ 服务器 → 网卡 → 内存 → CPU → 显示器3.打开聊天窗口
聊天记录可能来自本地或服务器:
text
本地磁盘/QQ服务器 → 内存 → CPU 解析 → 显示器显示4.发送文字消息
你输入文字:
text
键盘 → 内存中的 QQ 输入框 → CPU 处理 → 显示器显示点击发送后:
text
文字消息 → 内存 → CPU 封装/加密 → 网卡 → QQ服务器 → 好友设备好友收到后:
text
QQ服务器 → 好友网卡 → 好友内存 → 好友CPU解析 → 好友屏幕显示5.发送文件
文件原来在磁盘中:
text
本地磁盘 → 内存 → CPU 分块/校验/加密 → 网卡 → QQ服务器/好友设备好友接收:
text
网络 → 好友网卡 → 好友内存 → CPU 重组/校验 → 好友磁盘保存6.核心总结
冯诺依曼结构在 QQ 聊天中的体现就是:
text
输入设备产生数据 → 存入内存 → CPU 执行程序处理数据 → 网卡/显示器输出更具体地说:
text
键盘/鼠标 → 内存 → CPU → 网卡 → 网络 → 服务器 → 对方网卡 → 对方内存 → 对方CPU → 对方屏幕发文件时多了一个关键环节:
text
磁盘文件 → 内存 → CPU处理 → 网络发送 → 对方内存 → 对方磁盘重点就是:软件运行不是抽象的,所有聊天、发文件,本质都是数据在磁盘、内存、CPU、网卡、服务器和显示器之间流动.
2.操作系统(Operator System)
2.1操作系统的概念
操作系统 是管理计算机硬件和软件资源的系统软件,是用户和计算机硬件之间的"中间层".
简单说:
操作系统负责管理硬件、运行程序,并为用户提供方便的使用环境.
常见的操作系统有:
text
Windows、macOS、Linux、Android、iOS一句话总结操作系统就是:
管理计算机资源、控制程序运行、连接用户和硬件的核心系统软件.
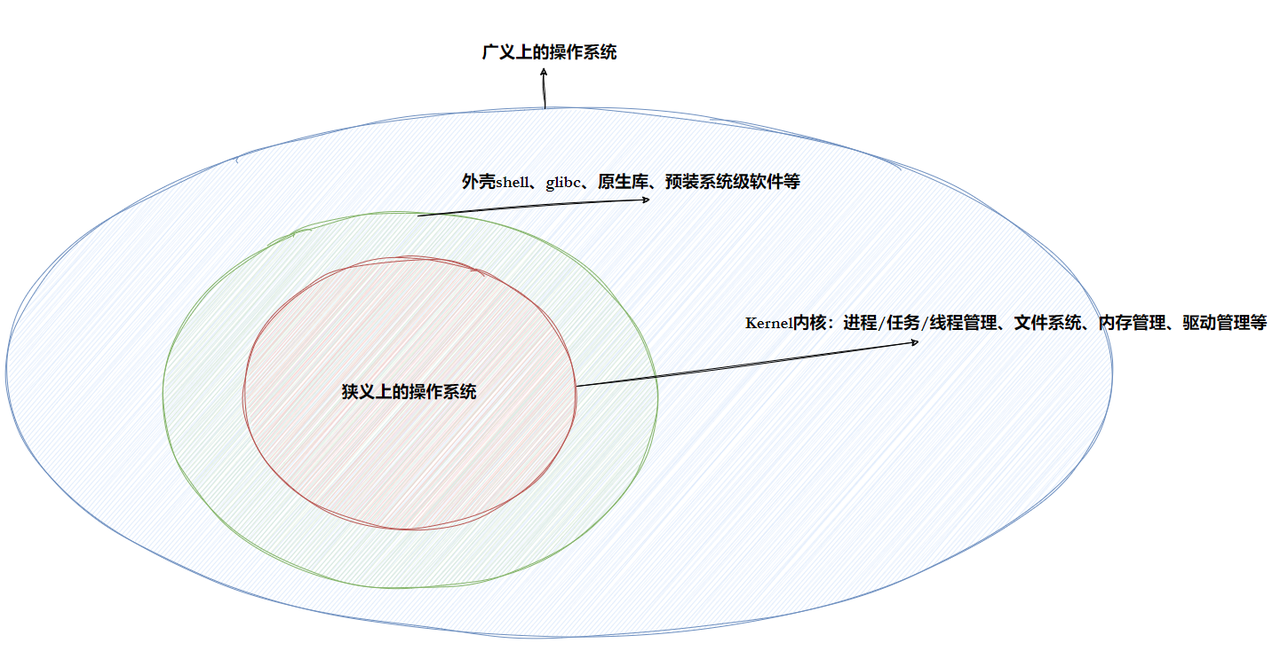
这张图在说明:"操作系统"这个词有狭义和广义两种理解.
1.狭义上的操作系统
图中红色区域写着:狭义上的操作系统它主要指 Kernel 内核 .
内核是操作系统最核心的部分,负责直接管理硬件资源,例如:
text
CPU、内存、磁盘、网卡、键盘、显示器等内核的典型功能包括:
text
进程/任务/线程管理
文件系统
内存管理
驱动管理
设备管理
也就是说,真正直接控制硬件、分配资源的是内核.
2.内核 + 系统基础组件
绿色区域比红色区域大,表示除了内核以外,还包括一些基础系统软件,例如图中提到的:
text
shell、glibc、原生库、预装系统级软件等这些东西通常不直接属于内核,但它们是操作系统环境的重要组成部分.
例如:
- shell:命令行解释器,比如 Linux 中的 bash;
- glibc:C 标准库,很多程序运行时都要依赖它;
- 原生库:系统提供的基础函数库;
- 预装系统级软件:系统自带的基础工具和服务.
所以从更宽一点的角度看,操作系统不仅是内核,还包括围绕内核的一套基础运行环境.
3.广义上的操作系统
最外层蓝色区域写着:广义上的操作系统它包括的范围更大.
广义操作系统可以理解为:
text
内核 + 系统库 + shell + 驱动 + 系统工具 + 图形界面 + 预装基础软件例如我们平时说"Windows操作系统" "Ubuntu 操作系统" "Android系统",通常说的是广义操作系统.
因为用户实际使用的并不只是内核,还包括:
- 桌面环境
- 文件管理器
- 设置程序
- 命令行工具
- 系统服务
- 网络工具
- 预装软件等.
4.核心意思
这张图想表达的是:操作系统不是一个单一程序,而是一套分层的软件系统.
最核心的是 内核 Kernel ,它负责资源管理;
内核外面是 系统库、shell、系统工具 ,它们让应用程序和用户更方便地使用内核;
最外层才是我们日常看到和使用的完整操作系统环境.
可以简单概括为:
text
狭义操作系统 = 内核 Kernel
广义操作系统 = 内核 + 系统库 + shell + 驱动 + 系统工具 + 用户环境
2.2设计操作系统的目的
设计操作系统的目的主要有两个:
1.管理计算机硬件资源
操作系统要统一管理计算机中的各种资源,例如:
text
CPU、内存、磁盘、文件、键盘、鼠标、显示器、网卡如果没有操作系统,每个程序都要自己控制硬件,会非常混乱.
例如你同时打开 QQ、浏览器、音乐软件,操作系统会负责:
text
给每个程序分配 CPU 时间
给每个程序分配内存
管理磁盘文件读写
协调键盘、鼠标、屏幕、网卡等设备
所以操作系统的第一个目的就是:
让硬件资源被安全、高效、有序地使用.
2.为用户和应用程序提供方便的使用接口
操作系统把复杂的硬件细节隐藏起来,提供简单的接口.
例如你保存一个文件时,只需要点击"保存",不用关心磁盘是怎么寻址、怎么写入数据的.
应用程序也不需要直接操作硬件,而是调用操作系统提供的功能:
text
打开文件
读写文件
申请内存
创建进程
使用网络
显示窗口
所以操作系统的第二个目的就是:
让用户和应用程序更方便地使用计算机.
3.一句话总结
设计操作系统的目的就是:管理计算机硬件和软件资源,并向用户和应用程序提供简单、安全、高效的使用环境.
也可以概括为:
text
对下管理硬件资源(与硬件交互,管理所有的软硬件资源)
对上提供使用接口(对上,为⽤⼾程序(应⽤程序)提供⼀个良好的执⾏环境)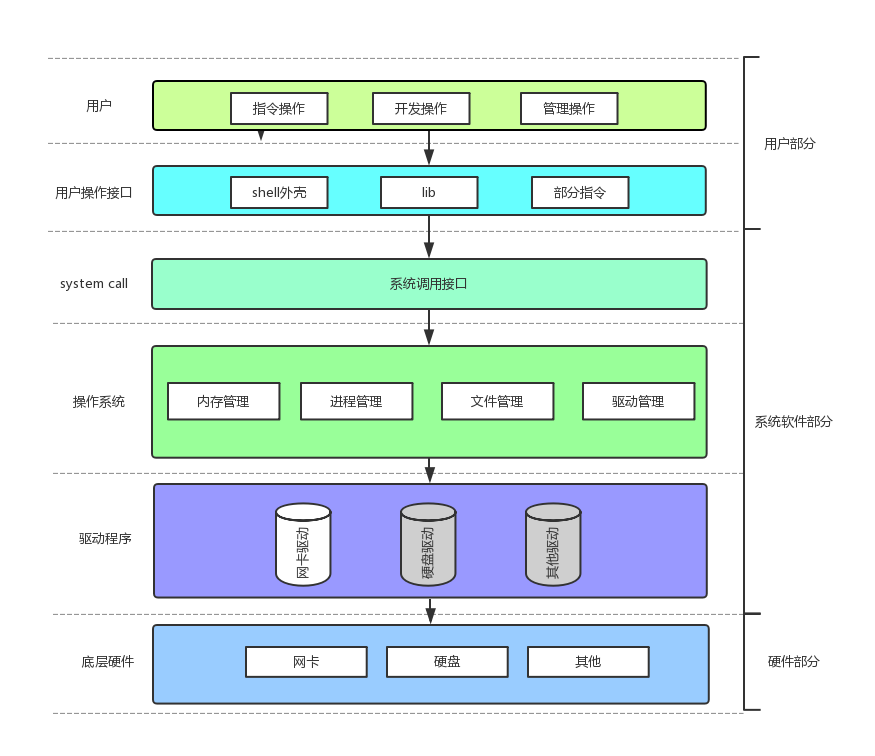
2.3操作系统的核⼼功能
在整个计算机软硬件架构中,操作系统的定位是:⼀款纯正的"搞管理"的软件.
操作系统的核心功能主要有四个:
1.进程管理
管理程序的运行.
比如你同时打开 QQ、浏览器、音乐软件,操作系统要决定:
text
哪个程序先运行
每个程序运行多久
程序之间如何切换
程序卡死后如何结束核心作用是:让多个程序能够并发运行.
2.内存管理
管理计算机的内存资源.
操作系统负责:
text
给程序分配内存
回收不用的内存
防止程序乱访问别人的内存
实现虚拟内存
比如 QQ 不能随便读取浏览器的内存数据,这就是内存管理和保护的作用.
3.文件管理
管理磁盘上的文件和目录.
操作系统负责:
text
创建文件
删除文件
读写文件
管理目录
控制文件权限
比如你保存一个 Word 文档,本质上是操作系统把数据写入磁盘文件.
4.设备管理/驱动管理
管理各种输入输出设备.
例如:
text
键盘、鼠标、显示器、硬盘、网卡、打印机应用程序通常不能直接操作硬件,而是通过操作系统和驱动程序来使用硬件.
比如 QQ 发消息时,最终要通过网卡发送数据,这需要操作系统调用网卡驱动完成.
5.一句话总结
操作系统的核心功能就是:管理 CPU、内存、文件和设备.
更完整地说:操作系统负责进程管理、内存管理、文件管理和设备管理,让程序能够安全、高效、方便地使用计算机硬件.
2.4操作系统中的"管理"如何理解?
在操作系统里,"管理"可以理解为:对计算机资源进行分配、控制、保护和回收.
也就是说,操作系统不是简单地"拥有"硬件,而是负责让各种程序有序、安全、高效 地使用硬件资源.
1.分配
谁需要资源,操作系统就按规则分配给谁.
例如:
text
QQ 要运行 → 分配 CPU 时间和内存
浏览器要打开网页 → 分配内存、网卡资源
Word 要保存文件 → 分配磁盘写入权限
2.控制
操作系统决定资源怎么用、什么时候用、用多久.
例如多个程序都想用 CPU,操作系统要调度:
text
QQ 运行一会儿 → 浏览器运行一会儿 → 音乐软件运行一会儿看起来它们同时运行,其实 CPU 在高速切换.
3.保护
防止程序乱用资源、互相破坏.
例如:
text
QQ 不能随便访问微信的内存
普通程序不能直接控制硬盘所有区域
一个程序崩溃不能把整个系统搞崩
这就是权限和隔离.
4.回收
程序用完资源后操,作系统要收回来,给其他程序使用.
例如:
text
关闭 QQ → 回收它占用的内存、文件句柄、网络连接5.一句话总结
操作系统中的"管理"就是:
谁能用、用什么、怎么用、用多久、用完怎么收回
比如管理CPU,就是决定哪个程序运行;管理内存,就是决定哪块内存给哪个程序;管理文件,就是决定谁能读写文件;管理设备,就是决定程序如何通过驱动使用硬件.
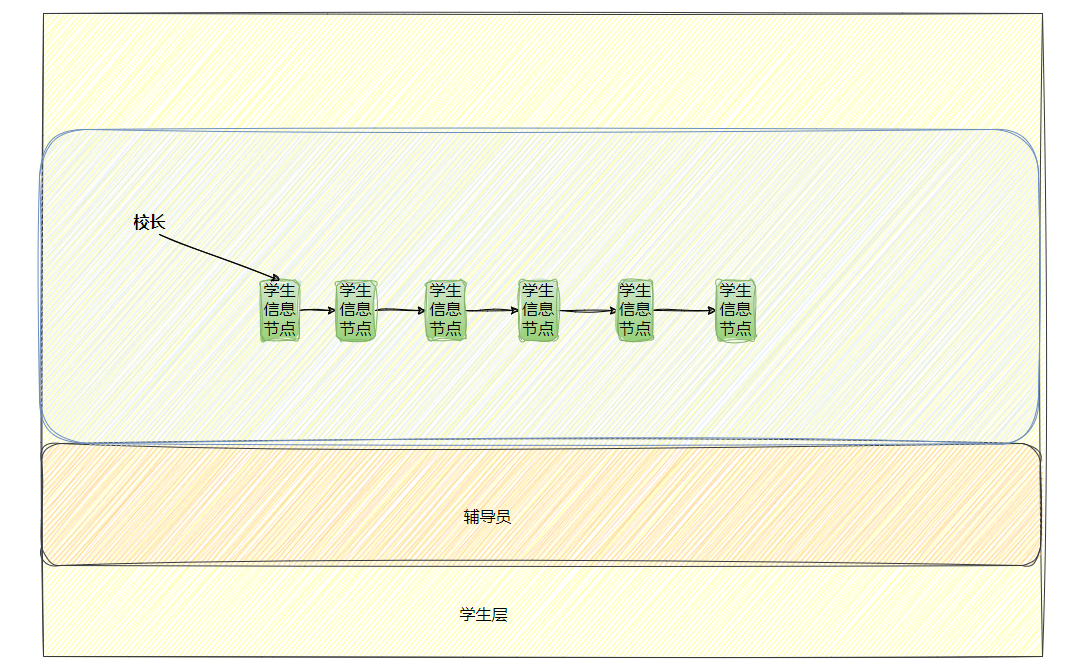
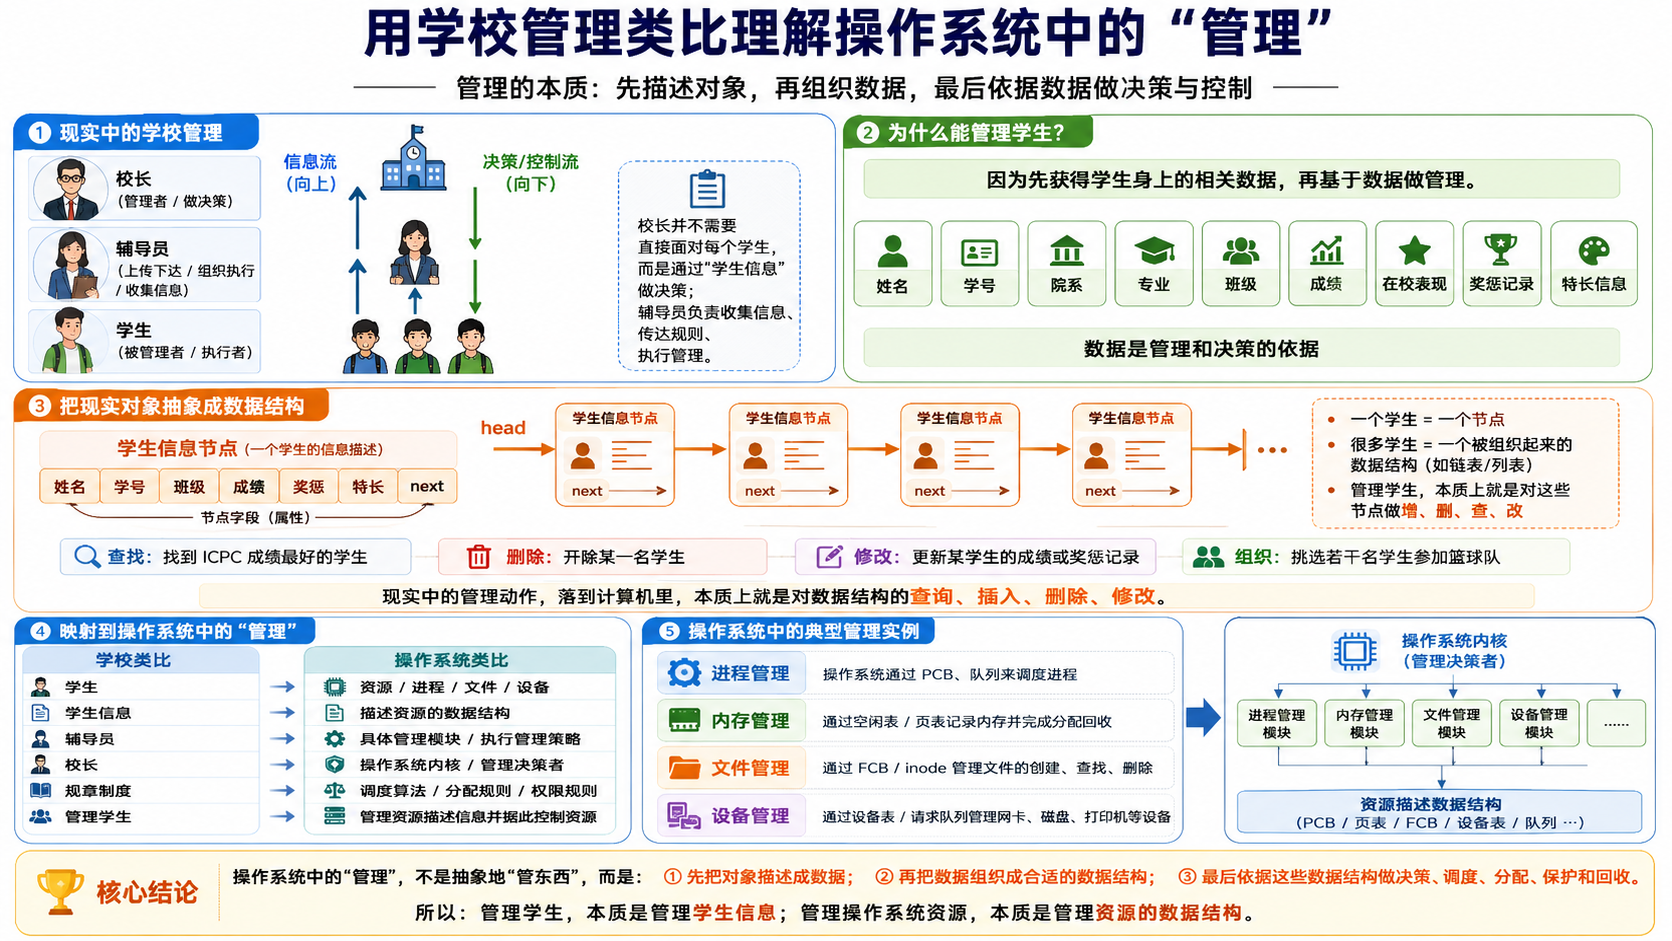
计算机管理硬件
(1)描述起来,⽤struct结构体
(2)组织起来,⽤链表或其他⾼效的数据结构
2.5系统调⽤和库函数概念
1.系统调用是什么?
系统调用 是应用程序请求操作系统内核帮忙做事的接口.
应用程序不能直接操作硬件,也不能随便访问系统资源,所以它必须通过系统调用进入内核,让操作系统代它完成一些底层操作.
常见系统调用包括:
text
open   打开文件
read   读文件
write  写文件
close  关闭文件
fork   创建进程
exec   执行程序
malloc 不是系统调用
例如 QQ 要发送消息,最终需要使用网卡,但 QQ 不能直接控制网卡,所以要通过系统调用请求操作系统发送网络数据.
可以理解为:
text
应用程序 → 系统调用 → 操作系统内核 → 驱动程序 → 硬件2.库函数是什么?
库函数 是程序开发时可以直接调用的现成函数,通常由标准库或第三方库提供.
它的作用是让程序员更方便地写程序,不用每次都直接写底层代码.
常见库函数包括:
text
printf   输出内容
scanf    输入内容
fopen    打开文件
fread    读文件
fwrite   写文件
fclose   关闭文件
malloc   申请内存
strlen 求字符串长度库函数运行在用户态,是应用程序的一部分.
3.二者关系
很多库函数内部会进一步调用系统调用.
例如C语言中的:
c
printf("hello\n");表面上调用的是库函数 printf,但如果要把内容输出到屏幕或终端,底层可能会调用系统调用:
text
printf → write 系统调用 → 操作系统内核 → 显示设备/终端再比如:
c
fopen("a.txt", "r");表面是库函数 fopen,底层可能会调用系统调用:
text
fopen → open 系统调用 → 操作系统内核 → 文件系统 → 磁盘4.主要区别
| 对比项 | 系统调用 | 库函数 |
|---|---|---|
| 所在层次 | 操作系统内核接口 | 用户层函数接口 |
| 执行位置 | 进入内核态执行 | 主要在用户态执行 |
| 作用 | 请求操作系统管理资源 | 简化程序开发 |
| 是否一定访问内核 | 是 | 不一定 |
| 例子 | open、read、write、fork |
printf、fopen、malloc、strlen |
5.重点理解
系统调用更底层,库函数更方便.
text
程序员通常调用库函数
库函数必要时调用系统调用
系统调用进入内核
内核再操作硬件或系统资源一句话总结:库函数是给程序员用的方便接口,系统调用是进入操作系统内核请求服务的接口.
3.进程
3.1进程基本概念与基本操作
1.进程的基本概念
进程就是正在运行的程序.
程序是静态的,放在磁盘里;进程是动态的,正在内存中运行.
例如:
text
QQ.exe 在磁盘里:程序
双击打开 QQ 后:进程
一个程序可以对应多个进程.比如你打开多个浏览器窗口或多个终端,可能就会产生多个进程.
一句话总结:进程就是正在运行的程序 .
操作系统管理进程,本质是:
text
用 PCB 描述进程
用队列组织进程
通过调度、阻塞、唤醒、切换、终止来控制进程运行最核心的一句话:进程管理就是操作系统对正在运行程序的创建、调度、切换、等待、唤醒和回收.
2.进程的基本操作
操作系统对进程的基本操作主要包括:
1.创建进程
当用户打开一个程序时,操作系统会创建进程.
例如:
text
双击 QQ → 操作系统创建 QQ 进程创建进程时,操作系统会:
text
分配 PID
创建 PCB
分配内存
加载程序代码
建立进程地址空间
把进程放入就绪队列
2.调度进程
如果有多个进程都想使用 CPU,操作系统要决定谁先运行.
例如:
text
QQ、浏览器、音乐软件都在运行CPU 不能真正同时执行所有进程,操作系统会快速切换:
text
QQ 运行一会儿 → 浏览器运行一会儿 → 音乐软件运行一会儿这个过程叫进程调度.
3.阻塞进程
当进程需要等待某些事情时,会进入阻塞态.
例如 QQ 等待网络消息:
text
QQ 进程 → 等待服务器数据 → 阻塞态此时CPU不会一直等QQ,而是去运行其他进程.
4.唤醒进程
当等待的事件发生后,操作系统会把进程从阻塞态变成就绪态.
例如:
text
网络数据到达 → 唤醒 QQ 进程 → QQ 进入就绪队列注意:唤醒后不是马上运行,而是先进入就绪态,等待CPU调度.
5.切换进程
当CPU 从一个进程切换到另一个进程时,需要保存和恢复现场.
例如:
text
QQ 正在运行 → 切换到浏览器操作系统会:
text
保存 QQ 的寄存器、程序计数器等信息到 PCB
恢复浏览器 PCB 中保存的运行状态
CPU 开始执行浏览器这个过程叫上下文切换.
6.终止进程
当程序运行结束或被强制关闭时,操作系统会终止进程.
例如:
text
关闭 QQ → QQ 进程终止操作系统会:
text
释放内存
关闭文件
断开网络连接
回收 PCB
释放 PID
3.1.1描述进程-->PCB
PCB:Process Control Block,进程控制块. 它是操作系统用来管理进程的数据结构.
PCB中通常记录:
text
进程 PID
进程状态
程序计数器 PC
寄存器信息
内存信息
打开文件信息
调度信息
父子进程关系
所以可以这样理解:管理进程,本质上就是管理进程的 PCB.
进程信息被放在⼀个叫做进程控制块的数据结构中,可以理解为进程属性的集合.
Linux 操作系统下的PCB 是: task_struct.
task_struct-PCB的⼀种
在Linux中描述进程的结构体叫做 task_struct.
task_struct 是Linux内核的⼀种数据结构类型,它会被装载到RAM(内存)⾥并且包含着进程的信息.
3.1.2task_ struct
内容分类
• 标示符:描述本进程的唯一标示符,用来区别其他进程.
• 状态:任务状态,退出代码,退出信号等.
• 优先级:相对于其他进程的优先级.
• 程序计数器:程序中即将被执行的下一条指令的地址.
• 内存指针:包括程序代码和进程相关数据的指针,还有和其他进程共享的内存块的指针.
• 上下文数据:进程执行时处理器的寄存器中的数据.
• I/O状态信息:包括显示的I/O请求,分配给进程的I/O设备和被进程使用的文件列表.
• 记账信息:可能包括处理器时间总和,使用的时钟数总和,时间限制,记账号等.
• 其他信息.
• 具体详细信息后续会介绍.
组织进程
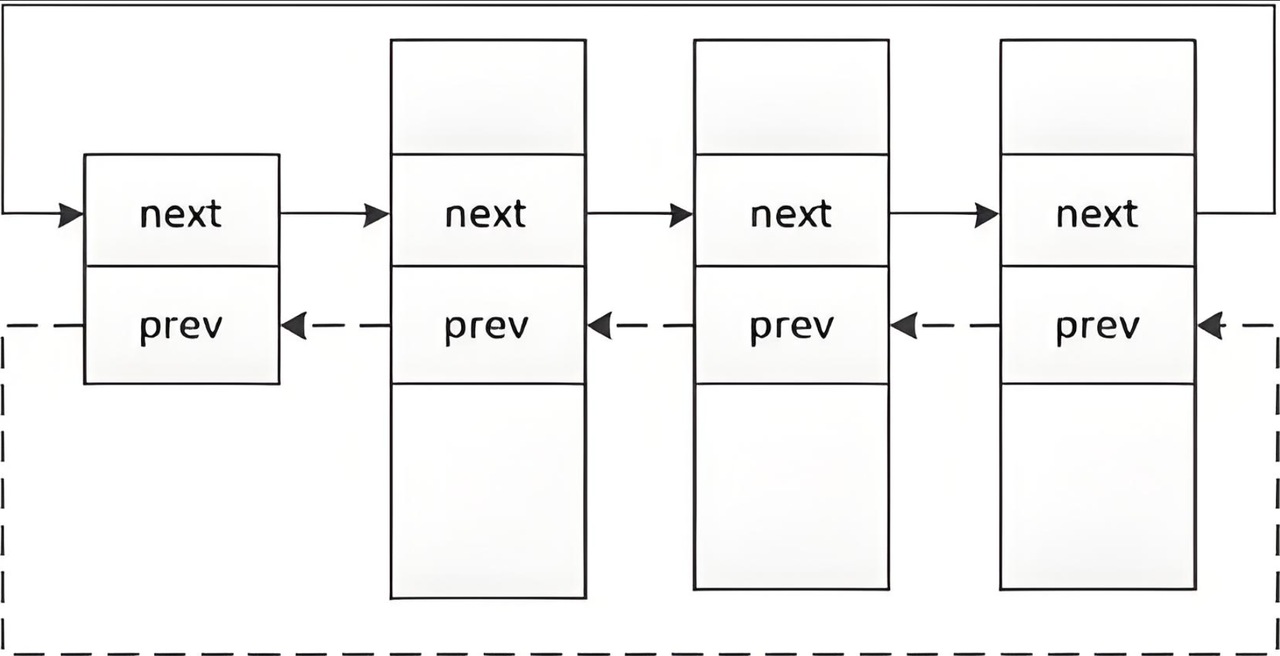
可以在内核源代码⾥找到它.所有运⾏在系统⾥的进程都以 task_struct 双链表的形式存在内核⾥.
3.1.3查看进程
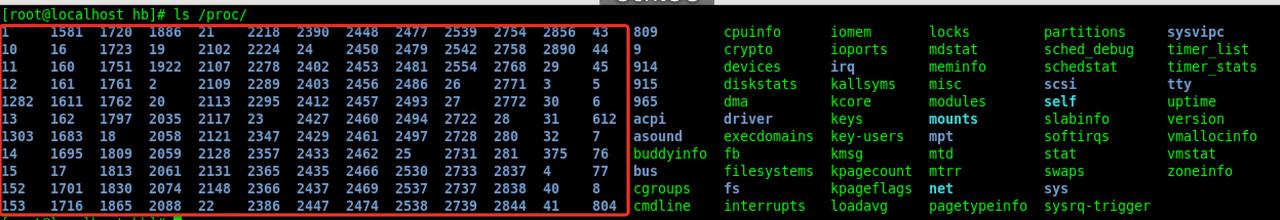
1.进程的信息可以通过 /proc 系统⽂件夹查看
如:要获取PID为1的进程信息,你需要查看 /proc/1 这个⽂件夹.
2.⼤多数进程信息同样可以使⽤top和ps这些⽤户级⼯具来获取
c
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>
int main()
{
while(1){
sleep(1);
}
return 0;
}
3.1.4通过系统调⽤获取进程标示符
c
//进程id(PID)
//⽗进程id(PPID)
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>
int main()
{
printf("pid: %d\n", getpid());
printf("ppid: %d\n", getppid());
return 0;
}
3.1.5通过系统调⽤创建进程-->fork初识
c
//运⾏ man fork 认识fork
//fork有两个返回值
//⽗⼦进程代码共享,数据各⾃开辟空间,私有⼀份(采⽤写时拷⻉)
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>
int main()
{
int ret = fork();
printf("hello proc : %d!, ret: %d\n", getpid(), ret);
sleep(1);
return 0;
}
c
//fork 之后通常要⽤if进⾏分流
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>
int main()
{
int ret = fork();
if(ret < 0){
perror("fork");
return 1;
}
else if(ret == 0){ //child
printf("I am child : %d!, ret: %d\n", getpid(), ret);
}else{ //father
printf("I am father : %d!, ret: %d\n", getpid(), ret);
}
sleep(1);
return 0;
}
📌 注意
1.为什么给子进程返回 0,给父进程返回子进程 pid?
因为 fork() 之后,父子进程会从同一个位置继续往下执行.系统必须让它们能区分自己是谁.
所以规定:
c
pid_t id = fork();返回值规则是:
text
子进程中:id == 0
父进程中:id > 0,值是子进程的 pid
创建失败:id < 0
为什么父进程要拿到子进程 pid?
因为父进程以后可能要管理子进程,比如:
text
等待子进程结束
回收子进程资源
给子进程发送信号
记录子进程状态
所以父进程需要知道"我创建的子进程是谁".
为什么子进程返回 0?
因为子进程可以通过 getpid() 得到自己的 pid,不需要 fork 再返回一次自己的 pid.
2.fork() 是一个函数,怎么可能返回两次?
因为 fork() 调用一次,但会创建出两个执行流:
text
fork 之前:只有父进程一个执行流
fork 之后:父进程和子进程两个执行流
父进程从 fork() 返回一次,子进程也从 fork() 返回一次.
所以不是一个进程里返回两次,而是:
text
父进程返回一次
子进程返回一次
合起来看,就像 fork() 返回了两次.
3.一个 id 怎么能接受两个不同的值?
因为 fork() 之后,父子进程拥有各自独立的地址空间.
代码看起来一样:
c
pid_t id = fork();但实际上父进程和子进程各有一份自己的 id 变量.
所以:
text
父进程中的 id = 子进程 pid,大于 0
子进程中的 id = 0
它们不是同一个物理变量,只是名字和代码位置一样.
关键理解
fork() 后,父子进程代码相同,但执行流不同,返回值不同,地址空间也彼此独立.
可以这样记:
text
fork 之前:一个进程
fork 之后:两个进程

父进程:fork 返回子进程 pid
子进程:fork 返回 0
失败:fork 返回 -1
示例:
c
pid_t id = fork();

if (id == 0) {
    printf("我是子进程\n");
} else if (id > 0) {
    printf("我是父进程,子进程 pid 是 %d\n", id);
} else {
    printf("fork 失败\n");
}一句话总结:fork() 不是普通意义上只产生一个返回结果的函数,它会复制出一个子进程,因此父子进程分别从 fork() 处继续执行,并得到不同返回值.
3.2进程状态
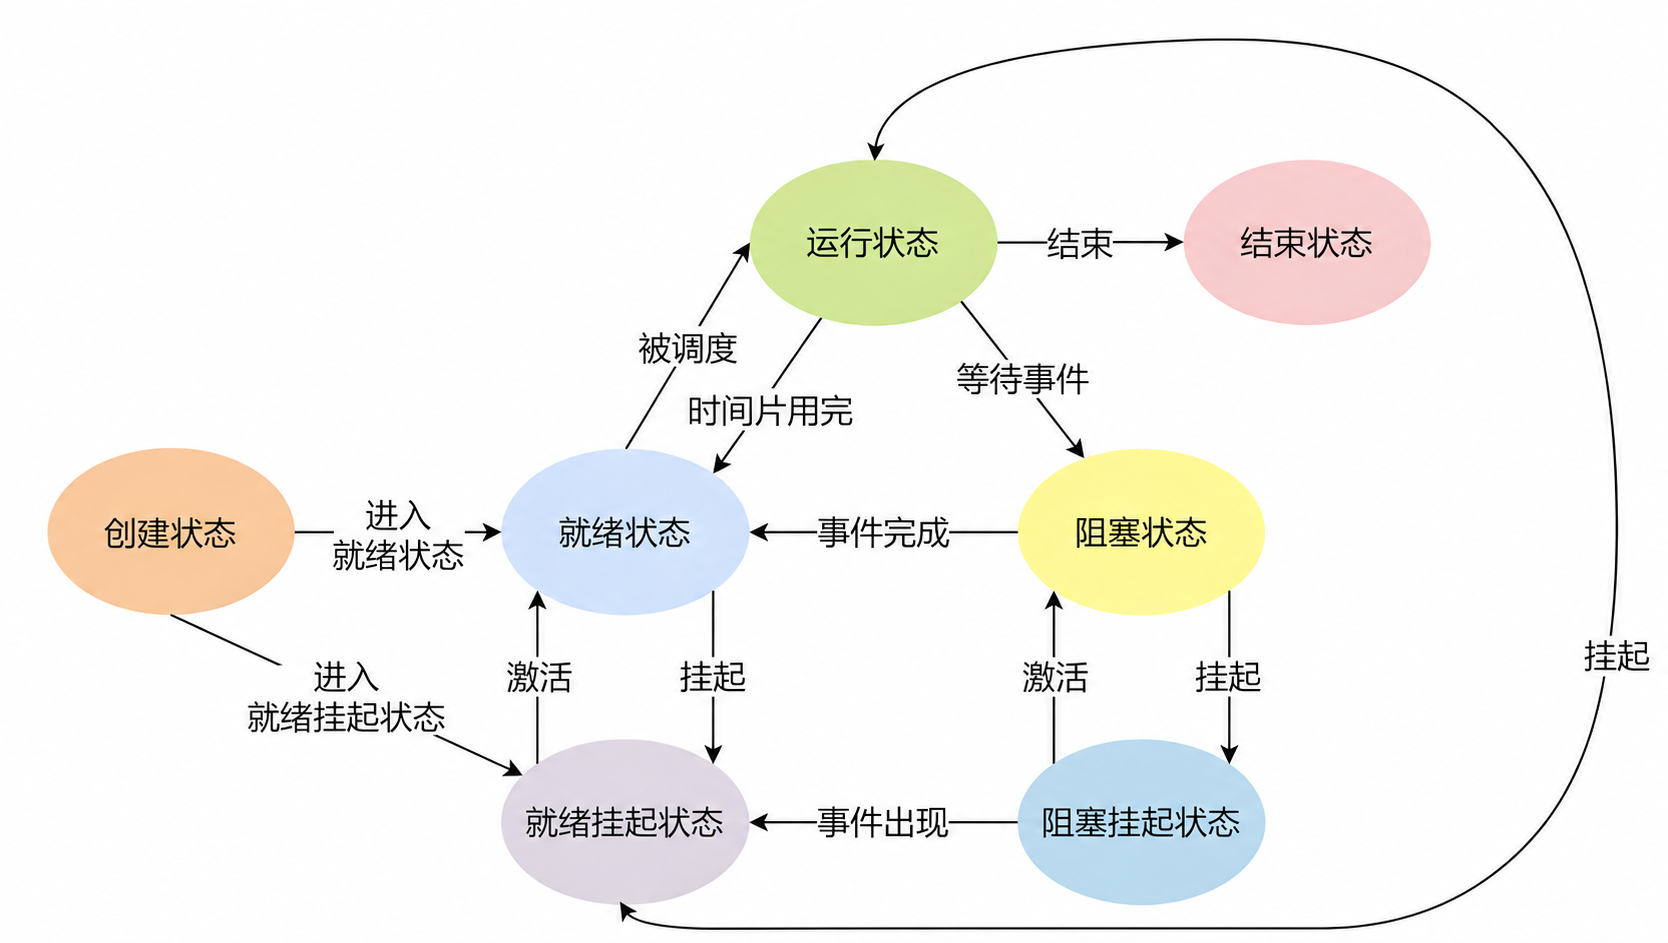
这张图讲的是进程的状态转换,也就是一个进程从创建到结束,中间可能经历哪些状态,以及状态之间如何变化.
1.创建状态
进程刚被创建时,处于创建状态 .
例如你双击打开 QQ,操作系统开始创建 QQ 进程:
text
创建 PCB
分配 PID
分配内存
加载程序代码创建完成后,进程不会马上运行,而是进入就绪状态 或就绪挂起状态.
2.就绪状态
就绪状态 表示:进程已经准备好运行,只差 CPU.
也就是说,进程需要的代码、数据等已经在内存中,只要操作系统调度它,它就能运行.
状态转换:就绪状态 → 运行状态
条件是:被调度.
3.运行状态
运行状态 表示:进程正在占用 CPU 执行.
例如 QQ 正在处理你输入的文字、刷新界面、发送消息时,就可能处于运行状态.
运行状态有几种可能变化:
① 运行 → 结束状态
如果程序执行完了,进程结束:运行状态 → 结束状态
② 运行 → 就绪状态
如果时间片用完,CPU 要让给其他进程:运行状态 → 就绪状态
这叫时间片用完 .
例如 CPU 让 QQ 运行一小段时间后,又切换去运行浏览器.
③ 运行 → 阻塞状态
如果进程要等待某个事件:运行状态 → 阻塞状态
例如:
text
等待键盘输入
等待网络数据
等待磁盘读写完成
4.阻塞状态
阻塞状态 表示:进程暂时不能运行,因为它在等待某件事情完成.
比如 QQ 正在等服务器返回消息,这时它不能继续处理后续逻辑,就会进入阻塞状态.
当等待的事件完成后:阻塞状态 → 就绪状态
图中标的是事件完成 .
注意:阻塞结束后不是直接进入运行状态,而是先回到就绪状态,等待 CPU 调度.
5.就绪挂起状态
就绪挂起状态 表示:进程本来已经准备好运行,但暂时被移出内存,放到了外存中.
也就是说,它逻辑上是"就绪"的,但因为不在内存里,所以暂时不能直接运行。
状态转换:就绪状态 → 就绪挂起状态
原因是:挂起 .
就绪挂起状态 → 就绪状态
原因是:激活 .
可以理解为:操作系统为了节省内存,把暂时不运行的进程换出到磁盘;需要时再换回内存.
6.阻塞挂起状态
阻塞挂起状态 表示:进程既在等待事件,又被移出内存.
例如某个进程正在等待磁盘 I/O,操作系统发现它短时间内也运行不了,就可能把它挂起,腾出内存给其他进程.
状态转换:
阻塞状态 → 阻塞挂起状态
原因是:挂起 .
阻塞挂起状态 → 阻塞状态
原因是:激活 .
如果它等待的事件已经发生:
阻塞挂起状态 → 就绪挂起状态
图中标的是事件出现 .
因为事件完成后,它不再阻塞了,但它仍然在外存中,所以变成就绪挂起状态.
一句话总结:进程状态转换的本质,就是操作系统根据CPU、内存、I/O 事件等情况,对进程进行调度、阻塞、唤醒、挂起和激活.
3.2.1Linux内核源代码定义的进程
bash
为了弄明⽩正在运⾏的进程是什么意思,我们需要知道进程的不同状态.⼀个进程可以有⼏个状态(在Linux内核⾥,进程有时候也叫做任务).下⾯的状态在kernel源代码⾥定义:

/*
*The task state array is a strange "bitmap" of
*reasons to sleep. Thus "running" is zero, and
*you can test for combinations of others with
*simple bit tests.
*/
static const char *const task_state_array[] = {
"R (running)", /*0 */
"S (sleeping)", /*1 */
"D (disk sleep)", /*2 */
"T (stopped)", /*4 */
"t (tracing stop)", /*8 */
"X (dead)", /*16 */
"Z (zombie)", /*32 */
};
Linux 内核里会用进程的task_struct 记录进程状态.ps 命令看到的 STAT 字段,就是这些状态的外部表现.
常见状态如下:
| 状态 | 含义 | 说明 |
|---|---|---|
R |
running | 正在运行,或者已经准备好运行,处于就绪队列中 |
S |
sleeping | 可中断睡眠,正在等待某个事件,比如等待输入、等待资源 |
D |
disk sleep | 不可中断睡眠,通常在等待磁盘 I/O,不能被普通信号打断 |
T |
stopped | 被暂停,比如收到 SIGSTOP、SIGTSTP |
t |
tracing stop | 被追踪器暂停,比如被 gdb 调试 |
X |
dead | 死亡状态,基本看不到,是内核内部的过渡状态 |
Z |
zombie | 僵尸状态,进程已经退出,但父进程还没有回收它 |
3.2.2进程状态查看
bash
ps aux / ps axj 命令a:显示⼀个终端所有的进程,包括其他⽤⼾的进程.
x:显示没有控制终端的进程,例如后台运⾏的守护进程.
j:显示进程归属的进程组ID、会话ID、⽗进程ID,以及与作业控制相关的信息.
u:以⽤⼾为中⼼的格式显⽰进程信息,提供进程的详细信息,如⽤⼾、CPU和内存使⽤情况等.
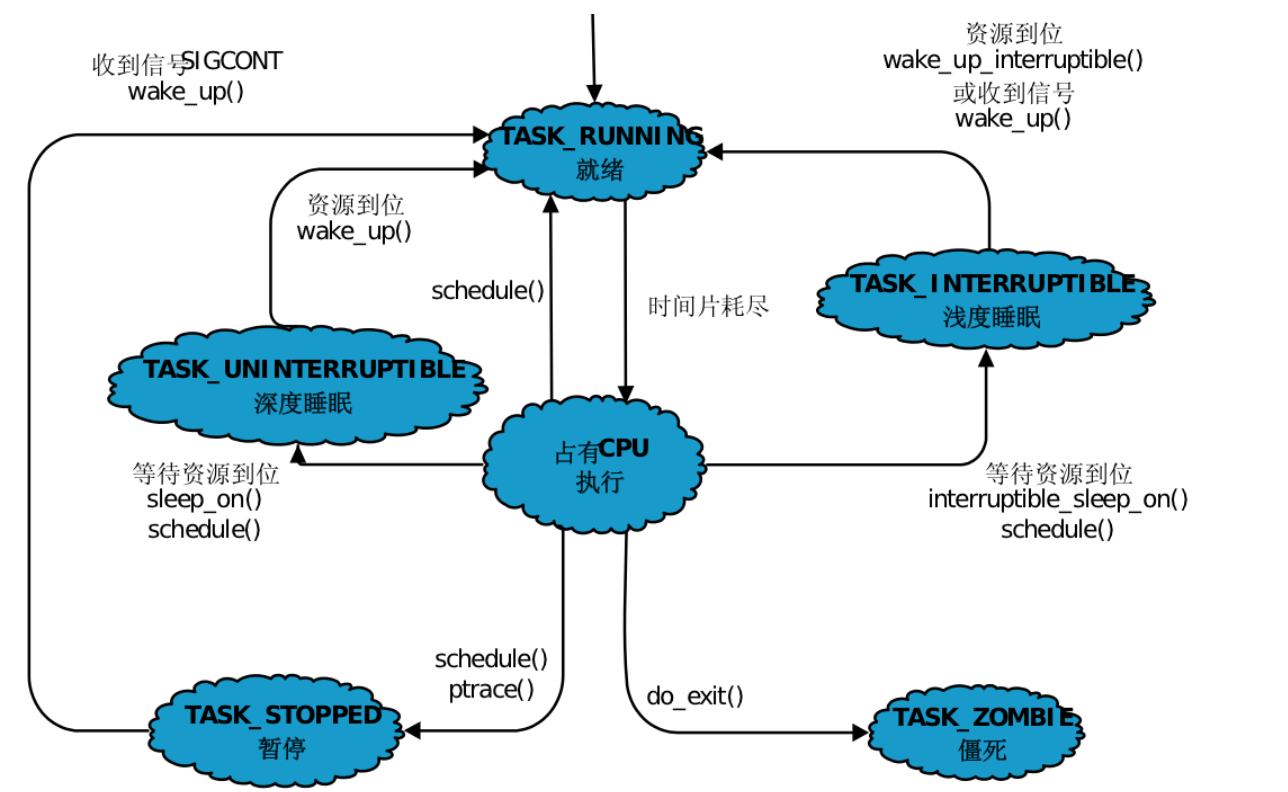
这张图展示的是 Linux 进程/任务的状态转换关系,也就是一个进程从"就绪、运行、睡眠、停止、僵尸"等状态之间如何切换.
核心可以理解为:进程并不是一直占用 CPU,而是在不同状态之间不断流转,具体由调度器、资源是否就绪、信号、退出等因素决定.
1.TASK_RUNNING:就绪状态
图中上方的 TASK_RUNNING / 就绪 表示进程已经具备运行条件.
注意:在 Linux 中,TASK_RUNNING 并不一定表示正在占用 CPU,它包括两种情况:
一是进程正在 CPU 上执行;二是进程已经准备好了,正在等待调度器分配 CPU.
也就是说,TASK_RUNNING 更准确地说是:可运行状态.
当进程被唤醒,比如资源到位或者收到某些信号时,会回到这个状态.
2.占有 CPU 执行:真正运行中
中间的 占有 CPU 执行 表示进程被调度器选中,真正拿到了 CPU 时间片,正在运行代码.
从 TASK_RUNNING 到"占有 CPU 执行",靠的是调度器调度.
如果时间片耗尽,或者进程主动调用 schedule() 让出 CPU,它会重新回到就绪队列,等待下一次调度.
图中的:
text
时间片耗尽
schedule()
表达的就是这个过程.
3.TASK_INTERRUPTIBLE:浅度睡眠,可中断睡眠
右侧的 TASK_INTERRUPTIBLE / 浅度睡眠 表示进程正在等待某个资源或事件,但这个等待可以被信号打断.
比如进程在等待:
text
interruptible_sleep_on()
schedule()
进入浅度睡眠.
如果资源到位,会通过:
text
wake_up_interruptible()把进程唤醒.
如果收到信号,也可以通过:
text
wake_up()唤醒它.
所以浅度睡眠的特点是:
等资源时睡眠,但收到信号也能醒.
常见例子包括等待键盘输入、等待 socket 数据、等待某些可中断 I/O.
4.TASK_UNINTERRUPTIBLE:深度睡眠,不可中断睡眠
左侧的 TASK_UNINTERRUPTIBLE / 深度睡眠 表示进程也在等待资源,但它不能被普通信号打断.
图中对应:
text
sleep_on()
schedule()
进程进入深度睡眠.
当等待的资源到位后,通过:
text
wake_up()回到 TASK_RUNNING.
深度睡眠的特点是:
必须等资源满足,普通信号无法唤醒.
这类状态常见于某些底层 I/O,比如等待磁盘 I/O、网络文件系统、块设备响应等.
如果一个进程长期处于 D 状态,通常说明它在等待内核态资源,可能存在磁盘、驱动、存储、NFS 等问题.
5.TASK_STOPPED:暂停状态
左下角的 TASK_STOPPED / 暂停 表示进程被暂停执行了.
图里从"占有 CPU 执行"到暂停状态标注了:
text
schedule()
ptrace()
这通常和调试、作业控制、信号有关.
例如进程收到:
text
SIGSTOP
SIGTSTP
就可能进入暂停状态.
如果之后收到:
text
SIGCONT就会被唤醒,重新回到 TASK_RUNNING.
所以 TASK_STOPPED 可以理解为:进程还活着,但被暂停了,暂时不参与正常运行.
6.TASK_ZOMBIE:僵尸状态
右下角的 TASK_ZOMBIE / 僵尸 表示进程已经执行结束,但它的父进程还没有回收它的退出状态.
图中从"占有 CPU 执行"到僵尸状态写的是:
text
do_exit()也就是进程调用退出逻辑后进入僵尸状态.
僵尸进程本身已经不再运行,也不再占用 CPU,但它还保留一部分进程信息,比如 PID、退出码等,等待父进程通过:
text
wait()
waitpid()
回收.
如果父进程一直不回收,就会看到僵尸进程长期存在.
3.2.3Z(zombie)-->僵⼫进程
- 僵死状态(Zombies)是⼀个⽐较特殊的状态.当进程退出并且⽗进程(使⽤wait()系统调⽤,后
⾯会讲)没有读取到⼦进程退出的返回代码时就会产⽣僵死(⼫)进程. - 僵死进程会以终⽌状态保持在进程表中,并且会⼀直在等待⽗进程读取退出状态代码.
- 所以,只要⼦进程退出,⽗进程还在运⾏,但⽗进程没有读取⼦进程状态,⼦进程进⼊Z状态.
来⼀个创建维持30秒的僵死进程例⼦:
cpp
#include <stdio.h>
#include <stdlib.h>
int main()
{
pid_t id = fork();
if(id < 0){
perror("fork");
return 1;
}
else if(id > 0){ //parent
printf("parent[%d] is sleeping...\n", getpid());
sleep(30);
}else{
printf("child[%d] is begin Z...\n", getpid());
sleep(5);
exit(EXIT_SUCCESS);
}
return 0;
}
编译并在另⼀个终端下启动监控

开始测试
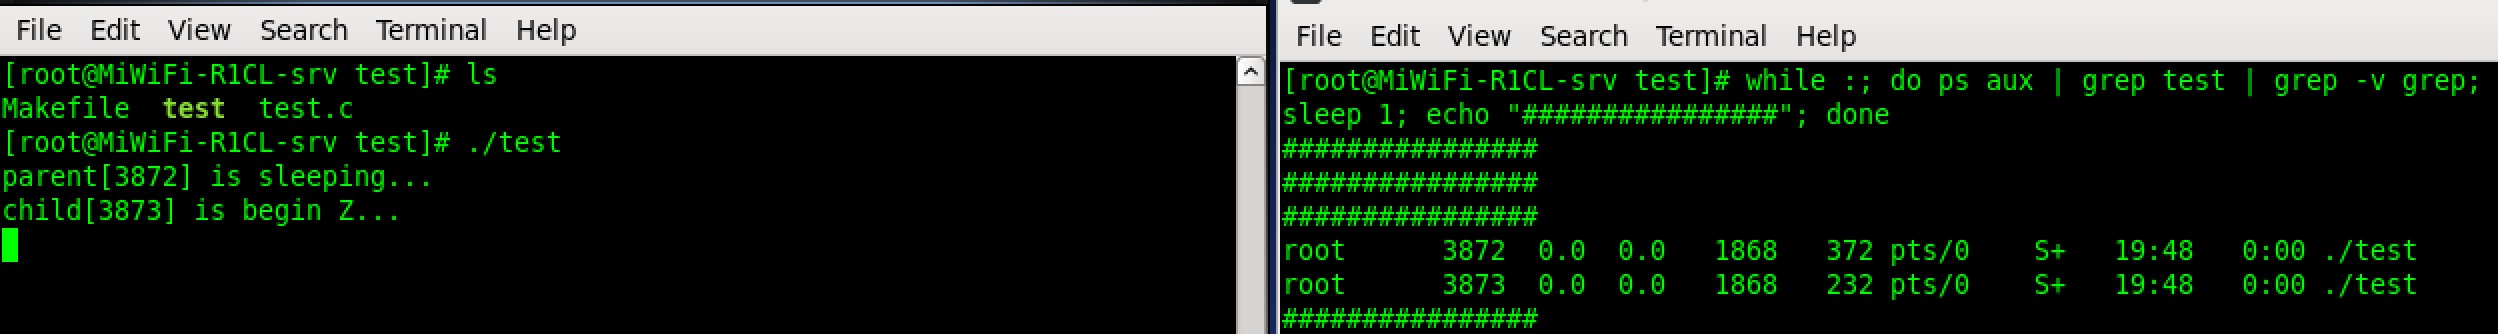
看到结果
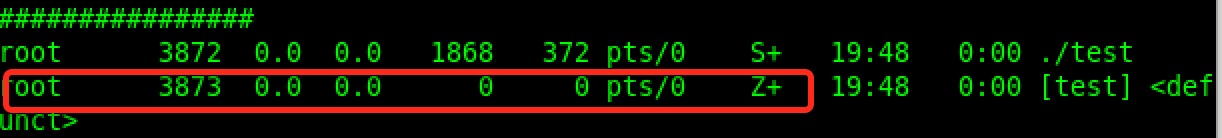
3.2.4ptrace系统调⽤追踪进程运⾏
ptrace 是 Linux/Unix 系统中的一个系统调用,全称可以理解为 process trace,主要用于让一个进程去观察、控制另一个进程的执行过程.
它最典型的用途就是:
调试器跟踪程序运行.
比如我们常用的 gdb,底层就大量依赖 ptrace.
1.ptrace 能做什么?
通过 ptrace,一个进程可以充当 跟踪者 tracer ,另一个进程作为 被跟踪者 tracee.
跟踪者可以对被跟踪进程做很多事情,例如:
| 能力 | 说明 |
|---|---|
| 暂停进程 | 让目标进程停下来,方便检查状态 |
| 单步执行 | 一条指令一条指令地运行 |
| 读取寄存器 | 查看 CPU 寄存器中的值 |
| 修改寄存器 | 改变程序接下来执行的位置或参数 |
| 读取内存 | 查看目标进程内存中的变量、栈、堆等 |
| 修改内存 | 改变量值、打补丁、插入断点 |
| 监听系统调用 | 在系统调用进入和退出时拦截 |
| 捕获信号 | 观察或控制目标进程收到的信号 |
所以 ptrace 不只是"看",它还可以"控制".
2.ptrace 的典型工作模型
通常有两种方式建立跟踪关系.
方式一:子进程主动请求被跟踪
调试器启动一个新程序时,经常是这样做的:
- 父进程
fork()出子进程; - 子进程调用:
c
ptrace(PTRACE_TRACEME, 0, NULL, NULL);- 子进程执行
exec()加载目标程序; - 父进程成为调试器,开始控制子进程.
简单示意:
c
if (fork() == 0) {
    ptrace(PTRACE_TRACEME, 0, NULL, NULL);
    execl("./test", "test", NULL);
} else {
    wait(NULL);
    // 父进程开始调试子进程
}
这就是很多调试器启动被调试程序时的基本模式.
方式二:附加到已有进程
如果目标进程已经在运行,可以通过:
c
ptrace(PTRACE_ATTACH, pid, NULL, NULL);附加到它.
附加成功后,目标进程通常会被暂停,调试器可以读取它的信息、设置断点、继续执行.
调试完成后,可以用:
c
ptrace(PTRACE_DETACH, pid, NULL, NULL);解除跟踪.
3.常见 ptrace 请求
ptrace 的原型大致是:
c
long ptrace(enum __ptrace_request request,
            pid_t pid,
            void *addr,
            void *data);
其中 request 决定要做什么.
常见请求包括:
| 请求 | 作用 |
|---|---|
PTRACE_TRACEME |
当前进程声明自己允许父进程跟踪 |
PTRACE_ATTACH |
附加到一个正在运行的进程 |
PTRACE_DETACH |
解除跟踪 |
PTRACE_CONT |
让被跟踪进程继续运行 |
PTRACE_SINGLESTEP |
单步执行一条指令 |
PTRACE_PEEKDATA |
读取目标进程内存数据 |
PTRACE_POKEDATA |
修改目标进程内存数据 |
PTRACE_GETREGS |
获取寄存器内容 |
PTRACE_SETREGS |
修改寄存器内容 |
PTRACE_SYSCALL |
在系统调用入口/出口处暂停 |
4.ptrace 如何追踪系统调用?
如果使用:
c
ptrace(PTRACE_SYSCALL, pid, NULL, NULL);被跟踪进程会在每次系统调用入口和出口处暂停.
这就是 strace 的核心原理.
例如你执行:
bash
strace ls会看到 ls 程序执行过程中调用了哪些系统调用,比如:
text
openat(...)
read(...)
write(...)
close(...)
exit_group(...)
strace 通过 ptrace 拦截系统调用边界,然后读取寄存器中的系统调用号、参数和返回值.
一句话总结:
ptrace 是 Linux 提供的进程跟踪与控制机制,它允许调试器暂停、观察、修改和继续执行目标进程,是 gdb、strace 等工具的底层核心能力.
3.2.5僵⼫进程危害
- (1)进程的退出状态必须被维持下去,因为他要告诉关⼼它的进程(⽗进程),你交给我的任务,我办的怎么样了.可⽗进程如果⼀直不读取,那⼦进程就⼀直处于Z状态?是的,如果父进程一直存活,但一直不调用
wait()/waitpid()等接口读取子进程的退出状态,那么子进程就会一直处于Z状态,也就是僵尸进程状态.
子进程退出时,内核不会立刻把它的进程表项完全删除,而是会保留一小部分信息给父进程读取,例如:
text
子进程 PID
退出码
终止信号
资源使用统计
父进程读取之后,内核才会彻底释放这个子进程残留的进程表项.
可以理解为:
text
子进程退出
    ↓
进入 Z 状态,等待父进程收尸
    ↓
父进程调用 wait()/waitpid()
    ↓
内核释放子进程最后的记录
    ↓
僵尸进程消失
如果父进程一直不 wait(),并且父进程自己也不退出,那么这个子进程就会一直是:
text
STAT = Z
COMMAND = <defunct>不过有一个例外:如果父进程退出了 ,这个僵尸子进程会变成孤儿进程,被 init 或 systemd 接管.接管后,init/systemd 通常会调用 wait() 回收它,所以僵尸进程就会消失.
所以结论是:
父进程活着但不回收,子进程会一直 Z;父进程退出后,子进程通常会被系统 1 号进程接管并回收.
- (2)维护退出状态本⾝就是要⽤数据维护,也属于进程基本信息,所以保存在task_struct(PCB)中,换句话说,Z状态⼀直不退出,PCB⼀直都要维护?对,可以这么理解:子进程进入
Z僵尸状态后,内核仍然要保留它的一部分进程描述信息,因此对应的task_struct/ PCB 相关信息不会被完全释放.
但要注意一点:僵尸进程并不是完整地保留整个进程运行时资源.
子进程执行 exit() 后,大部分资源已经释放了,比如:
| 资源 | 是否还保留 |
|---|---|
| 用户态代码段、数据段、堆、栈 | 基本释放 |
| 打开的文件描述符 | 关闭/释放 |
| 占用的内存页 | 释放 |
| CPU 执行资格 | 没有 |
| 调度运行能力 | 没有 |
| PID | 保留 |
| 退出码 | 保留 |
| 终止信号 | 保留 |
| 部分资源统计信息 | 保留 |
进程表项 / task_struct 关键信息 |
保留 |
也就是说,Z 状态的进程已经不是一个"能运行的进程",但它还保留了一个等待父进程读取的尸体记录.
原因是父进程可能需要知道:
c
wait(&status);里的 status,比如:
text
子进程是正常退出还是异常退出?
退出码是多少?
是不是被信号杀死的?
用了多少资源?
所以内核必须保留这些信息,直到父进程调用:
c
wait()
waitpid()
waitid()
完成回收.
这句话可以进一步表述为:
Z 状态不退出,本质上就是子进程的 PCB 残留信息一直没有被父进程回收,因此内核必须继续维护这部分进程描述符信息.
不过更严谨一点说:
不是完整 PCB 的所有资源都还在,而是 task_struct 中用于表示进程身份、退出状态和父子关系等必要字段仍然存在.
可以这样画:
text
子进程运行中
  task_struct + mm_struct + 文件表 + 信号处理 + 调度信息 + 用户态内存
        ↓ exit()
释放大部分资源
        ↓
僵尸状态 Z
  保留 PID + task_struct 残留 + exit_code + 统计信息
        ↓ wait()
父进程读取退出状态
        ↓
释放最后的 task_struct / PID 等信息所以结论是:只要僵尸进程没有被 wait() 回收,内核就必须维护它残留的 PCB / task_struct 信息;大量僵尸进程会持续占用进程表项和 PID 资源.
- (3)那⼀个⽗进程创建了很多⼦进程,就是不回收,是不是就会造成内存资源的浪费?是的,会造成资源浪费 ,但要区分清楚:僵尸进程浪费的主要不是普通意义上的"大量用户态内存",而是内核资源.
子进程退出进入 Z 状态后,它的代码段、堆、栈、打开文件、用户态内存页等大部分资源已经释放了,所以单个僵尸进程通常不会占用很多内存.
但是父进程创建了很多子进程却一直不回收,就会不断残留:
| 残留资源 | 说明 |
|---|---|
| PID | 每个僵尸进程仍然占用一个 PID |
| 进程表项 | 系统仍能在进程表中看到它 |
部分 task_struct 信息 |
用于保存进程身份、退出状态、父子关系等 |
| 退出状态 | 供父进程 wait() / waitpid() 读取 |
| 资源统计信息 | 比如运行时间、退出原因等 |
所以大量僵尸进程会导致:
-
内核内存浪费
每个僵尸进程都要保留少量内核数据结构,数量多了就会明显浪费.
-
PID 被耗尽
这是更常见、更严重的问题.PID 数量不是无限的,如果僵尸进程太多,占住大量 PID,系统可能无法创建新进程.
-
进程表压力增大
ps、top等工具会看到大量<defunct>进程,系统维护和遍历进程信息也会更混乱. -
业务异常放大
父进程不断创建子进程但不回收,说明程序逻辑有问题.子进程越多,僵尸越多,最终可能影响业务继续 fork 新任务.
可以这样理解:
text
少量僵尸进程:
占一点内核资源,通常影响不大

大量僵尸进程:
占 PID + 占进程表项 + 占内核数据结构
最终可能导致系统无法 fork 新进程所以:父进程创建很多子进程却不回收,会造成资源浪费;虽然不是大量用户态内存泄漏,但会造成内核资源泄漏,尤其是 PID 和进程表项泄漏.
- (4)僵⼫进程危害会造成内存泄漏?严格说,僵尸进程一般不算典型的"用户态内存泄漏" ,但它会造成内核资源泄漏/浪费,其中也包括少量内核内存长期无法释放.
子进程退出后,大部分资源已经被释放了,比如:
| 资源 | 僵尸状态下是否还占用 |
|---|---|
| 用户态堆、栈、代码段、数据段 | 基本已释放 |
| 打开的文件描述符 | 已关闭 |
| 占用的普通内存页 | 已释放 |
| CPU | 不占用 |
| PID | 仍占用 |
进程表项/部分 task_struct |
仍占用 |
| 退出状态、资源统计信息 | 仍保存 |
所以更准确的说法是:**僵尸进程不会造成大量用户态内存泄漏,但会造成内核中进程描述信息长期残留.**如果只有一两个僵尸进程,影响通常很小;但如果父进程不断创建子进程又不 wait() 回收,僵尸进程大量堆积,就会导致:
- 内核内存被浪费 :每个僵尸进程都要保留少量 PCB /
task_struct相关信息. - PID 被占用:大量僵尸进程可能导致 PID 资源耗尽.
- 系统无法创建新进程 :严重时
fork()可能失败. - 说明父进程有 bug:父进程没有正确回收子进程退出状态.
因此可以这样回答:
僵尸进程本身不会造成传统意义上的内存泄漏,因为子进程退出时大部分用户态资源已经释放;但如果父进程长期不回收,内核仍需维护其 PID、退出状态和部分 PCB 信息,造成内核资源泄漏.数量过多时会浪费内核内存、占用进程表项和 PID,严重时导致系统无法创建新进程.
- (5)僵⼫进程危害如何避免?避免僵尸进程的核心原则是:**父进程必须及时回收已经退出的子进程.**子进程退出后,父进程要通过
wait()/waitpid()/waitid()读取子进程退出状态,这样内核才能释放残留的 PCB、PID、退出码等信息.
1.父进程主动 wait 回收
如果父进程创建子进程后会等待它结束,可以直接用:
c
int status;
pid_t pid = wait(&status);
或者更常用:
c
int status;
pid_t pid = waitpid(child_pid, &status, 0);
这样父进程会阻塞,直到指定子进程退出.
适合场景:父进程必须等待子进程执行完成,比如命令执行、批处理任务.
2.使用非阻塞 waitpid 回收
如果父进程不能一直阻塞等待子进程,可以使用 WNOHANG:
c
int status;
pid_t pid;

while ((pid = waitpid(-1, &status, WNOHANG)) > 0) {
    // 回收已经退出的任意子进程
}
-1 表示回收任意子进程,WNOHANG 表示没有子进程退出时立即返回,不阻塞父进程.
适合场景:服务器主进程、事件循环程序、长期运行的守护进程...
3.捕获 SIGCHLD 信号
子进程退出时,内核会给父进程发送 SIGCHLD 信号.父进程可以注册信号处理函数,在里面调用 waitpid() 回收子进程:
c
#include <sys/wait.h>
#include <signal.h>
#include <unistd.h>

void sigchld_handler(int signo) {
    int status;
    while (waitpid(-1, &status, WNOHANG) > 0) {
        // 回收所有已退出的子进程
    }
}

int main() {
    signal(SIGCHLD, sigchld_handler);

    while (1) {
        // 父进程主逻辑
        sleep(1);
    }

    return 0;
}
注意这里要用 while,因为多个子进程可能几乎同时退出,但信号可能合并.如果只 waitpid() 一次,可能还有其他僵尸进程没被回收.
4.忽略 SIGCHLD
在一些系统上,可以通过忽略 SIGCHLD,让内核自动回收子进程:
c
signal(SIGCHLD, SIG_IGN);或者使用:
c
struct sigaction sa;
sa.sa_handler = SIG_IGN;
sigemptyset(&sa.sa_mask);
sa.sa_flags = 0;
sigaction(SIGCHLD, &sa, NULL);
这种方式适合父进程完全不关心子进程退出状态的场景.
不过要注意:如果你还需要获取子进程退出码,就不能直接忽略 SIGCHLD,因为自动回收后你就拿不到退出状态了.
5.双 fork 创建守护进程
传统 Unix 编程中,经常用"双 fork"避免僵尸进程.
大致流程是:
text
父进程 fork 子进程
子进程 fork 孙进程
子进程立即退出
父进程 wait 回收子进程
孙进程被 init/systemd 接管
孙进程退出后由 init/systemd 回收
这样最终真正干活的是孙进程,它不再由原父进程直接管理,而是交给 1 号进程接管.
适合场景:创建后台任务、守护进程.
6.使用成熟的进程管理器
实际生产环境中,可以让成熟组件负责进程生命周期管理,例如:
text
systemd
supervisord
pm2
gunicorn master
nginx master
容器 init 进程 tini/dumb-init
这些工具通常会处理子进程回收问题.
特别是在 Docker 容器里,如果主进程是 PID 1,又没有正确处理 SIGCHLD,非常容易产生僵尸进程.可以使用:
bash
docker run --init ...或者在镜像中使用 tini / dumb-init 作为入口进程.
7.避免无限制 fork 子进程
除了回收,还要控制创建速度和数量.
比如:
- 不要在循环中无控制地
fork() - 使用进程池代替频繁创建子进程
- 限制并发任务数量
- 子进程异常退出时做好日志记录
- 父进程定期检查并回收退出子进程
避免僵尸进程的方法可以概括为:
| 方法 | 适用场景 |
|---|---|
wait() |
父进程可以阻塞等待 |
waitpid() |
指定回收某个子进程 |
waitpid(-1, WNOHANG) |
非阻塞回收任意已退出子进程 |
处理 SIGCHLD |
长期运行的父进程 |
忽略 SIGCHLD |
不关心子进程退出状态 |
| 双 fork | 创建守护进程 |
| 使用进程管理器 | 生产环境服务管理 |
3.2.6孤⼉进程
孤儿进程 指的是:父进程已经退出,但子进程还没有退出 的进程.
这时候子进程就变成了孤儿进程.孤儿进程不会没人管,Linux/Unix 系统会把它交给 1 号进程 接管,通常是 init 或 systemd.
可以这样理解:
text
父进程创建子进程
    ↓
父进程先退出
    ↓
子进程还在运行
    ↓
子进程变成孤儿进程
    ↓
被 init/systemd 接管
    ↓
子进程退出后,由 init/systemd 回收
举个例子
假设父进程创建了一个子进程:
c
#include <stdio.h>
#include <unistd.h>

int main() {
    pid_t pid = fork();

    if (pid > 0) {
        printf("父进程退出,pid=%d\n", getpid());
        return 0;
    } else if (pid == 0) {
        sleep(30);
        printf("子进程继续运行,pid=%d, ppid=%d\n", getpid(), getppid());
    }

    return 0;
}
这里父进程很快退出,子进程还会继续 sleep(30).在父进程退出后,子进程的父进程 ID,也就是 PPID,会变成 1,表示它被 init/systemd 接管了.
孤儿进程和僵尸进程的区别
| 类型 | 父进程状态 | 子进程状态 | 是否还在运行 |
|---|---|---|---|
| 孤儿进程 | 父进程已退出 | 子进程还活着 | 可能正在运行 |
| 僵尸进程 | 父进程还活着但不回收 | 子进程已退出 | 不会运行 |
简单说:
孤儿进程是"父进程没了,子进程还活着".
僵尸进程是"子进程死了,但父进程还没收尸".
孤儿进程有危害吗?
一般来说,孤儿进程本身没有太大危害.
因为系统会自动把孤儿进程交给 init/systemd 接管.等孤儿进程结束后,init/systemd 会调用 wait() 回收它,不会长期变成僵尸进程.
但是如果孤儿进程本身是异常遗留的后台任务,比如一直占用 CPU、内存、文件句柄、端口或者磁盘资源,那就可能有危害.
所以孤儿进程是否有问题,取决于它本身在做什么,而不是"孤儿"这个状态本身.
如何查看孤儿进程?
可以用:
bash
ps -ef重点看 PPID 列:
text
UID        PID   PPID  CMD
user      1234      1  ./child_process
如果某个普通业务进程的 PPID 是 1,说明它可能是孤儿进程,已经被 init/systemd 接管.
一句话总结:孤儿进程是父进程退出后仍然运行的子进程,它会被 1 号进程接管,通常不会像僵尸进程那样长期占用进程表项.
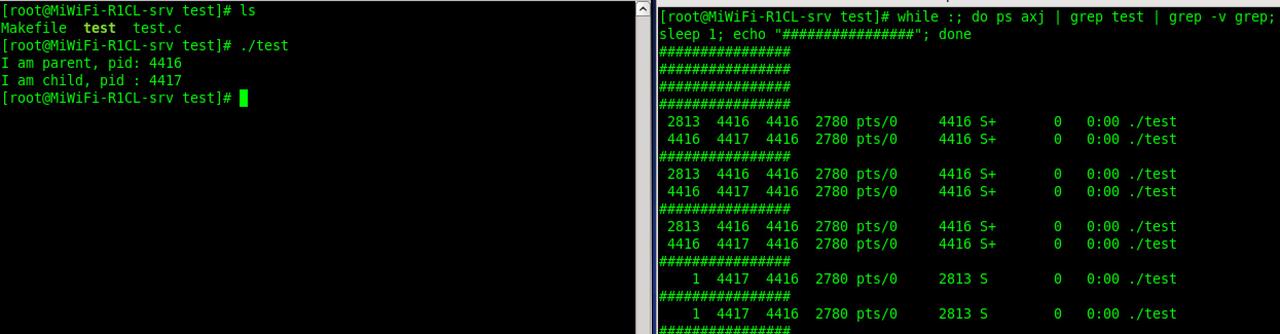
来段代码:
cpp
#include <stdio.h>
#include <unistd.h>
#include <stdlib.h>
int main()
{
pid_t id = fork();
if(id < 0){
perror("fork");
return 1;
}
else if(id == 0){//child
printf("I am child, pid : %d\n", getpid());
sleep(10);
}else{//parent
printf("I am parent, pid: %d\n", getpid());
sleep(3);
exit(0);
}
return 0;
}
3.3进程优先级
3.3.1基本概念
进程优先级可以理解为:操作系统在多个进程都想使用 CPU 时,用来决定"谁先运行、谁多运行一会儿"的重要依据.在多任务系统中,CPU 数量有限,但进程可能很多.调度器需要不断从就绪队列中选择一个进程运行,这个选择过程就会参考进程优先级.cpu资源分配的先后顺序,就是指进程的优先权(priority).优先权⾼的进程有优先执⾏权利.配置进程优先权对多任务环境的linux很有⽤,可以改善系统性能.还可以把进程运⾏到指定的CPU上,这样⼀来,把不重要的进程安排到某个CPU,可以⼤ 改善系统整体性能.
3.3.2查看系统进程
在linux或者unix系统中,⽤ps ‒l命令则会类似输出以下⼏个内容:
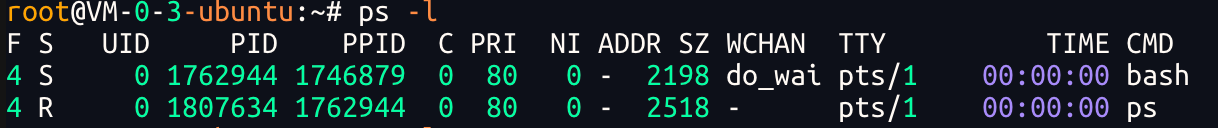
我们很容易注意到其中的⼏个重要信息,有下:
• UID : 代表执⾏者的⾝份
• PID : 代表这个进程的代号
• PPID :代表这个进程是由哪个进程发展衍⽣⽽来的,亦即⽗进程的代号
• PRI :代表这个进程可被执⾏的优先级,其值越⼩越早被执⾏
• NI :代表这个进程的nice值
3.3.3PRI和NI介绍
在 Linux 中,PRI 和 NI 都和进程优先级有关,但含义不一样.
1.PRI 是什么?
PRI 表示 Priority ,也就是进程的实际调度优先级.
它是内核调度器真正参考的优先级数值之一.
在很多工具里,比如 top、ps,可以看到类似:
bash
top输出中有:
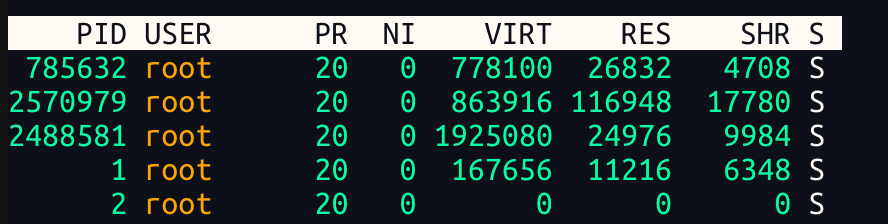
这里的 PR 或 PRI 就表示进程当前优先级.
需要注意:
在 Linux 中,PRI 数值越小,优先级越高.
也就是说:
text
PRI = 10  比 PRI = 20 优先级高
PRI = 20  比 PRI = 30 优先级高
2.NI 是什么?
NI 表示 Nice value,也就是 nice 值.
它是用户可以调整的一个优先级修正值,主要影响普通进程的调度优先级.
NI 的取值范围通常是:
text
-20 ~ 19规则是:
text
NI 越小,优先级越高
NI 越大,优先级越低
例如:
| NI | 含义 |
|---|---|
-20 |
最高普通优先级 |
0 |
默认值 |
19 |
最低普通优先级 |
为什么叫 nice?
因为 nice 值越大,说明这个进程越"友好",更愿意把 CPU 让给其他进程,所以它自己的优先级越低.
3.PRI 和 NI 的关系
对于普通进程来说,可以粗略理解为:
text
PRI = 20 + NI例如:
| NI | PRI/PR | 优先级 |
|---|---|---|
-20 |
0 |
高 |
-5 |
15 |
较高 |
0 |
20 |
默认 |
10 |
30 |
较低 |
19 |
39 |
低 |
所以:
text
NI 越小 → PRI 越小 → 优先级越高
NI 越大 → PRI 越大 → 优先级越低
不过这只是普通进程中的常见理解.内核内部的调度优先级还会受到调度策略、动态调整、实时优先级等因素影响.
3.3.4查看进程优先级的命令
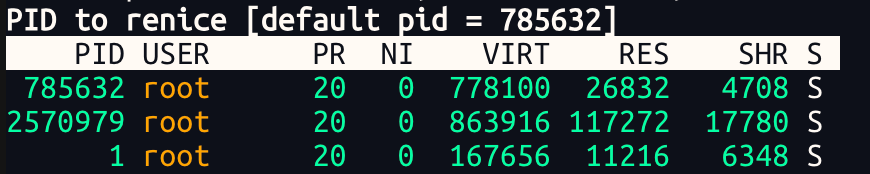
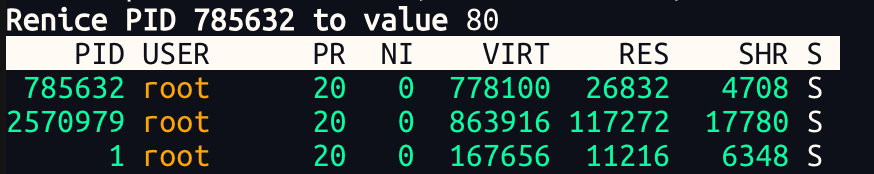
使用 top 查看:进⼊top后按"r"‒>输⼊进程PID‒>输⼊nice值
3.3.5某个进程循环进行时,如何终止?
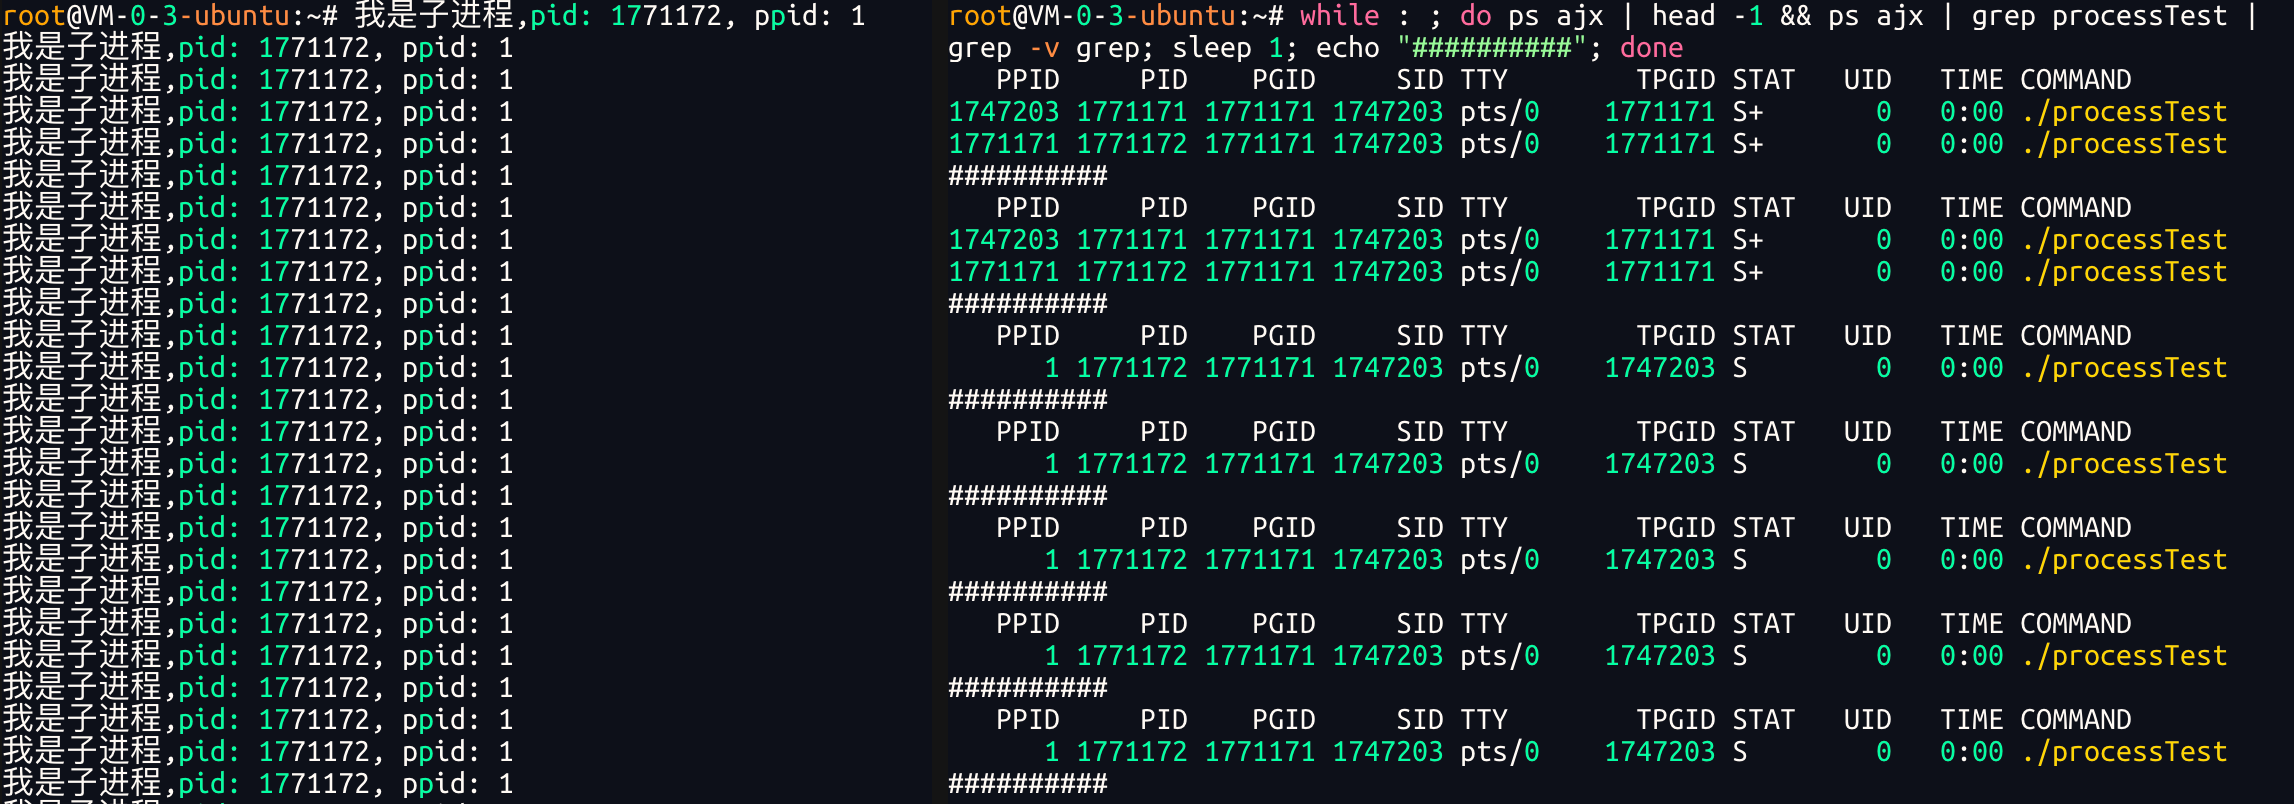
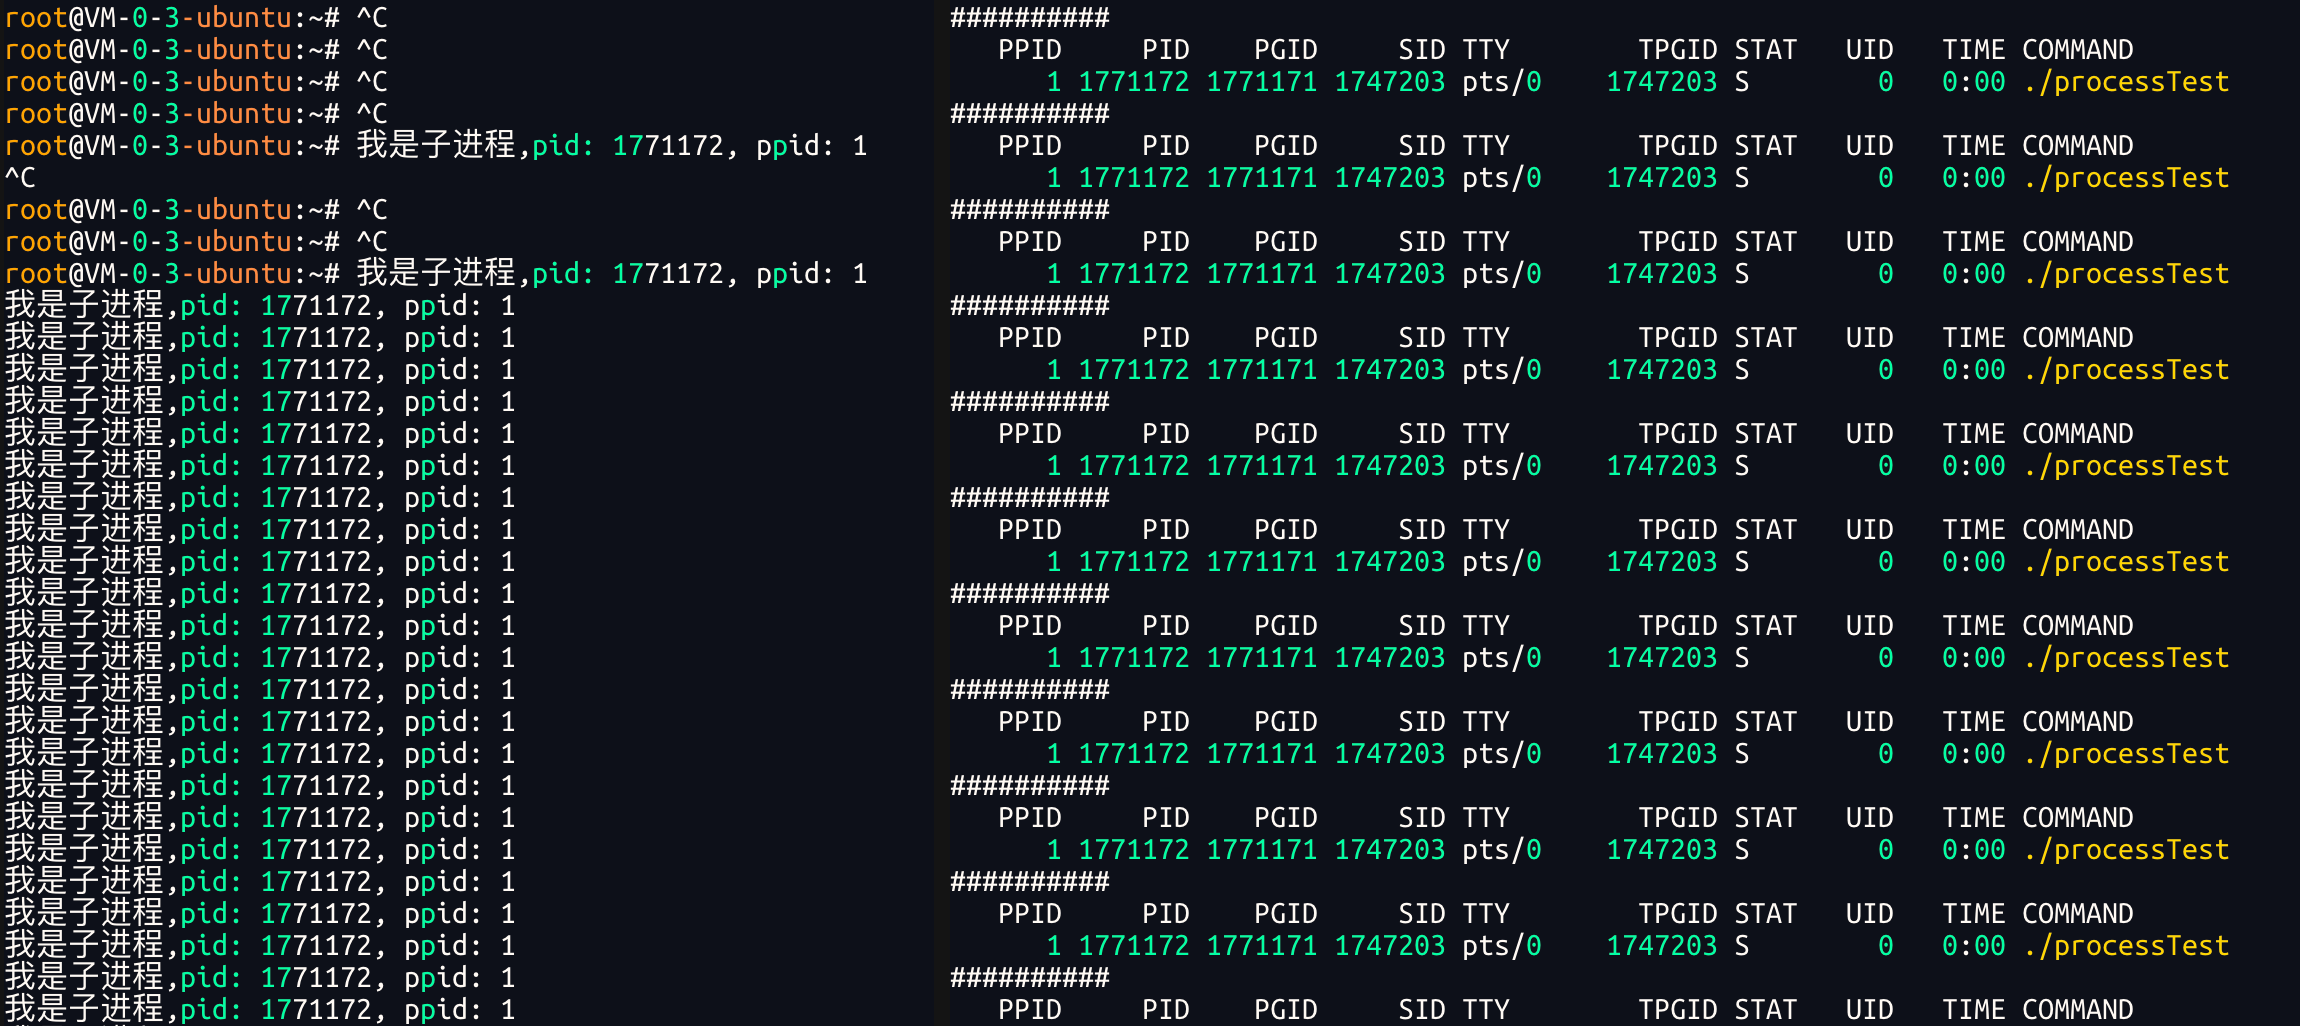
能看到图片里面反复按Ctrl+C,进程并没有结束!依旧在运行!
🛠 分步终止方法
步骤 1:找到进程的 PID
输出里已经显示子进程的 PID 是 1771172,
bash
ps ajx | grep processTest | grep -v grep输出里第二列就是进程的 PID,确保和你看到的 1771172 一致。
步骤 2:用 kill 命令终止进程
方法 1:普通终止(推荐)
给进程发送正常退出信号,让它自己结束:
bash
kill 1771172方法 2:强制终止(如果普通 kill 没反应)
如果进程卡住无法响应普通信号,用 -9 选项强制杀死:
bash
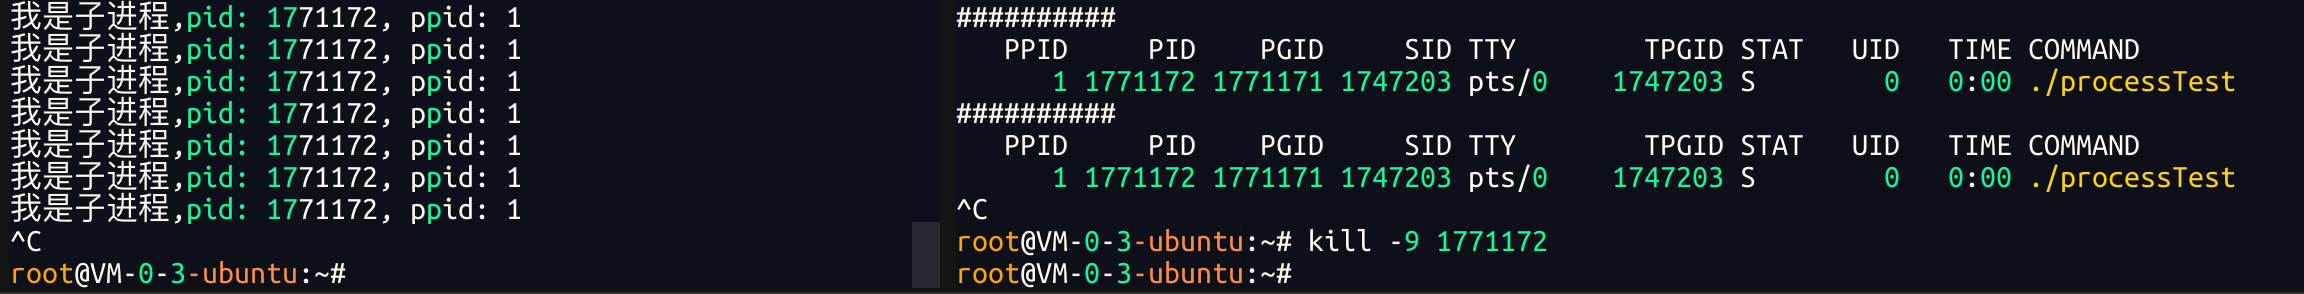
kill -9 1771172-9 对应 SIGKILL 信号,进程无法忽略或处理这个信号,会被系统直接回收.
步骤 3:验证进程是否被杀死
执行下面的命令,如果没有输出,说明进程已经被终止了:
bash
ps ajx | grep processTest | grep -v grep💡 一键终止所有同名进程
如果不想手动找 PID,可以直接按进程名批量终止所有 processTest 进程:
bash
# 方法1:pkill(按进程名终止)
pkill processTest

# 方法2:killall(按进程名终止,需要确保系统安装了killall)
killall processTest
📌 为什么 Ctrl+C 没用?
Ctrl+C只会给当前终端前台进程组 发送SIGINT信号,只能终止前台运行的进程.- 你的父进程退出后,子进程变成了孤儿进程,被系统进程收养,脱离了当前终端的进程组,所以
Ctrl+C对它无效,必须用kill命令.
3.3.6补充概念-->竞争、独⽴、并⾏、并发
• 竞争性: 系统进程数⽬众多,⽽CPU资源只有少量,甚⾄1个,所以进程之间是具有竞争属性的.为了⾼效完成任务,更合理竞争相关资源,便具有了优先级.
• 独⽴性: 多进程运⾏,需要独享各种资源,多进程运⾏期间互不⼲扰.
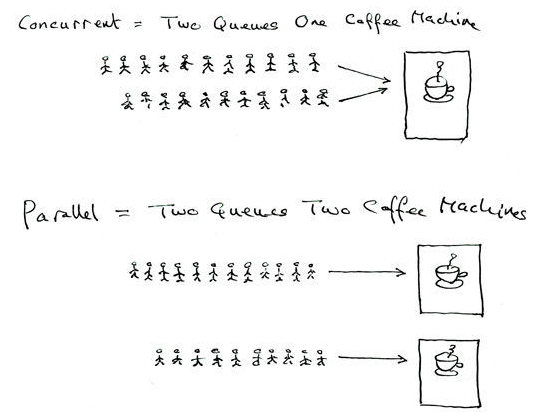
• 并⾏: 多个进程在多个CPU下分别,同时进⾏运⾏,这称之为并⾏.
• 并发: 多个进程在⼀个CPU下采⽤进程切换的⽅式,在⼀段时间之内,让多个进程都得以推进,称之为并发.
3.4进程切换
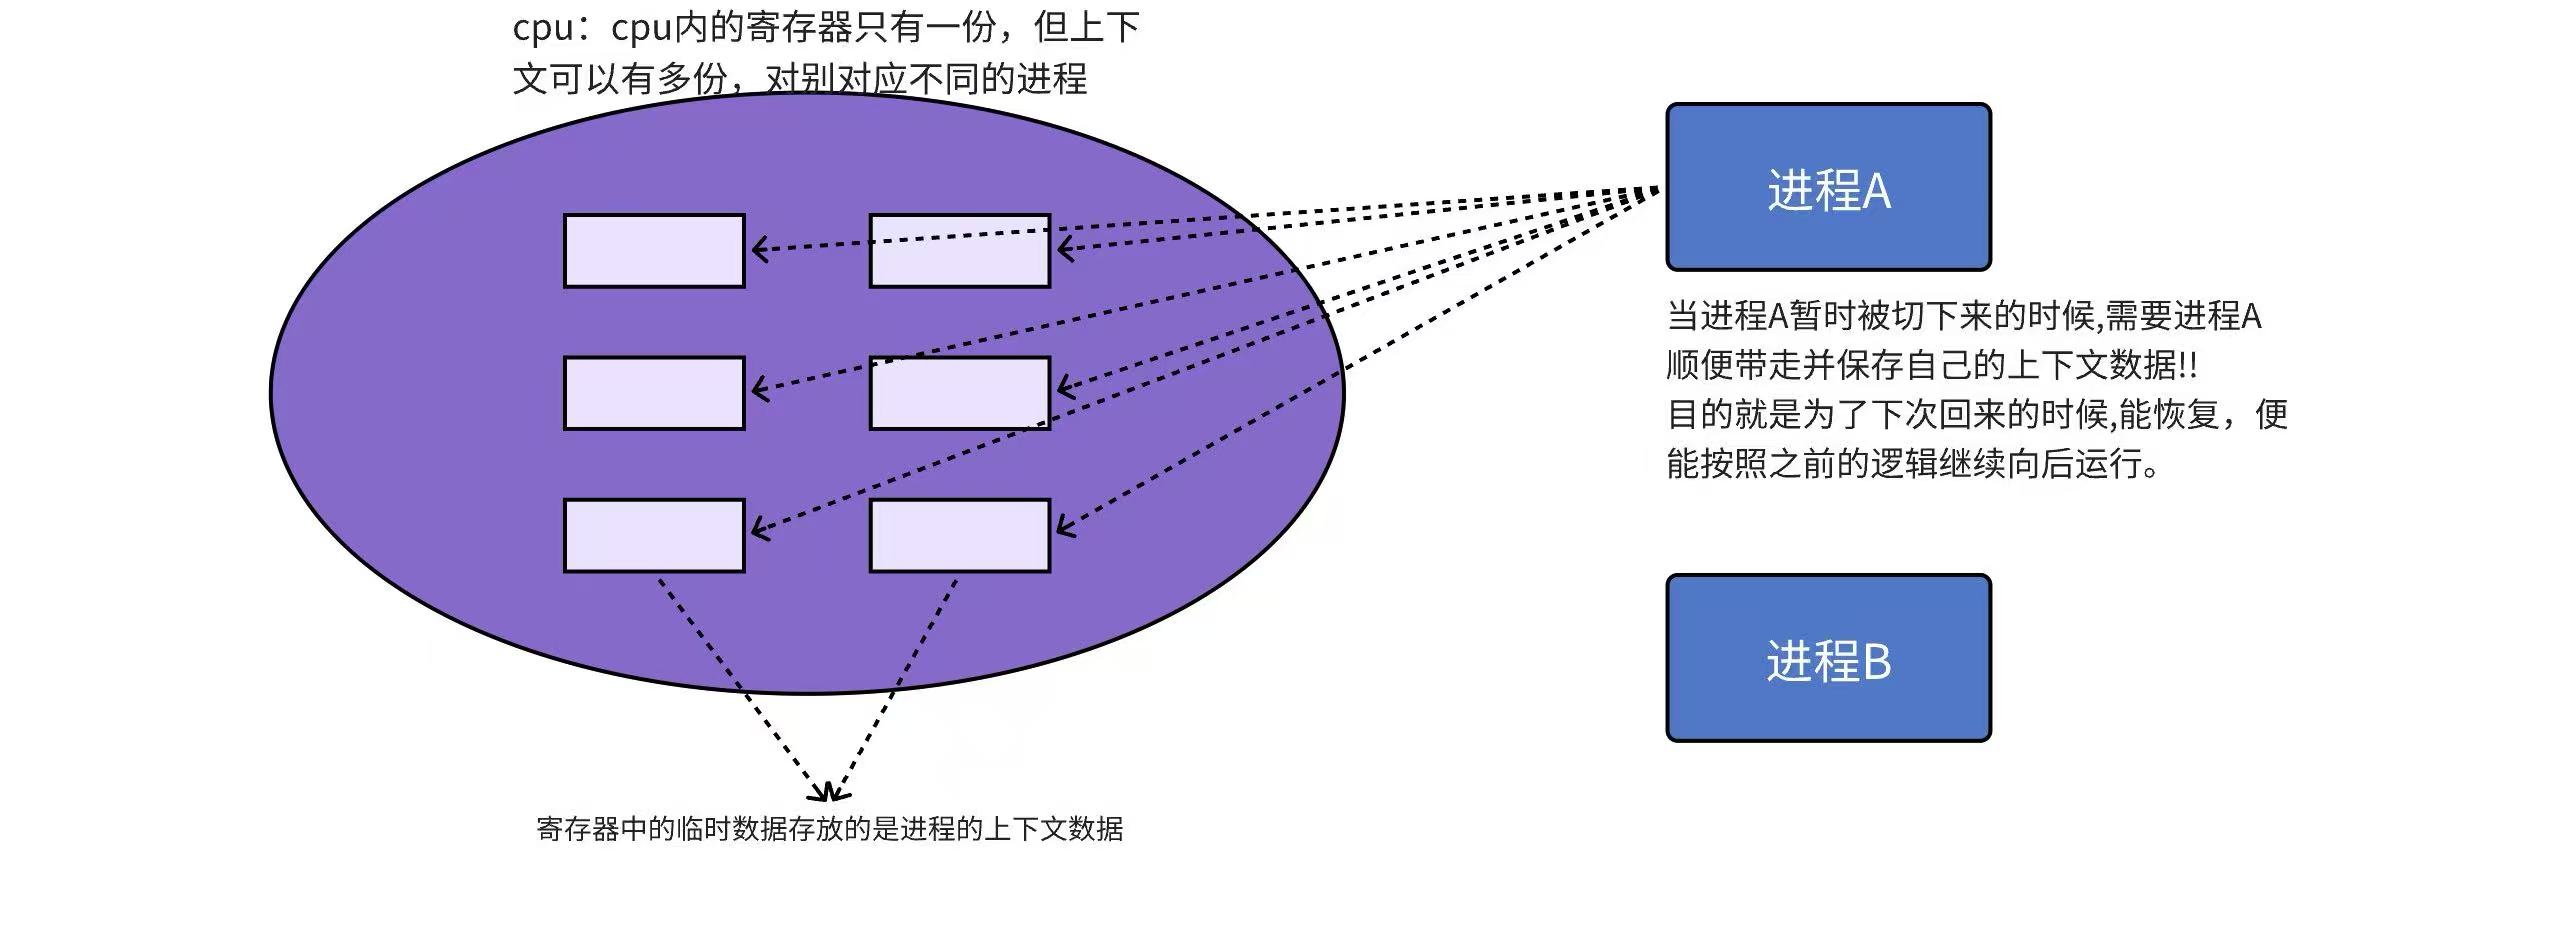
CPU上下⽂切换:其实际含义是任务切换,或者CPU寄存器切换.当多任务内核决定运⾏另外的任务时,它保存正在运⾏任务的当前状态,也就是CPU寄存器中的全部内容.这些内容被保存在任务⾃⼰的堆栈中,⼊栈⼯作完成后就把下⼀个将要运⾏的任务的当前状况从该任务的栈中重新装⼊CPU寄存器,并开始下⼀个任务的运⾏,这⼀过程就是context switch.
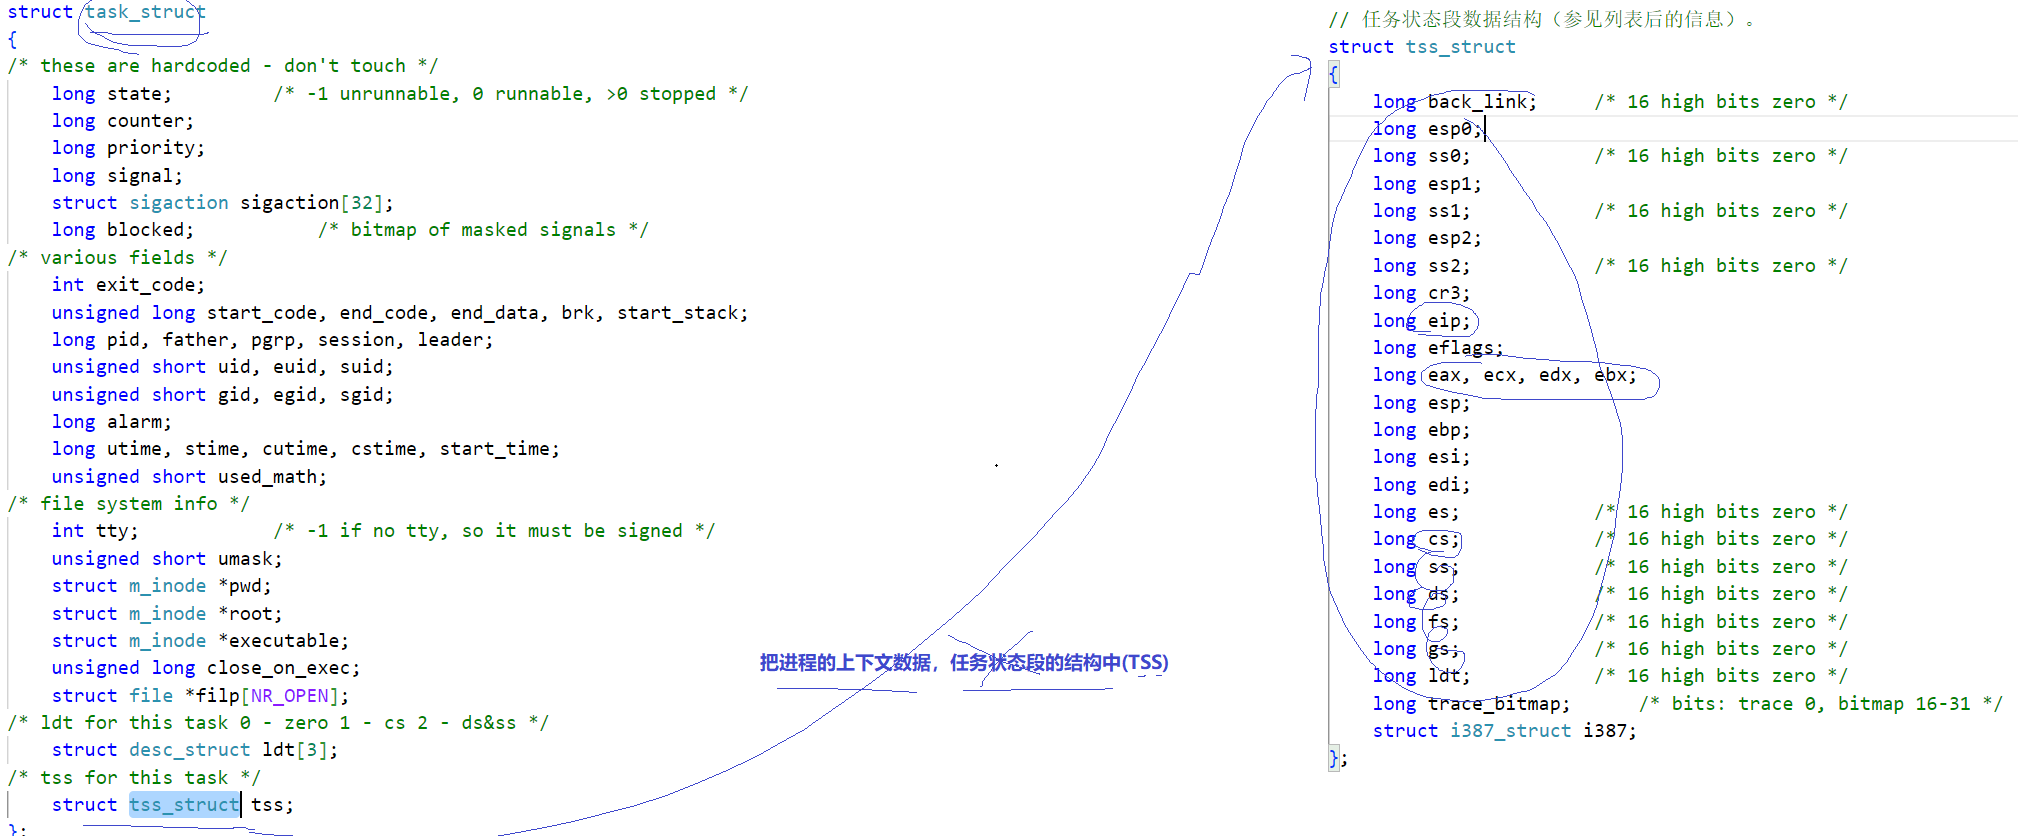
参考⼀下Linux内核0.11代码
📌注意:时间⽚:当代计算机都是分时操作系统,没有进程都有它合适的时间⽚(其实就是⼀个计数器).时间⽚到达,进程就被操作系统从CPU中剥离下来.
3.5Linux2.6内核进程O(1)调度队列
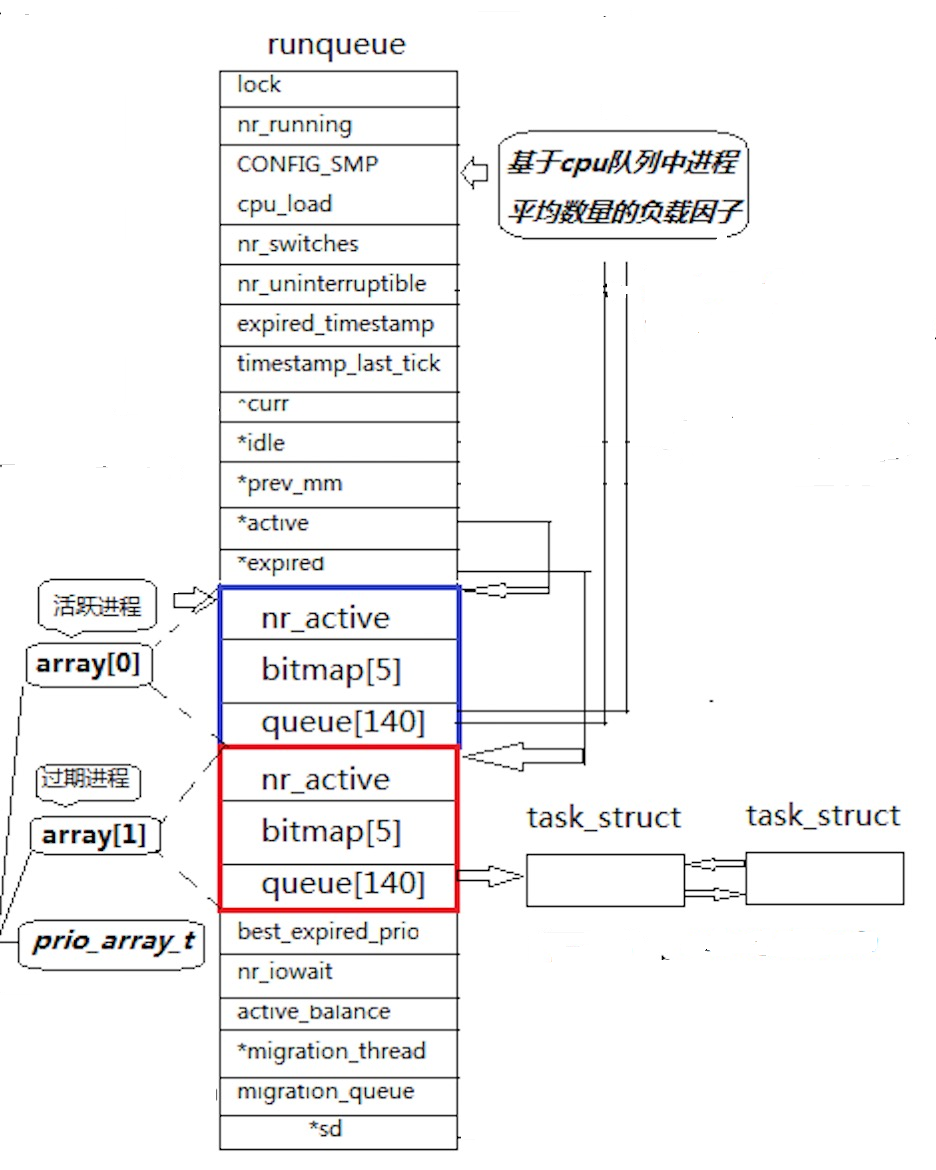
上图是Linux2.6内核中进程队列的数据结构,之间关系也已经给⼤家画出来,⽅便⼤家理解.
这张图讲的是 早期 Linux O(1) 调度器中的 runqueue 运行队列结构 ,核心目的是说明:CPU 如何管理可运行进程,以及调度器如何快速找到下一个要运行的进程.
runqueue是什么?
图顶部写着:
c
runqueue它表示 运行队列.
在 Linux 内核中,runqueue 是调度器维护的核心数据结构,用来保存某个 CPU 上所有处于可运行状态的进程.
也就是说:
text
TASK_RUNNING 状态的进程
        ↓
进入 runqueue
        ↓
等待 CPU 调度执行
如果是多核系统,通常是:
text
CPU0 有自己的 runqueue
CPU1 有自己的 runqueue
CPU2 有自己的 runqueue
...
这样每个 CPU 可以独立调度自己的进程.
runqueue 里的重要字段
图中 runqueue 结构里有很多字段,主要可以这样理解:
| 字段 | 含义 |
|---|---|
lock |
保护运行队列的自旋锁,防止并发修改 |
nr_running |
当前运行队列中可运行进程数量 |
cpu_load |
CPU 负载因子,和该 CPU 队列中的进程数量/负载有关 |
nr_switches |
进程上下文切换次数 |
nr_uninterruptible |
不可中断睡眠进程数量 |
curr |
当前正在 CPU 上运行的进程 |
idle |
当前 CPU 的 idle 空闲进程 |
prev_mm |
上一个进程的内存描述符,用于上下文切换优化 |
active |
指向活跃优先级数组 |
expired |
指向过期优先级数组 |
best_expired_prio |
过期数组中最优先的优先级 |
nr_iowait |
等待 I/O 的进程数量 |
migration_thread |
进程迁移线程 |
migration_queue |
迁移队列 |
sd |
调度域,用于多 CPU 负载均衡 |
其中最关键的是:
c
*active
*expired
它们指向两个优先级数组.
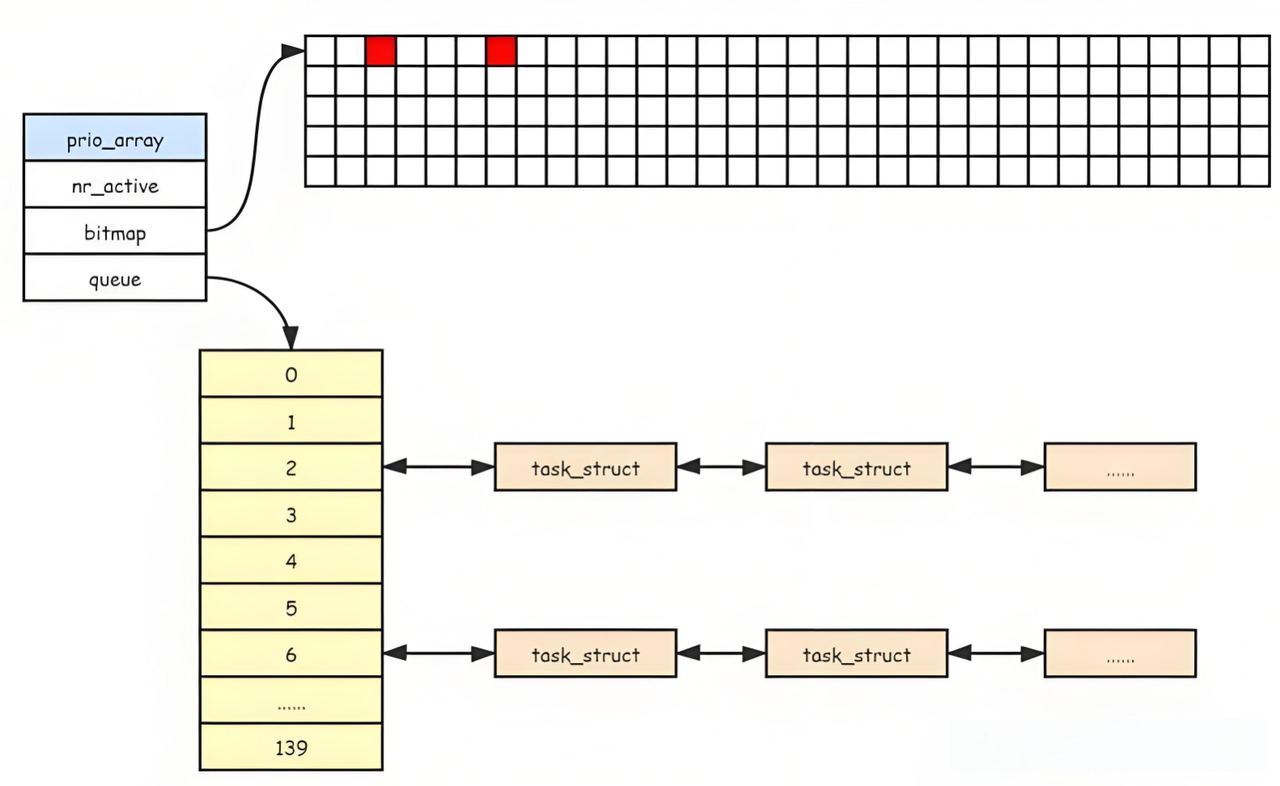
3.5.1活动队列
时间⽚还没有结束的所有进程都按照优先级放在该队列
• nr_active: 总共有多少个运⾏状态的进程
• queue140: ⼀个元素就是⼀个进程队列,相同优先级的进程按照FIFO规则进⾏排队调度,所以,数组下标就是优先级!
• 从该结构中,选择⼀个最合适的进程,过程是怎么的呢?
- 从0下表开始遍历queue140
- 找到第⼀个⾮空队列,该队列必定为优先级最⾼的队列
- 拿到选中队列的第⼀个进程,开始运⾏,调度完成!
- 遍历queue140时间复杂度是常数!但还是太低效了!
• bitmap5:⼀共140个优先级,⼀共140个进程队列,为了提⾼查找⾮空队列的效率,就可以⽤5*32个⽐特位表⽰队列是否为空,这样,便可以⼤ 提⾼查找效率!
3.5.2过期队列
• 过期队列和活动队列结构⼀模⼀样
• 过期队列上放置的进程,都是时间⽚耗尽的进程
• 当活动队列上的进程都被处理完毕之后,对过期队列的进程进⾏时间⽚重新计算
3.5.3active和expired是什么?
图中有两个彩色框:
蓝色框:
c
nr_active
bitmap[5]
queue[140]
红色框:
c
nr_active
bitmap[5]
queue[140]
左边标注:
text
活跃进程 array[0]
过期进程 array[1]
prio_array_t
这说明 runqueue 中有两个 prio_array_t 优先级数组:
c
array[0]
array[1]
其中一个作为:
c
active另一个作为:
c
expiredactive 数组
active 里面放的是 当前还有时间片、可以被调度运行的进程.
调度器每次选进程时,优先从 active 数组中选择最高优先级的进程.
expired 数组
expired 里面放的是 时间片已经用完的进程.
进程时间片耗尽后,不会立刻继续在 active 中竞争 CPU,而是被放到 expired 中,等待下一轮.
active / expired 的切换
O(1) 调度器很经典的设计是:
text
active 数组中的进程逐渐运行
        ↓
时间片用完后进入 expired 数组
        ↓
active 数组空了
        ↓
active 和 expired 指针交换
        ↓
expired 变成新的 active
也就是说,不需要把所有进程一个个搬来搬去,只要交换两个指针:
c
active <-> expired这样调度效率很高.
这也是它被称为 O(1) 调度器 的原因之一:调度器选择下一个进程的时间复杂度基本不随进程数量增长.
3.5.4总结
在系统当中查找⼀个最合适调度的进程的时间复杂度是⼀个常数,不随着进程增多⽽导致时间成本增加,我们称之为进程调度O(1)算法!
cpp
struct rq {
spinlock_t lock;
/*
* nr_running and cpu_load should be in the same cacheline because
* remote CPUs use both these fields when doing load calculation.
*/
unsigned long nr_running;
unsigned long raw_weighted_load;
#ifdef CONFIG_SMP
unsigned long cpu_load[3];
#endif
unsigned long long nr_switches;
/*
* This is part of a global counter where only the total sum
* over all CPUs matters. A task can increase this counter on
* one CPU and if it got migrated afterwards it may decrease
* it on another CPU. Always updated under the runqueue lock:
*/
unsigned long nr_uninterruptible;
unsigned long expired_timestamp;
unsigned long long timestamp_last_tick;
struct task_struct *curr, *idle;
struct mm_struct *prev_mm;
struct prio_array *active, *expired, arrays[2];
int best_expired_prio;
atomic_t nr_iowait;
#ifdef CONFIG_SMP
struct sched_domain *sd;
/* For active balancing */
int active_balance;
int push_cpu;
struct task_struct *migration_thread;
struct list_head migration_queue;
#endif
#ifdef CONFIG_SCHEDSTATS
/* latency stats */
struct sched_info rq_sched_info;
/* sys_sched_yield() stats */
unsigned long yld_exp_empty;
unsigned long yld_act_empty;
unsigned long yld_both_empty;
unsigned long yld_cnt;
/* schedule() stats */
unsigned long sched_switch;
unsigned long sched_cnt;
unsigned long sched_goidle;
/* try_to_wake_up() stats */
unsigned long ttwu_cnt;
unsigned long ttwu_local;
#endif
struct lock_class_key rq_lock_key;
};
/*
* These are the runqueue data structures:
*/
struct prio_array {
unsigned int nr_active;
DECLARE_BITMAP(bitmap, MAX_PRIO+1); /* include 1 bit for delimiter */
struct list_head queue[MAX_PRIO];
};
4.命令⾏参数和环境变量
4.1基本概念
命令行参数是在启动程序时,跟在命令后面的额外信息.环境变量是操作系统或 shell 中保存的一些"全局配置值",程序运行时可以读取它们.环境变量⼀般是指在操作系统中⽤来指定操作系统运⾏环境的⼀些参数.如:我们在编写C/C++代码的时候,在链接的时候,从来不知道我们的所链接的动态静态库在哪⾥,但是照样可以链接成功,⽣成可执⾏程序,原因就是有相关环境变量帮助编译器进⾏查找.环境变量通常具有某些特殊⽤途,还有在系统当中通常具有全局特性.
总结一句话:
命令行参数是"运行这个程序时给它的参数",环境变量是"程序运行时所在环境里的配置".
4.2查看命令行参数
在 Shell 脚本中,可以用特殊变量读取参数:
bash
#!/bin/bash

echo "脚本名:$0"
echo "第一个参数:$1"
echo "第二个参数:$2"
echo "所有参数:$@"
echo "参数个数:$#"
保存为 test.sh,然后运行:
bash
chmod +x test.sh
./test.sh hello world
输出类似:
text
脚本名:./test.sh
第一个参数:hello
第二个参数:world
所有参数:hello world
参数个数:2
常见特殊变量:
| 变量 | 含义 |
|---|---|
$0 |
脚本名 |
$1 |
第 1 个参数 |
$2 |
第 2 个参数 |
$@ |
所有参数 |
$# |
参数个数 |
$? |
上一个命令的退出状态 |
4.3查看环境变量
环境变量是 Linux 系统或 Shell 中保存的配置值.
查看环境变量:
bash
env或:
bash
printenv查看某个变量:
bash
echo $PATH
echo $HOME
echo $USER
常见环境变量:
| 环境变量 | 含义 |
|---|---|
PATH |
命令搜索路径 |
HOME |
当前用户的家目录 |
USER |
当前用户名 |
SHELL |
当前使用的 Shell |
PWD |
当前所在目录 |
LANG |
语言和字符编码设置 |
4.4设置环境变量
只在当前 Shell 中设置普通变量:
bash
PORT=8080如果要让子进程也能读取,需要使用 export:
bash
export PORT=8080然后运行程序:
bash
python3 app.py程序就可以读取 PORT 这个环境变量.
也可以临时只对某个命令生效:
bash
PORT=8080 python3 app.py这个 PORT 只对这一次 python3 app.py 生效,不会长期保存.
4.5与环境变量有关的问题
创建mycommand.c⽂件
cpp
#include <stdio.h>
int main()
{
printf("我是一个命令,自己实现的!\n");
return 0;
}
对⽐./mycommand执⾏和mycommand执⾏
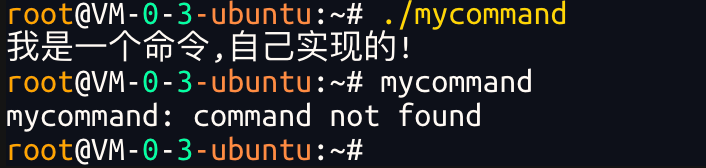
为什么输入./mycommand可以直接执⾏,展示我们编写的代码信息,而直接输入mycommand会告诉我们文件找不到信息?其实这跟当前文件所处的环境变量有关!
我们查看一下当前环境变量的路径

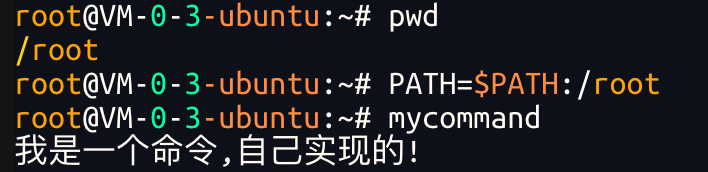
当我们把/root路径也拷贝到$PATH路径下,我们再次运行mycommand时,就会发现可以直接运行了!Linux 会根据环境变量 PATH 中记录的路径,依次去查找这个命令对应的程序.如果找不到,就会报错:上面就是使用了程序的完整路径,Linux 会直接去这个位置找程序.PATH 的作用是:
告诉用户输入一个命令时,应该去哪些目录里查找对应的可执行程序.Linux 会按照 PATH 中的目录顺序查找,找到后,就执行它.
4.6环境变量的组织⽅式
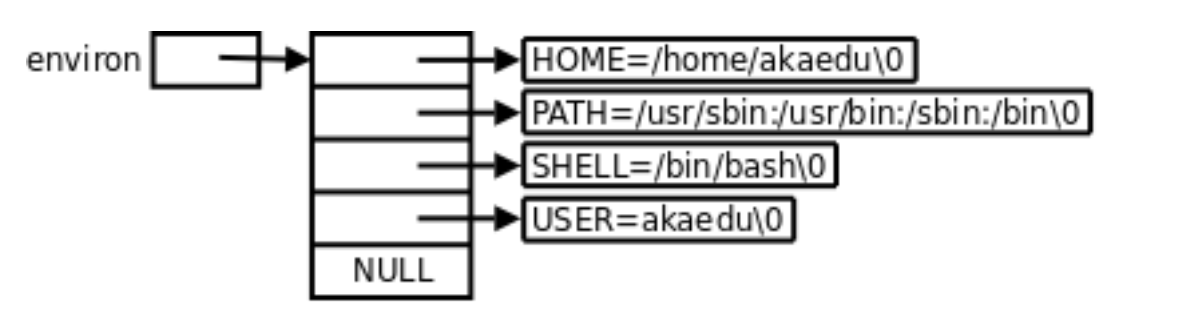
每个程序都会收到⼀张环境表,环境表是⼀个字符指针数组,每个指针指向⼀个以'\0'结尾的环境
字符串.
4.7通过代码如何获取环境变量
cpp
//命令⾏第三个参数
#include <stdio.h>
int main(int argc, char *argv[], char *env[])
{
int i = 0;
for(; env[i]; i++){
printf("%s\n", env[i]);
}
return 0;
}

//通过第三⽅变量environ获取
#include <stdio.h>
int main(int argc, char *argv[])
{
extern char **environ;
int i = 0;
for(; environ[i]; i++){
printf("%s\n", environ[i]);
}
return 0;
}//libc中定义的全局变量environ指向环境变量表,environ没有包含在任何头⽂件中,所以在使⽤时 要⽤extern声明。

//通过系统调⽤获取或设置环境变量
//putenv getenv
#include <stdio.h>
#include <stdlib.h>
int main()
{
printf("%s\n", putenv("PATH"));
printf("%s\n", getenv("PATH"));
return 0;
}//常⽤getenv和putenv函数来访问特定的环境变量。
4.8环境变量通常是具有全局属性的
cpp
//环境变量通常具有全局属性,可以被⼦进程继承下去
#include <stdio.h>
#include <stdlib.h>
int main()
{
char *env = getenv("MYENV");
if(env){
printf("%s\n", env);
}
return 0;
}
环境变量属于进程环境.每个进程都有自己的一份环境变量.
当 Bash 启动一个子进程时,会把自己的环境变量传递给子进程.
所以:
bash
bash 进程
  └── 子进程
子进程可以继承父进程的环境变量.但是,子进程修改环境变量,不会反向影响父进程.
5.程序地址空间
5.1回顾程序地址空间
我们在学习C语⾔的时候,⼤家应该见过这样的空间布局图
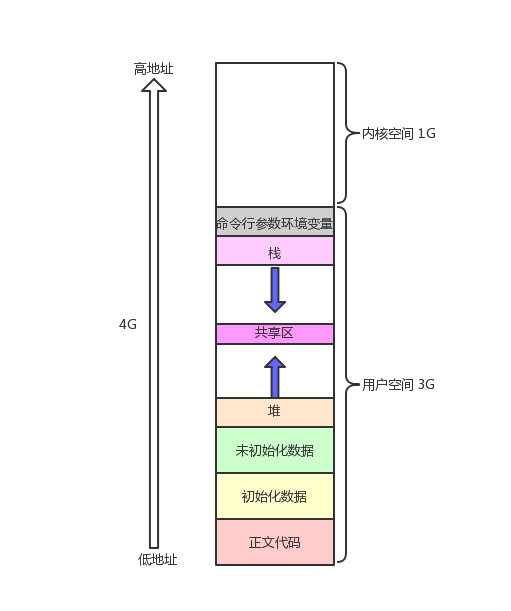
这图是在解释 32 位 Linux 进程的虚拟地址空间布局。
它表示:每个进程在运行时,都会认为自己独占一整块连续的地址空间.对于 32 位系统来说,地址范围通常是:
text
0x00000000 到 0xFFFFFFFF也就是总共 4GB 虚拟地址空间.
1.用户空间和内核空间
右侧标注了:
- 用户空间:3G
- 内核空间:1G
在典型 32 位 Linux 中,一个进程的 4GB 虚拟地址空间通常被分成:
text
高地址
┌──────────────┐
│ 内核空间 1G  │  0xC0000000 ~ 0xFFFFFFFF
├──────────────┤
│ 用户空间 3G  │  0x00000000 ~ 0xBFFFFFFF
└──────────────┘
低地址
用户程序平时只能访问 用户空间 .
内核空间属于操作系统内核,普通程序不能直接访问,否则会出现非法访问,例如段错误.
2.从低地址到高地址的区域
图中最下面是 低地址 ,最上面是 高地址.
正文代码区
最底部的"正文代码"就是程序的机器指令区域,比如你的 main() 函数、普通函数等编译后的代码.
通常它是只读的,防止程序运行时随便修改自己的代码.
初始化数据区
这里存放已经初始化的全局变量和静态变量,例如:
c
int g_val = 10;
static int s_val = 20;
这些变量在程序开始运行前就有明确初值.
未初始化数据区
也叫 BSS 段,存放未显式初始化或初始化为 0 的全局变量、静态变量,例如:
c
int g_val;
static int s_val;
它们默认会被初始化为 0.
堆
堆区用于动态内存申请,例如:
c
int *p = malloc(sizeof(int));堆通常 向高地址方向增长,所以图里堆旁边有一个向上的箭头.
也就是说,随着 malloc() 申请越来越多内存,堆可能往上扩展.
共享区
共享区主要用于:
- 动态库,比如
libc.so mmap()映射的文件- 进程间共享内存
- 动态链接相关内容
它位于堆和栈之间.
栈
栈区用于函数调用、局部变量、函数参数、返回地址等,例如:
c
void test() {
    int a = 10;
}
变量 a 通常就在栈上.
栈通常 向低地址方向增长,所以图里栈旁边有一个向下箭头.
命令行参数和环境变量
靠近用户空间高地址的位置存放:
- 命令行参数,比如
argv - 环境变量,比如
PATH - 启动程序时传递给进程的信息
- 为什么堆向上,栈向下?
图中最重要的一点是:
text
堆向高地址增长
栈向低地址增长
这样设计可以让二者共享中间的空闲区域.
如果程序大量 malloc(),堆可以向上扩展.
如果函数调用层级很深,局部变量很多,栈可以向下扩展.
但如果堆和栈不断增长,最终可能会碰撞,导致内存不足或程序崩溃.
我们对它并不理解!可以先对其进⾏各区域分布验证:
cpp
#include <stdio.h>
#include <unistd.h>
#include <stdlib.h>
int g_unval;
int g_val = 100;
int main(int argc, char *argv[], char *env[])
{
const char *str = "helloworld";
printf("code addr: %p\n", main);
printf("init global addr: %p\n", &g_val);
printf("uninit global addr: %p\n", &g_unval);
static int test = 10;
char *heap_mem = (char*)malloc(10);
char *heap_mem1 = (char*)malloc(10);
char *heap_mem2 = (char*)malloc(10);
char *heap_mem3 = (char*)malloc(10);
printf("heap addr: %p\n", heap_mem); //heap_mem(0), &heap_mem(1)
printf("heap addr: %p\n", heap_mem1); //heap_mem(0), &heap_mem(1)
printf("heap addr: %p\n", heap_mem2); //heap_mem(0), &heap_mem(1)
printf("heap addr: %p\n", heap_mem3); //heap_mem(0), &heap_mem(1)
printf("test static addr: %p\n", &test); //heap_mem(0), &heap_mem(1)
printf("stack addr: %p\n", &heap_mem); //heap_mem(0), &heap_mem(1)
printf("stack addr: %p\n", &heap_mem1); //heap_mem(0), &heap_mem(1)
printf("stack addr: %p\n", &heap_mem2); //heap_mem(0), &heap_mem(1)
printf("stack addr: %p\n", &heap_mem3); //heap_mem(0), &heap_mem(1)
printf("read only string addr: %p\n", str);
for(int i = 0 ;i < argc; i++)
{
printf("argv[%d]: %p\n", i, argv[i]);
}
for(int i = 0; env[i]; i++)
{
printf("env[%d]: %p\n", i, env[i]);
}
return 0;
}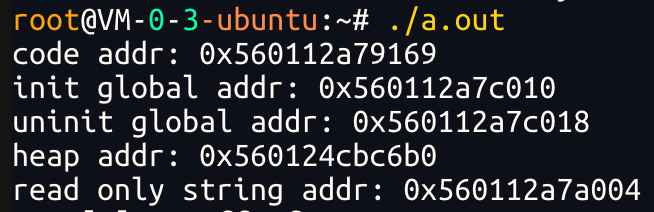
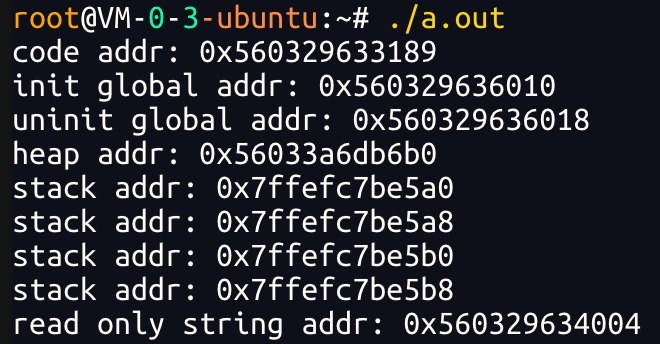
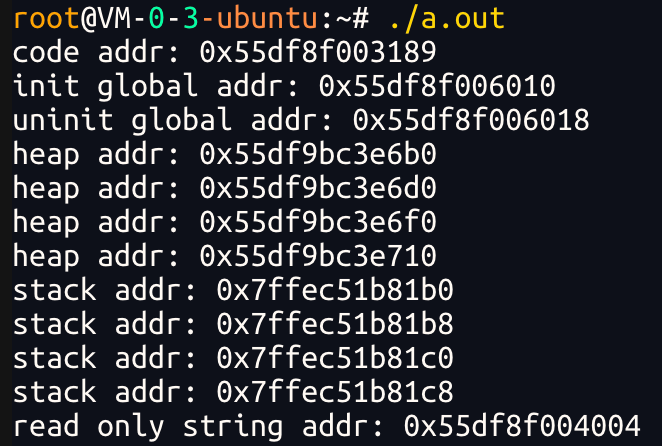
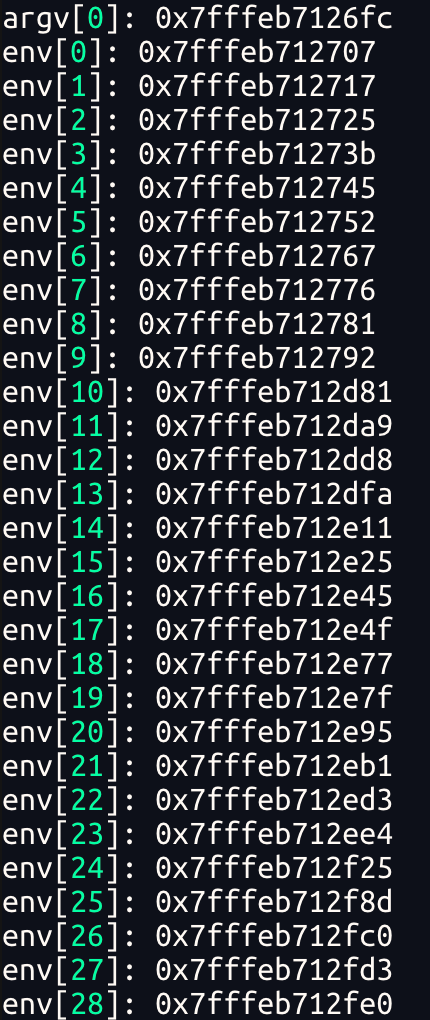
我们可以观察到各个空间的内存地址分布!
5.2虚拟地址
感受⼀下下面这段代码
cpp
#include <stdio.h>
#include <unistd.h>

int g_val = 100;

int main()
{
    printf("g_val: %d, &g_val: %p\n", g_val, &g_val);

    pid_t id = fork();

    if(id == 0)
    {
        while(1)
        {
            printf("我是子进程, pid: %d, ppid: %d, g_val: %d, &g_val: %p\n",
                   getpid(), getppid(), g_val, &g_val);
            sleep(1);
        }
    }
    else
    {
        while(1)
        {
            printf("我是父进程, pid: %d, ppid: %d, g_val: %d, &g_val: %p\n",
                   getpid(), getppid(), g_val, &g_val);
            sleep(1);
        }
    }
}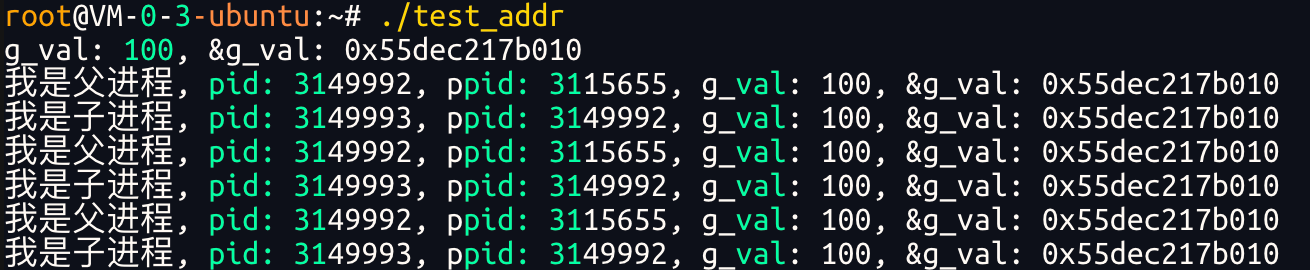
我们发现,输出出来的变量值和地址是⼀模⼀样的,很好理解呀,因为⼦进程按照⽗进程为模版,⽗⼦并没有对变量进⾏进⾏任何修改.可是将代码稍加改动:
cpp
#include <stdio.h>
#include <unistd.h>

int g_val = 100;

int main()
{
    printf("g_val: %d, &g_val: %p\n", g_val, &g_val);

    pid_t id = fork();

    if(id == 0)
    {
        while(1)
        {
            printf("我是子进程, pid: %d, ppid: %d, g_val: %d, &g_val: %p\n",
                   getpid(), getppid(), g_val, &g_val);
            sleep(1);
            g_val++;
        }
    }
    else
    {
        while(1)
        {
            printf("我是父进程, pid: %d, ppid: %d, g_val: %d, &g_val: %p\n",
                   getpid(), getppid(), g_val, &g_val);
            sleep(1);
        }
    }
}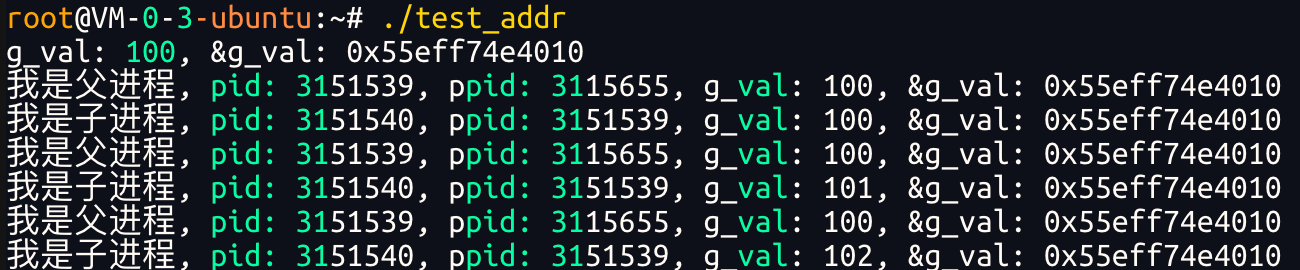
我们发现,⽗⼦进程,输出地址是⼀致的,但是变量内容不⼀样!能得出如下结论:
• 变量内容不⼀样,所以⽗⼦进程输出的变量绝对不是同⼀个变量
• 但地址值是⼀样的,说明:该地址绝对不是物理地址!
• 在Linux地址下,这种地址叫做虚拟地址
• 我们在⽤C/C++语⾔所看到的地址,全部都是虚拟地址!物理地址,⽤⼾⼀概看不到,由OS统⼀管理,操作系统必须负责将虚拟地址转化成物理地址.
5.3进程地址空间
所以之前标题说"程序的地址空间"是不准确的,准确的应该说成进程地址空间,那该如何理解呢?看图:理解分⻚&虚拟地址空间
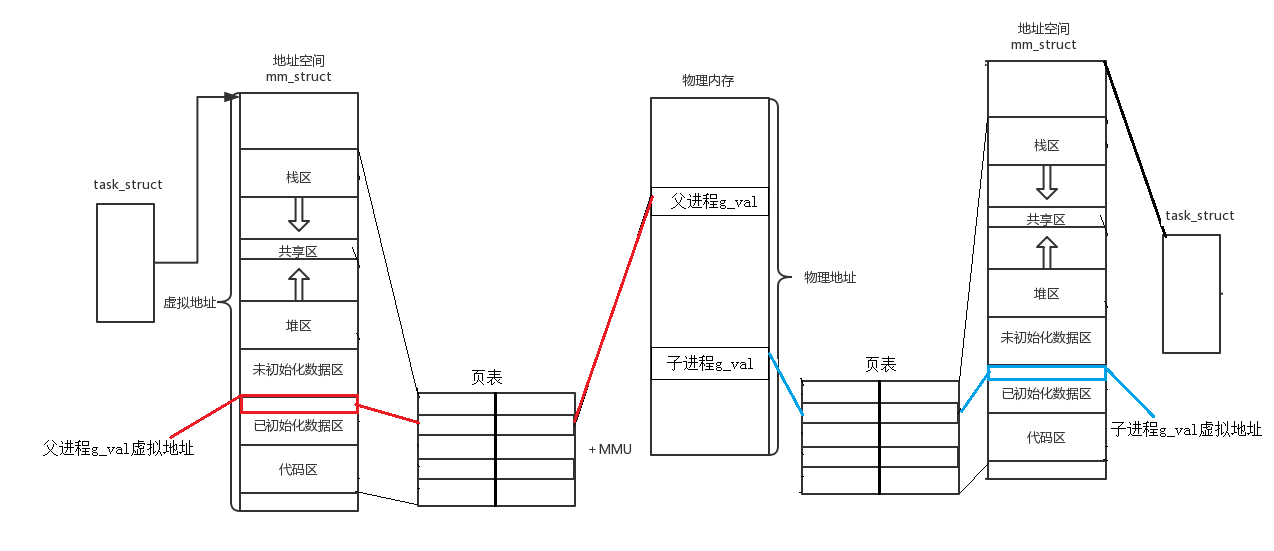
这图是在解释:父子进程虽然看到的变量虚拟地址一样,但通过各自的页表可以映射到不同的物理内存,从而实现进程独立性.
c
int g_val = 100;

pid_t id = fork();

if (id == 0) {
    // 子进程
    g_val++;
} else {
    // 父进程
}
重点是解释 fork() 之后,父子进程中的 g_val 为什么地址看起来一样,但值可以不一样.
1.父进程的虚拟地址空间
父进程的地址空间
里面分了很多区域:
text
栈区
共享区
堆区
未初始化数据区
已初始化数据区
代码区
其中 g_val 是这样定义的:
c
int g_val = 100;它是一个 已经初始化的全局变量,所以它位于:
text
已初始化数据区图中红框标出来的区域,就是父进程地址空间里的 g_val 所在位置.
注意这里标的是:
text
父进程 g_val 虚拟地址也就是说,父进程看到的 &g_val 是一个虚拟地址,不是物理地址.
2.task_struct和 mm_struct
左侧旁边画了一个 task_struct.
在 Linux 中,每个进程在内核里都有一个 task_struct,它可以理解成进程的"身份证"或者"管理结构体".
它里面记录了很多进程信息,例如:
- PID
- 进程状态
- 调度信息
- 打开的文件
- 信号信息
- 内存信息指针
其中和内存相关的重要字段会指向 mm_struct.
图中写了:
text
地址空间 mm_structmm_struct 描述的是这个进程的整个虚拟地址空间,例如:
- 代码区在哪里
- 数据区在哪里
- 堆在哪里
- 栈在哪里
- 页表在哪里
所以关系大概是:
text
task_struct
    ↓
mm_struct
    ↓
进程虚拟地址空间
3.页表 + MMU 完成地址转换
父进程访问 g_val 时,CPU 拿到的是:
text
父进程 g_val 的虚拟地址但是内存条里面真正存放数据的位置是 物理地址.
所以需要经过:
text
虚拟地址 -> 页表 -> MMU -> 物理地址图中父进程的虚拟地址通过左边的页表,最终映射到中间物理内存里的:
text
父进程 g_val也就是说:
text
父进程的 &g_val
    ↓
父进程页表
    ↓
物理内存中父进程 g_val 所在位置
图中的红线表示这个映射过程.
4.子进程的虚拟地址空间
右边画的是 子进程的地址空间.
它看起来和父进程几乎一样,也有:
text
栈区
共享区
堆区
未初始化数据区
已初始化数据区
代码区
子进程也是从 fork() 出来的,所以它继承了父进程的地址空间布局.
因此,子进程中的 g_val 也在:
text
已初始化数据区图中蓝框标出来的就是:
text
子进程 g_val 虚拟地址重点:子进程打印出来的 &g_val 很可能和父进程打印出来的一样.
例如父进程可能打印:
text
&g_val: 0x601054子进程也可能打印:
text
&g_val: 0x601054这不是说它们真的在访问同一块物理内存,而是说明:
父子进程的虚拟地址布局相同,所以虚拟地址一样.
5.为什么虚拟地址一样,但互不影响?
因为父进程和子进程有 不同的页表.
图中左边父进程有一张页表,右边子进程也有一张页表.
虽然它们看到的虚拟地址可能都是:
text
0x601054但是:
text
父进程 0x601054 -> 父进程页表 -> 物理内存 A
子进程 0x601054 -> 子进程页表 -> 物理内存 B
所以它们的虚拟地址一样,但经过不同页表翻译后,得到的物理地址可以不同.
这就是为什么子进程执行:
c
g_val++;之后,子进程里的 g_val 变成 101、102、103......
但父进程里的 g_val 仍然可能一直是 100.
6.物理内存的含义
中间画的是 物理内存.
里面分别标出了:
text
父进程 g_val
子进程 g_val
这说明父子进程中的 g_val 最终可能对应物理内存中的两块不同区域.
也就是说:
text
父进程 g_val 的虚拟地址
        ↓
父进程页表
        ↓
物理内存中的父进程 g_val

子进程 g_val 的虚拟地址
        ↓
子进程页表
        ↓
物理内存中的子进程 g_val
这就是红线和蓝线表达的核心.
7.为什么父子进程代码区看起来也一样?
图中父子进程都有代码区.
fork() 之后,父子进程执行的是同一份程序代码,所以它们的代码区虚拟地址也类似.
但是代码区通常是只读的,不会被修改,因此父子进程的代码区可以共享同一份物理内存.
所以不是所有区域都会立刻复制.
一般来说:
text
代码区:通常可以共享
只读数据:可以共享
普通数据区:写时拷贝
堆区:写时拷贝
栈区:写时拷贝
8.核心结论
这张图最重要的结论是:
父子进程拥有各自独立的虚拟地址空间.它们可以看到相同的虚拟地址,例如
&g_val一样,但由于各自有不同的页表,所以最终可以映射到不同的物理内存.子进程修改g_val不会影响父进程.
可以用一句话概括:
text
虚拟地址相同,不代表物理地址相同。更完整地说:
text
父子进程地址空间布局相似,
所以变量的虚拟地址可能一样;
但进程之间通过页表隔离,
修改变量时通过写时拷贝分离物理内存,
因此父子进程的数据互不影响。
5.3.1如何理解虚拟地址空间?
可以把 虚拟地址空间 理解成:
操作系统给每个进程"画出来的一套假地址世界".
程序运行时,它以为自己拥有一整块连续的内存空间,但实际上这些地址并不一定直接对应真实物理内存.真正访问内存时,要经过 页表 + MMU 把虚拟地址转换成物理地址.
1.为什么叫"虚拟"地址?
比如程序里有一个全局变量:
c
int g_val = 100;

printf("%p\n", &g_val);
打印出来的 &g_val,不是物理内存条上的真实地址,而是 虚拟地址.
也就是说,程序看到的是:
text
g_val 在 0x601054但这个 0x601054 只是进程自己地址空间里的编号.
真正的数据可能在物理内存的另一个位置.
2.类比:虚拟地址像"座位号",物理地址像"真实椅子"
可以这样理解:
你拿到一张电影票,上面写着:
text
3 排 5 座对你来说,你只需要知道自己坐 3 排 5 座.
但是电影院管理系统可能会决定:
text
3 排 5 座 -> 实际对应某个影厅里的某把椅子程序也是一样.
程序只知道:
text
虚拟地址:0x601054但操作系统和硬件负责把它翻译成:
text
物理地址:真实内存中的某个位置3.每个进程都有自己的虚拟地址空间
这是最关键的点.
假设父进程和子进程都打印:
text
&g_val = 0x601054看起来地址一样.
但它们是两个不同进程,各自有自己的虚拟地址空间:
text
父进程:
虚拟地址 0x601054 -> 物理内存 A

子进程:
虚拟地址 0x601054 -> 物理内存 B
所以:
虚拟地址一样,不代表物理地址一样.
这就是为什么子进程修改 g_val,不会影响父进程的 g_val.
4.虚拟地址空间长什么样?
对于一个典型进程来说,它的虚拟地址空间大概分成这些区域:
text
高地址
┌────────────────────┐
│ 栈区               │  局部变量、函数调用
├────────────────────┤
│ 共享区             │  动态库、mmap 映射
├────────────────────┤
│ 堆区               │  malloc / new 申请的空间
├────────────────────┤
│ 未初始化数据区 BSS │  未初始化全局变量、静态变量
├────────────────────┤
│ 已初始化数据区     │  已初始化全局变量、静态变量
├────────────────────┤
│ 代码区             │  程序指令
└────────────────────┘
低地址
例如:
c
int g_val = 100;      // 已初始化数据区
int uninit_val;       // 未初始化数据区 BSS

int main()
{
    int a = 10;       // 栈区
    int *p = malloc(4); // 堆区
}
5.虚拟地址如何变成物理地址?
靠两个东西:
text
页表 + MMU流程大概是:
text
程序访问虚拟地址
        ↓
CPU 把虚拟地址交给 MMU
        ↓
MMU 查当前进程的页表
        ↓
找到对应的物理地址
        ↓
访问真实内存
可以理解为:
text
虚拟地址 -> 页表翻译 -> 物理地址页表就像一本"地址翻译表".
6.为什么需要虚拟地址空间?
主要有几个好处.
第一:实现进程隔离
每个进程都有自己的虚拟地址空间.
进程 A 不能随便访问进程 B 的内存.
即使两个进程里都有地址 0x601054,它们也可能映射到不同物理内存.
这样一个程序崩了,一般不会直接破坏另一个程序的数据.
第二:让程序觉得内存是连续的
程序写代码时,可以认为自己有一块连续地址:
text
0x00000000 ~ 0xFFFFFFFF但实际上物理内存可能是零散的.
操作系统通过页表把零散物理页映射成连续的虚拟地址.
这让程序员不用关心真实内存怎么分布.
第三:方便内存权限管理
不同区域可以设置不同权限:
text
代码区:可读、可执行、不可写
数据区:可读、可写
栈区:可读、可写
内核区:用户态不可访问
所以如果程序想修改代码区,或者访问非法地址,操作系统就可以拦截.
第四:支持写时拷贝
fork() 创建子进程时,不需要马上复制整个内存.
一开始父子进程可以共享同一份物理页.
等某一方要修改时,操作系统再复制一份.
这叫 写时拷贝 COW.
所以你看到:
text
父子进程 &g_val 一样
但 g_val 值可以不一样
本质上就是虚拟地址空间 + 页表 + 写时拷贝共同作用的结果.
7.用一句话总结
虚拟地址空间就是操作系统给每个进程提供的一套"独立的、连续的、受保护的假地址空间".
程序看到的是虚拟地址;
真正访问内存时,系统通过页表把虚拟地址翻译成物理地址.
最核心的理解是:
text
同一个虚拟地址,在不同进程中,可能对应不同的物理地址。所以:
text
地址相同 ≠ 同一块内存在进程场景下,打印出来的地址通常都是虚拟地址,不是物理地址.
5.3.2如何理解区域划分?
这里的"区域划分",指的是:操作系统把一个进程的虚拟地址空间,按照不同用途划分成若干块区域.每一块区域负责存放不同类型的数据,并且有不同的增长方向和访问权限.
可以把一个进程的虚拟地址空间想象成一栋楼:
text
高地址
┌────────────────────┐
│ 内核空间            │
├────────────────────┤
│ 命令行参数/环境变量 │
├────────────────────┤
│ 栈区                │
├────────────────────┤
│ 共享区              │
├────────────────────┤
│ 堆区                │
├────────────────────┤
│ 未初始化数据区 BSS  │
├────────────────────┤
│ 已初始化数据区      │
├────────────────────┤
│ 代码区              │
└────────────────────┘
低地址
每一层楼都有固定用途,这就是区域划分.
1.代码区:存放程序指令
代码区也叫正文代码区,主要存放程序编译后的机器指令.
例如:
c
int main()
{
    printf("hello\n");
    return 0;
}
main 函数、printf 调用相关的指令,都会放在代码区.
代码区通常具有:
text
可读、可执行、不可写也就是说,CPU 可以从这里取指令执行,但普通情况下不能随便修改代码区内容.这样可以防止程序运行时把自己的代码破坏掉.
2.已初始化数据区:存放有初值的全局变量和静态变量
例如:
c
int g_val = 100;

int main()
{
    return 0;
}
这里的 g_val 是全局变量,并且有明确初始值 100,所以它在 已初始化数据区.
再比如:
c
static int s_val = 20;它也在已初始化数据区.
你前面代码里的:
c
int g_val = 100;就属于这个区域.
所以图中 g_val 被画在"已初始化数据区".
3.未初始化数据区:BSS 段
未初始化数据区也叫 BSS 段.
它存放没有显式初始化,或者初始化为 0 的全局变量、静态变量.
例如:
c
int g_val;

static int count;
或者:
c
int g_val = 0;这些变量一般会被放到 BSS 段.
程序启动时,操作系统会把这片区域清零.
所以:
c
int g_val;虽然你没有写 = 0,但它默认就是 0.
4.堆区:动态申请内存
堆区主要用于 malloc、calloc、realloc、new 等动态内存申请.
例如:
c
int *p = malloc(sizeof(int));这块内存就在堆区.
堆区的特点是:由程序员主动申请和释放.
c
int *p = malloc(100);
free(p);
如果只 malloc 不 free,就可能造成内存泄漏.
堆区通常是 向高地址方向增长 的.
text
堆区
 ↑
向高地址增长
也就是说,程序动态申请的内存越来越多时,堆可能往上扩展.
5.共享区:动态库、mmap、共享内存
共享区通常用于存放:
- 动态库,比如
libc.so mmap映射的文件- 共享内存
- 动态链接相关内容
例如你写:
c
printf("hello\n");printf 不是你自己写的函数,它来自 C 标准库.程序运行时,C 标准库可能会被映射到共享区.
共享区之所以叫"共享",是因为多个进程可以映射同一份动态库代码,从而节省物理内存.
比如很多进程都用 libc.so,不需要每个进程都在物理内存里复制一份完整的 libc.
6.栈区:局部变量、函数调用、参数、返回地址
栈区主要存放函数调用相关的信息.
例如:
c
void test()
{
    int a = 10;
    int b = 20;
}
a 和 b 是局部变量,一般在栈区.
再比如:
c
int add(int x, int y)
{
    return x + y;
}
函数参数 x、y,函数返回地址,也和栈有关.
栈区的特点是:由系统自动管理.
函数调用时,栈空间自动分配;函数返回后,栈空间自动释放.
栈通常是 向低地址方向增长 的.
text
向低地址增长
 ↓
栈区
7.命令行参数和环境变量
程序启动时,操作系统会把命令行参数和环境变量放到靠近用户空间高地址的位置.
例如你运行:
bash
./test hello world那么:
c
int main(int argc, char *argv[])里面的 argc、argv 就和命令行参数有关.
环境变量比如:
bash
PATH
HOME
USER
这些也会被放到进程地址空间的高地址附近.
8.内核空间:用户不能直接访问
在 32 位 Linux 中,常见划分是:
text
用户空间:0x00000000 ~ 0xBFFFFFFF,大约 3GB
内核空间:0xC0000000 ~ 0xFFFFFFFF,大约 1GB
用户程序只能直接访问用户空间,不能随便访问内核空间.
如果用户程序强行访问内核空间,通常会发生错误,比如段错误.
内核空间由操作系统内核使用,里面存放:
- 内核代码
- 内核数据结构
- 进程管理信息
- 文件系统相关信息
- 驱动程序相关信息
用户程序如果想让内核帮忙做事,需要通过 系统调用.
例如:
c
fork();
read();
write();
open();
close();
malloc();
其中 fork()、read()、write() 这些会直接进入内核.malloc() 本身是库函数,但底层可能通过 brk 或 mmap 向内核申请内存.
9.为什么要这样划分?
区域划分主要有几个目的.
第一:方便管理
不同类型的数据放在不同区域,操作系统和编译器都更容易管理.
例如:
text
代码放代码区
全局变量放数据区
动态内存放堆区
局部变量放栈区
动态库放共享区
这样结构清晰,管理方便.
第二:设置不同权限
不同区域有不同权限.
例如:
text
代码区:可读、可执行、不可写
数据区:可读、可写
栈区:可读、可写
内核区:用户态不可访问
这样可以提高安全性.
比如程序不能随便修改代码区,用户进程不能随便访问内核空间.
第三:支持动态增长
堆和栈都不是固定死的.
堆可以随着 malloc 增长,栈可以随着函数调用增长.
所以图中会画:
text
堆向上增长
栈向下增长
它们中间留出一大片空间,谁需要就向中间扩展.
第四:支持进程隔离
每个进程都有自己的虚拟地址空间.
即使两个进程都有相同的区域划分,比如都有代码区、数据区、堆、栈,它们也是各自独立的.
比如父子进程中都有:
c
int g_val = 100;它们的 &g_val 可能一样,但只是虚拟地址一样.经过各自的页表转换后,可能对应不同物理内存.
10.一句话总结
区域划分就是操作系统和编译器把进程的虚拟地址空间按用途分成代码区、数据区、堆区、共享区、栈区、内核区等不同部分.
这样做的目的,是为了让程序的内存结构更清晰、更安全、更容易管理,也方便实现动态内存分配、函数调用、权限保护和进程隔离.
5.4虚拟内存管理
描述linux下进程的地址空间的所有的信息的结构体是 mm_struct (内存描述符).每个进程只有⼀个mm_struct结构,在每个进程的 task_struct 结构中,有⼀个指向该进程的mm_struct结构体指针.
bash
struct task_struct
{
/*...*/
struct mm_struct *mm; //对于普通的⽤⼾进程来说该字段指向他
的虚拟地址空间的⽤⼾空间部分,对于内核线程来说这部分为NULL。
struct mm_struct *active_mm; // 该字段是内核线程使⽤的。当
该进程是内核线程时,它的mm字段为NULL,表⽰没有内存地址空间,可也并不是真正的没有,这是因
为所有进程关于内核的映射都是⼀样的,内核线程可以使⽤任意进程的地址空间。
/*...*/
}
可以说mm_struct 结构是对整个⽤⼾空间的描述.每⼀个进程都会有⾃⼰独⽴的 mm_struct ,
这样每⼀个进程都会有⾃⼰独⽴的地址空间才能互不⼲扰.先来看看由 task_struct 到mm_struct ,进程的地址空间的分布情况:
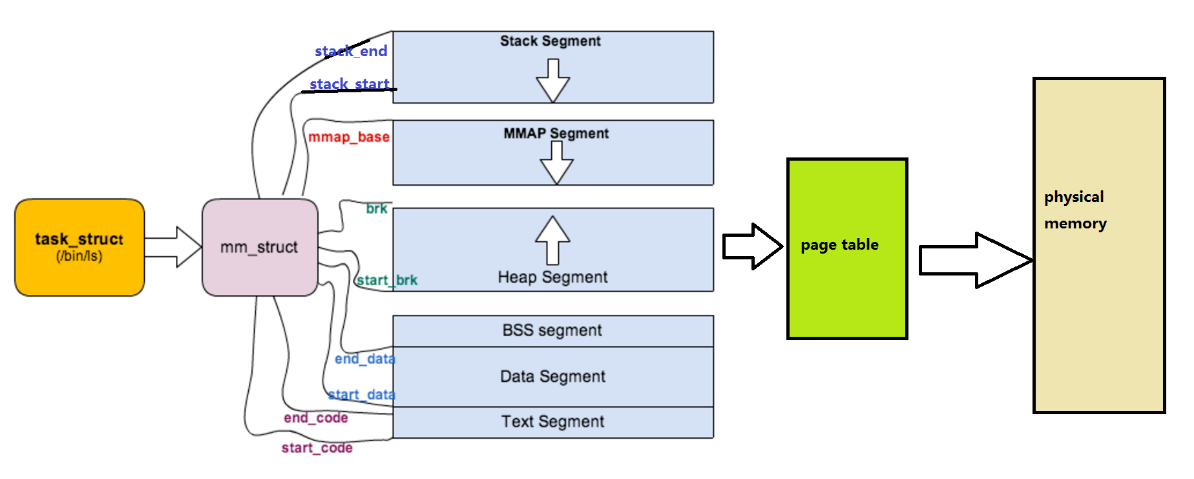
定位 mm_struct ⽂件所在位置和 task_struct 所在路径是⼀样的,不过他们所在⽂件是不⼀样
的,mm_struct 所在的⽂件是 mm_types.h
bash
struct mm_struct
{
/*...*/
struct vm_area_struct *mmap; /* 指向虚拟区间(VMA)链表 */
struct rb_root mm_rb; /* red_black树 */
unsigned long task_size; /*具有该结构体的进程的虚拟地址空间的⼤⼩*/
/*...*/
// 代码段、数据段、堆栈段、参数段及环境段的起始和结束地址。
unsigned long start_code, end_code, start_data, end_data;
unsigned long start_brk, brk, start_stack;
unsigned long arg_start, arg_end, env_start, env_end;
/*...*/
}
那既然每⼀个进程都会有⾃⼰独⽴的 mm_struct ,操作系统肯定是要将这么多进程mm_struct
组织起来的!虚拟空间的组织⽅式有两种:
- 当虚拟区较少时采取单链表,由mmap指针指向这个链表;
- 当虚拟区间多时采取红⿊树进⾏管理,由mm_rb指向这棵树.
linux内核使⽤ vm_area_struct 结构来表⽰⼀个独⽴的虚拟内存区域(VMA),由于每个不同质的虚拟内存区域功能和内部机制都不同,因此⼀个进程使⽤多个vm_area_struct结构来分别表⽰不同类型的虚拟内存区域.上⾯提到的两种组织⽅式使⽤的就是vm_area_struct结构来连接各个VMA,⽅便进程快速访问.
bash
struct vm_area_struct {
unsigned long vm_start; //虚存区起始
unsigned long vm_end; //虚存区结束
struct vm_area_struct *vm_next, *vm_prev; //前后指针
struct rb_node vm_rb; //红⿊树中的位置
unsigned long rb_subtree_gap;
struct mm_struct *vm_mm; //所属的 mm_struct
pgprot_t vm_page_prot;
unsigned long vm_flags; //标志位
struct {
struct rb_node rb;
unsigned long rb_subtree_last;
} shared;
struct list_head anon_vma_chain;
struct anon_vma *anon_vma;
const struct vm_operations_struct *vm_ops; //vma对应的实际操作
unsigned long vm_pgoff; //⽂件映射偏移量
struct file * vm_file; //映射的⽂件
void * vm_private_data; //私有数据
atomic_long_t swap_readahead_info;
#ifndef CONFIG_MMU
struct vm_region *vm_region; /* NOMMU mapping region */
#endif
#ifdef CONFIG_NUMA
struct mempolicy *vm_policy; /* NUMA policy for the VMA */
#endif
struct vm_userfaultfd_ctx vm_userfaultfd_ctx;
} __randomize_layout;
所以我们可以对上图在进⾏更细致的描述,如下图所示:
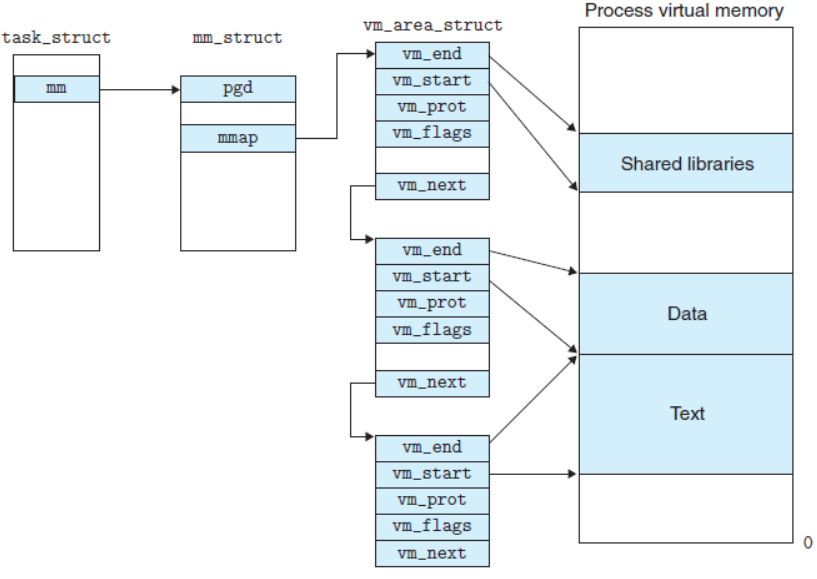
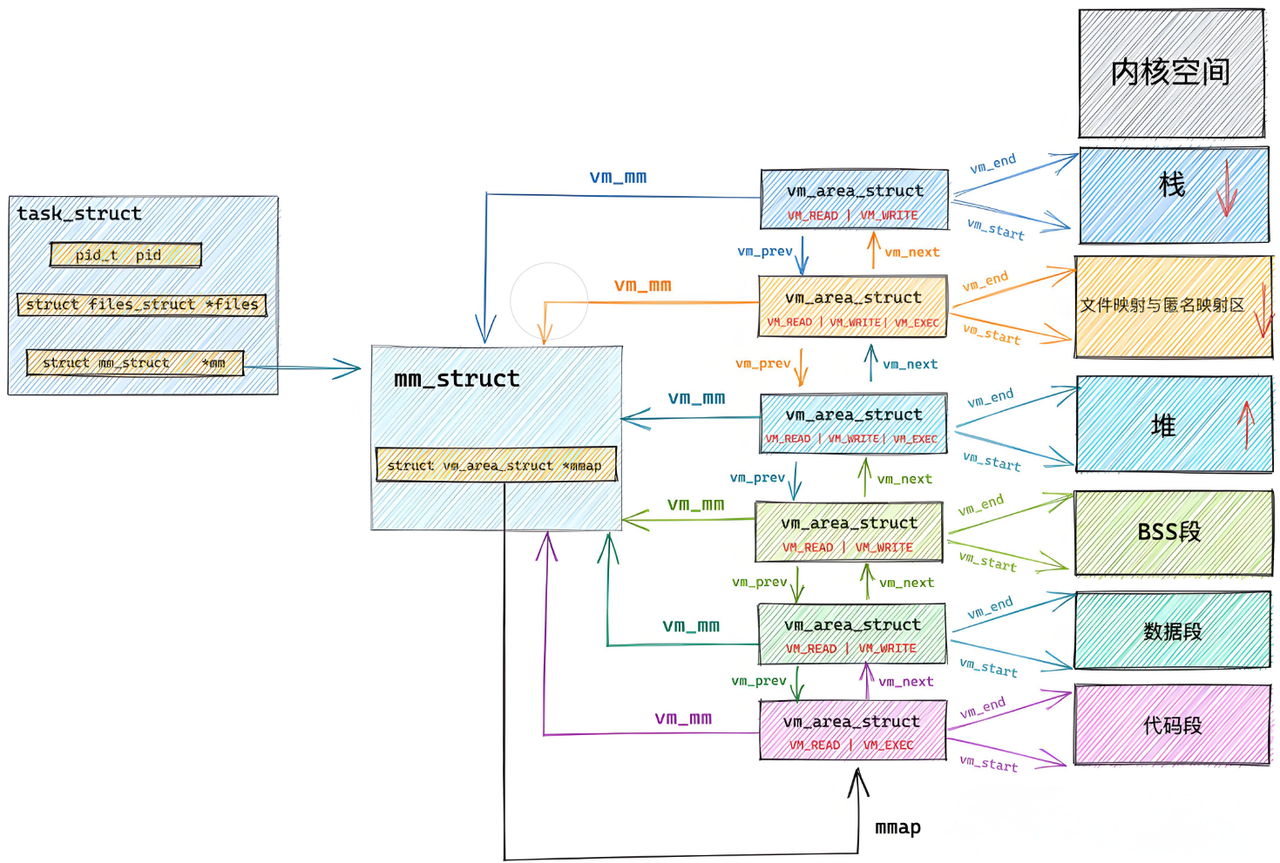
5.5为什么要有虚拟地址空间?
这个问题其实可以转化为:如果程序直接可以操作物理内存会造成什么问题?
在早期的计算机中,要运⾏⼀个程序,会把这些程序全都装⼊内存,程序都是直接运⾏在内存上的,也就是说程序中访问的内存地址都是实际的物理内存地址.当计算机同时运⾏多个程序时,必须保证这些程序⽤到的内存总量要⼩于计算机实际物理内存的⼤⼩.那当程序同时运⾏多个程序时,操作系统是如何为这些程序分配内存的呢?例如某台计算机总的内存⼤⼩是128M,现在同时运⾏两个程序A和B,A需占⽤内存10M,B需占⽤内存110.计算机在给程序分配内存时会采取这样的⽅法:先将内存中的前10M分配给程序A,接着再从内存中剩余的118M中划分出110M分配给程序B.
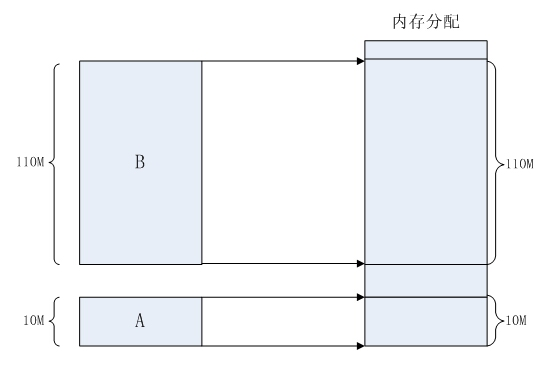
这种分配⽅法可以保证程序A和程序B都能运⾏,但是这种简单的内存分配策略问题很多.
- 安全⻛险:每个进程都可以访问任意的内存空间,这也就意味着任意⼀个进程都能够去读写系统相关内存区域,如果是⼀个⽊⻢病毒,那么它就能随意的修改内存空间,让设备直接瘫痪.
- 地址不确定:众所周知,编译完成后的程序是存放在硬盘上的,当运⾏的时候,需要将程序搬到内存当中去运⾏,如果直接使⽤物理地址的话,我们⽆法确定内存现在使⽤到哪⾥了,也就是说拷⻉的实际内存地址每⼀次运⾏都是不确定的,⽐如:第⼀次执⾏a.out时候,内存当中⼀个进程
都没有运⾏,所以搬移到内存地址是0x00000000,但是第⼆次的时候,内存已经有10个进程在运⾏了,那执⾏a.out的时候,内存地址就不⼀定了. - 效率低下:如果直接使⽤物理内存的话,⼀个进程就是作为⼀个整体(内存块)操作的,如果出现物理内存不够⽤的时候,我们⼀般的办法是将不常⽤的进程拷⻉到磁盘的交换分区中,好腾出内
存,但是如果是物理地址的话,就需要将整个进程⼀起拷⾛,这样,在内存和磁盘之间拷⻉时间太⻓,效率较低.
存在这么多问题,有了虚拟地址空间和分⻚机制就能解决了吗?当然!
- 地址空间和⻚表是OS创建并维护的!是不是也就意味着,凡是想使⽤地址空间和⻚表进⾏映射,
也⼀定要在OS的监管之下来进⾏访问!也顺便,包括各个进程以及内核的相关有效数据!保护了物理内存中的所有的合法数据. - 因为有地址空间的存在和⻚表的映射的存在,我们的物理内存中可以对未来的数据进⾏任意位置的加载!物理内存的分配和进程的管理就可以做到没有关系,进程管理模块和内存管理模块就完成了解耦合:因为有地址空间的存在,所以我们在C、C++语⾔上new, malloc空间的时候,其实是在地址空间上申请的,物理内存可以甚⾄⼀个字节都不给你.⽽当你真正进⾏对物理地址空间访问的时候,才执⾏内存的相关管理算法,帮你申请内存,构建⻚表映射关系(延迟分配),这是由操作系统⾃动完成,⽤⼾包括进程完全0感知!!
- 因为⻚表的映射的存在,程序在物理内存中理论上就可以任意位置加载.它可以将地址空间上的虚拟地址和物理地址进⾏映射,在进程视⻆所有的内存分布都可以是有序的.
🚀真正的勇者不是流泪的人,而是含泪奔跑的人!
敬请期待下一篇文章内容
每日心灵鸡汤: 成功是瞬间的荣耀,成长是一辈子的课题!
看过一个说法:"失败"是个伪概念,人根本就不会失败,因为努力到最后,要么成功了,要么学到了东西.所以,别再说"努力无意义"了.周国平说:"人的一生,有三次成长.第一次是发现自己不是世界中心的时候;第二次是在发现你即使再怎么努力,有些事还是无能为力的时候;第三次是明知道有些事可能会无能为力,还是尽力争取的时候."成功是瞬间的荣耀,成长是一辈子的课题.能成功固然好,但持续成长的人,才最厉害.