import torch
import torch.nn.functional as F
import numpy as np

class PolicyNet(torch.nn.Module):
    ''' 策略网络 (Actor):负责根据状态,直接输出一个确定的连续物理动作值 '''
    def __init__(self, state_dim, hidden_dim, action_dim, action_bound):
        super(PolicyNet, self).__init__()  # 继承并初始化 PyTorch 的 nn.Module
        self.fc1 = torch.nn.Linear(state_dim, hidden_dim)  # 第一层全连接,输入状态特征
        self.fc2 = torch.nn.Linear(hidden_dim, action_dim)  # 第二层全连接,直接输出动作
        # action_bound 是环境物理限制的最大动作值(例如方向盘最多只能打 30 度,这里就是 30)
        self.action_bound = action_bound

    def forward(self, x):
        x = F.relu(self.fc1(x))  # 经过隐藏层,使用 ReLU 激活函数增加非线性
        # 极其关键:这里使用 tanh 激活函数!
        # tanh 会把神经网络的输出死死限制在 [-1, 1] 之间。
        # 然后乘以 action_bound (比如 30),最终输出的动作就被完美限制在了 [-30, 30] 物理范围内!
        return torch.tanh(self.fc2(x)) * self.action_bound


class QValueNet(torch.nn.Module):
    ''' 价值网络 (Critic):负责给 (状态, 动作) 对打分,评价这个动作在当前状态下有多好 '''
    def __init__(self, state_dim, hidden_dim, action_dim):
        super(QValueNet, self).__init__()
        # 与 DQN 不同!这里的输入不仅有状态,还有动作!所以输入维度是 state_dim + action_dim
        self.fc1 = torch.nn.Linear(state_dim + action_dim, hidden_dim)
        self.fc2 = torch.nn.Linear(hidden_dim, hidden_dim)  # 第二个隐藏层
        self.fc_out = torch.nn.Linear(hidden_dim, 1)  # 最终输出一个标量:Q值(即这个动作的预计得分)

    def forward(self, x, a):
        # 核心操作:在维度 1 (列维度) 上,将 状态向量 x 和 动作向量 a 强行拼接在一起
        # 相当于把 "当前处境" 和 "你的决定" 揉成一团,送给 Critic 审判
        cat = torch.cat([x, a], dim=1)
        x = F.relu(self.fc1(cat))  # 经过第一层并激活
        x = F.relu(self.fc2(x))  # 经过第二层并激活
        return self.fc_out(x)  # 输出 Q 值(实数,不加激活函数)


class DDPG:
    ''' DDPG 算法核心大脑 '''
    def __init__(self, state_dim, hidden_dim, action_dim, action_bound, sigma, actor_lr, critic_lr, tau, gamma, device):
        # 1. 实例化主策略网络 (Actor)
        self.actor = PolicyNet(state_dim, hidden_dim, action_dim, action_bound).to(device)
        # 2. 实例化主价值网络 (Critic)
        self.critic = QValueNet(state_dim, hidden_dim, action_dim).to(device)
        # 3. 实例化目标策略网络 (Target Actor,充当提供稳定动作的"靶子")
        self.target_actor = PolicyNet(state_dim, hidden_dim, action_dim, action_bound).to(device)
        # 4. 实例化目标价值网络 (Target Critic,充当提供稳定分数的"靶子")
        self.target_critic = QValueNet(state_dim, hidden_dim, action_dim).to(device)

        # 初始化时,将主网络的参数"硬拷贝"给目标网络,保证起跑线一致
        self.target_critic.load_state_dict(self.critic.state_dict())
        self.target_actor.load_state_dict(self.actor.state_dict())

        # 定义主 Actor 的优化器
        self.actor_optimizer = torch.optim.Adam(self.actor.parameters(), lr=actor_lr)
        # 定义主 Critic 的优化器
        self.critic_optimizer = torch.optim.Adam(self.critic.parameters(), lr=critic_lr)

        self.gamma = gamma  # 折扣因子
        self.sigma = sigma  # 探索噪声的标准差。因为 DDPG 输出的是确定性动作,如果不加噪声,它永远不会尝试新动作
        self.tau = tau  # 软更新 (Soft Update) 的平滑系数,通常极小(如 0.005)
        self.action_dim = action_dim  # 动作维度大小
        self.device = device  # 计算设备

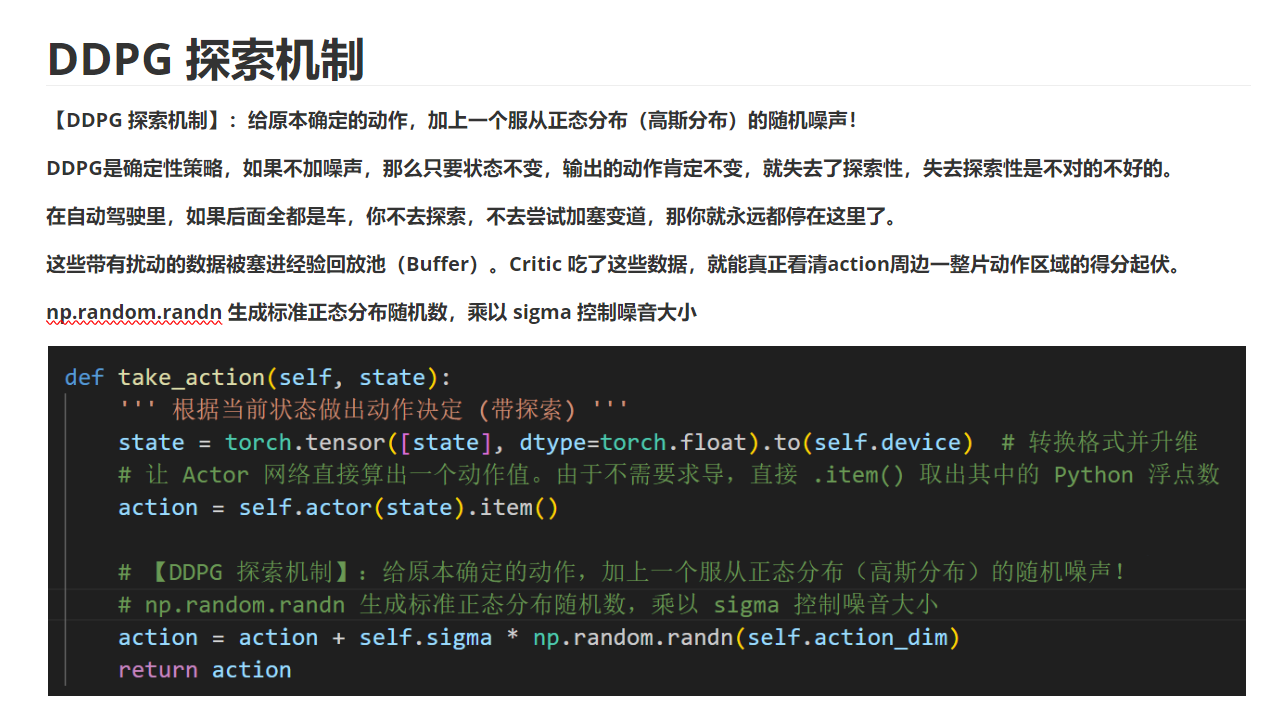
    def take_action(self, state):
        ''' 根据当前状态做出动作决定 (带探索) '''
        state = torch.tensor([state], dtype=torch.float).to(self.device)  # 转换格式并升维
        # 让 Actor 网络直接算出一个动作值。由于不需要求导,直接 .item() 取出其中的 Python 浮点数
        action = self.actor(state).item()

        # 【DDPG 探索机制】:给原本确定的动作,加上一个服从正态分布(高斯分布)的随机噪声!
        # np.random.randn 生成标准正态分布随机数,乘以 sigma 控制噪音大小
        action = action + self.sigma * np.random.randn(self.action_dim)
        return action

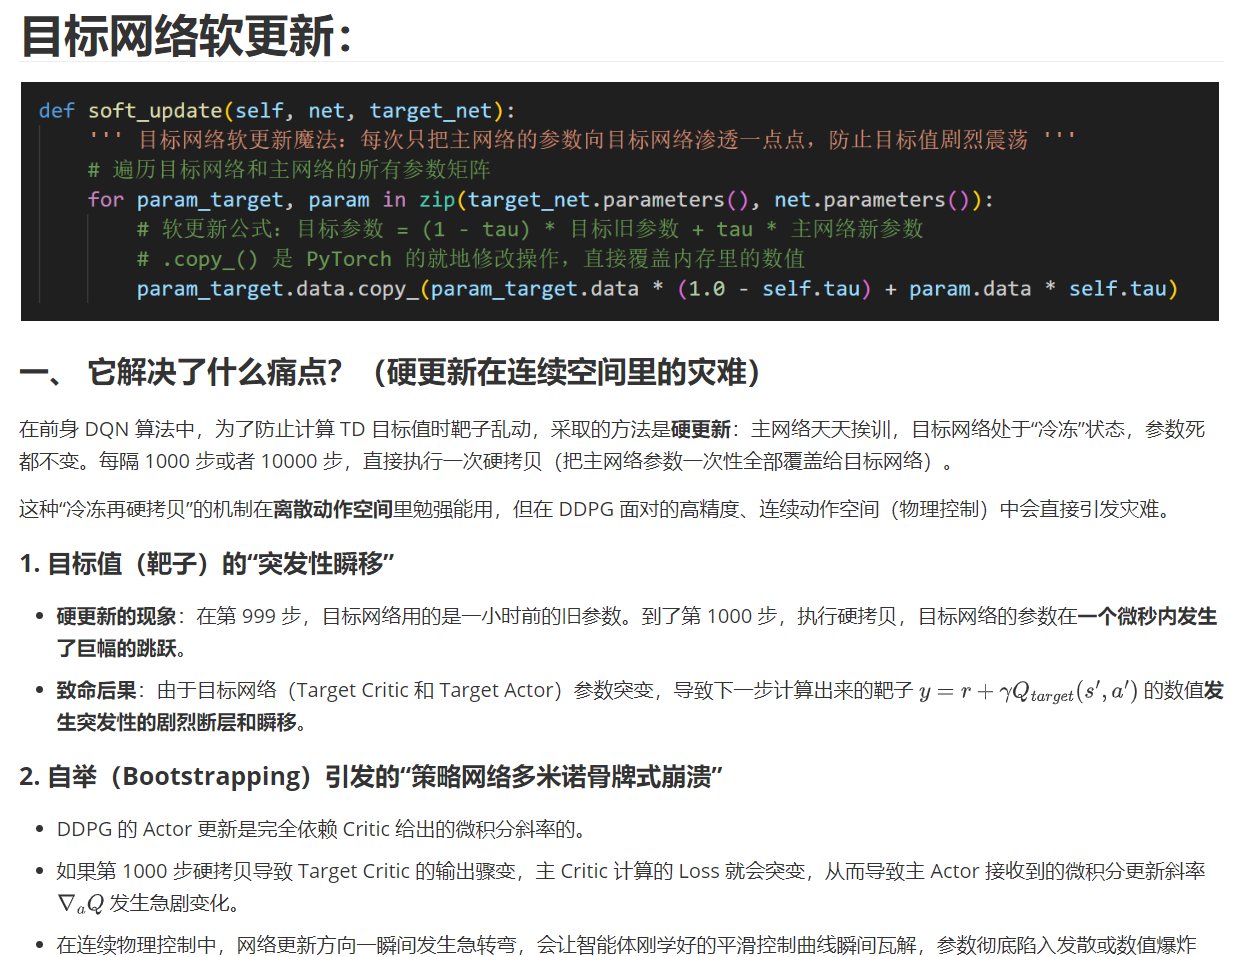
    def soft_update(self, net, target_net):
        ''' 目标网络软更新魔法:每次只把主网络的参数向目标网络渗透一点点,防止目标值剧烈震荡 '''
        # 遍历目标网络和主网络的所有参数矩阵
        for param_target, param in zip(target_net.parameters(), net.parameters()):
            # 软更新公式:目标参数 = (1 - tau) * 目标旧参数 + tau * 主网络新参数
            # .copy_() 是 PyTorch 的就地修改操作,直接覆盖内存里的数值
            param_target.data.copy_(param_target.data * (1.0 - self.tau) + param.data * self.tau)

    def update(self, transition_dict):
        ''' 核心训练逻辑 '''
        # 从经验池提取数据,并转换为适合放入神经网络的 Tensor 格式,全扔到指定设备上
        states = torch.tensor(transition_dict['states'], dtype=torch.float).to(self.device)
        actions = torch.tensor(transition_dict['actions'], dtype=torch.float).view(-1, 1).to(self.device)
        rewards = torch.tensor(transition_dict['rewards'], dtype=torch.float).view(-1, 1).to(self.device)
        next_states = torch.tensor(transition_dict['next_states'], dtype=torch.float).to(self.device)
        dones = torch.tensor(transition_dict['dones'], dtype=torch.float).view(-1, 1).to(self.device)

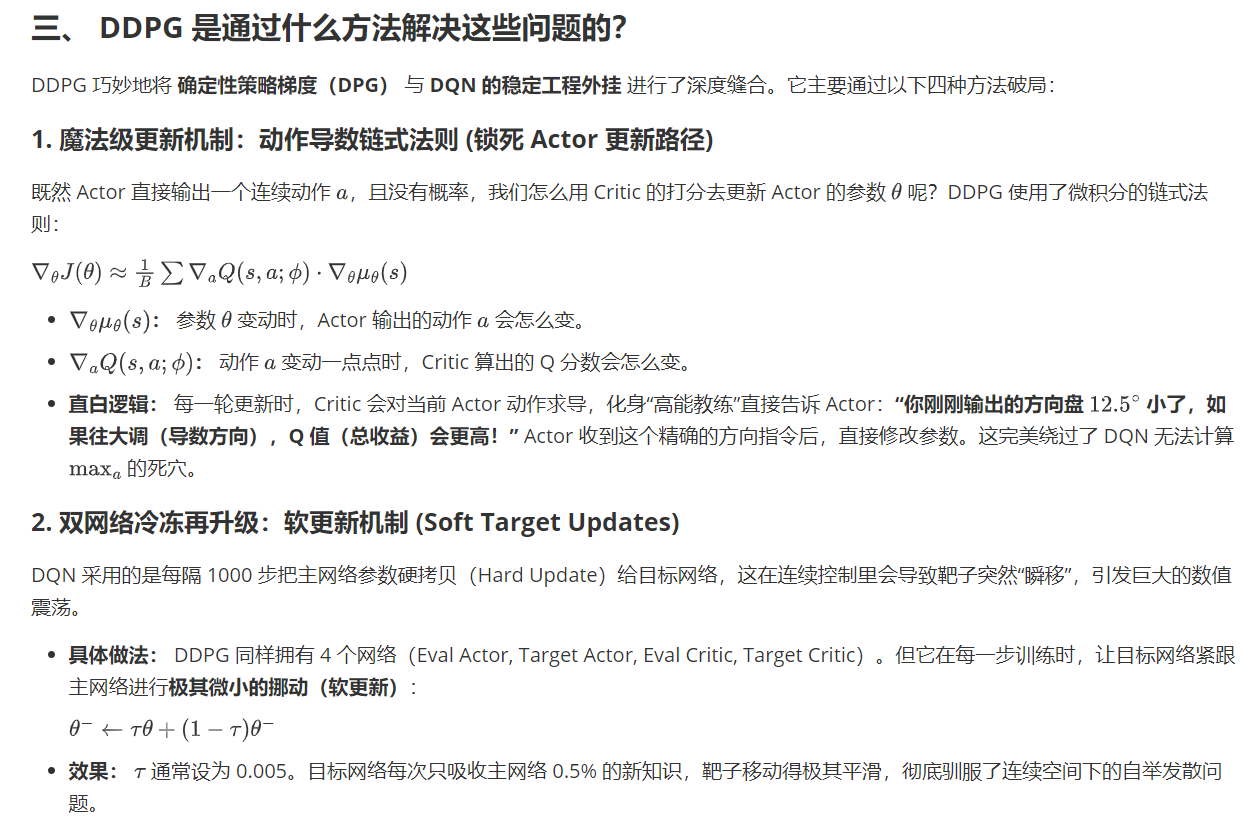
        # ---------------- 1. 更新 Critic (评论家) ----------------
        # 计算未来的目标 Q 值:让 Target Actor 预测下一步该做什么,然后让 Target Critic 给这个未来动作打分
        next_q_values = self.target_critic(next_states, self.target_actor(next_states))

        # 算出当前状态下的 目标绝对真理 (TD Target)。游戏结束时 (dones=1),未来期望强制归零
        q_targets = rewards + self.gamma * next_q_values * (1 - dones)

        # 让主 Critic 对当前状态和刚做过的动作打分:self.critic(states, actions)
        # Critic 的损失函数:主 Critic 的预测值 与 目标真理值 之间的均方误差 (MSE)
        critic_loss = torch.mean(F.mse_loss(self.critic(states, actions), q_targets))

        self.critic_optimizer.zero_grad()  # 清空 Critic 优化器梯度
        critic_loss.backward()  # 反向传播,算出 Critic 每个参数的梯度
        self.critic_optimizer.step()  # 修改 Critic 参数

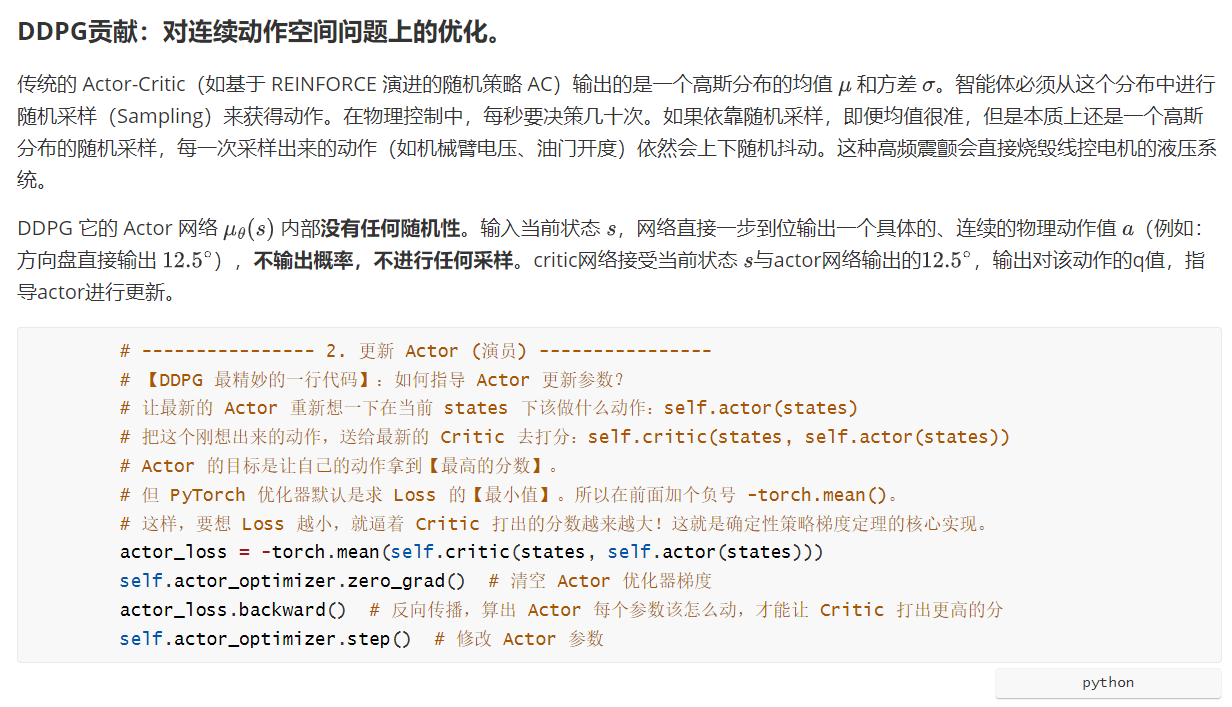
        # ---------------- 2. 更新 Actor (演员) ----------------
        # 【DDPG 最精妙的一行代码】:如何指导 Actor 更新参数?
        # 让最新的 Actor 重新想一下在当前 states 下该做什么动作:self.actor(states)
        # 把这个刚想出来的动作,送给最新的 Critic 去打分:self.critic(states, self.actor(states))
        # Actor 的目标是让自己的动作拿到【最高的分数】。
        # 但 PyTorch 优化器默认是求 Loss 的【最小值】。所以在前面加个负号 -torch.mean()。
        # 这样,要想 Loss 越小,就逼着 Critic 打出的分数越来越大!这就是确定性策略梯度定理的核心实现。
        actor_loss = -torch.mean(self.critic(states, self.actor(states)))

        self.actor_optimizer.zero_grad()  # 清空 Actor 优化器梯度
        actor_loss.backward()  # 反向传播,算出 Actor 每个参数该怎么动,才能让 Critic 打出更高的分
        self.actor_optimizer.step()  # 修改 Actor 参数

        # ---------------- 3. 更新目标网络 (靶子) ----------------
        # 每次训练完,不仅更新主网络,还要让两个目标网络吸收一点主网络的聪明才智(软更新)
        self.soft_update(self.actor, self.target_actor)  # 软更新目标策略网络
        self.soft_update(self.critic, self.target_critic)  # 软更新目标价值网络