接上篇《第一个 AI 调用------TypeScript 工程初始化与配置管理》,本篇在已经能成功调用大模型的基础上,深入对比 LangChain.js 里两种最常用的调用方式:
invoke(阻塞式) 和stream(流式)。读完你就能根据场景选对姿势,并避开几个真实的坑。
一、回顾:模型是怎么初始化的
无论用哪种方式,第一步都是创建一个 ChatOpenAI 实例(以 DeepSeek 为例):
ts
import "dotenv/config";
import { ChatOpenAI } from "@langchain/openai";

// 从 .env 读取配置:NANA_MODEL / NANA_API_KEY / NANA_API_BASE_URL
const getEnv = (key: string) => process.env[key] || "";

const llm = new ChatOpenAI({
  model: getEnv("NANA_MODEL"),            // 例如 deepseek-chat
  apiKey: getEnv("NANA_API_KEY"),        // sk-xxx
  configuration: {
    baseURL: getEnv("NANA_API_BASE_URL"), // https://api.deepseek.com/v1
  },
});
.env 关键配置(注意 baseURL 只写到 /v1,SDK 会自动拼接 /chat/completions):
env
NANA_API_KEY=sk-xxxx
NANA_MODEL=deepseek-chat
NANA_API_BASE_URL=https://api.deepseek.com/v1
环境变量、依赖安装、Prettier 保存格式化等前置步骤见上篇,本文不再展开。
二、invoke:阻塞式调用
invoke 是最直观的调用方式------把整个 Prompt 丢进去,等模型把全部内容生成完,一次性返回结果。
ts
const invoke = async (prompt: string) => {
  const res = await llm.invoke(prompt);
  console.log(res.content);
};

invoke("写一首关于AI的诗");
发生了什么
- 请求发出,客户端进入等待。
- 模型在服务器侧逐 token 生成,但服务端会攒齐全部 token 才一次性返回 HTTP 响应。
await拿到完整结果,res.content就是诗歌全文(字符串)。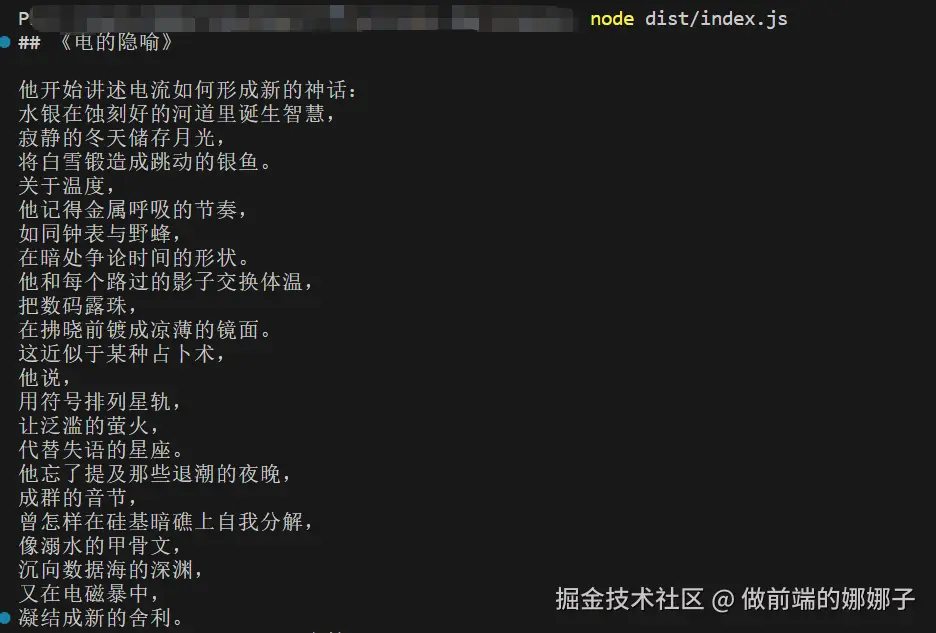
适用场景
- 简短问答、翻译、摘要
- 需要把结果当变量继续做逻辑处理(比如解析 JSON、喂给下一步)
- 不关心"边生成边显示"的交互体验
缺点
- 用户要干等整段生成完成。如果模型要写 500 字,可能要等好几秒才"啪"一下全部出现,体验差。
- 长时间无输出,容易让人以为程序卡死了。
三、stream:流式调用
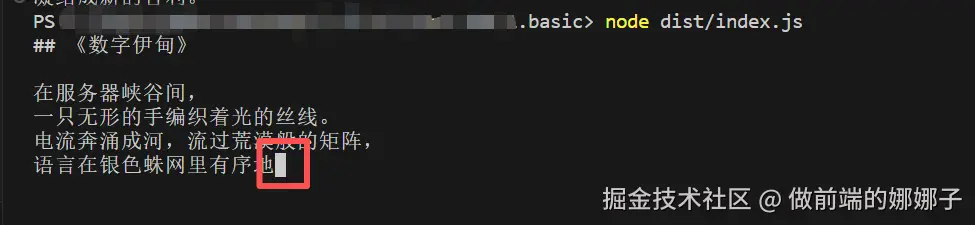
stream 让模型边生成边返回,前端/终端可以像打字机一样逐字吐出。这才是 ChatGPT 那种"逐字蹦字"体验的底层原理。
ts
import { HumanMessage } from "@langchain/core/messages";

const stream = async () => {
  const stream = await llm.stream([new HumanMessage("写一首关于AI的诗")]);
  for await (const chunk of stream) {
    const content = Array.isArray(chunk.content)
      ? chunk.content.map((item) => ("text" in item ? item.text : "")).join("")
      : chunk.content;
    if (content) process.stdout.write(content);
  }
};

stream();
发生了什么
- 请求发出,服务端以 SSE(Server-Sent Events) 流的形式,每生成一小块 token 就推一段。
llm.stream(...)返回一个异步可迭代对象(AsyncIterable)。- 用
for await...of逐块消费,chunk.content就是这一小段文本。 process.stdout.write(content)把碎片直接写到终端,不换行、不缓冲。
为什么要用 HumanMessage 而不是字符串
stream 接收的是 消息数组 ,不是裸字符串(裸字符串只有 invoke 支持)。标准写法是包一层 HumanMessage:
ts
import { HumanMessage } from "@langchain/core/messages";

llm.stream([new HumanMessage("写一首关于AI的诗")]);
如果漏掉 import { HumanMessage },TS 会直接报"找不到名称 HumanMessage"。
chunk.content 为什么要做数组判断
LangChain 的 content 类型其实是 string | Array<...>------当返回纯文本时是字符串;当涉及多模态(图片、工具调用等)时会变成内容块数组。所以用 Array.isArray 兜底,保证只取文本部分:
ts
const content = Array.isArray(chunk.content)
  ? chunk.content.map((item) => ("text" in item ? item.text : "")).join("")
  : chunk.content;
process.stdout.write vs console.log
console.log(content)每次都会自动加换行\n,一首诗会被切成一堆带空行的小段,很难看。process.stdout.write(content)原样输出、不换行,拼起来才是完整连贯的文本。
适用场景
- 聊天对话、长文生成(体验最佳)
- 任何需要"即时反馈"的交互
- 前端打字机效果、Token 用量实时统计
四、两种方式对比
| 维度 | invoke(阻塞式) | stream(流式) |
|---|---|---|
| 返回时机 | 全部生成完才返回 | 边生成边返回 |
| 返回类型 | 完整 AIMessage |
AsyncIterable<chunk> |
| 消费方式 | await 一次拿结果 |
for await...of 遍历 |
| 入参 | 字符串或消息数组 | 消息数组(推荐 HumanMessage) |
| 终端体验 | 干等后整段出现 | 逐字打印,像打字机 |
| 取文本 | res.content |
chunk.content(需遍历拼接) |
| 适合场景 | 工具调用、JSON 解析、短答 | 对话、长文、实时展示 |
| 首次出字延迟 | 高(等整段) | 低(首个 token 即出) |
一句话总结:要拿结果做后续处理用 invoke,要给用户看的用 stream。
五、今天踩过的真实坑
-
res.content不是res.concat新手容易把字符串的.concat()方法当成响应属性,写出来res.concat得到undefined。响应正文是res.content。 -
stream入参要用消息对象llm.stream([["human", "..."]])这种元组写法在新版 LangChain 已不支持,会抛Unable to coerce message from array。改成llm.stream([new HumanMessage("...")])或llm.stream("...")。 -
HumanMessage必须导入 只写new HumanMessage(...)不import,TS 直接报错"找不到名称"。 -
.env用=不用:写成NANA_API_KEY:sk-xxx会导致 dotenv 读不到,apiKey变空字符串,报Missing credentials。 -
baseURL别带/chat/completions写成https://api.deepseek.com/v1/chat/completions,SDK 会再拼一次,最终请求变成.../chat/completions/chat/completions,直接 404。只写到https://api.deepseek.com/v1。
六、运行验证
bash
# 编译
pnpm build
# 运行(默认走 stream)
node dist/index.js
终端会逐字打印出 DeepSeek 写的诗,证明流式调用已通。
想对比 invoke,把被注释的那段解开、注释掉 stream 即可:
ts
const res = await llm.invoke("写一首关于AI的诗");
console.log(res.content);
七、小结
invoke是"一次性拿结果",适合程序内部消费;stream是"边生成边拿",适合给用户看。- 流式关键是
AsyncIterable+for await...of+process.stdout.write。 content可能是数组,生产代码要做类型兜底。- 所有配置(key、baseURL)都来自
.env,改配置不用重新编译,重启进程即可。
下一篇可以聊 多轮对话(带 history 的 messages 数组) 或 RAG 向量检索,把"单次问答"升级成"能记住上下文的助手"。
相关代码 :nana-ima/1.basic/src/index.ts 环境搭建:见《第一个 AI 调用------TypeScript 工程初始化与配置管理》