MoE 训练中的长尾问题
MoE 已经是大模型的主流形态。每个 token 只激活少数专家,模型规模能继续放大,而单步计算量不必同步膨胀。但专家并行(EP)存在一个现实问题:每张卡要算多少 token,完全由路由结果临时决定。几个专家一旦成为热点,token 集中涌向承载它们的 rank,同步训练的整体耗时被这几张卡拖住,其余的卡算完只能空等。
现有方案漏看了一件事
这个问题业界很早就想到过解法:既然某个专家计算太多,那就把它的权重临时复制一份,放到一张空闲的卡上,让这张卡帮着分担一部分。
问题在于,这些方案几乎只优化一件事------负载摊得够不够平,并默认放哪张空闲卡中都行。可真实的机器并不是这样:
- 同一台机器里的卡,彼此之间走的是 NVLink 这种高速通道,搬数据又快又省;
- 而跨机器的卡之间,得走网络(InfiniBand),搬同样多的数据,慢得多,也贵得多。
这就带来一个容易被忽略的后果:两个方案哪怕负载摊得一样平,只要一个把权重留在了本机、另一个搬去了别的机器,实际花掉的通信开销可能差出一大截。
TAOT 的思路:把"搬运的代价"也算进去
百度 LoongForge 团队认为副本到底放哪张卡,不能只问"哪里有空",还得问一句"搬过去到底有多贵"。
TAOT 正是从这里入手的------它首次把"削峰收益"和"跨节点搬权重的代价"同时写进优化目标,即在挑副本落点时,会同时考虑两件事:一边要把负载摊平,一边还要尽量少花跨机器搬运的通信代价。
它借用了数学里"最优传输"(Optimal Transport)的思想来做这件事,你可以把它理解成一个会算通信账的调度员:
- 能放本机就放本机:本机里还有空位,就先放本机,省得往外搬;
- 实在放不下才往外走:本机满了,跨机器也不是完全禁止,只是在它看来这是"可以选、但更费钱"的选项,而不会被一刀切掉。
现有方案基本落在两个极端。一类干脆不看拓扑,只要哪张卡空就往哪儿放,副本很容易被扔到隔壁机器上,负载是摊平了,跨机通信却涨了一大截;另一类则反过来,用一张固定的拓扑图把权重能往哪儿搬写死,规模一大,热点被拆散,近处的容量先用完,远处那些其实还闲着的卡又被图挡在门外,能调度的空间反而变窄。
TAOT 走的是中间路线:不禁止跨机,也不写死路径,只是给跨机贴上一个"更贵"的标价,让它在算账时自然排在后面。所以规模越大、空闲的卡越多,它反而越有腾挪的余地,以下是系统整体架构图:
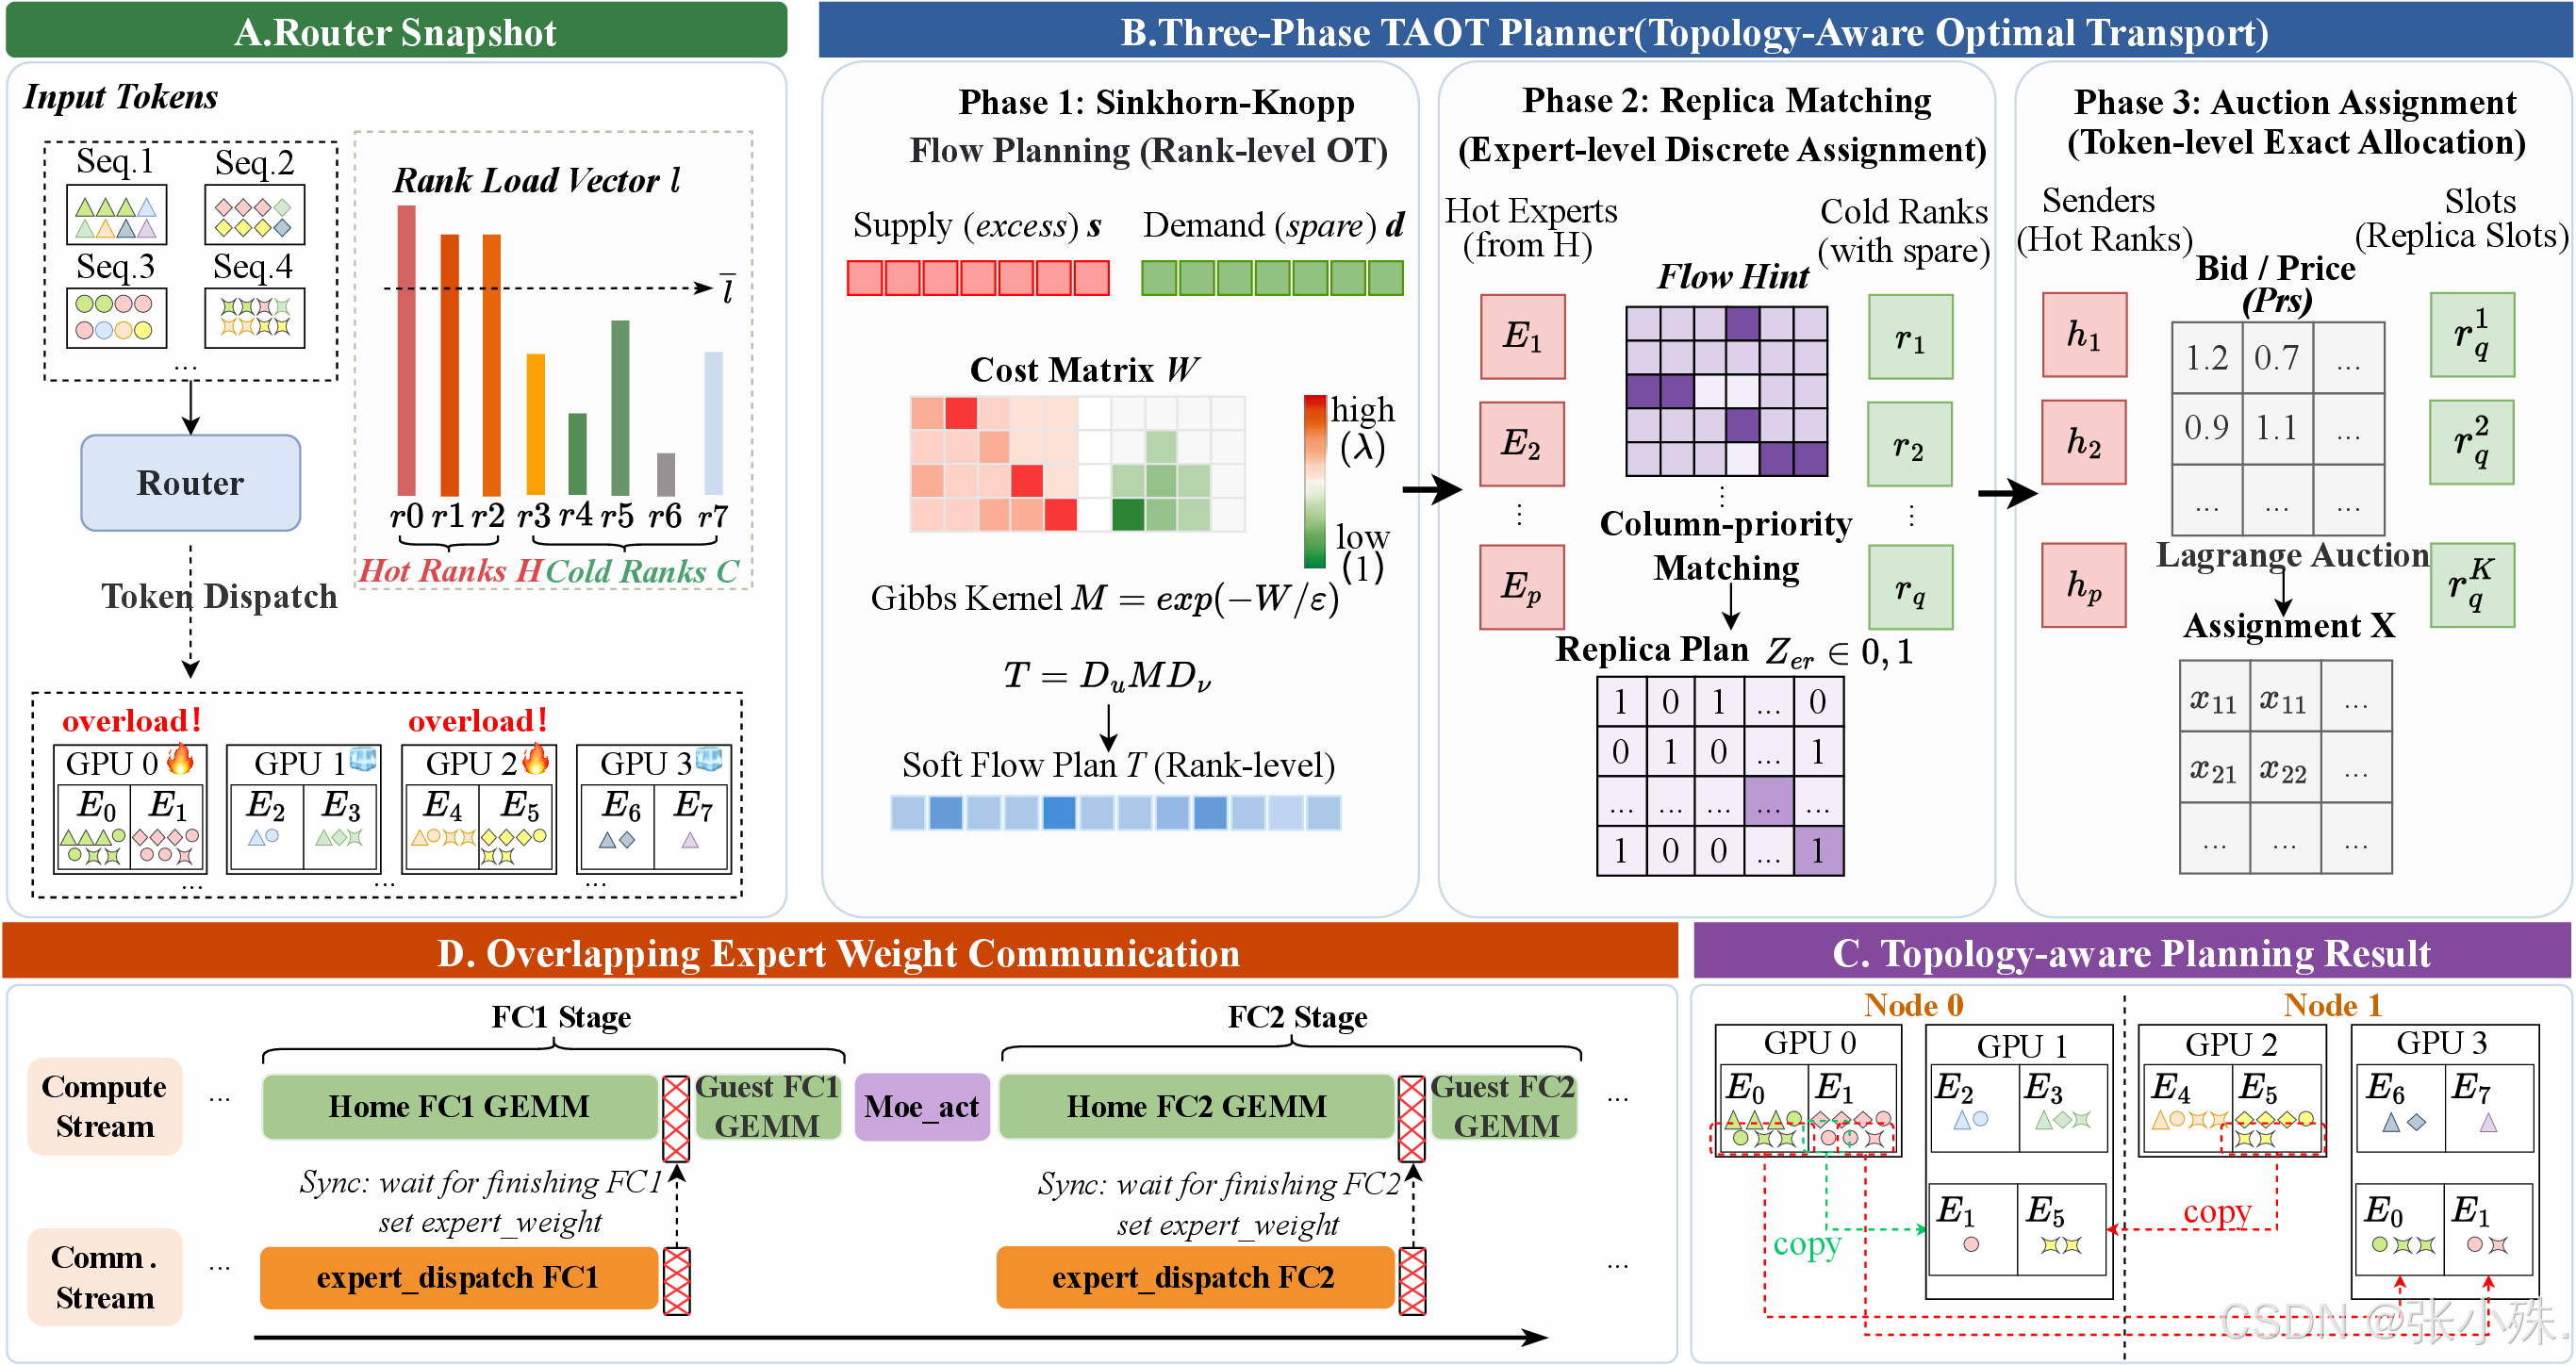
TAOT 的整体流程:路由算完之后,先收集每张卡的负载情况,交给三阶段规划器定出副本方案,执行时再把副本权重搬到位,并让这部分搬运和显卡上的计算并行起来。
"均衡"和"通信代价"两个目标一起解,问题规模会随 EP 度数迅速膨胀。TAOT 把它拆成三步,从粗到细,每一步只回答一个问题:
- Phase 1(rank 级):负载大致该往哪流? 把过载量当供给、空闲容量当需求,配上通信代价矩阵求最优传输,得到一张全局的流量建议表------它只是软提示,作用是给后两步一个全局参照,别只顾眼前。
- Phase 2(专家级):哪个专家的副本,进哪张卡? 把连续流量变成 0/1 决策:给每个"(空闲卡, 热点专家)"配对算一个由削峰收益、落点远近、Phase 1 流量提示三项加权组成的分数,取分数最高的组合。
- Phase 3(token 级):这些 token 分别由谁来发? 同一个专家的 token 散在多张卡上,用一轮轮竞价定下每张源卡各发多少。中标者价格上涨,下一轮自然让位,就近原则也就此带进了分配。
光有算法还不够,工程上还得配合
一个方法想真正跑进训练里,只有好算法是不够的,工程上还有两处得跟上。
第一,调度本身得够快。 这套规划不是算一次就完事,而是要在训练里一个 microbatch 接一个 microbatch 地反复实时跑。要是规划自己就慢,那通信这头省下来的时间,转头又搭在了调度上。为此团队在算子层面做了大量优化,把原本要跑几百次的零碎计算压缩到几次,最后把整个规划的开销控制在了前向计算时间的 1% 以内。
第二,把搬运的动作"藏"进计算里。 副本权重的分发被放在通信流上,与同一张卡上 home 专家的 GEMM 并行;反向阶段 guest 梯度通过一次 All-to-All 回传累加。搬运时间基本被计算掩盖。
实际效果怎么样
- 更快:在 Qwen3-30B-A3B 上,单次迭代的前反向计算时间从 155.4ms 降到了 108.8ms,端到端加速 1.43 倍;
- 更省:在负载同样摊得很平的前提下,它的通信代价是所有对比的 SOTA 方法里最低的,最多比对手低 74%;
- 不牺牲精度:这份加速来自更合理的调度,而不是靠降低数值精度换来的,loss 曲线和标准方案几乎重合;
- 规模越大越明显 :并行规模越大、初始的负载越不均衡,TAOT 带来的加速就越显著。EP4 到 EP16,加速最高 1.79× ;初始不均衡从 30% 升到 90%,加速从 1.21× 涨到 1.75×。越难的场景,收益越大。
结语:会算通信账的调度器
动态副本已经是 MoE 均衡里比较成熟的一条技术路线,Echo、LPLB、LLEP 都在这条线上。TAOT 的区别在优化目标:把副本落点的通信代价和削峰收益放进同一个目标函数里权衡,而不是只求负载摊平。实现上用连续代价矩阵配软拓扑偏好,把"优先节点内、必要时再跨节点"直接写进目标,不依赖特殊硬件,不锁死在单节点,不用预定义图。
如果你正在做大规模 MoE 训练,训练被少数热点专家拖住长尾,TAOT 值得试一试。它已作为 MoE 专家机制的扩展,集成进百度百舸开源的全模态训练框架 LoongForge中。
- 📄 论文:https://arxiv.org/abs/2608.03676
- 🔗 LoongForge 开源地址:https://github.com/baidu-baige/LoongForge