在企业AI化转型过程中,预测建模往往是数据价值落地的关键一步。但面对决策树、随机森林、XGBoost等常见树模型,很多技术团队容易陷入"越复杂越好"的误区。
本文旨在系统梳理三种模型的原理、优缺点和适用场景,并通过对比表格与常见问题,为读者提供一份客观、可落地的选型参考。写这篇文章的原因很简单:算法选型不是追新,而是匹配业务与数据。
一、决策树:可解释性的起点
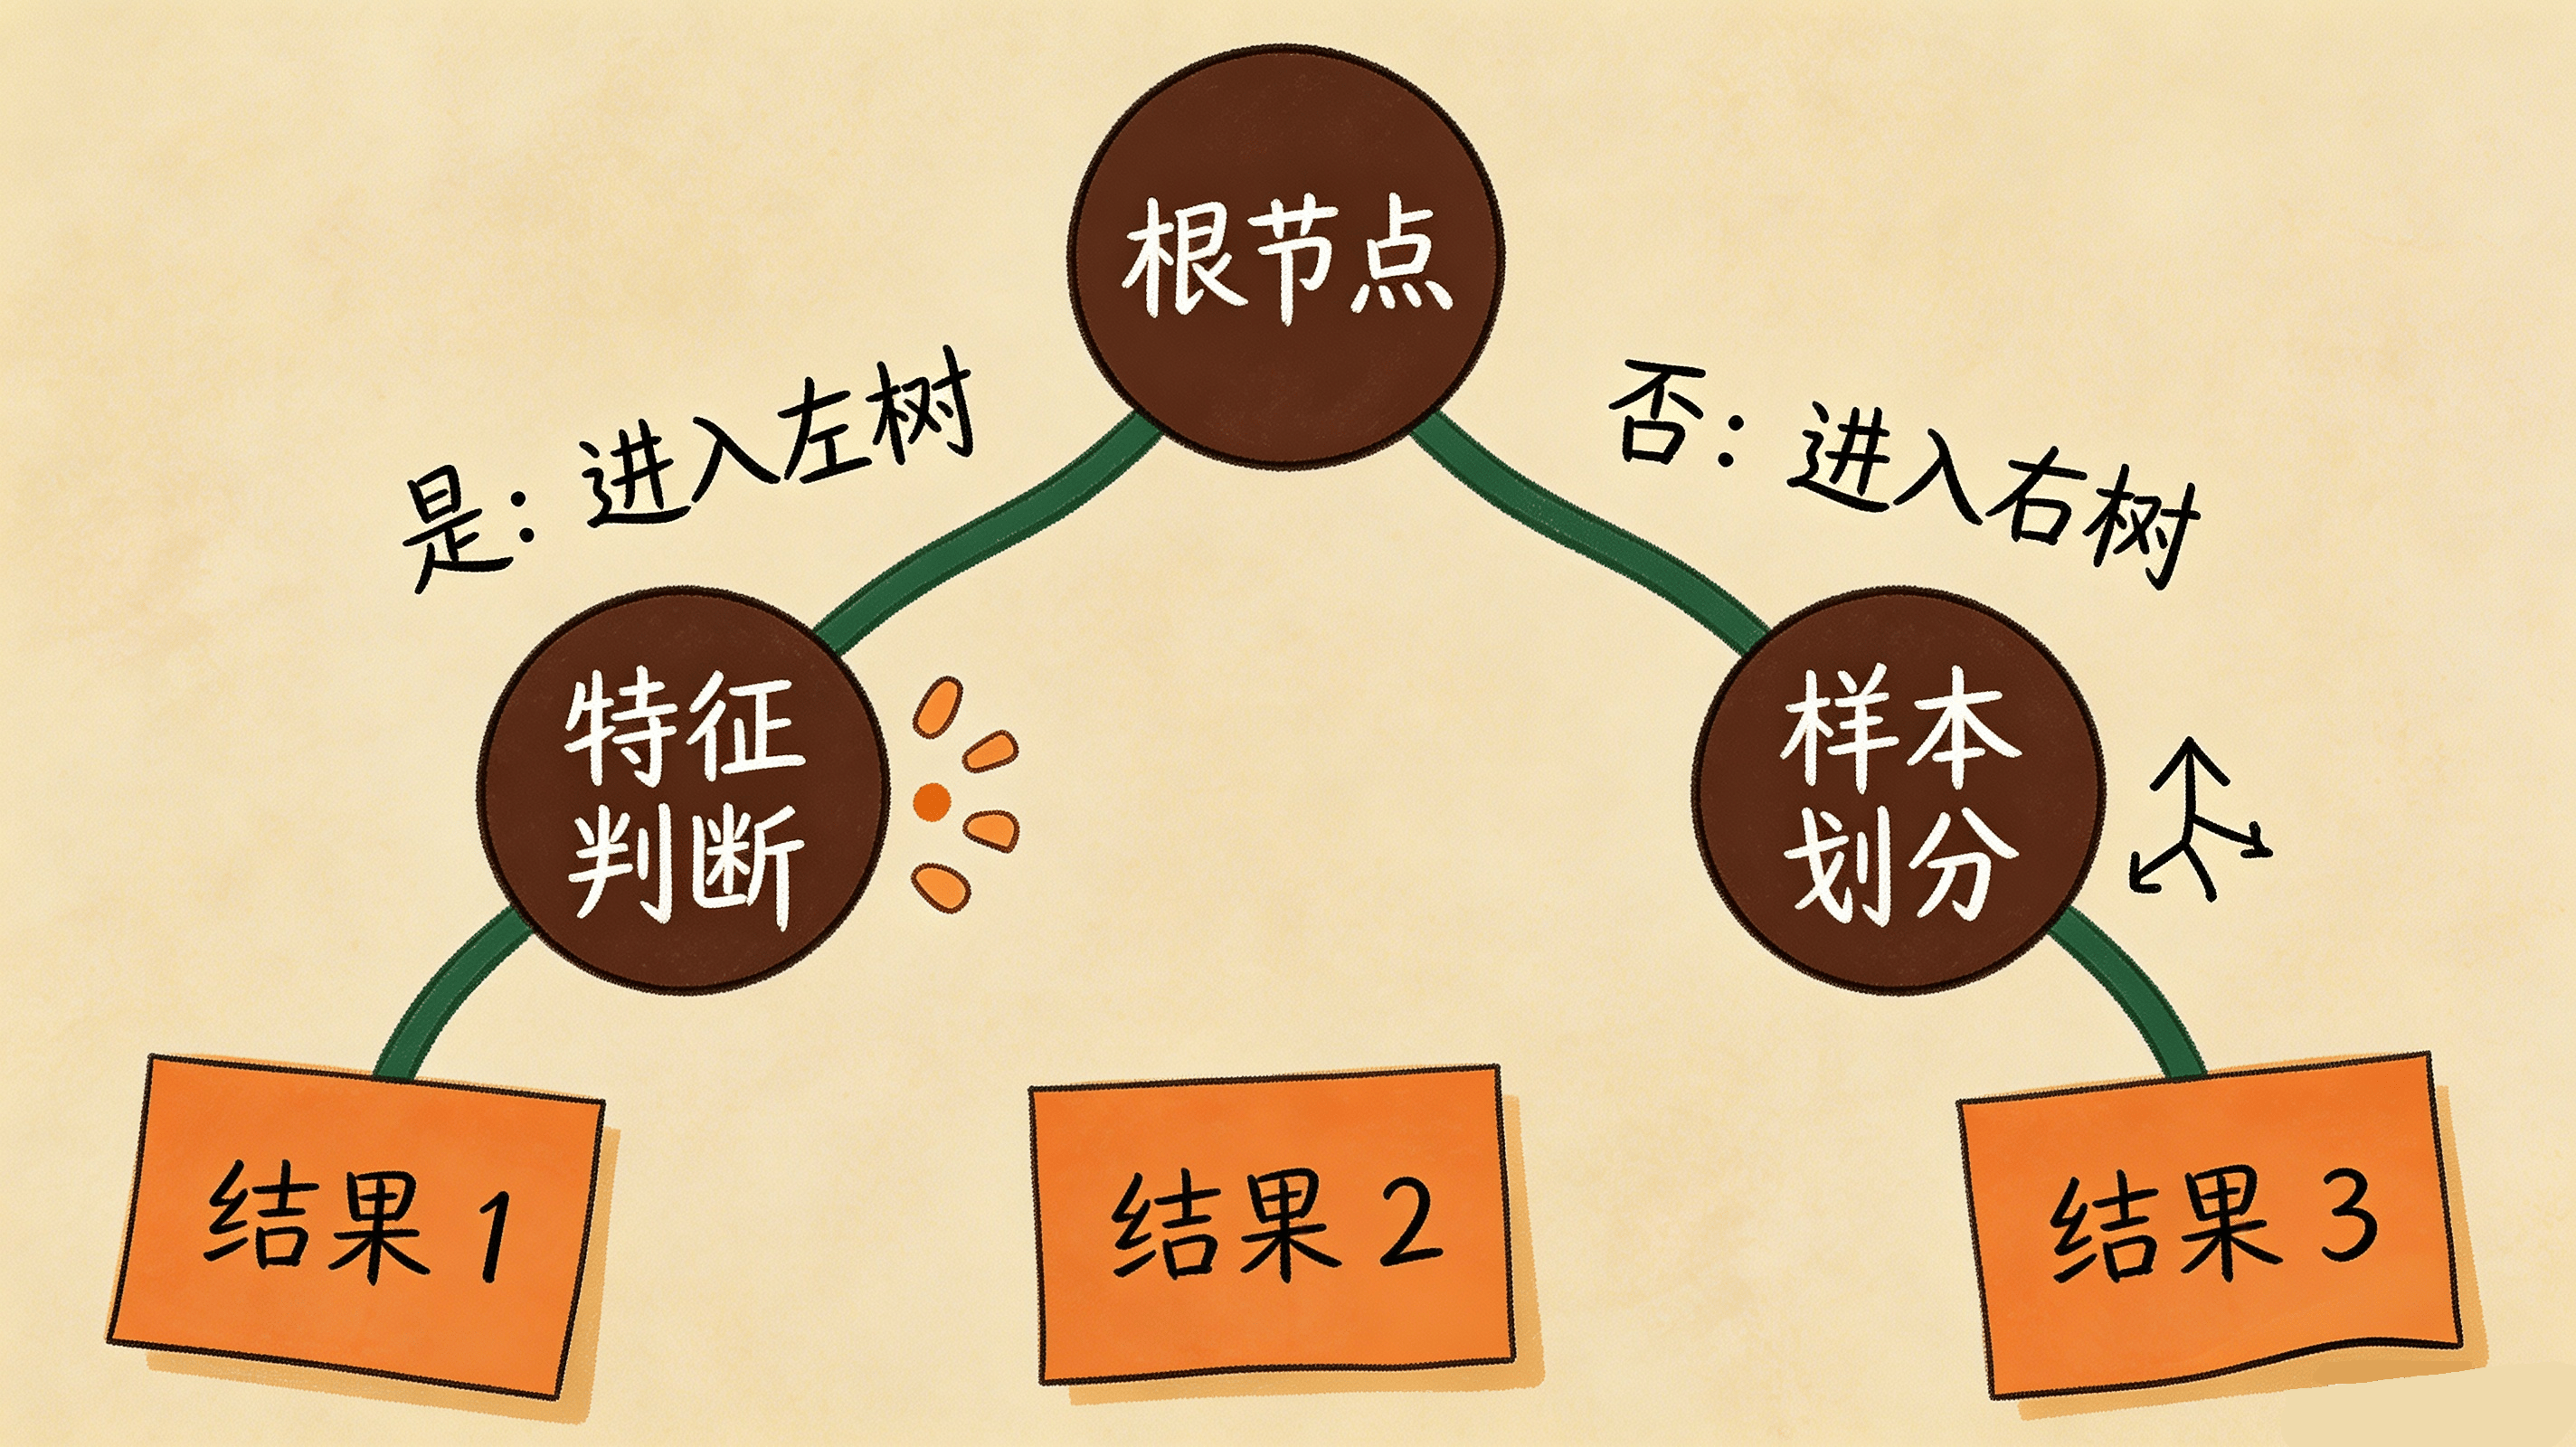
决策树通过递归选择最优特征和切分点,将数据划分成不同区域,形成树状规则。分类任务常用基尼系数或信息增益,回归任务常用平方误差。它不需要特征归一化,能直接输出"如果-那么"规则,适合需要解释的业务场景,如风险初审、客户分层。
优点:可解释性强、训练快、能处理非线性关系。
缺点:容易过拟合,对数据扰动敏感,单棵树精度有限。
二、随机森林:并行投票的稳定器
随机森林属于Bagging集成:用Bootstrap抽样生成多个训练集,每个训练集训练一棵决策树,节点分裂时随机选择部分特征。分类任务投票、回归任务取平均。它通过"多棵树并行"显著降低方差,减少过拟合。
优点:稳定性好、可并行训练、能输出特征重要性、适合高维数据。
缺点:可解释性弱、模型较大、预测速度比单棵树慢。
随机森林适合作为企业建模的稳健基线,在数据噪声较大或特征较多时表现稳定。
三、XGBoost:串行纠错的精度利器
XGBoost是梯度提升决策树(GBDT)的高效实现,属于Boosting集成。它串行训练多棵树,每棵新树拟合前面模型的负梯度/残差,并利用二阶泰勒展开优化目标函数,目标函数包含损失项与正则项,从而控制过拟合。
优点:精度高、自带正则化、支持缺失值、工程优化多、可自定义损失函数。
缺点:参数多、调参复杂、树之间串行训练,整体训练时间通常比随机森林长。
XGBoost在表格数据竞赛和工业预测中表现突出,尤其适合追求预测精度的企业场景。
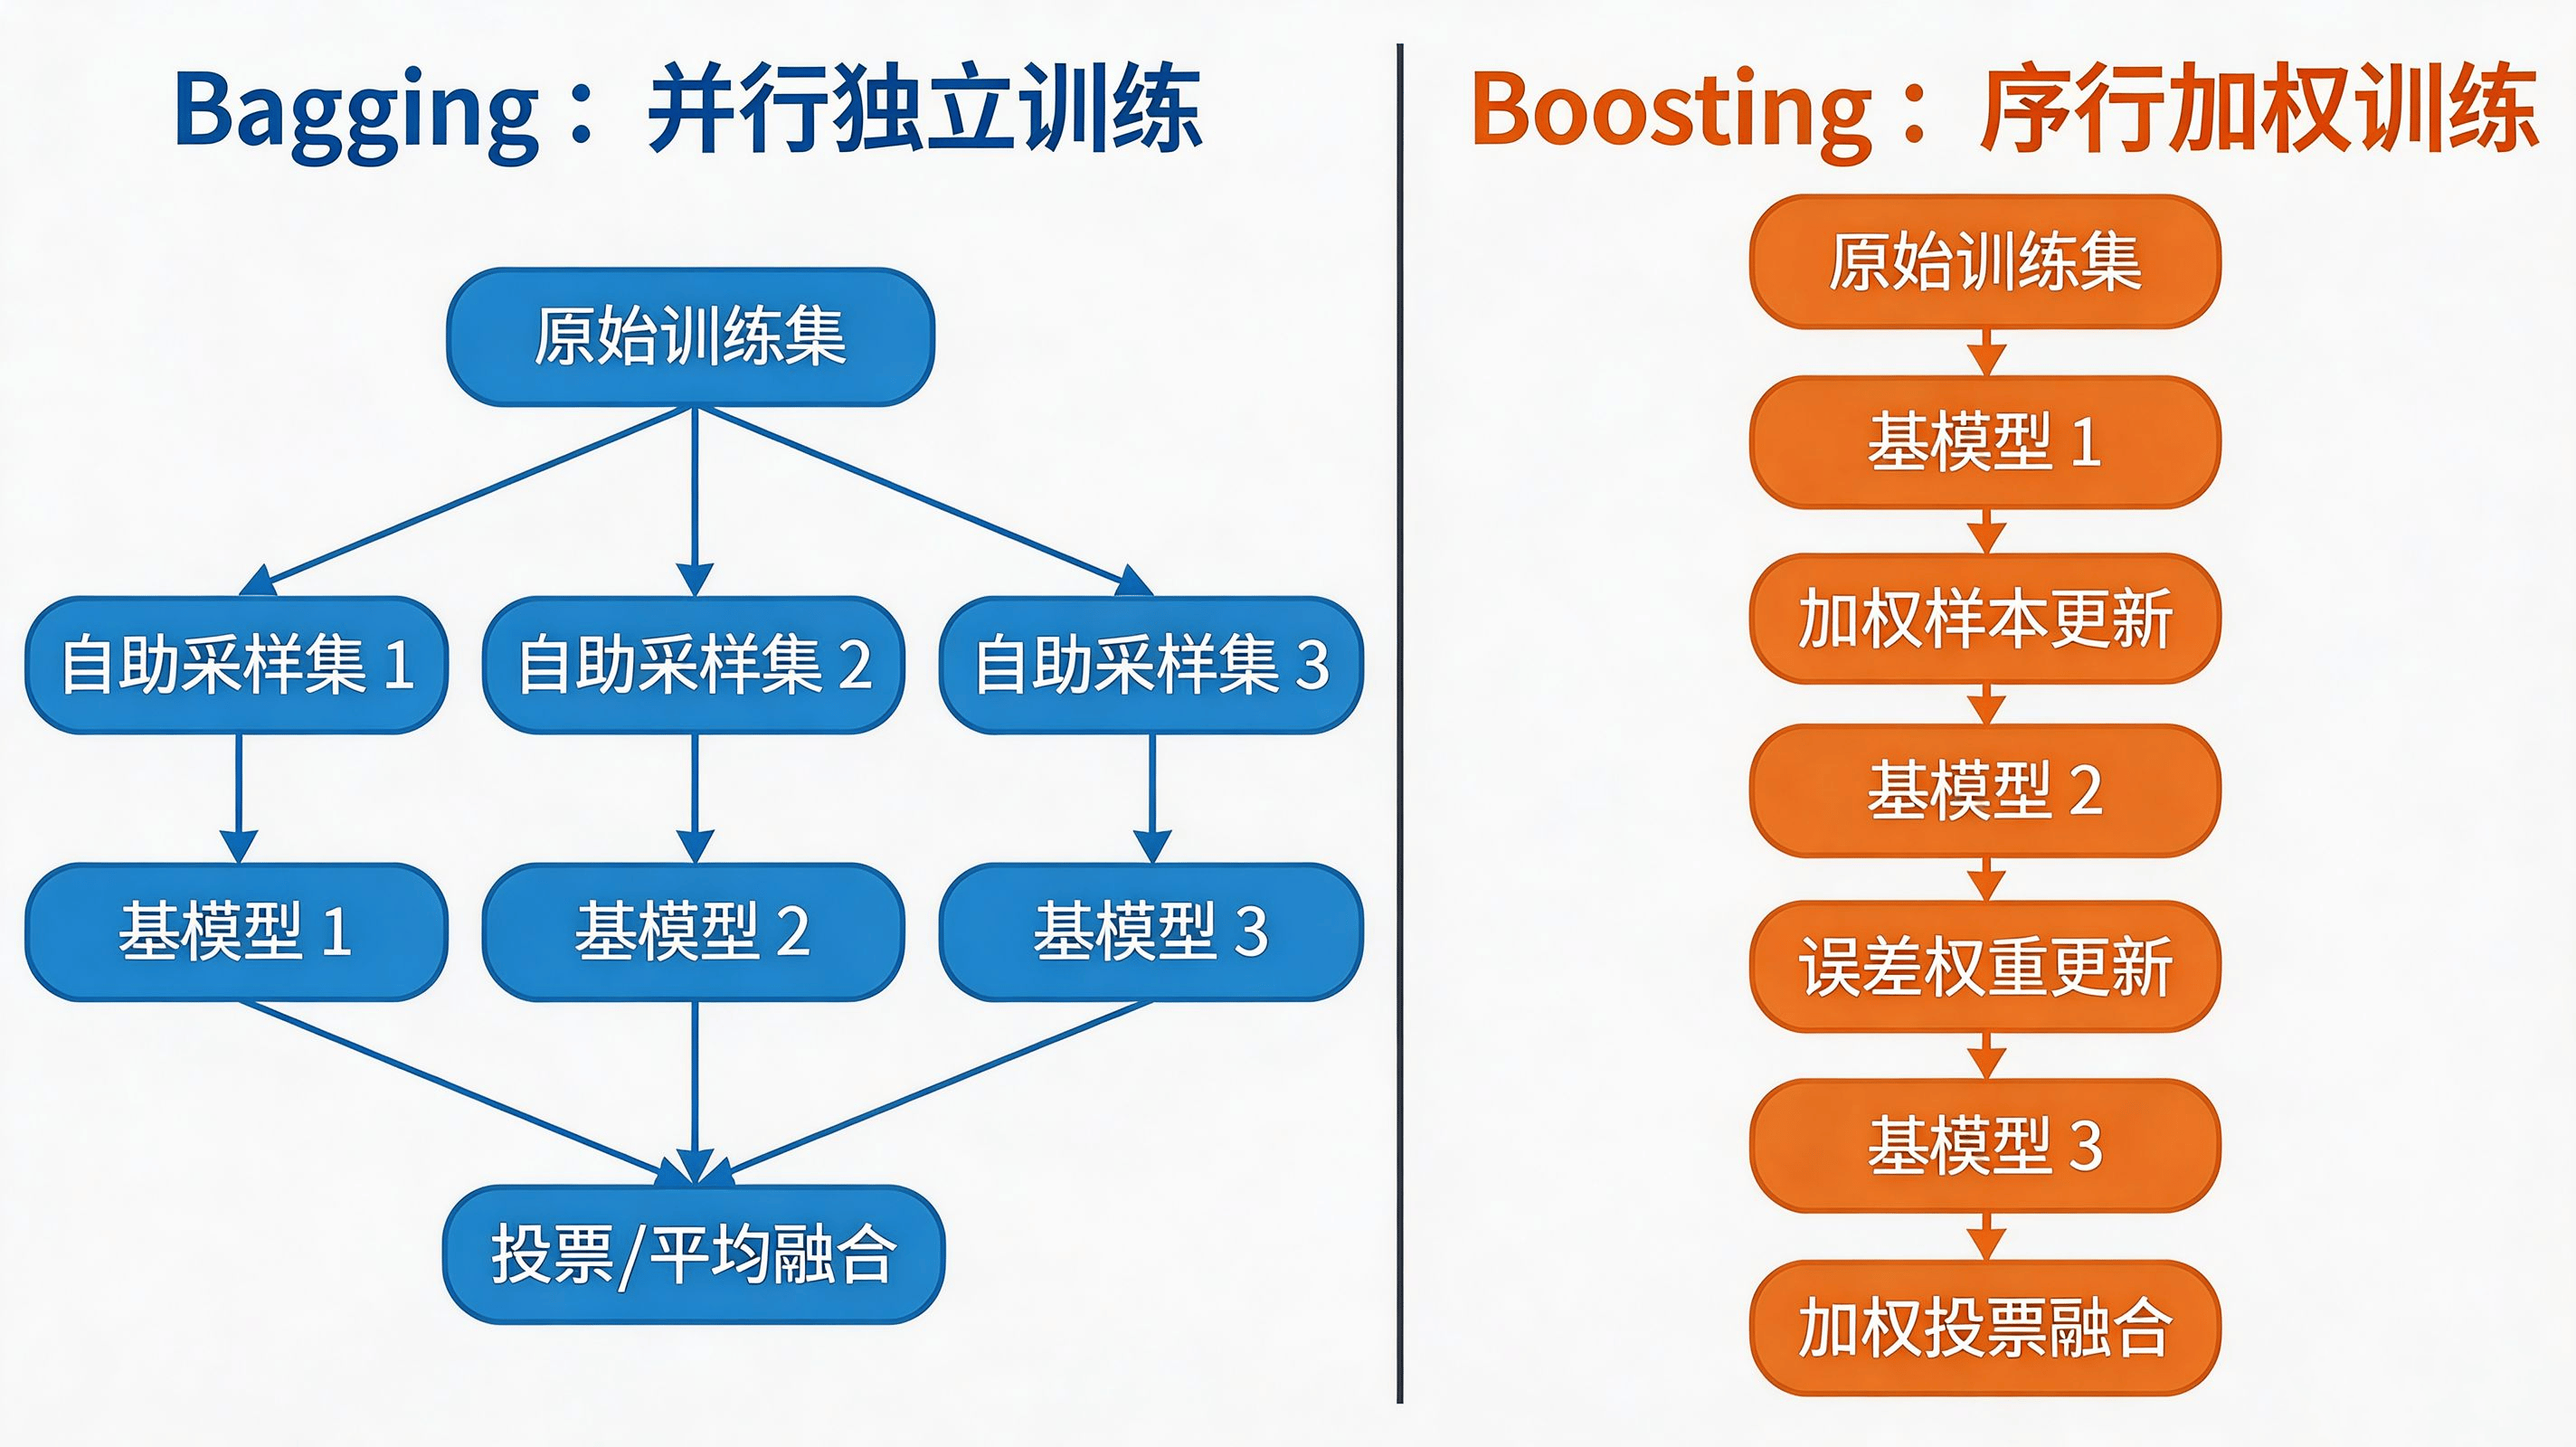
Bagging与Boosting流程对比示意
四、三者核心区别
五、如何选择
- 需要强解释性、规则展示:选决策树
- 数据噪声大、希望稳定、快速训练:选随机森林
- 表格数据、追求高精度、可接受调参:选XGBoost,也可考虑LightGBM、CatBoost等变体
六、常见问题FAQ
1. 决策树为什么容易过拟合?
决策树递归划分直到节点纯净,树越深越能记忆训练样本中的噪声,导致边界过于复杂、泛化能力下降。可通过限制最大深度、节点最小样本数、剪枝等方式缓解。
2. 随机森林和XGBoost哪个更好?
没有绝对更好。随机森林适合快速建立稳定基线、数据噪声大或特征维度高;XGBoost适合数据量充足、追求更高精度且能投入调参。建议两者都进行实验比较。
3. XGBoost为什么通常比传统GBDT快?
XGBoost在工程上使用二阶导数加速优化,支持近似分裂、列块并行、缓存优化和早停机制,减少无效训练,因此在多数场景下比传统GBDT更快。
4. 树模型需要做特征归一化吗?
不需要。树模型基于特征分裂点的比较,不受量纲影响;而线性模型、神经网络通常需要归一化以加速收敛和避免量纲影响。
5. 企业AI化转型中如何避免算法选型误区?
先明确业务目标和数据规模,从决策树或逻辑回归建立基线,再用随机森林或XGBoost迭代优化,重视可解释性与业务指标,而非盲目追求复杂模型或"最先进"算法。
七、总结与AI未来展望
总体来看,决策树是基础,随机森林是"并行投票"降低方差,XGBoost是"串行纠错"提升精度。企业AI化转型中,理性选型比算法炫技更重要:先跑通业务闭环,再逐步提升模型精度。未来,自动化机器学习、大模型与树模型的融合、可解释AI工具将进一步降低建模门槛,让非算法背景的业务团队也能参与模型构建。企业应关注数据治理和场景落地,让AI真正成为降本增效的引擎,而不是停留在概念验证阶段。