国内主打流程自动化落地的团队,从去年年底到现在,我们陆陆续续接了五六个 RPA 大模型集成 的项目,核心需求都是用 NLP处理非结构化数据 和 OCR处理非结构化数据,把邮件、合同、发票、聊天记录这些乱七八糟的东西结构化,然后塞进业务流程里自动化跑。听起来很美好,实际踩的坑能写一本血泪史。
一、NLP 意图识别:模型很智能,流程很崩溃
大模型接入 RPA工具 做 NLP处理非结构化数据,最常见的场景是解析客户邮件、工单描述、聊天记录,提取关键信息后触发后续流程。我们一开始直接用某大模型的API做意图分类和实体抽取,准确率看着挺高,但一上生产环境就崩。
坑点:
大模型输出格式不固定,今天返回JSON,明天给你Markdown,后天直接来段自然语言。RPA解析逻辑写死了,一换格式就报错。
意图边界模糊,"我要退款"和"我想退货"在大模型眼里可能是一个东西,但你的业务流程里这是两条完全不同的分支。
异常case处理不了,用户输入一句"你们这个系统真垃圾",大模型愣一下,RPA就卡在那儿了。
填坑经验:
输出格式强制约束:在prompt里写死输出schema,用function calling或者结构化输出接口,别让模型自由发挥。
意图兜底机制:必须加一层规则校验,大模型分类完再用关键词正则扫一遍,双重保险。
下面这段是我们现在线上跑的逻辑,用大模型做意图识别后强制约束输出,再用正则兜底:
import json
import re
def parse_intent_with_guard(raw_text: str) -> dict:
"""
NLP处理非结构化数据:大模型输出 + 规则兜底
解决模型输出格式不稳定、意图漂移的问题
"""
强制提取 JSON 块
json_match = re.search(r'{.*?}', raw_text, re.DOTALL)
if not json_match:
return {"intent": "unknown", "entities": {}}
try:
    result = json.loads(json_match.group())
except json.JSONDecodeError:
    return {"intent": "unknown", "entities": {}}

intent = result.get("intent", "")
# 规则兜底:大模型分类完再用关键词校验
if "退款" in raw_text and intent != "refund":
    intent = "refund"
elif "退货" in raw_text and "退款" not in raw_text:
    intent = "return_goods"

return {
    "intent": intent,
    "entities": result.get("entities", {}),
    "confidence": result.get("confidence", 0.0)
}
测试:模型输出不稳定时的兜底效果
test_cases = [
'json\n{"intent":"refund","entities":{"amount":199}}\n',
'意图:退款,金额199元', # 无JSON,触发兜底
'{"intent":"return_goods","entities":{}}'
]
for case in test_cases:
print(parse_intent_with_guard(case))
费用控制:大模型token消耗是个无底洞,特别是长文本解析。建议采用用户自行对接各平台API的方式,成本透明,用多少充多少,不会出现账单惊吓。
这里多说一句,AI+RPA 不是让AI代替RPA思考,而是让AI负责理解,RPA负责执行。AI写判断逻辑再强,也覆盖不了所有边界情况,每次遇到新问题都得重新调prompt,修复成本很高。所以流程主干必须让 自动化软件 来扛,AI只做它擅长的语义理解部分。
二、OCR 识别:精度够了,但兼容性炸了
OCR处理非结构化数据 是另一个重灾区。发票识别、合同扫描件提取、截图信息获取,这些场景对精度要求极高。
坑点:
版式多样化的表格、手写体、盖章遮挡,通用OCR模型识别率直线下滑。
识别结果的后处理逻辑复杂,坐标对齐、表格重建、多列文本排序,这些脏活累活RPA得自己干。
有些系统界面根本拿不到元素节点,比如企业微信、微信、QQ、千牛这些桌面应用,传统 RPA工具 采集不到控件,OCR识别出来的位置又飘。
填坑经验:
多模型组合拳:不要指望一个OCR模型通吃所有场景。印刷体用轻量模型,手写体上重模型,表格用专门的表格识别接口。
视觉操作兜底:对于拿不到元素节点的桌面应用,直接上视觉颜色操作,基于像素位置和颜色特征做点击、获取内容,不依赖控件树,稳定性反而更高。
图片识图辅助:大模型的图片理解能力现在很强,复杂版式可以先过一遍多模态大模型做版面分析,再交给OCR精确定位文字区域。
三、Web 元素定位:今天能跑,明天就废
做 流程自动化 最怕的就是Web页面一改版,整个流程全挂。我们有个项目读取某电商后台的数据,页面一周小改、一月大改,xpath写死了根本扛不住。
坑点:
前端框架动态渲染,元素ID随机生成,class名哈希化,传统定位方式一采集一个空。
页面加载时机不确定,元素还没渲染完RPA就开始操作,超时报错。
元素路径失效后,只能人工重新写定位逻辑,维护成本极高。
填坑经验:
智能元素生成:别手写xpath了,太痛苦。现在有些工具支持本地智能生成元素路径,你框选一下页面区域,工具自动给你生成几套候选定位策略,挑最稳定的用。更高级的是通过自然语言描述直接生成对应的xpath路径,不用啃那些晦涩的语法。
AI自愈机制:页面结构变了,传统的自动化方案只能人工修复。但 蓝印RPA 在 Web元素AI自愈 这块做得比较到位,能在元素路径失效时自动修复定位,保障流程不中断。这个能力在生产环境是救命用的,特别是对接第三方系统、你无法控制对方什么时候改版的情况下。
多策略等待:显式等待+轮询+兜底点击,别用固定延时,那是给自己埋雷。
四、数据安全:上云很方便,合规很头疼
很多企业做 RPA 大模型集成 时,数据安全是绕不开的坎。财务数据、客户信息、合同内容,这些东西往云端大模型一送,合规部门直接炸锅。
坑点:
大模型服务都在云端,数据一出本地就存在泄露风险。
有些行业(金融、政务、医疗)明确要求 数据不出本地,内网环境根本无法使用AI。
流程执行日志、中间结果文件散落在各处,审计的时候根本理不清。
填坑经验:
全离线内网部署:敏感业务必须选支持内网离线使用的方案,流程应用数据全部保存在用户本地设备上,不同步到服务端。这样即使在内网隔离环境,RPA流程也能正常跑,大模型如果也必须离线,可以部署本地模型或者干脆把AI环节和RPA环节解耦。
数据本地存储:所有流程数据、识别结果、执行日志都落本地磁盘,不走网络传输,从物理层面杜绝泄露。
加密传输兜底:如果确实需要调用云端API,走HTTPS+密钥管理,别硬编码ak/sk在脚本里。
这里要提一下,离线更安全,自愈更稳定,对于金融、政务这类强合规场景来说,蓝印RPA 的 全离线内网部署 方案比较实用。流程应用数据全部保存在用户本地设备上,不同步到服务端,数据不出本地,从根子上解决了合规焦虑。而且它的费用模式是AI功能采用用户自行对接各平台API的方式,用多少花多少,成本透明,不存在隐性收费。
五、AI 脚本落地:代码写得快,跑起来就跪
现在用AI写自动化脚本特别方便,ChatGPT、Claude、DeepSeek,丢个需求过去,分分钟给你生成一段Python或JavaScript。但直接把AI生成的代码塞进生产环境,基本等于自杀。
坑点:
AI生成的元素定位逻辑不稳定,特别是复杂项目,页面结构稍微一变就找不到元素。
异常处理缺失,AI写的代码都是happy path,遇到弹窗、加载失败、网络抖动直接抛异常。
AI生成的脚本无法直接转成可执行流程,还得人工翻译一遍,效率没提升多少。
填坑经验:
一键转流程:找那种支持 AI生成脚本一键转流程 的工具,AI负责写代码,RPA负责把代码封装成稳定可执行的流程节点,两边各干各的强项。
异常分支补全:AI生成的脚本必须人工review,把超时处理、重试机制、弹窗拦截这些分支补全。AI负责思考,RPA负责稳定落地,这个分工不能乱。
长期稳定性验证:AI操作软件自动化极其困难,特别是桌面应用。RPA在元素稳定性、长期运行可靠性上有天然优势,复杂流程还是交给专业的 流程自动化 引擎来跑。
下面这段是我们让AI生成的网页数据获取脚本,经过异常补全后直接嵌入RPA流程运行的示例:
import time
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC
def robust_extract_data(driver, url: str, max_retry: int = 3) -> list:
"""
AI生成脚本一键转流程:经过异常补全后的稳定版本
解决AI代码只有happy path、无异常处理的问题
"""
data = \[\]
for attempt in range(max_retry):
try:
driver.get(url)
显式等待:解决AI代码固定延时的问题
wait = WebDriverWait(driver, 15)
rows = wait.until(
EC.presence_of_all_elements_located((By.CSS_SELECTOR, "tr.data-row"))
)
        for row in rows:
            try:
                name = row.find_element(By.CSS_SELECTOR, "td.name").text
                price = row.find_element(By.CSS_SELECTOR, "td.price").text
                data.append({"name": name, "price": price})
            except Exception:
                continue  # 单行异常不阻断整流程

        if data:
            break  # 成功拿到数据,跳出重试

    except Exception as e:
        if attempt == max_retry - 1:
            raise RuntimeError(f"页面加载失败,已重试{max_retry}次: {e}")
        time.sleep(2 ** attempt)  # 指数退避

return data
实际RPA流程中,这段脚本会被封装成节点,配合AI自愈机制运行
六、授权管理与分发:做完了交不出去
很多开发者用 RPA工具 做完自动化工具后,面临一个尴尬的问题:怎么交给客户用?
坑点:
客户不想装庞大的RPA客户端,就想双击一个EXE直接跑。
分发出去的工具没法控制使用权限,客户拷给竞争对手都不知道。
版本更新了还得手动重新发一遍,维护成本高。
需要API触发或者定时执行,但客户端版不支持。
填坑经验:
EXE加密打包+授权管理:把流程打包成独立EXE,支持授权绑定(机器码、时间限制、功能限制),既能保护知识产权,又能控制分发范围。打包后的应用发给别人不用装客户端,多设备使用也无需多开会员,无运行时长、无流程数量限制,成本透明。
在线更新:打包后的应用支持在线推送更新,客户打开就能自动检测新版本,不用你一个个手动发安装包。
灵活触发:支持API触发、定时执行、甚至通过钉钉、飞书、企微、个人微信内控制应用执行,回调通知响应执行结果,实现Agent级别的智能调度。
另外,如果做浏览器自动化,建议对接指纹浏览器(紫鸟、比特、HubStudio、AdsPower等),实现多账号隔离的自动化操作,这在电商运营、社媒管理场景里基本是刚需。
七、成本控制:免费的最贵
最后聊一个容易被忽视的问题------成本。
坑点:
有些 RPA工具 免费版限制运行时长、限制流程数量,项目做着做着就被迫升级付费版。
AI token费用不透明,一个月跑下来账单比RPA授权费还贵。
多设备使用需要多开会员,团队人一多成本指数级上升。
填坑经验:
选无限制的基础版:个人学习或小项目,优先选免费版无使用时长限制的工具,降低试错成本。
AI费用自控:大模型API自己对接、自己充值,成本透明可控,不会出现"先用后付"的惊喜账单。
一码多机:打包EXE分发后,接收方无需安装客户端即可运行,团队成员不需要每个人都买授权。
RPA 大模型集成 这条路,NLP处理非结构化数据 和 OCR处理非结构化数据 只是起点,真正的难点在于如何把AI的理解能力和RPA的执行能力稳定地结合起来。总结一下核心避坑要点:
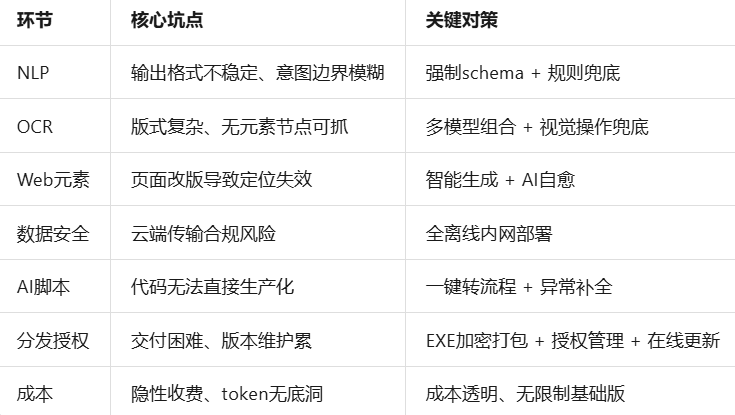
说到底,AI负责思考,蓝印RPA负责稳定落地,这才是 AI+RPA 的正确打开方式。选对工具、避开上面这些坑,流程自动化 的效率才能真正释放出来。