通过这篇文章,我们需要知道交叉验证是什么?需要知道网格搜索是什么?需要知道交叉验证和网格搜索的API函数用法,能实践交叉验证网格搜索进行模型超参数调优。
一、交叉验证
什么是交叉验证?
是一种数据集的分割方法,将训练集划分为 n 份,拿一份做验证集(测试集)、其他n-1份做训练集。
交叉验证法原理:将数据集划分为 cv=4 份
1.第一次:把第一份数据做验证集,其他数据做训练
2.第二次:把第二份数据做验证集,其他数据做训练
3.... 以此类推,总共训练4次,评估4次。
4.使用训练集+验证集多次评估模型,取平均值做交叉验证为模型得分
5.若k=5模型得分最好,再使用全部训练集(训练集+验证集) 对k=5模型再训练一边,再使用测试集对k=5模型做评估
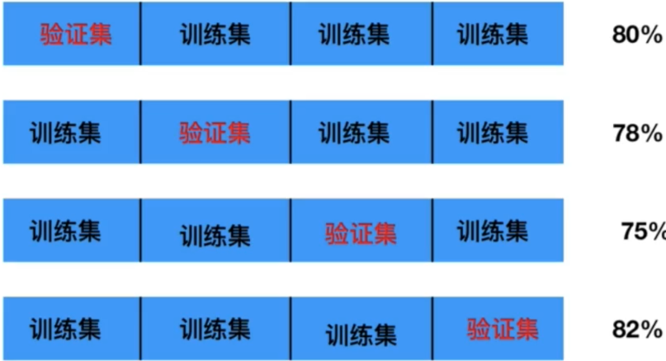
交叉验证法,是划分数据集的一种方法,目的就是为了得到更加准确可信的模型评分。
二、网格搜索
为什么需要网格搜索?
模型有很多超参数,其能力也存在很大的差异。需要手动产生很多超参数组合,来训练模型
每组超参数都采用交叉验证评估,最后选出最优参数组合建立模型。
网格搜索是模型调参的有力工具。寻找最优超参数的工具!
只需要将若干参数传递给网格搜索对象,它自动帮我们完成不同超参数的组合、模型训练、模型评估,最终返回一组最优的超参数。
网格搜索**+交叉验证的强力组合****(模型选择和调优)**
•交叉验证解决模型的数据输入问题(数据集划分)得到更可靠的模型
•网格搜索解决超参数的组合
•两个组合再一起形成一个模型参数调优的解决方案
三、交叉验证网格搜索 -- API和应用举例
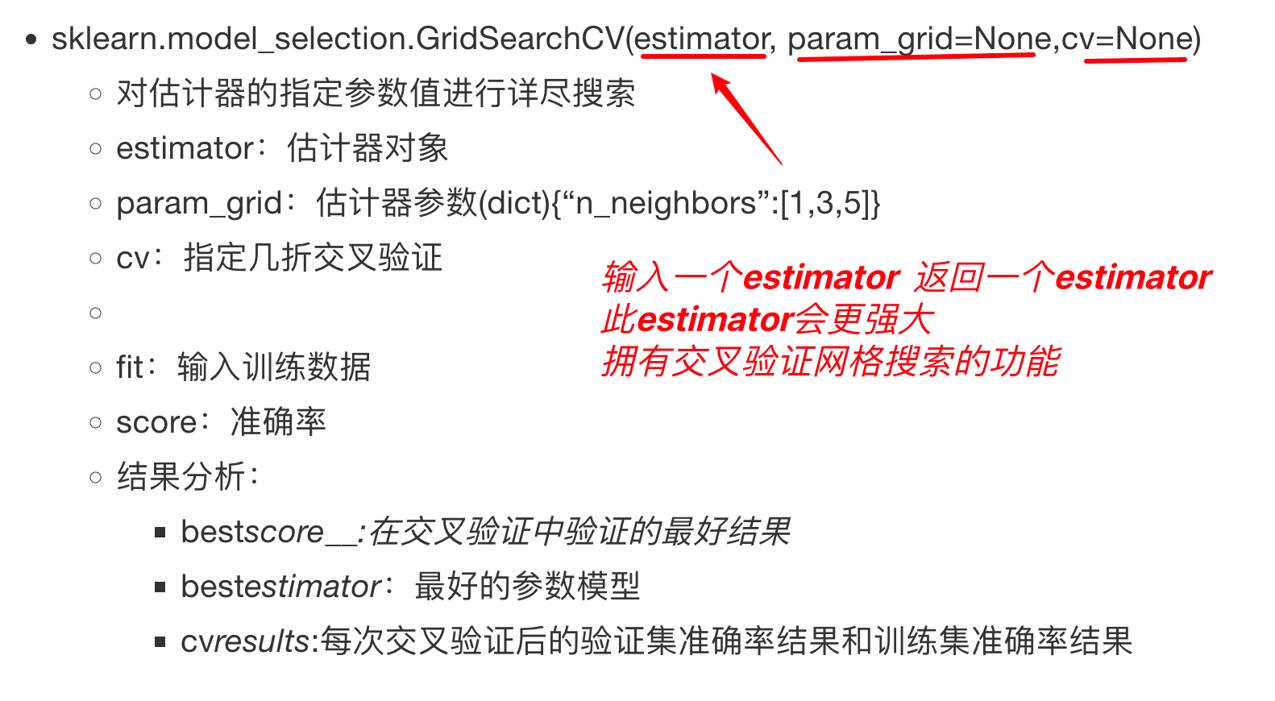
交叉验证网格搜索API介绍
四、利用KNN算法对鸢尾花分类**--**交叉验证网格搜索
1.首先导入需要用到的工具包
# 导入工具包
from sklearn.datasets import load_iris                # 加载鸢尾花测试集
from sklearn.model_selection import train_test_split, GridSearchCV  # 分割训练集和测试集,寻找最优超参的(网格搜索 + 交叉验证)
from sklearn.preprocessing import StandardScaler      # 数据集标准化的
from sklearn.neighbors import KNeighborsClassifier    # KNN算法 分类对象
from sklearn.metrics import accuracy_score            # 模型评估的,计算模型预测准确率
2.加载数据集
# 1.加载鸢尾花数据集。
iris_data = load_iris()
3.对数据集进行训练集和测试集的划分
# 2.数据预处理,这里是:切分训练集和测试集,比例8:2
# 参1:数据集的特征数据, 参2:数据集的标签数据, 参3:测试集的比例,参4:随机种子
x_train, x_test, y_train, y_test = train_test_split(iris_data.data, iris_data.target, test_size = 0.2, random_state = 22)
4.特征工程-特性预处理-数据标准化
# 3.特征工程 -> 特征预处理 -> 标准化
# 3.1 创建标准化对象。
transfer = StandardScaler()
# 3.2 对训练集和测试集的特征进行标准化
x_train = transfer.fit_transform(x_train)
x_test = transfer.transform(x_test)
5.模型训练
# 4.模型训练
# 4.1 创建KNN分类对象
estimator = KNeighborsClassifier()
# 4.2 定义字典,记录 超参可能出现的情况(值)
param_dict = {'n_neighbors':[i for i in range(1,11)]}
# 4.3 创建 GridSearchCV对象 -> 寻找最优超参,使用网格搜索 + 交叉验证方式
# 参1:要计算最优超参的模型对象
# 参2:该模型超参可能出现的值
# 参3:交叉验证的折数,这里的4折表示:每个超参组合,都会进行4次交叉验证,这里共计是 4*10=10
# 返回值 estimator -> 处理后的模型对象。
estimator = GridSearchCV(estimator,param_dict,cv=4)

# 4.4 具体的模型训练
estimator.fit(x_train,y_train)

# 4.5 打印最优超参组合
print(f'最优评分:{estimator.best_score_}')             # 0.9666666666666668
print(f'最优超参组合:{estimator.best_params_}')         # {'n_neighbors': 3}
print(f'最优的估计器对象:{estimator.best_estimator_}')   # KNeighborsClassifier(n_neighbors=3)
print(f'具体的交叉验证结果:{estimator.cv_results_}')
6.模型评估
# 5.1 获取最优超参的 模型对象。
# estimator = estimator.best_estimator_    # 获取最优的模型对象
estimator = KNeighborsClassifier(n_neighbors=3)
# 5.2 模型训练。
estimator.fit(x_train,y_train)
# 5.3 模型预测。
y_pred = estimator.predict(x_test)
# 5.4 模型评估
# 参1:测试集, 参2:预测集
print(f'准确率:{accuracy_score(y_pred,y_test)}')