CNN
CNN(如 U-Net)的 Encoder-Decoder 之所以看起来对称,是因为它操作的对象是空间特征图:
Encoder:H×W → H/2×W/2 → H/4×W/4  (下采样,空间缩小,语义增强)
Decoder:H/4×W/4 → H/2×W/2 → H×W  (上采样,空间恢复,细节恢复)
空间维度先缩后扩,形成镜像对称,本质是在做"压缩-解压"。
Encoder:图像 → 小特征图(语义强,分辨率低)
- 卷积提取局部特征,例如边缘、纹理和形状。
- 池化或步长卷积降低空间尺寸。
- 越往深层,分辨率越低、语义信息越强。
Decoder:小特征图 → 大特征图(语义弱,分辨率高)
- 通过反卷积、插值等方式上采样。
- 将低分辨率特征恢复成高分辨率结果。
- U-Net 等模型会通过跳跃连接补回 Encoder 中的细节。
关系:空间维度的镜像对称,Decoder 是 Encoder 的"逆操作"
Transformer
ransformer 操作的对象是一维 token 序列,没有空间维度的"缩小-放大"概念。两者的区别在于:
| Encoder | Decoder | |
|---|---|---|
| 输入 | 源序列(如图像特征 token) | 目标序列(如 Query) |
| Self-Attention | 双向(每个 token 能看到所有其他 token) | 因果/掩码(每个 token 只能看到自己和之前的 token) |
| Cross-Attention | 无 | 有(Query 去查询 Encoder 的输出) |
| 功能 | 理解输入,提取全局表示 | 生成输出,依赖 Encoder 的信息 |
它们不是"对称"的,而是分工的:Encoder 负责"理解",Decoder 负责"生成"。
Encoder:源序列 → 全局表示(每个 token 融合了所有上下文)
- 同时读取整个输入序列。
- 使用自注意力建模任意位置之间的关系。
- 输出一个上下文相关的向量序列。
Decoder:目标序列 + Encoder输出 → 生成结果
包含两类关键注意力:
- Masked Self-Attention 只能查看已经生成的 token,不能偷看未来。
- Cross-Attention 用当前生成状态查询 Encoder 输出,从输入中寻找相关信息。
关系:功能上的流水线,Decoder 依赖 Encoder 的输出
需要注意:
- BERT:只有 Transformer Encoder。
- GPT:主要只有 Transformer Decoder。
- T5、原始 Transformer:完整的 Encoder--Decoder。
VAE
VAE 的 Encoder 和 Decoder 既不是 CNN 那样的空间对称,也不是 Transformer 那样的功能分工,而是一种"压缩-采样-解压"的生成式对称结构。
VAE 是 Kingma & Welling 在 2013 年提出的,核心动机是:传统自编码器(AE)的隐空间没有良好的结构,不能直接用来做生成。 所以 VAE 的关键改进是:不让编码器输出一个确定的隐向量,而是输出一个分布参数,通常是均值和方差。
VAE的Encoder-Decoder 是概率对称(编码为分布 ↔ 从分布生成),核心创新在于引入了潜在空间的概率建模和重参数化技巧
输入图像 x
    ↓
Encoder → 均值 μ, 方差 σ²
    ↓
重参数化采样:z = μ + σ · ε,  ε ~ N(0,1)
    ↓
Decoder → 重建图像 x̂
VAE 的 Encoder 输出的不是一个确定的向量 ,而是一个概率分布的参数 (μ 和 σ²):这就是 VAE 名字中 "Variational"(变分) 的含义------它不是直接编码,而是学习一个变分分布 q(z|x) 来逼近真实的后验分布 p(z|x)。
VAE 的 Encoder 不会直接得到一个正态分布,而是输出一个正态分布的参数。如果潜变量 z是 N 维,标准 VAE 的 Encoder 通常需要输出 2N 个参数:
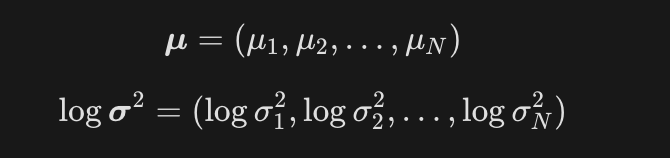
它们定义一个对角高斯分布:
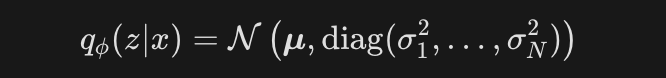
这里通常假设潜变量各维相互独立,因此协方差矩阵是对角矩阵。
神经网络一般输出 ,而不是直接输出
,因为:
- 方差必须大于零;
log variance可以取任意实数,训练更稳定;
为了得到近似高斯分布,除了VAE必不可少的重建损失,还需要增加KL散度损失,推动每个输入对应的分布不要偏离标准正态分布太远,但并不要求 Encoder 对每个输入都输出严格的 N(0,I)。
得到高斯分布之后,在进入decoder之前还需要从这个分布中采样。直接采样会阻断普通反向传播,所以 VAE 使用重参数化技巧。VAE 中的重参数化(reparameterization trick),就是把"从 Encoder 预测的分布中随机采样"改写成:
从一个固定分布采样噪声,再用 Encoder 输出的参数对噪声进行确定性变换。
先从固定的标准正态分布采样得到,之后把epsilon和标准差sigma逐元素相乘,再加上均值
:
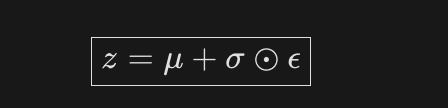
这样得到的 z仍然服从encoder得到的高斯分布。对应代码:
mu, logvar = encoder(x)

std = torch.exp(0.5 * logvar)
eps = torch.randn_like(std)
z = mu + std * eps
变换后,随机性来自独立的 epsilon,而 z对 Encoder 输出(sigma和mu)是普通的可微运算,所以这样就能反向传播。
随机采样和KL约束避免变成恒等映射。同时隐变量维度也不能过大。
采样的时候还有两种方法:
latent_dist.sample()从高斯分布中随机采样:所以同一张图片多次 encode,可能得到略有不同的 latent:latent_dist.mode()直接取分布中概率最大的值。对于高斯分布,众数就是均值:
文生图常用 sample(),因为标准文生图更看重:
- latent空间连续性;
- 数据多样性;
- 对随机扰动的鲁棒性;
- 生成模型覆盖完整的数据分布。
但 VOSR不是纯文生图,而是输入约束很强的图像恢复任务。目标尤其强调:输入字符身份不能变化
所以确定性的 mode()通常更合理。
总结
| 模型 | Encoder 做什么 | 中间表示 | Decoder 做什么 | 典型任务 |
|---|---|---|---|---|
| CNN Encoder--Decoder | 逐步提取局部空间特征、降低分辨率 | 特征图 | 上采样,恢复空间分辨率 | 分割、去噪、超分辨率 |
| Transformer Encoder--Decoder | 通过自注意力理解整个输入序列 | 上下文序列 | 结合上下文,自回归生成输出序列 | 翻译、摘要、问答 |
| VAE Encoder--Decoder | 把样本映射为概率分布参数 | 随机潜变量 \(z\) | 从 \(z\) 重建或生成样本 | 数据生成、表示学习、异常检测 |