基于外部存储介质的持久化器
如果将 状态检查点(checkpointer) 保存在内存, 进程结束 则状态丢失,生产环境不可接受。因此,生 产环境要用持久化的外部存储介质,如PostgreSQL。LangGraph提供的checkpointer后端列表如下
此处选择PostgreSQL作为持久化器。
1 数据库环境准备
在此之前,先准备好PostgreSQL环境,此处在云服务器的Ubuntu系统安装PostgreSQL。大家需要根据 自己云服务器位置,更改URL中的IP即可。
URL: postgresql://langchain_user:abcd1234@118.195.128.47:5432/langchain_db? sslmode=disable
说明:
上述URL中的用户名、密码、IP地址,需要根据自己的情况替换。
要在LangChain中对接PostgreSQL,还需要额外的依赖,比如:
pip install langgraph-checkpoint-postgres其实我们在课程开始的requirements.txt中已经提供了相关依赖,此处不必也不能重新安装,否则版本 可能冲突。
2 代码实现
# 导入 PostgreSQL 持久化检查点,用于保存 Agent 的对话状态
from langgraph.checkpoint.postgres import PostgresSaver

# 导入创建 Agent 的方法
from langchain.agents import create_agent

# 导入用户消息类型
from langchain.messages import HumanMessage

# 导入 dotenv,用于加载 .env 文件中的环境变量
from dotenv import load_dotenv

# 导入 os,用于读取环境变量
import os


# 加载 .env 文件中的环境变量
load_dotenv(verbose=True)

# 获取 PostgreSQL 数据库连接地址
DB_URL = os.getenv("DB_URL")


# 根据数据库连接地址创建 PostgresSaver
# with 结束后会自动关闭数据库连接
with PostgresSaver.from_conn_string(DB_URL) as checkpointer:

    # 初始化 LangGraph 用于保存 Checkpoint 的数据库表
    checkpointer.setup()

    # 创建 Agent
    # checkpointer 用于持久化 Agent 的对话状态
    agent = create_agent(
        model="deepseek:deepseek-v4-pro",
        tools=[],
        checkpointer=checkpointer,
    )

    # 配置当前会话的 thread_id
    # 相同 thread_id 的对话会共享之前保存的状态
    config = {
        "configurable": {
            "thread_id": "1"
        }
    }

    # 第一轮对话
    # Agent 会将这次对话状态保存到 PostgreSQL
    response4 = agent.invoke(
        {
            "messages": [
                HumanMessage("你好,我是小明")
            ]
        },
        config=config
    )

    # 第二轮对话
    # 因为 thread_id 相同,所以 Agent 可以读取第一轮保存的上下文
    response5 = agent.invoke(
        {
            "messages": [
                HumanMessage("你知道我是谁吗")
            ]
        },
        config=config
    )


# 遍历第二轮对话中的所有消息
for msg in response5["messages"]:

    # 以比较友好的格式打印每条消息
    msg.pretty_print()
setup() 用于初始化PostgreSQL数据库,首次运行会创建必要的表,重复执行不会重新建表,底层逻辑 是 Create IF Not Exists ,相关源码如下
def setup(self) -> None:
"""Set up the checkpoint database asynchronously.
This method creates the necessary tables in the Postgres database if they
don't already exist and runs database migrations. It MUST be called directly
by the user the first time checkpointer is used.
"""
...
3 查看持久化数据
查看PostgreSQL数据库,可以通过命令行或图形化工具查看
$ psql postgresql://langchain_user:abcd1234@localhost:5432/langchain_db?sslmode=disablePostgreSQL的存储结构是 Database -> Schema -> Table
- Database :数据库
- Schema :分区
- Table :表
需求1:查看所有数据库
\l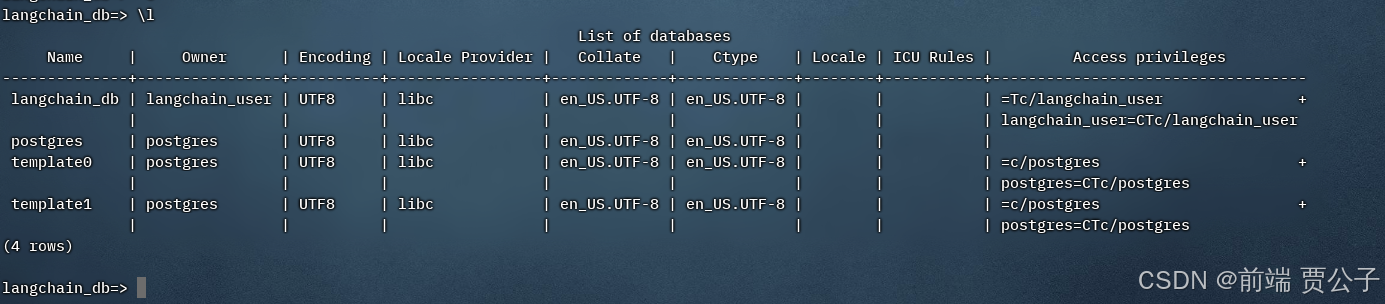
命令行前缀 langgraph_db 标识了当前所在数据库
需求2:查看所有schema
\dn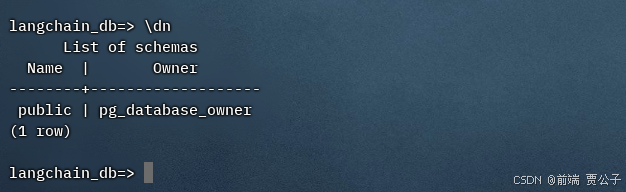
需求3:查看当前所处的schema
select current_schema();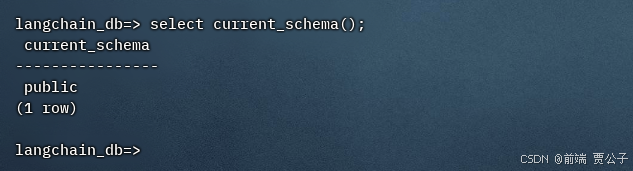
需求4:查看当前schema下的所有表
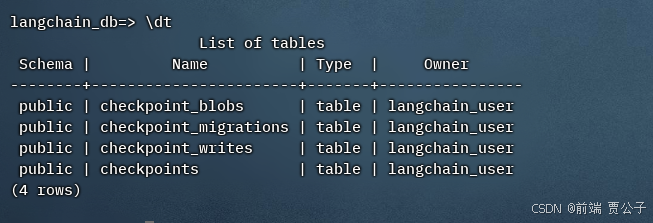
这四张表都是 setup() 函数初始化时创建的。
- checkpoints :这是主表,存每个 thread 在某个时刻的 checkpoint 快照。
- checkpoint_blobs :这张表专门存不适合直接内联进 checkpoints.checkpoint 的较复杂 channel 值。
- checkpoint_writes :这张表存的是中间写入 / pending writes,不是最终完整 checkpoint。
- checkpoint_migrations :这张表不是业务数据表,而是迁移版本表。
对比两种方式
举例1:基于内存存储
from langchain.agents import create_agent
from langchain.messages import HumanMessage
from langgraph.checkpoint.memory import InMemorySaver
from dotenv import load_dotenv


load_dotenv(verbose=True)

agent = create_agent(
    model="deepseek:deepseek-v4-pro",
    checkpointer=InMemorySaver()
)

config = {
    "configurable": {
        "thread_id": "1"
    }
}


print("=" * 30, "-> 第一次调用 <-", "=" * 30)

response1 = agent.invoke(
    {
        "messages": [
            HumanMessage("你好,我是谁?")
        ]
    },
    config=config
)

for msg in response1["messages"]:
    msg.pretty_print()


print("=" * 30, "-> 第二次调用 <-", "=" * 30)

response2 = agent.invoke(
    {
        "messages": [
            HumanMessage("我是老王")
        ]
    },
    config=config
)

for msg in response2["messages"]:
    msg.pretty_print()


print("=" * 30, "-> 第三次调用 <-", "=" * 30)

response3 = agent.invoke(
    {
        "messages": [
            HumanMessage("你好,我是谁?")
        ]
    },
    config=config
)

for msg in response3["messages"]:
    msg.pretty_print()
可以发现,每次执行的输出完全相同,而我们并没有更改 thread_id ,之所以看不到上次运行的状态是 因为每次运行创建新的Saver(),历史State被丢弃了。
举例2:基于外部存储器存储
from langchain.agents import create_agent
from langchain.messages import HumanMessage
from langgraph.checkpoint.postgres import PostgresSaver

# 导入 dotenv,用于加载 .env 文件中的环境变量
from dotenv import load_dotenv

# 导入 os,用于读取环境变量
import os


# 加载 .env 文件中的环境变量
load_dotenv(verbose=True)

# 获取 PostgreSQL 数据库连接地址
DB_URL = os.getenv("DB_URL")


# 创建 PostgreSQL Checkpointer
with PostgresSaver.from_conn_string(DB_URL) as checkpointer:

    # 第一次使用时初始化数据库
    # 创建 Checkpoint 所需的数据表,并执行数据库迁移
    checkpointer.setup()

    # 创建 Agent,并使用 PostgreSQL 保存会话状态
    agent = create_agent(
         model="deepseek:deepseek-v4-pro",
        checkpointer=checkpointer
    )

    # 指定会话 ID
    # 相同的 thread_id 会使用同一份历史记录
    config = {
        "configurable": {
            "thread_id": "3"
        }
    }


    # ==============================
    # 第一次调用
    # ==============================
    print("=" * 30, "-> 第一次调用 <-", "=" * 30)

    response1 = agent.invoke(
        {
            "messages": [
                HumanMessage("你好,我是谁啊?")
            ]
        },
        config
    )

    for msg in response1["messages"]:
        msg.pretty_print()


    # ==============================
    # 第二次调用
    # ==============================
    print("=" * 30, "-> 第二次调用 <-", "=" * 30)

    response2 = agent.invoke(
        {
            "messages": [
                HumanMessage("我是老王~")
            ]
        },
        config
    )

    for msg in response2["messages"]:
        msg.pretty_print()


    # ==============================
    # 第三次调用
    # ==============================
    print("=" * 30, "-> 第三次调用 <-", "=" * 30)

    response3 = agent.invoke(
        {
            "messages": [
                HumanMessage("你好,我是谁??")
            ]
        },
        config
    )

    # 第三次调用时,可以看到前两次对话的历史
    for msg in response3["messages"]:
        msg.pretty_print()
根据输出判断,状态是累积的。
由此可以得出结论:即便重新创建 Saver() ,只要 thread_id 一致,历史状态就可以和当前调用串联起 来。
总结:
-
InMemorySaver()将状态持久化到内存, 进程结束或重建Saver() 则历史状态丢失
-
基于外部存储介质(如PostgreSQL)的持久化器,其存储的状态不会随进程终止而丢失,只要 不 显式删除历史状态 ,即可通过 thread_id 加载历史状态。