知识库要返回某租户最近一年、包含退款、且语义最接近用户问题的 10 篇文档。Elasticsearch 先取关键词 Top 100,向量库再取语义 Top 100,应用层求交集,最后只剩两篇。
扩大两个 TopK 能缓解问题,却无法证明不会漏掉真正相关的第 101 名。
Doris 混合检索最有价值的不是少部署一个组件,而是让结构化过滤先确定候选集合,再在同一数据快照上做全文与向量排名。
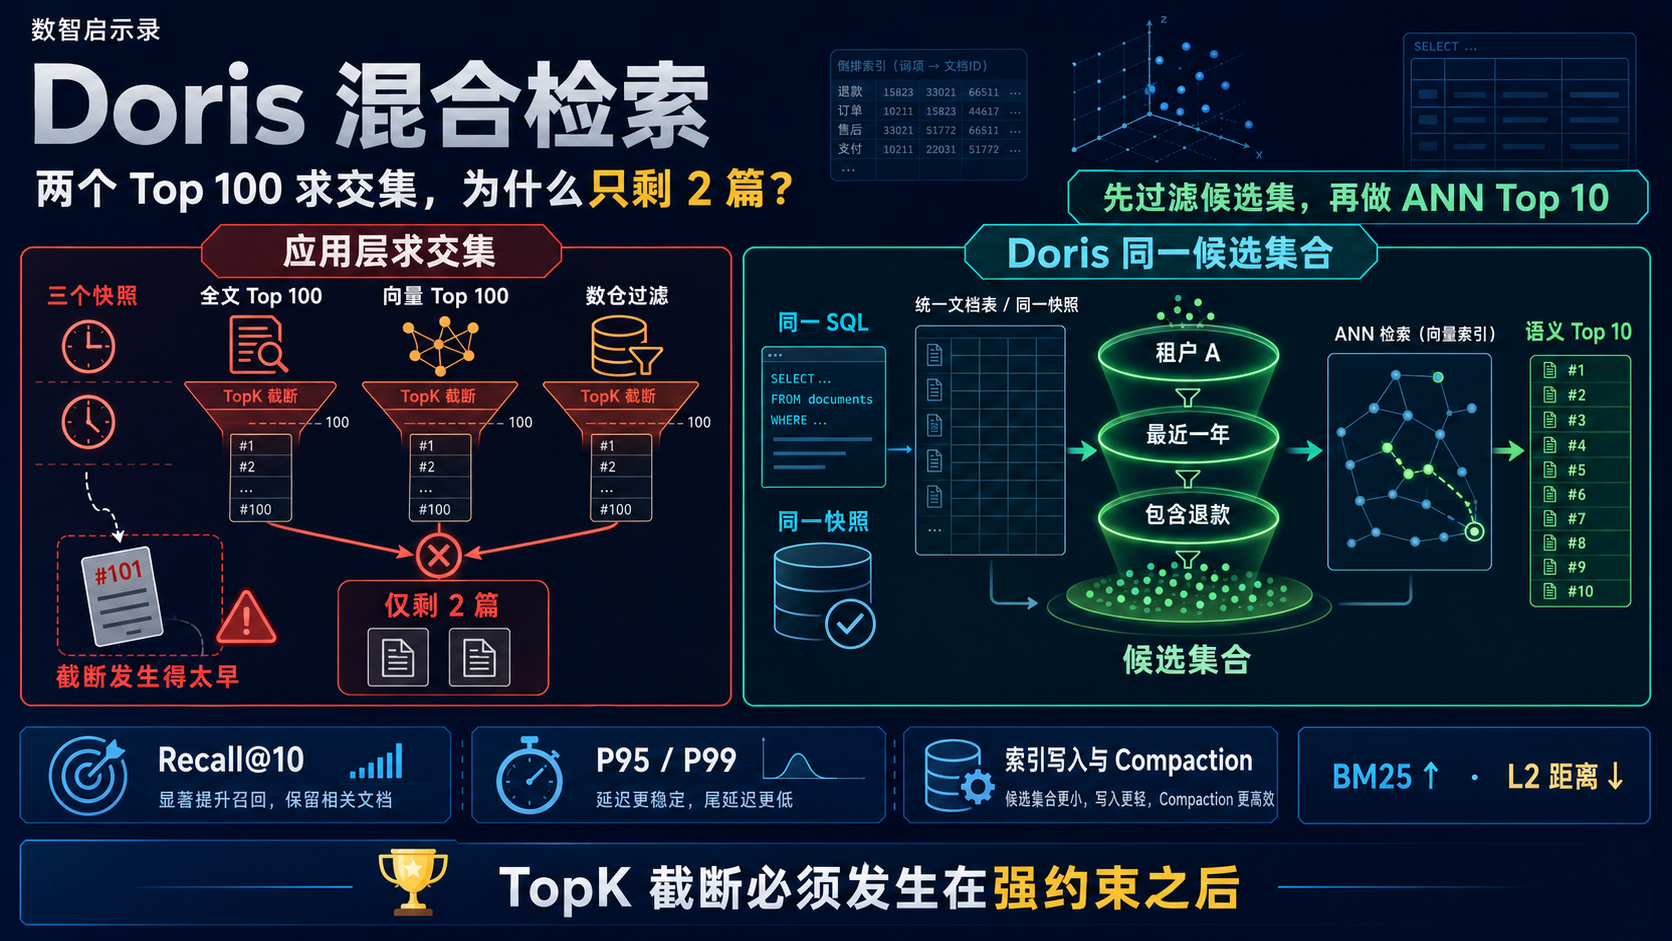
应用层求交集从一开始就改变了问题
目标集合是:
text
租户 A ∩ 最近一年 ∩ 包含退款 ∩ 语义 Top 10多系统方案实际计算的是:
text
全文系统 Top 100 ∩ 向量系统 Top 100 ∩ 数仓过滤结果TopK 截断发生在求交集之前,正确候选可能已经被任一系统丢掉。除此之外,三个系统的更新时刻不同,同一个文档可能已在数仓删除、仍在向量库可见。
三种架构在同一条件下的差异
| 架构 | 过滤与排名顺序 | 优势 | 代价与边界 |
|---|---|---|---|
| Elasticsearch + 向量库 + 数仓 | 各自召回后应用合并 | 每个专用系统能力成熟 | TopK 交集丢失、版本漂移、Glue Code |
| Elasticsearch 单系统 | 全文、过滤、向量在搜索引擎内组合 | 搜索生态与相关性调优强 | 复杂分析、宽表 Join 和指标治理不是主要强项 |
| Doris 单表混合检索 | 结构化/倒排预过滤后 ANN,再 SQL 聚合 | 同一快照、同一 SQL、可继续 Join 分析 | ANN 内存、召回率和索引写入成本 |
如果业务核心是搜索相关性、复杂分词插件和海量纯向量 QPS,专用系统可能更合适。Doris 的优势出现在向量与文本只是分析 SQL 的一部分,还要结合租户、时间、订单和指标。
一张表把三个候选空间放在一起
下面是最小结构。向量维度仅用于演示,实际模型维度必须与索引 dim 一致。
sql
CREATE TABLE knowledge_doc (
    doc_id BIGINT,
    tenant_id BIGINT,
    publish_time DATETIME,
    title STRING,
    body STRING,
    embedding ARRAY<FLOAT> NOT NULL,
    INDEX idx_tenant(tenant_id) USING INVERTED,
    INDEX idx_body(body) USING INVERTED PROPERTIES ("parser" = "chinese"),
    INDEX idx_embedding(embedding) USING ANN PROPERTIES (
        "index_type" = "hnsw",
        "metric_type" = "l2_distance",
        "dim" = "4"
    )
)
DUPLICATE KEY(doc_id)
DISTRIBUTED BY HASH(doc_id) BUCKETS 4;
查询把强约束留在 WHERE,把语义距离用于 TopN:
sql
SELECT doc_id, title,
       l2_distance_approximate(embedding, [0.12, 0.31, 0.08, 0.44]) AS distance
FROM knowledge_doc
WHERE tenant_id = 42
  AND publish_time >= '2025-08-27 00:00:00'
  AND body MATCH_ANY '退款'
ORDER BY distance
LIMIT 10;
Vector Index 官方文档 描述的关键顺序是预过滤、Segment 内 TopN、全局合并。过滤列有合适二级索引时,ANN 在较小候选集上工作;缺少索引时,为保证结果正确可能回退到暴力计算。
ANN 快的代价是近似,不是免费
HNSW 追求低延迟和高召回,但索引需要驻留内存。粗略向量原始体积为:
text
dim × 4 bytes × row_count这还没有包含图结构和其他索引开销。高维、亿级数据直接选择 HNSW,内存预算很容易失控。IVF、量化和磁盘索引能降低内存,但会改变延迟与召回率。
POC 必须同时测:
- Recall@10:与精确暴力结果比较;
- 有过滤与无过滤时的 P95/P99;
- 索引构建对导入吞吐和 Compaction 的影响;
- Segment 数增加后 TopN 合并成本;
- 文档更新、删除后的可见性一致性。
实验以同一批查询、同一过滤条件和同一人工标注集合为基准,对比暴力精确搜索、Doris ANN 与应用层多系统合并,不能拿不同候选集的最低延迟互相比较。
只测查询 20ms,不测召回率,等于只证明系统很快地返回了一组不确定结果。
全文相关性与向量距离不是同一种分数
倒排索引官方文档 在 4.0 引入 BM25 相关性与统一搜索入口。BM25 分数越高通常越相关,L2 距离越小越接近,两者不能直接相加。
混合排序需要归一化、权重和离线评测:
text
文本召回保证关键词约束
→ 结构化条件排除无权访问和过期文档
→ 向量召回补充语义相近结果
→ 业务规则或模型统一重排
Doris 可以在一条 SQL 中拿到候选和特征,但最终排序策略仍属于业务,不应把一个随意权重包装成相关性真理。
源码阅读只追两个下推点
Apache Doris 4.0.8 的源码无需从 Faiss 实现开始。真正影响业务结果的是两处:
- 优化器是否识别
ORDER BY approximate_distance LIMIT k并生成 ANN TopN; - Segment Reader 如何先应用过滤位图,再调用 ANN 索引并合并局部 TopN。
源码目录集中在 be/src/olap/rowset/segment_v2/ann_index/。阅读时用 EXPLAIN 验证索引是否命中;如果参数顺序、距离函数或排序方向不匹配,查询可能回退暴力扫描。
统一系统减少的是一致性税,不是专业能力税
Doris 混合检索减少了三份数据、三个位点和应用层求交集,但不会自动获得专用搜索系统的全部插件生态,也不会让 ANN 变成精确检索。
适合 Doris 的判断条件很具体:结构化过滤强、结果要继续聚合或 Join、数据更新频繁、同一快照一致性比极致纯向量性能更重要。
混合检索最难的不是把三个分数写进公式,而是在任何 TopK 截断之前,先让三个条件作用于同一个候选集合。