关键词:OCR POC测试、OCR测试方案、OCR选型、OCR识别测试、OCR准确率评测
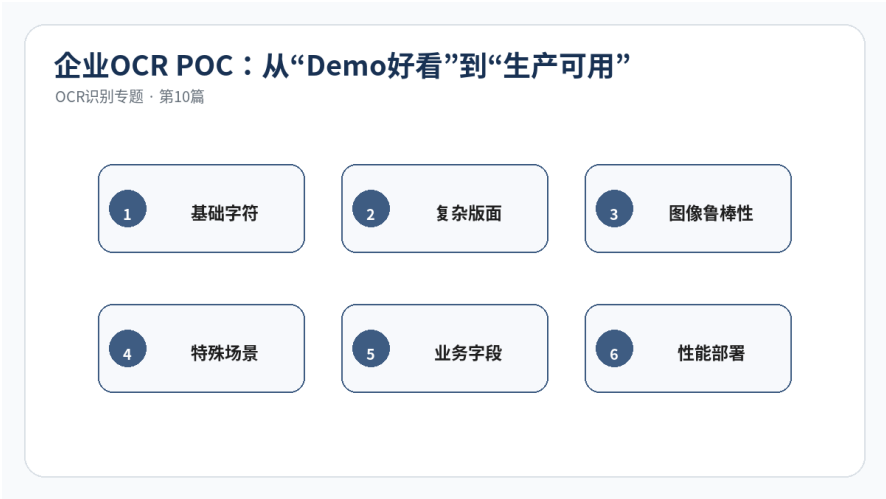
图:企业OCR POC:从"Demo好看"到"生产可用"
企业选择OCR识别系统时,最可靠的方法不是看宣传页,也不是只上传三五张清晰图片体验Demo,而是做一轮结构化POC测试。一个好的OCR POC应该回答三个问题:基础识别到底准不准?真实坏图能不能扛住?上线后的速度、成本和集成是否可接受?
一、先把测试目标拆成六个维度
用户提供的《OCR模型对比测试报告》给出了一套很有参考价值的思路:从技术架构、识别准确性、信息抽取准确性、鲁棒性、多语言、推理部署和训练成本等方面评估OCR。企业可以在此基础上形成自己的评分表,而不是用一个综合准确率决定结果。
建议把POC拆成六个维度:基础字符能力、复杂版面理解、图像质量鲁棒性、特殊字符和特殊场景、业务字段抽取、性能与部署。
二、基础字符测试至少包含七类
可以分别准备标准中文、标准英文、数字、中英文混排、繁体中文、标点特殊符号和竖排文字。每类样本统计字符数和字符正确率。这样可以快速发现模型是否偏科,例如某个模型中文很好但英文偏弱,或者繁体、标点和竖排明显下降。
对于姓名、设备编号等业务,还应额外加入生僻字、上下角标和专业符号。
三、复杂版面和坏图必须占足够比例
POC不能全部用扫描清晰的A4纸。测试报告设置了多栏文档、表格结构还原、图文混排、页眉页脚、各方向文字,以及模糊、低分辨率、高噪点、曝光过度/不足、倾斜、折痕遮挡、旋转、超大图、局部文档、畸变、水印、底纹、印章覆盖、背透、套打和手写等项目。
这套分类几乎可以直接变成企业的"破坏性测试清单"。如果某类问题在真实业务里高频出现,就应该提高样本比例和评分权重。
四、业务字段必须按字段统计
如果OCR最终用于发票、证件、合同或表单,POC一定要增加字段级指标。例如通行费可以统计代码、号码、入口、出口、日期、金额;客运票可以增加姓名、身份证号。每个字段分别统计正确数,而不是只给整张文档一个分数。
对于金额、证件号、发票号码等高风险字段,可以设置"必须100%或人工复核"的规则;对于备注、说明等长文本,可以允许字符级小误差。
五、一定要建立Bad Case回归库
POC不是一次考试,而是未来迭代的起点。所有识别错误都应该分类保存:漏行、错字、重复、顺序错、表格错位、幻觉、超时、格式不支持等。后续模型升级或参数修改后,要重新跑这批Bad Case,防止"修好一个问题又引入另一个问题"。
六、最后才比较性能和成本
准确率达到业务门槛后,再比较单张耗时、并发吞吐、显存、CPU占用、文件格式、SDK/API、私有化部署和硬件成本。对于海量文档,0.5秒和3秒的差异会直接转化为服务器数量;对于内网场景,是否支持CPU或国产平台也可能比0.1%的准确率差异更重要。
无论测试文通OCR、PaddleOCR、GLM-OCR还是其他方案,都应该在同一份POC规则、同一批真实样本、同一套统计脚本下比较。这样得到的结论才公平,也最接近上线后的真实表现。
一个成熟的OCR选型,不是寻找"万能第一名",而是建立自己的测试标准。只要POC方法正确,企业最终选到的往往不是榜单上最耀眼的模型,而是最适合自己生产环境的OCR系统。