通过这篇文章,我们需要理解信息增益率的意义,知道C4.5树的构建方法;理解基尼指数的作用,知道cart构建的特征选择方法,知道分类决策树的特点。
一、C4.5决策树
1.ID3树的不足
偏向于选择种类多的特征作为分裂依据
原因:ID3 用信息增益 做特征选择:选择信息增益最大的特征做分裂。核心:特征的取值类别越多,越容易把数据集切得很碎,子集纯度很高,信息增益就会偏大。
2.简单回顾信息增益
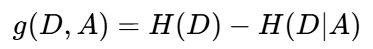
- H(D):原数据集的熵(混乱程度)
- H(D|A):按特征 A 分裂之后的条件熵
信息增益 = 分裂前混乱度 − 分裂后加权平均混乱度
信息增益越大,代表这个特征分裂之后,整体数据变得越 "干净"。
条件熵公式: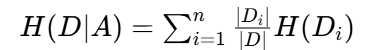
n:特征 A 有多少个不同取值。
3.举个栗子
|-----|-----|-----|
| 特征b | 特征a | 目标值 |
| 1 | α | A |
| 2 | α | A |
| 3 | β | B |
| 4 | α | A |
| 5 | β | B |
| 6 | α | B |
特征a有2个取值
特征b有6个取值
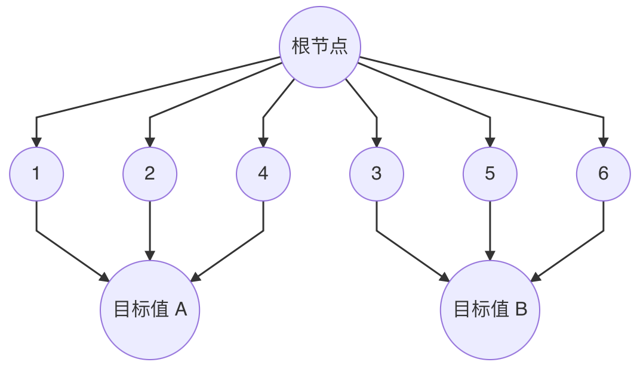
1 特征M作为分裂特征,会构造一棵深度为2的决策树,该树的预测准确率可能非常高
2 但整棵树过于依赖少数的特征(只根据少数特征进行学习),导致过拟合
二、信息增益率
信息增益率 = 信息增益 /特征熵
1.计算方法:
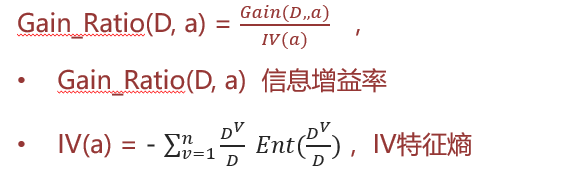
2.信息增益率的本质:
特征的信息增益 ➗ 特征的内在信息
相当于对信息增益进行修正,增加一个惩罚系数
特征取值个数较多时,惩罚系数较小;特征取值个数较少时,惩罚系数较大。
惩罚系数:数据集D以特征a作为随机变量的熵的倒数**。**
3.总结
ID3 基于信息增益,当某个特征取值种类很多时,分裂后会产生大量小的子集,子集容易达到高纯度,条件熵大幅下降,信息增益偏大;算法会优先挑选这类特征,造成偏向取值多的特征。C4.5 使用信息增益比,引入特征自身熵做分母,对高基数特征进行惩罚,缓解该问题。
4.举个例子
已知数据集:
|-----|-----|-----|
| 特征b | 特征a | 目标值 |
| 1 | α | A |
| 2 | α | A |
| 3 | β | B |
| 4 | α | A |
| 5 | β | B |
| 6 | α | B |
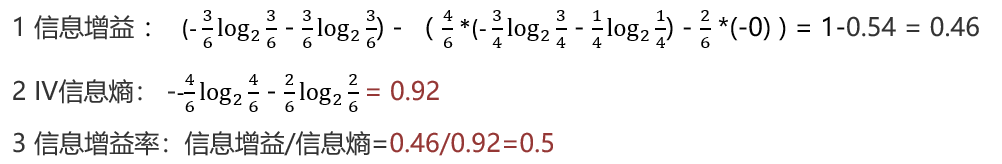
需求:求特征a、b的信息增益率
(1).特征a的信息增益率:
(2).特征b的信息增益率:
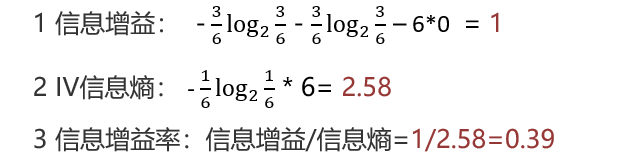
结论:特征a的信息增益率大于特征b的信息增益率,根据信息增益率,应该选择特征a作为分裂特征
5.关于信息增益率的总结
信息增益率的作用
•信息增益偏向于选择种类多的特征作为分裂依据
•缓解ID3树中存在的不足
信息增益率
•信息增益率 = 信息增益 /特征熵
•相当于对信息增益进行修正,增加一个惩罚系数
二、CART决策树(Classification and Regression Tree)
Cart模型是一种决策树模型,它即可以用于分类,也可以用于回归。
Cart回归树使用平方误差最小化策略,
Cart分类生成树采用的基尼指数最小化策略。
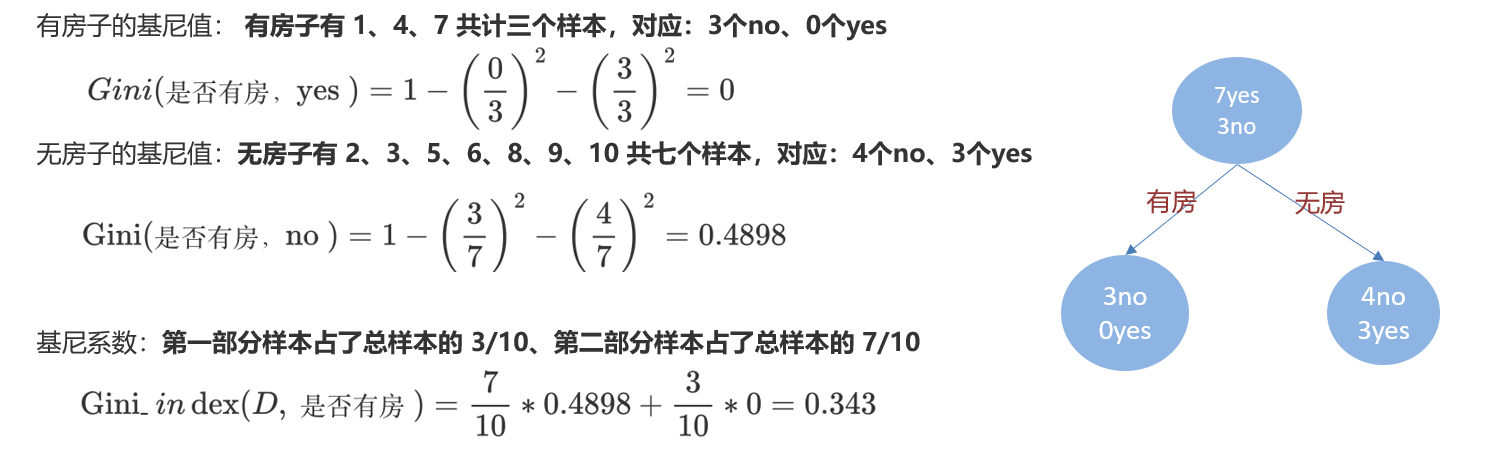
**基尼值Gini(D):**从数据集D中随机抽取两个样本,其类别标记不一致的概率。故,Gini(D)值越小,数据集D****的纯度越高。
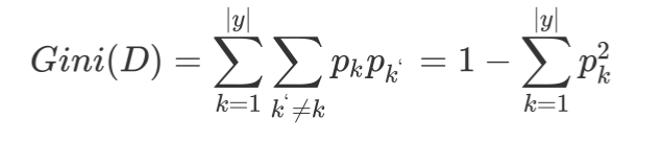
**基尼指数Gini_index(D):**选择使划分后基尼系数最小的属性作为最优化分属性。
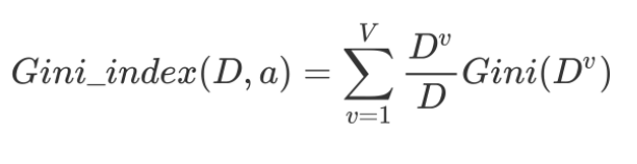
注意:
1.信息增益(ID3)、信息增益率值越大(C4.5),则说明优先选择该特征。
2.基尼指数值越小(cart),则说明优先选择该特征。
物理含义:
基尼值代表:从数据集随机抽两个样本,它们类别不一样的概率。
- Gini 越大 → 数据集越混乱、纯度越低
- Gini 越小 → 数据集越纯净
举个例子:
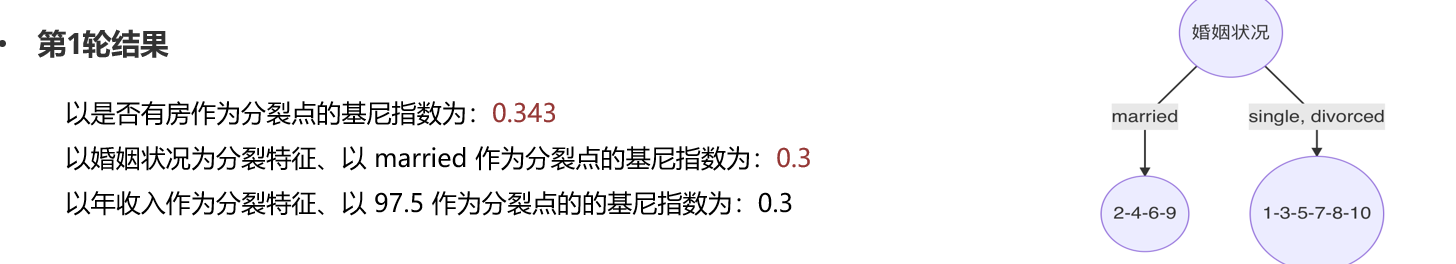
已知:是否拖欠贷款数据。
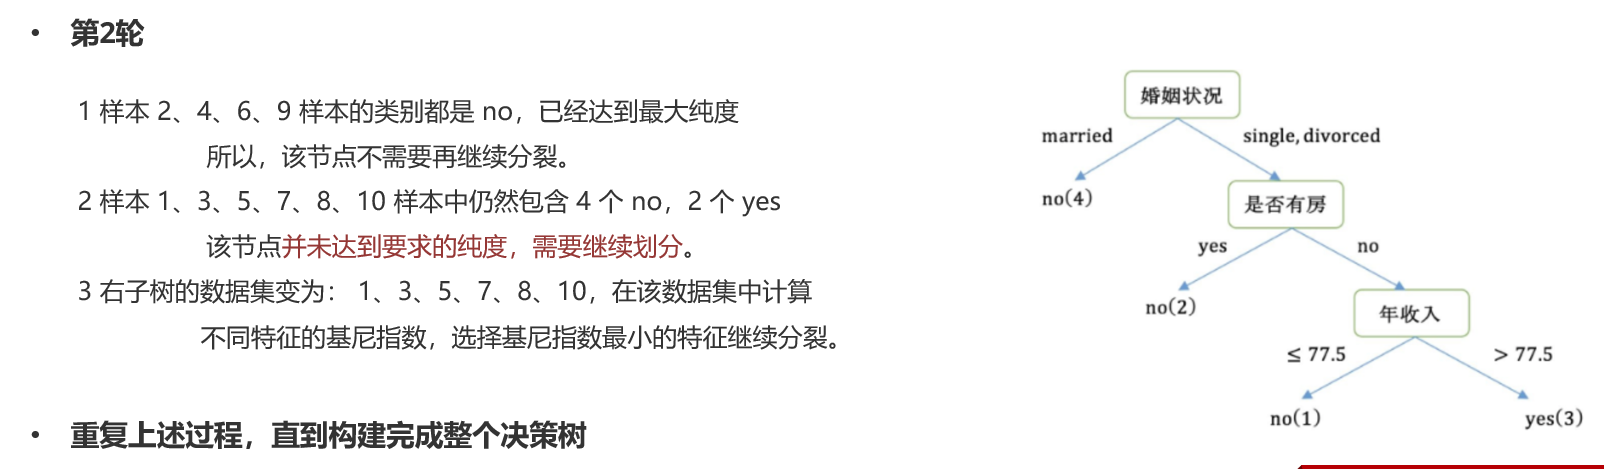
需求:计算各特征的基尼指数,选择最优分裂点
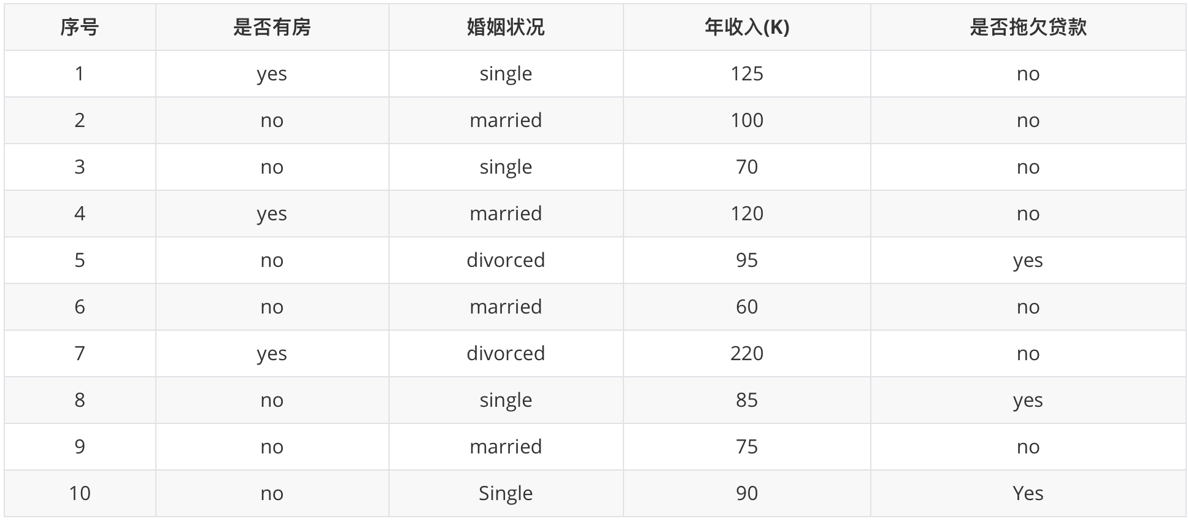
(1)是否有房
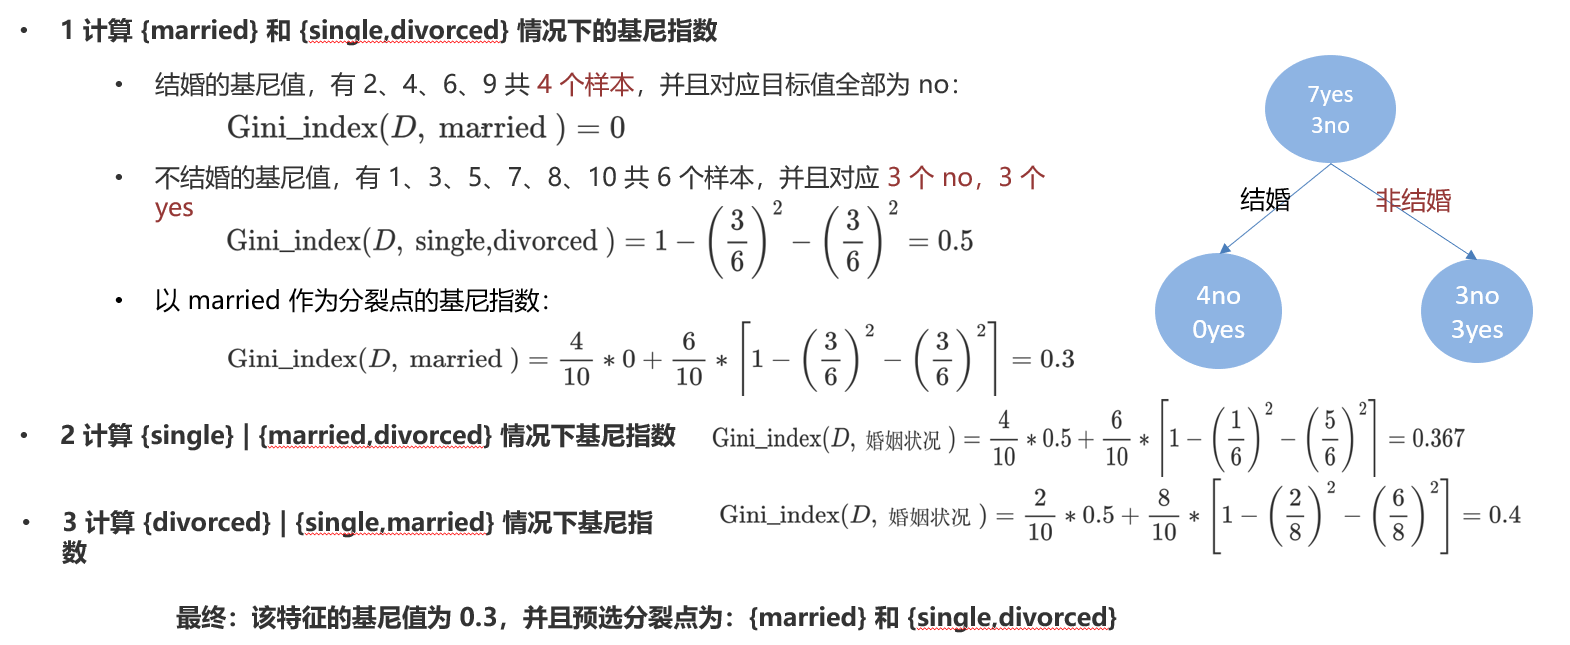
(2)婚姻状况
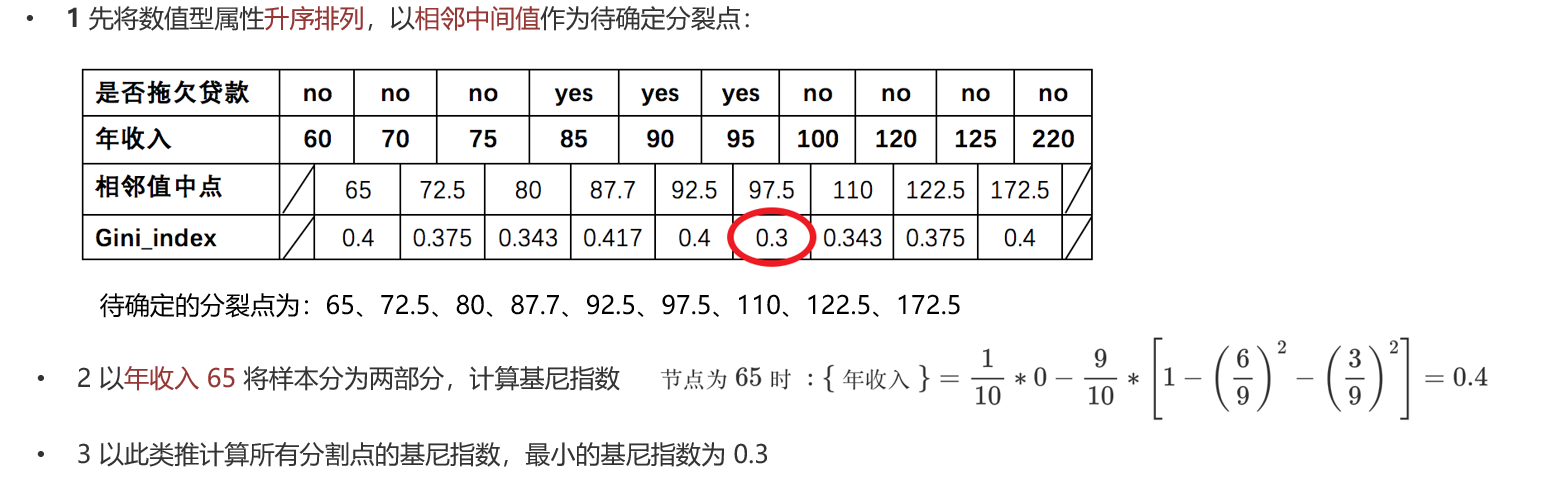
(3)年收入
(4)CART树原理举例
三、三种分类树的对比
|--------|----------|----------|----------------------------------------------------------------------------------|
| 名称 | 提出时间 | 分支方式 | 特点 |
| ID3 | 1975 | 信息增益 | 1.ID3只能对离散属性的数据集构成决策树 2.倾向于选择取值较多的属性 |
| C4.5 | 1993 | 信息增益率 | 1.缓解了ID3分支过程中总喜欢偏向选择值较多的属性 2.可处理连续数值型属性,也增加了对缺失值的处理方法 3.只适合于能够驻留于内存的数据集,大数据集无能为力 |
| CART | 1984 | 基尼指数 | 1.可以进行分类和回归,可处理离散属性,也可以处理连续属性 2.采用基尼指数,计算量减小 3.一定是二叉树 |