📖标题:FinixDoc: Rethinking Financial Document Parsing Beyond Saturated Benchmarks
🌐来源:arXiv, 2608.22842v1
🛎️文章简介
🔸研究问题:现有基准测试无法反映真实金融场景中低质量、超大规模文档的解析性能差距,如何解决这一部署难题?
🔸主要贡献:提出FinixDoc端到端代理解析系统及FinixDoc-VL模型,构建能力矩阵与FinixDocBench基准,显著提升复杂场景下的解析鲁棒性。
📝重点思路
🔸提出文档解析能力矩阵,从视觉质量和文档规模两个维度划分基准收敛区、低质量区、未探索大规模区及模糊不可恢复区,明确工业界能力边界。
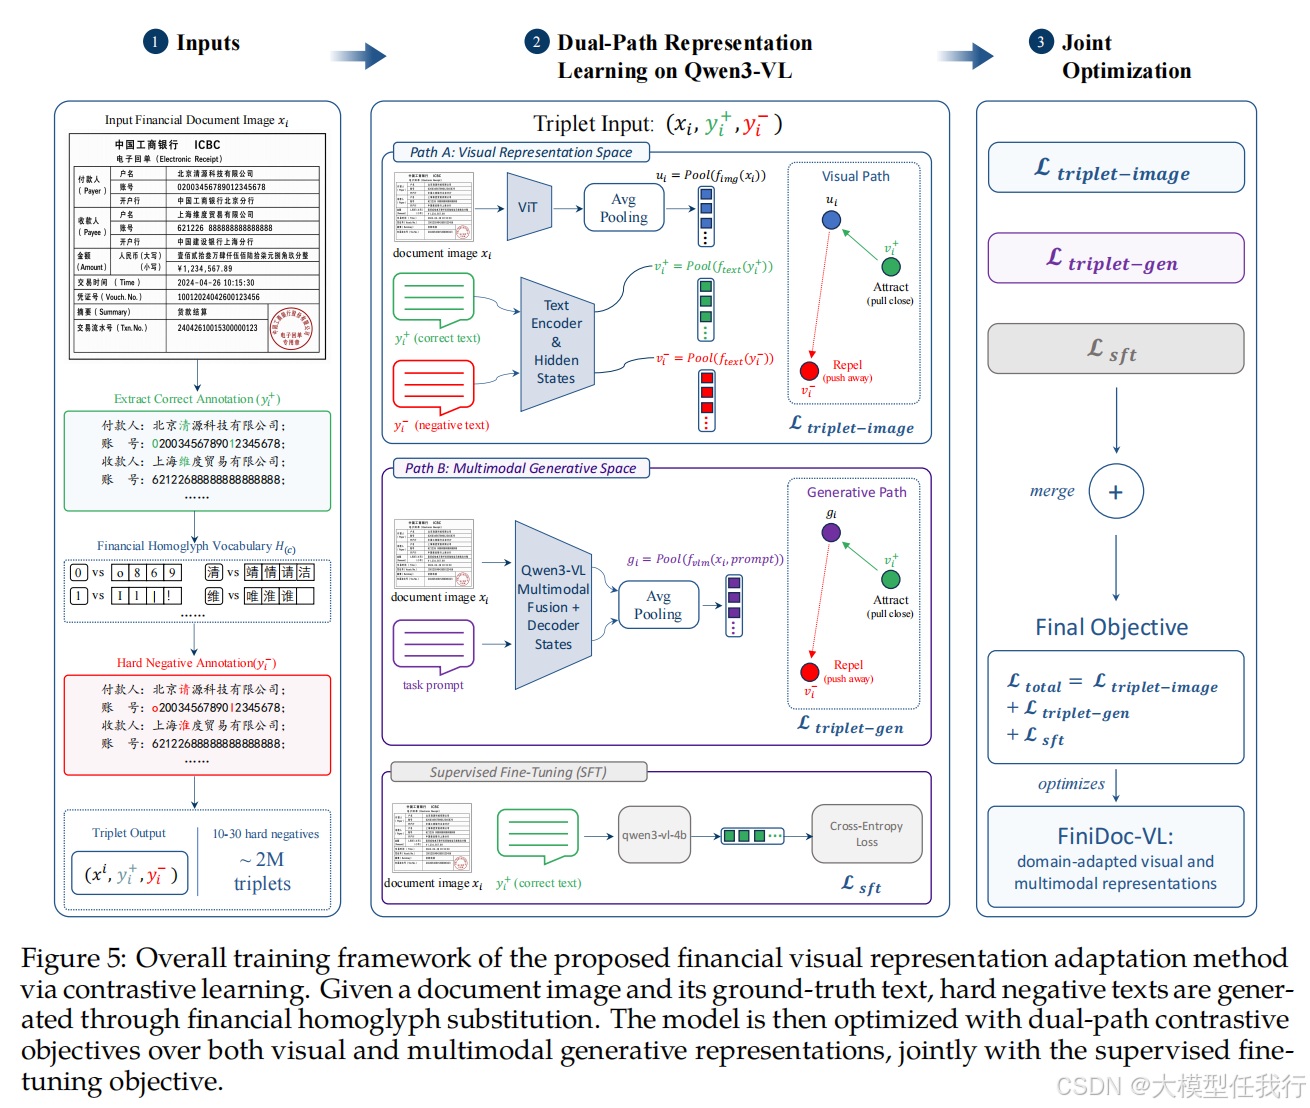
🔸研发FinixDoc-VL核心模型,基于Qwen3-VL-4B,采用同形字感知对比学习增强视觉编码器对细微字形差异的辨别力,并结合多阶段强化学习优化文本保真度、检测质量及阅读顺序一致性。
🔸构建人机协同数据工厂,通过异构多模型协作推理、大模型级联校准及基于置信度的专家审核流程,高效生产高质量结构化训练数据。
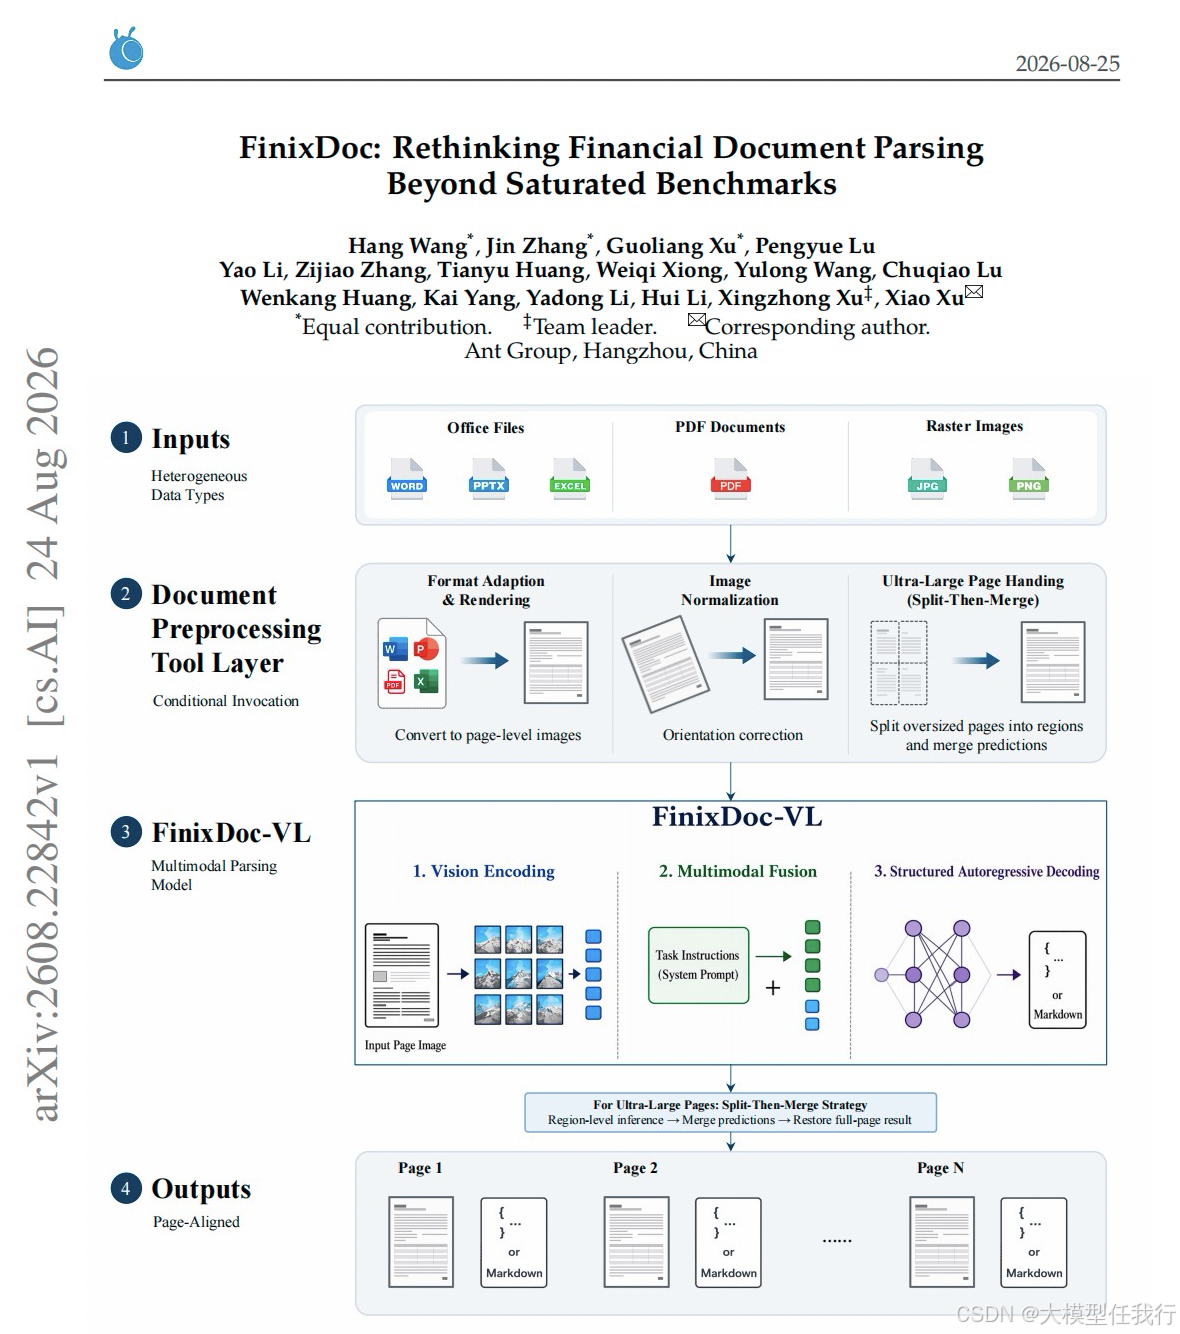
🔸设计系统级分割合并策略处理超大页面,通过动态路由、结构感知分割及方向感知合并,解决单一大模型处理超长文档的显存与上下文限制。
🔸发布FinixDocBench基准,涵盖数字原生、相机拍摄、超大页面及内部工作流场景,填补真实金融部署评估空白。
🔎分析总结
🔸在通用基准OmniDocBench上,FinixDoc-VL保持强劲基础能力,虽略逊于专用OCR模型,但远超同规模基座模型,证明训练策略未损害通用性。
🔸在低质量相机拍摄场景(FinixPhoto)中,专用模型性能急剧下降,而FinixDoc-VL凭借视觉适应训练展现出最强鲁棒性,综合得分领先第二名5.13分。
🔸在超大页面场景(FinixHuge)中,完整FinixDoc系统通过分割合并策略实现92%的成功率,远高于直接推理的基线模型,有效解决了可处理性瓶颈。
🔸在内部高频工作流评估(FinixInner)中,FinixDoc-VL在理赔记录、费用单据等复杂异构文档上表现最佳,验证了其在真实业务中的实用价值。
💡个人观点
论文直面金融场景中的噪声与规模挑战,将通用VLM的鲁棒性与领域特定的对比学习及强化学习相结合。