🔥承渊政道: 个人主页
❄️个人专栏: 《C语言基础语法知识》 《数据结构与算法》 《C++知识内容》 《Linux系统与网络知识》 《算法刷题指南》 《测评文章活动推广》 《大模型语言路线学习》 《MySQL数据库学习》 《Python知识内容》 《cpolar知识学习》
✨逆境不吐心中苦,顺境不忘来时路!✨ 🎬 博主简介:
在前一面我们介绍了ChatGLM的基本内容,并介绍了ChatGLM的一些常用应用,例如使用ChatGLM完成一些基本的场景问答以及特定信息抽取等.除此之外,ChatGLM还可以完成一些更高级的任务和应用,例如通过提供的文档完成基于特定领域文档内容的知识问答等.不同类型的本地知识库可能对应不同的应用场景.例如,在问答系统中,可以使用维基百科或其他在线百科全书作为本地知识库,以便回答用户的常见问题.在客服对话系统中,可以使用公司内部的产品文档或常见问题解答作为本地知识库,以便回答用户关于产品的问题.在聊天机器人中,可以使用社交媒体数据、电影评论或其他大规模文本数据集作为本地知识库,以便回答用户的聊天话题.
目录
- 1.医疗问答GLMQABot搭建实战---基于ChatGLM搭建专业客服问答机器人
- 2.金融信息抽取实战---基于知识链的ChatGLM本地化知识库检索与智能答案生成
- 3.基于ChatGLM的一些补充内容
- 4.小结
1.医疗问答GLMQABot搭建实战---基于ChatGLM搭建专业客服问答机器人
我们在前面已经介绍了使用基本的ChatGLM完成知识问答的一些方法,即直接通过Prompt将需要提出的问题传送给ChatGLM.可以看到ChatGLM已经能够较好地完成相关内容的知识问答,如图所示.
如果我们对ChatGLM进一步提出涉及专业领域的问题,而此方面知识是ChatGLM未经数据训练的,那么ChatGLM的回答效果如何呢?本文将考察ChatGLM在专业领域的问答水平,并尝试解决此方面的问题.
1.1基于ChatGLM搭建专业领域问答机器人的思路
在使用ChatGLM制作专业领域问答机器人之前,我们需要了解ChatGLM能否完整地回答使用者所提出的问题.下面提出一个专业医学问题交于ChatGLM回答,代码如下:
python
from transformers import AutoTokenizer, AutoModel

tokenizer = AutoTokenizer.from_pretrained(
    "THUDM/chatglm-6b",
    trust_remote_code=True
)

model = AutoModel.from_pretrained(
    "THUDM/chatglm-6b",
    trust_remote_code=True
).half().cuda()

prompt_text = "小孩牙龈肿痛服用什么药"

# ----------------------------------------

print("单轮ChatGLM询问结果:")

response, _ = model.chat(
    tokenizer,
    prompt_text,
    history=[]
)

print(response)
这是一份最常见的生活类医学问答,问题是"小孩牙龈肿痛服用什么药",在这里我们使用已有的ChatGLM完成此问题的回答,结果如图所示(注意,在使用ChatGLM回答问题时,结果会略有不同).
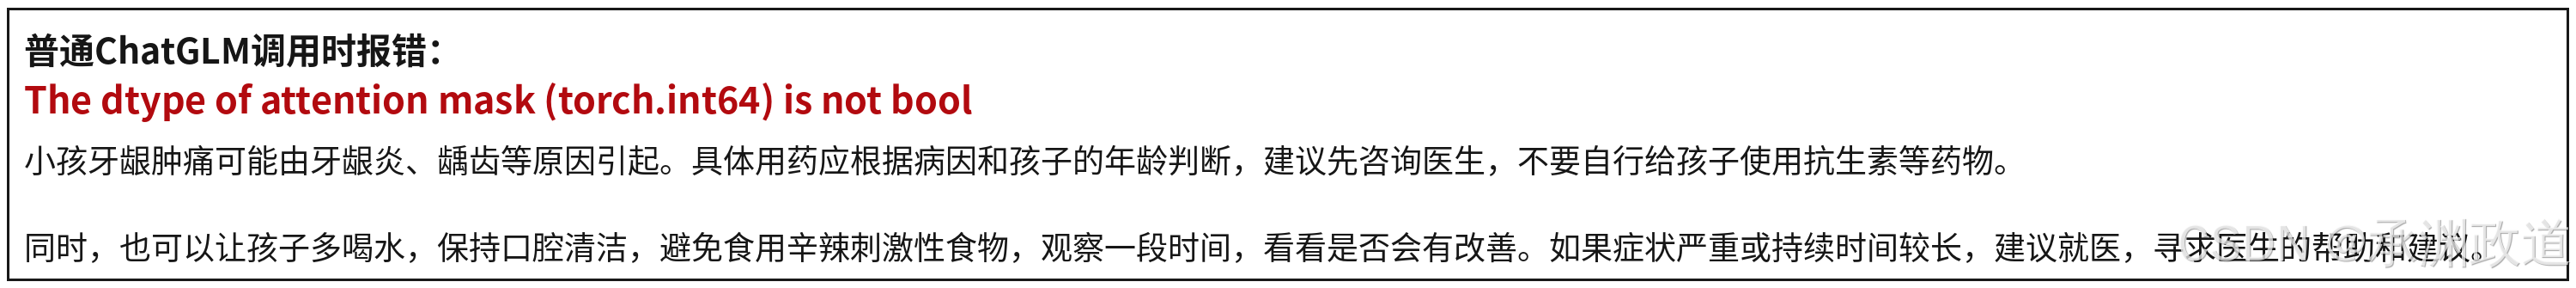
这是一个较经典的回答,其中涉及用药建议,但是并没有直接回答我们所提出的问题,即"服用什
么药".专业回答建议如图所示.
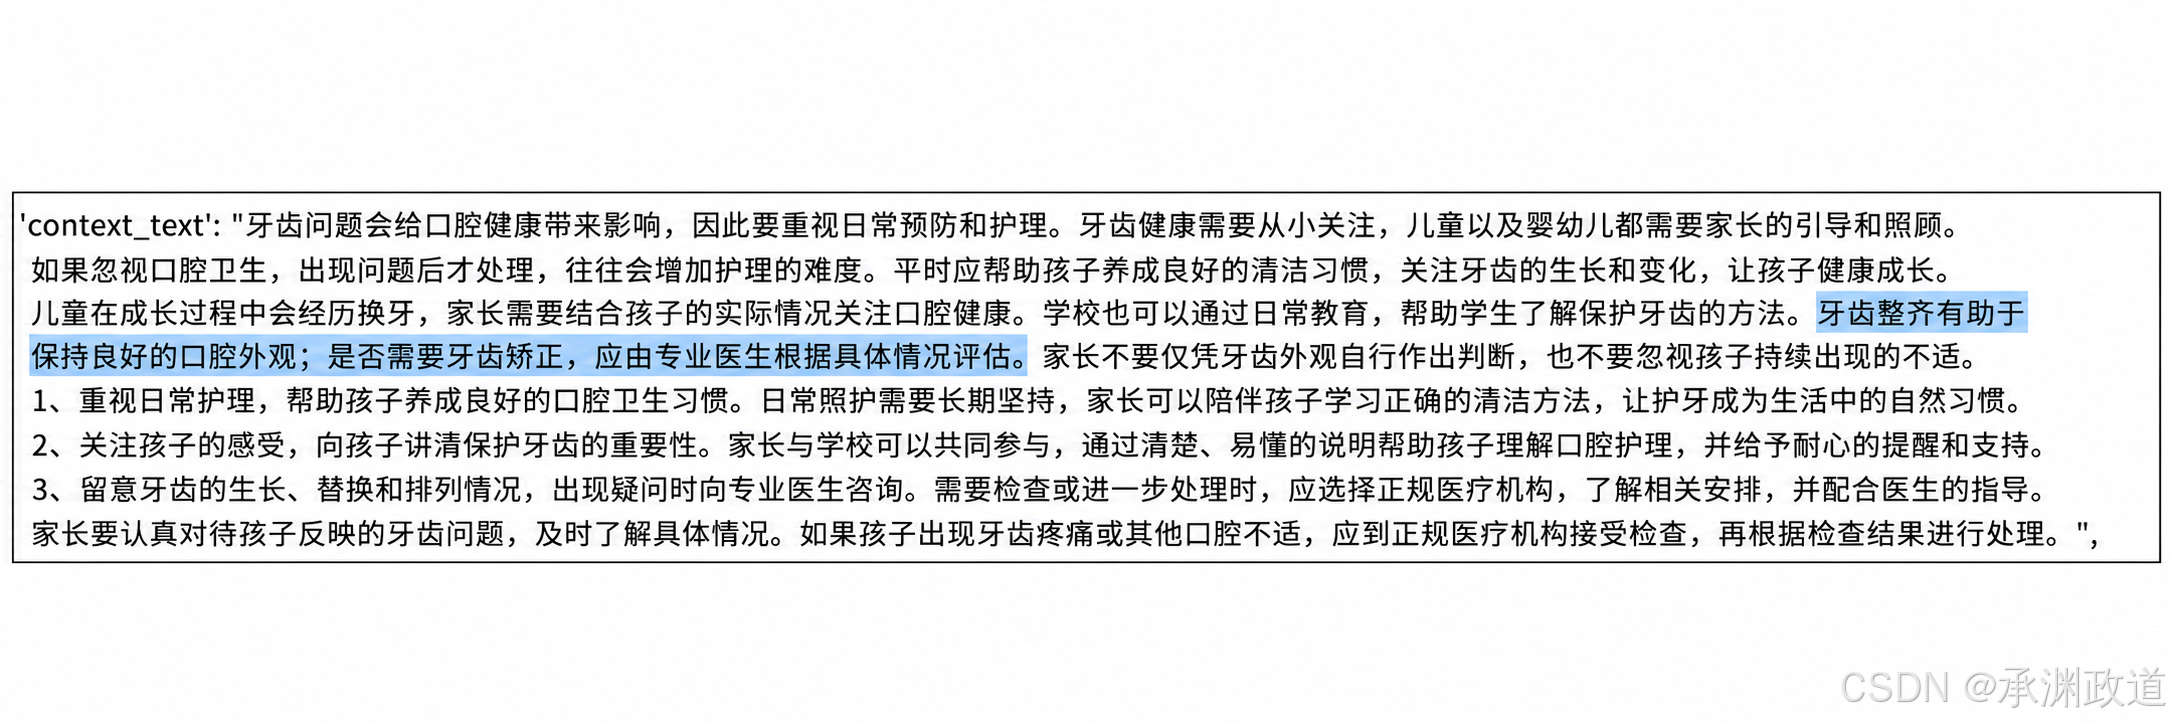
其中灰底部分是对这个问题的回答,即通过服用牛黄解毒丸可以较好地治疗小孩牙龈肿痛.这是一种传统的治疗方案.我们的目标就是希望ChatGLM能够根据所提供的文本资料回答对应的问题,而问题的答案应该就是由文本内容所决定的.
下面我们分析使用ChatGLM根据文本回答问题的思路.一个简单的办法就是将全部文档发送给ChatGLM,然后通过Prompt的方式告诉ChatGLM需要在发送的文档中回答特定的问题.
显然这个方法在实战中并不可信.首先,需要发送的文档内容太多,严重地消耗硬件的显存资源;其次,庞大的数据量会严重拖慢ChatGLM的回答;再次数据量过大还会影响ChatGLM查询文档的范围.
因此,我们需要换一种思路来完成实战训练.如果只发送与问题最相关的"部分文档"信息给ChatGLM,是否可行呢?整体流程如图所示.
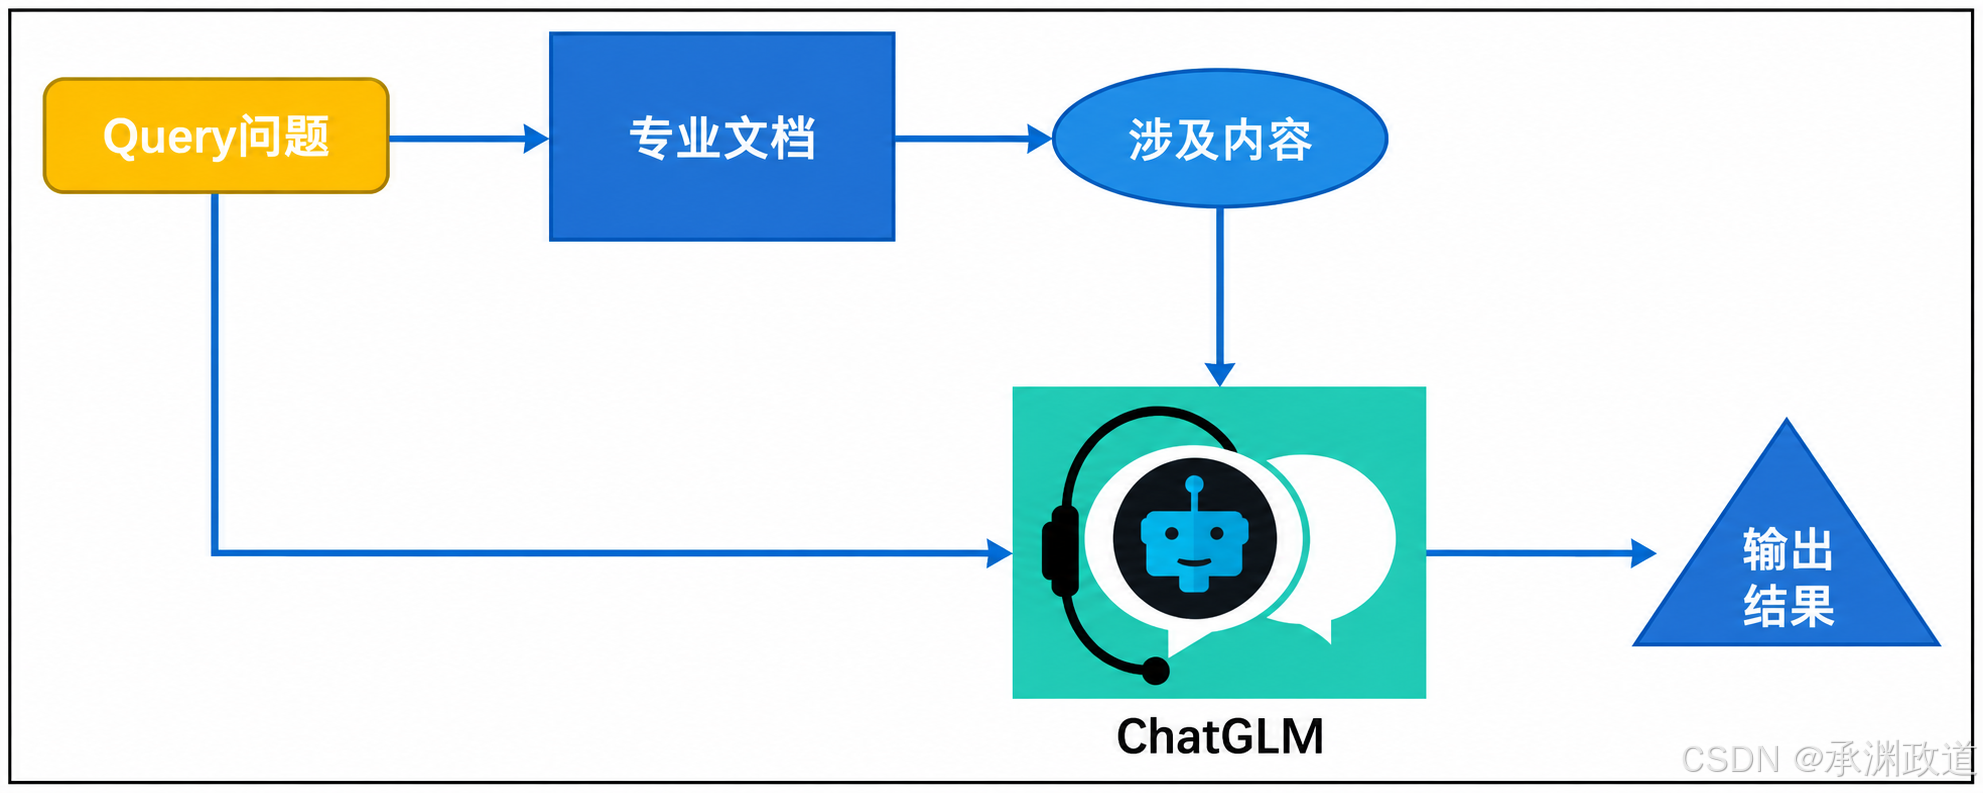
这只是一个思路,具体是否能够成功还需要自己自行尝试.
1.2基于真实医疗问答的数据准备
由于此项目是完成专业领域的问答,因此这里准备了一份真实的医疗问答实例作为基础数据,数据是根据具有实际意义的医学问答病例所设计的医疗常识,如图所示.
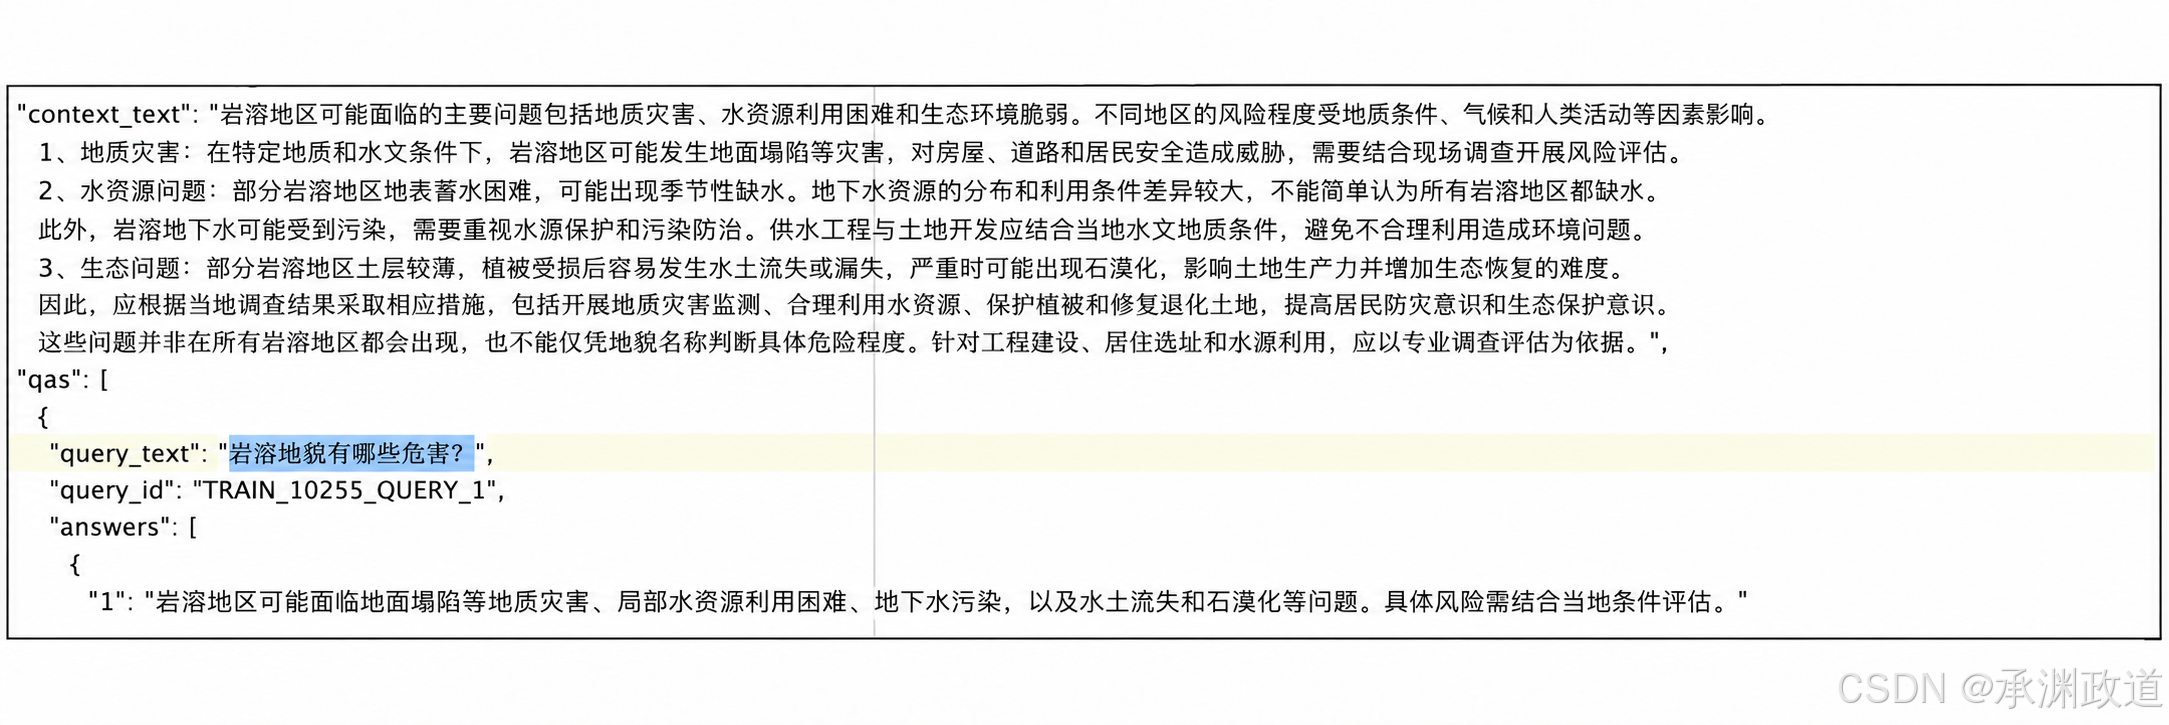
下面对数据进行处理,在这里由于读取的文档内容是以JSON格式存储的,因此读取此内容的代码如下:
python
import json
# 打开文件,r用于读取,encoding用于指定编码格式
with open('./dataset/train1.json', 'r', encoding='utf-8') as fp:
    # load()函数将fp(一个支持read()的文件类对象,包含一个JSON文档)反序列化为一个Python对象
    data = json.load(fp)

    for line in data:
        line = (line["context_text"])  # 获取文档中的context_text内容
        context_list.append(line)     # 将获取到的文档添加到对应的list列表中
注意,本例中我们采用医疗问答数据作为特定的文档目标,可以选择自定义的专业领域文档或
者内容作为特定目标进行处理.
1.3文本相关性(相似度)的比较算法
根据前面讲解的内容,在获取到对应的文档内容后,一个非常重要的工作是用特定的方法或者算
法找到与提出的问题最相近的那部分答案.因此,这里的实战内容就转化成文本相关性(相似度)的比较和计算.
对于文本相关性的计算,相信不会陌生,常用的是余弦相关性计算与BM25相关性计算,在这里我们采用BM25来计算对应的文本相关性.
假如我们有一系列的文档Doc,现在要查询问题Query.BM25的思想是,对Query进行语素解析,生成语素Q;然后对于每个搜索文档Di计算每个语素Qi与文档Dj的相关性;最后将所有的语素Qi与Dj进行加权求和,最终计算出Query与Dj的相似性得分.将BM25算法总结如下:
S c o r e ( Q u e r y , D i ) = ∑ i n W i ⋅ R ( Q i , D j ) \mathrm{Score}(\mathrm{Query},D_i)=\sum_{i}^{n}W_i\cdot R(Q_i,D_j) Score(Query,Di)=i∑nWi⋅R(Qi,Dj)
在中文中,我们通常将每一个词语当作Qi,Wi表示语素Qi的权重,R(Qi,Dj)表示语素Qi与文档Di的相关性得分关系.
限于篇幅,对于BM25不再深入说明,有兴趣的可以自行研究.
下面通过程序实现BM25工程,我们可以通过编写自己的Python代码来实现BM25函数.对于成熟的算法,建议使用Python中现成的库函数,这是因为大多数现成的Python库,已经经过持续优化,我们没必要再重复制造轮子,使用现成的库即可.
可以使用如下代码安装对应的Python库:
python
pip install rank_bm25 #注意下画线这是一个较常用的BM25库,其作用是计算单个文本与文本库的BM25值.但是需要注意的是,BM在公式中要求传递的是单个字(或者词),其过程是以单个字或者词为基础进行计算,因此在使用BM进行相关性计算时,需要将其拆分为字或者词的形式,完整的相关性计算代码如下:
python
# query是需要查询的文本,documents为文本库,top_n为返回最接近的n条文本内容
def get_top_n_sim_text(query: str, documents: List[str], top_n=3):
    tokenized_corpus = []
    for doc in documents:
        text = []
        for char in doc:
            text.append(char)
        tokenized_corpus.append(text)

    bm25 = BM25Okapi(tokenized_corpus)
    tokenized_query = [char for char in query]

    # doc_scores = bm25.get_scores(tokenized_query)  # array([0., 0.93729472, 0.])

    results = bm25.get_top_n(tokenized_query, tokenized_corpus, n=top_n)
    results = ["".join(res) for res in results]
    return results
对于此部分的代码应用如下:
python
import utils
     prompt_text = "明天是什么天气"
     context_list = ["哪个颜色好看","今天晚上吃什么","你家电话多少","明天的天气是晴天","晚上的月亮好美呀"]
     sim_results = utils.get_top_n_sim_text(query=prompt_text,documents=context_list,
top_n=1)
     print(sim_results)
最终打印结果如下:
bash
['明天的天气是晴天']更多的内容请自行尝试.
当然,对于文本相似性的比较,除了使用BM25相关性计算外,还可以使用余弦相似度、欧拉距离以及深度学习的方法来实现,具体采用哪种方案,需要在不同的任务场景下比较选择.
1.4提示语句Prompt的构建
本小节使用基于专业文档搭建的GLMQABot问答机器人.
我们的目标是将相关的文本内容传递给ChatGLM,并显式地要求ChatGLM根据文档内容回答对应的问题,因此一个非常重要的内容就是显式地传递需要ChatGLM的Prompt.
在这里准备了一个可供ChatGLM使用的专门用于读取专业文档的Prompt,其内容如下:
python
prompt = f'根据文档内容来回答问题,问题是"{question}",文档内容如下:\n'可以看到,此次任务的Prompt就是使用自定义的问题和查找到的相关内容组成一条特定的语句,要求ChatGLM对此语句做出回应.完整的构建Prompt的函数如下:
python
 def generate_prompt( question: str, relevant_chunks: List[str]):
        prompt = f'根据文档内容来回答问题,问题是"{question}",文档内容如下:\n'
        for chunk in relevant_chunks:
           prompt += chunk + "\n"
        return prompt
1.5基于单个文档的GLMQABot的搭建
下面完成GLMQABot的问答搭建,按照前面的分析,现在只需要将所有的内容串联在同一个文件
中即可,代码如下:
python
import utils

     context_list = []
     import json
     # 打开文件,r用于读取,encoding用于指定编码格式
     with open('./dataset/train1.json', 'r', encoding='utf-8') as fp:
        # load()函数将fp(一个支持.read()的文件类对象,包含一个JSON文档)反序列化为一个Python对象
        data = json.load(fp)
        for line in data:
           line = (line["context_text"])
           context_list.append(line)
    from transformers import AutoTokenizer, AutoModel
    tokenizer = AutoTokenizer.from_pretrained("THUDM/chatglm-6b",
    "trust_remote_code=True)
    model = AutoModel.from_pretrained("THUDM/chatglm-6b",
trust_remote_code=True).half().cuda()

    prompt_text = "小孩牙龈肿痛服用什么药"
    "--------------------------------------------------------"
    print("普通ChatGLM询问结果:")
    response, _ = model.chat(tokenizer, prompt_text, history=[])
    print(response)
    print("----------------------------------------")
    print("经过文本查询的结果如下:")
    sim_results = utils.get_top_n_sim_text(query=prompt_text,documents=context_list)
    print(sim_results)
    print("----------------------------------------")
    print("由ChatGLM根据文档查询的结果如下:")
    prompt = utils.generate_prompt(prompt_text,sim_results)
    response, _ = model.chat(tokenizer, prompt, history=[])
    print(response)
    print("----------------------------------------")
在这里分别展示了不同情况下对问题的回答情况,下面说明一下结果.
普通ChatGLM询问结果如图所示.
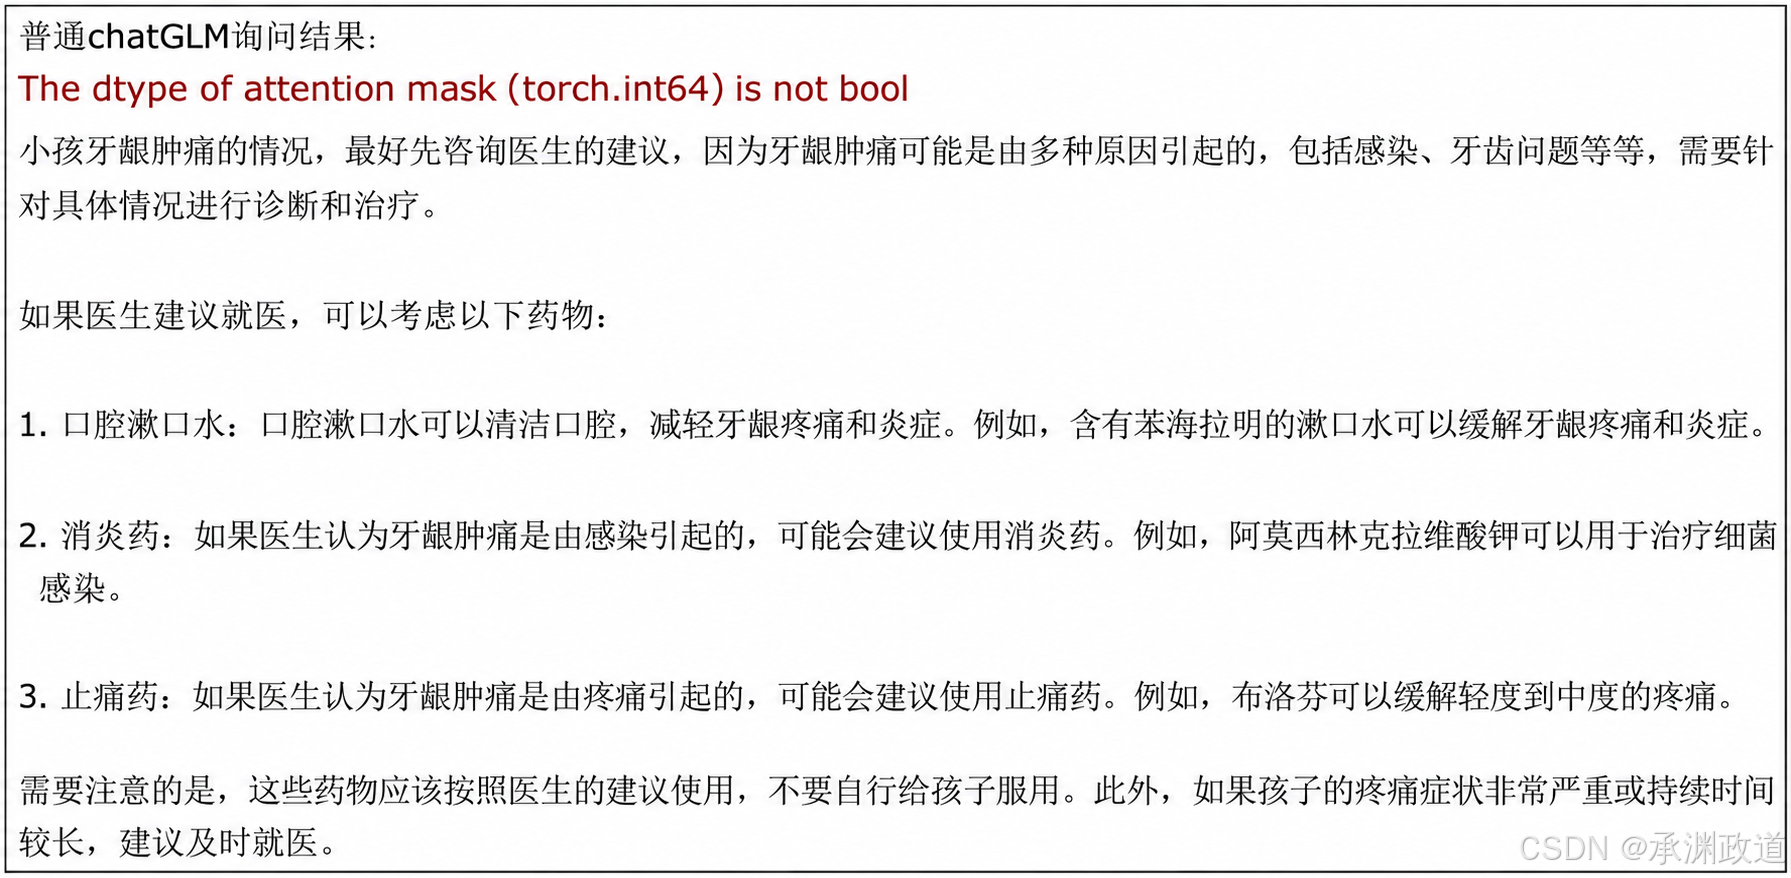
直接使用BM25进行文本查询的结果如图所示.
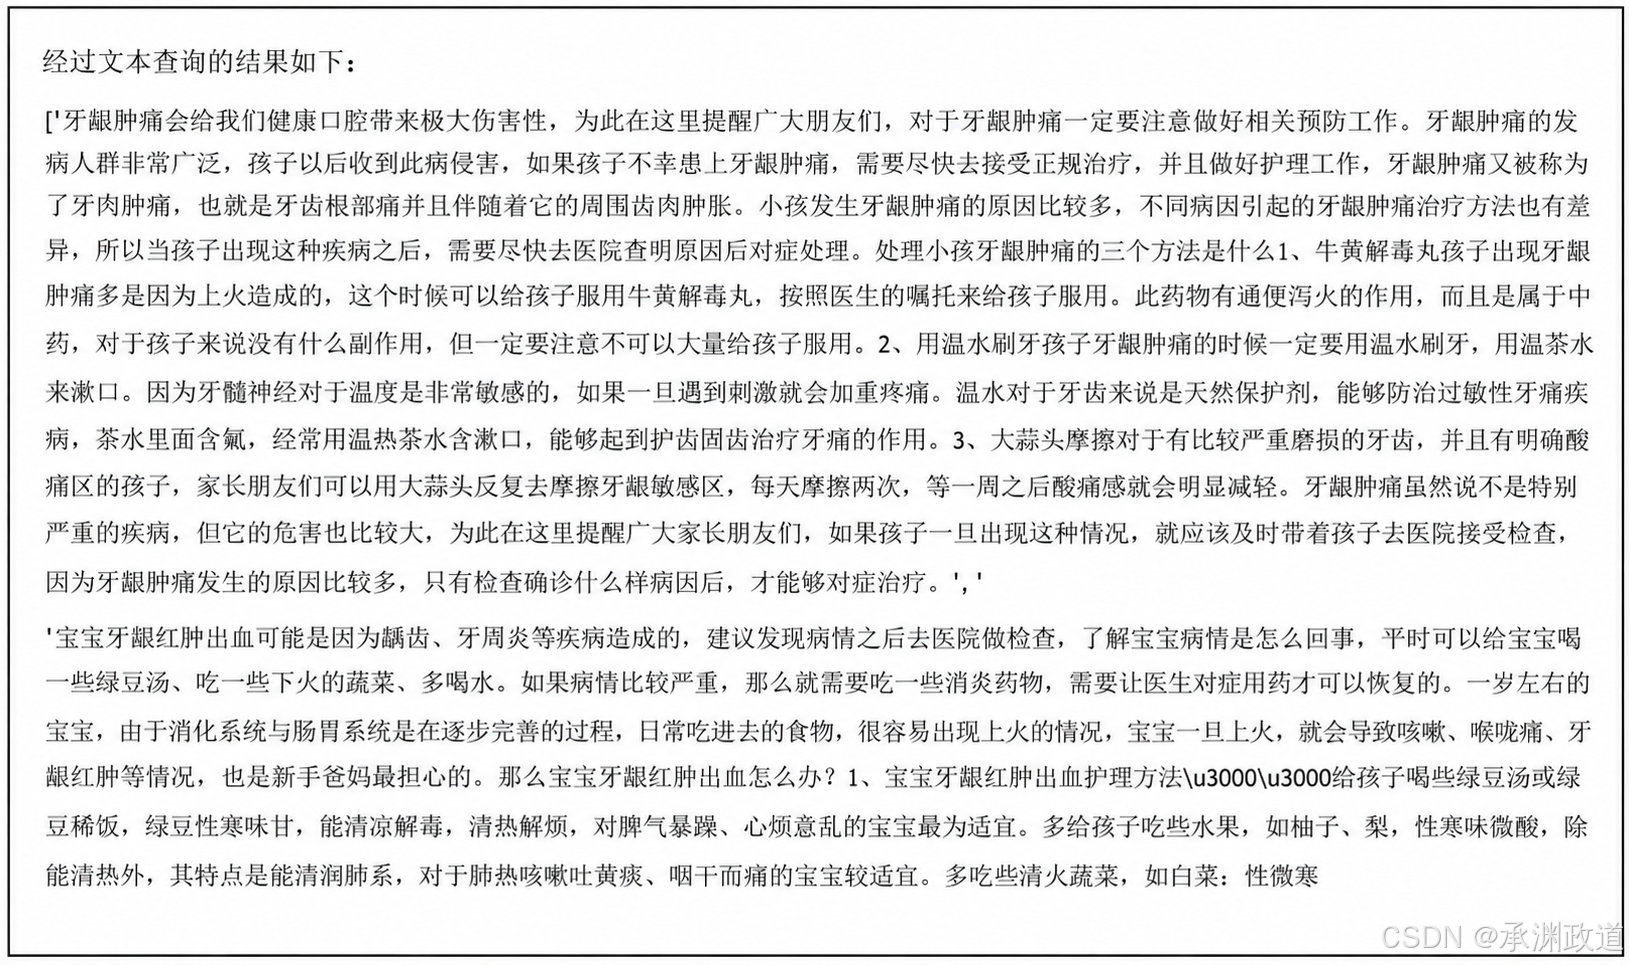
由ChatGLM根据文档查询的结果如图所示.
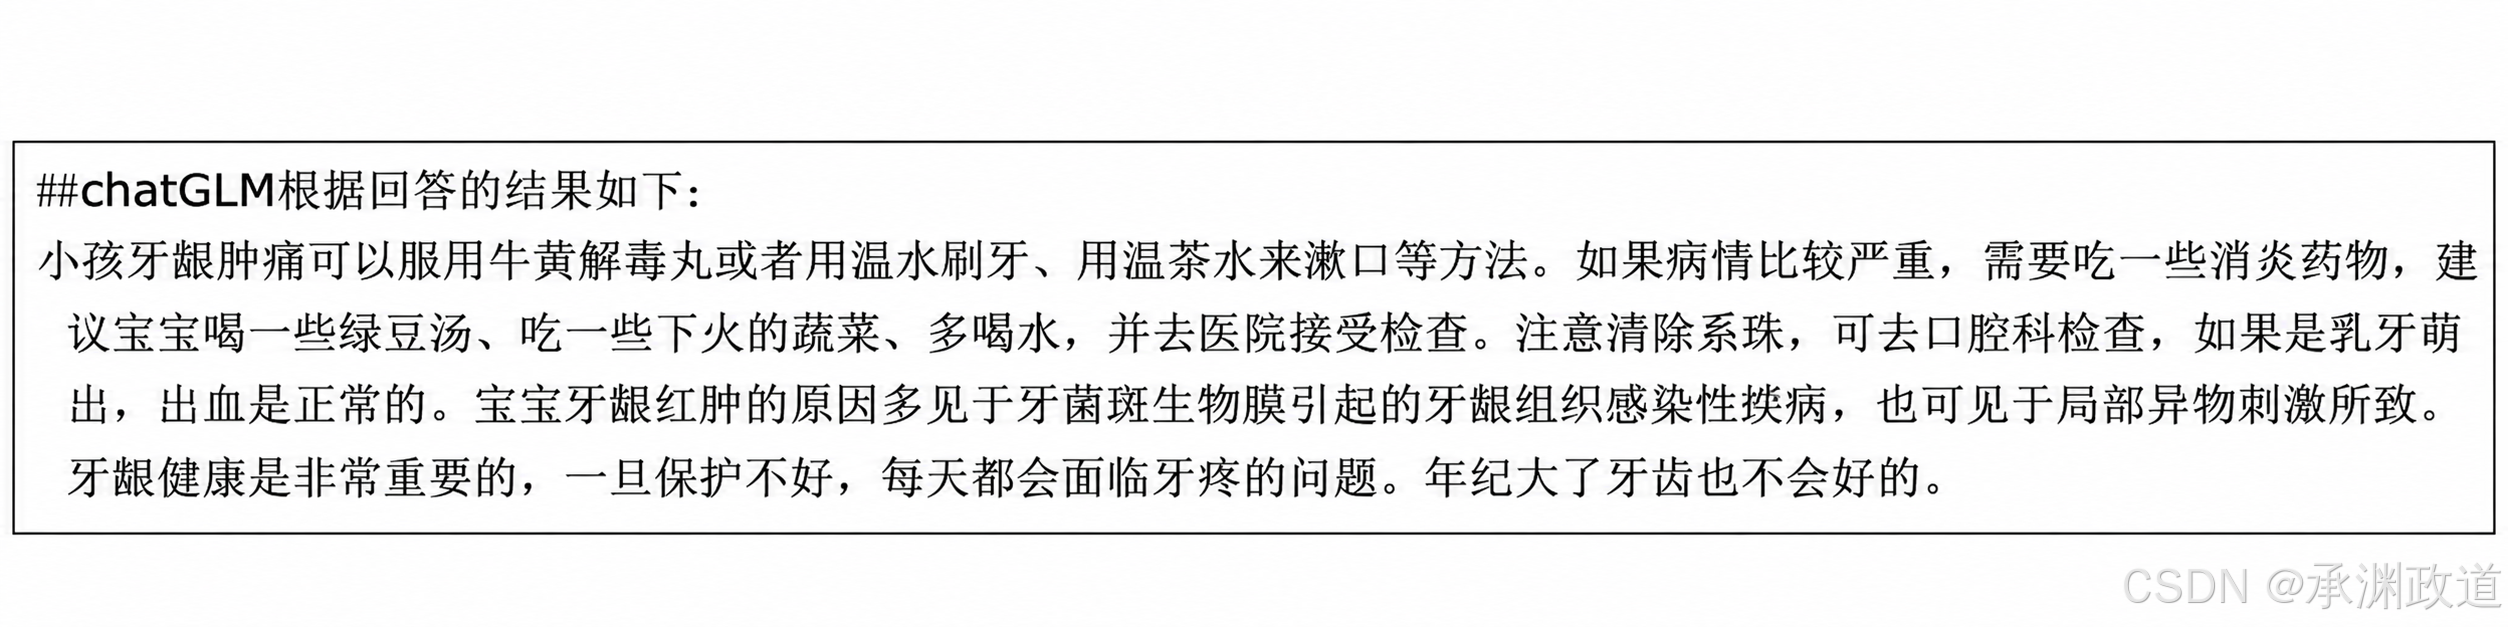
此时我们做一个对比,对于不同条件下的问答,可以很明显地看到,基于提供的文本内容ChatGLM作了较为全面的回复,即采用"牛黄解毒丸"作为最优的解答方案,而不是采用较为经典的回答来答复问题.
2.金融信息抽取实战---基于知识链的ChatGLM本地化知识库检索与智能答案生成
前面介绍了使用ChatGLM搭建专业领域(专业客服)的问答机器人.可以看到,通过相关实战内容可以很好地实现基于单个文本的深度数据分析与提取,但是需要注意的是,这部分专业内容都是由使用者预先发送给ChatGLM,显式地要求其在对应文档中进行读取的.
但是当我们的要求不确定,或者涉及的文档来源不确定时,ChatGLM如何完成知识检索与智能问答呢?
答案就是采用知识链的方式对数据进行提取与整合,由多个模型共同作用,从而实现对目标答案的获取和输出.下面将讲解基于知识链的ChatGLM本地化知识库检索与智能答案生成.
2.1基于ChatGLM搭建智能答案生成机器人的思路
在构建知识链检索机器人之前,我们需要对总体环节进行设置,即构建基于知识链的ChatGLM本地化知识库检索与智能答案生成的机器人需要哪些步骤.
遵循人类的思维习惯,当一个较为专业的问题来临时,首先需要在所有的知识范畴或者知识库中查询所涉及的文档内容,之后阅读相关的文档,从而解析出对应的目标.一个完整的知识链问答流程如图所示.
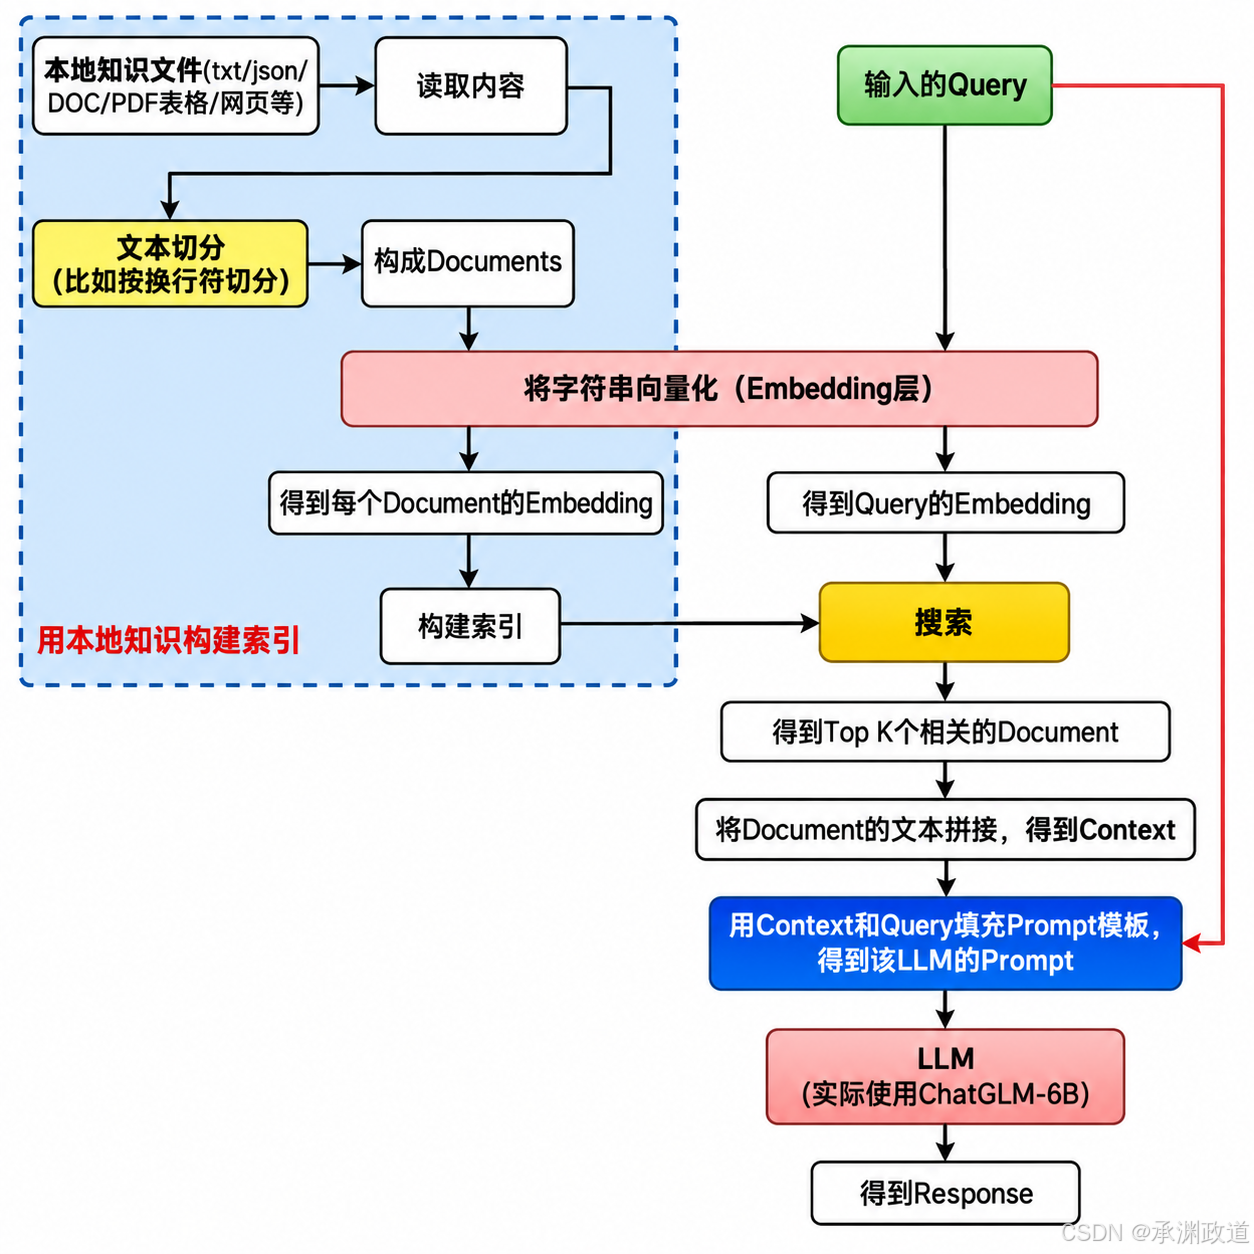
从图可以看到,相对于前面构建的基于专业领域的问答机器人,这里的步骤明显更多.这里将本文的主要内容用浅色框标出,本节首先需要在广泛的文档中找到所要查询的特定文件,然后选择其中之一或者若干文档,通过前面的内容进行完整的推断.
本节的目标是提供一条需要查询的语句:
python
query = ["雅生活服务的人工成本占营业成本的比例是多少"]并且提供若干金融文档,希望阅读这些文档后回答这个简单的问题.提供的文档样式如图所示.
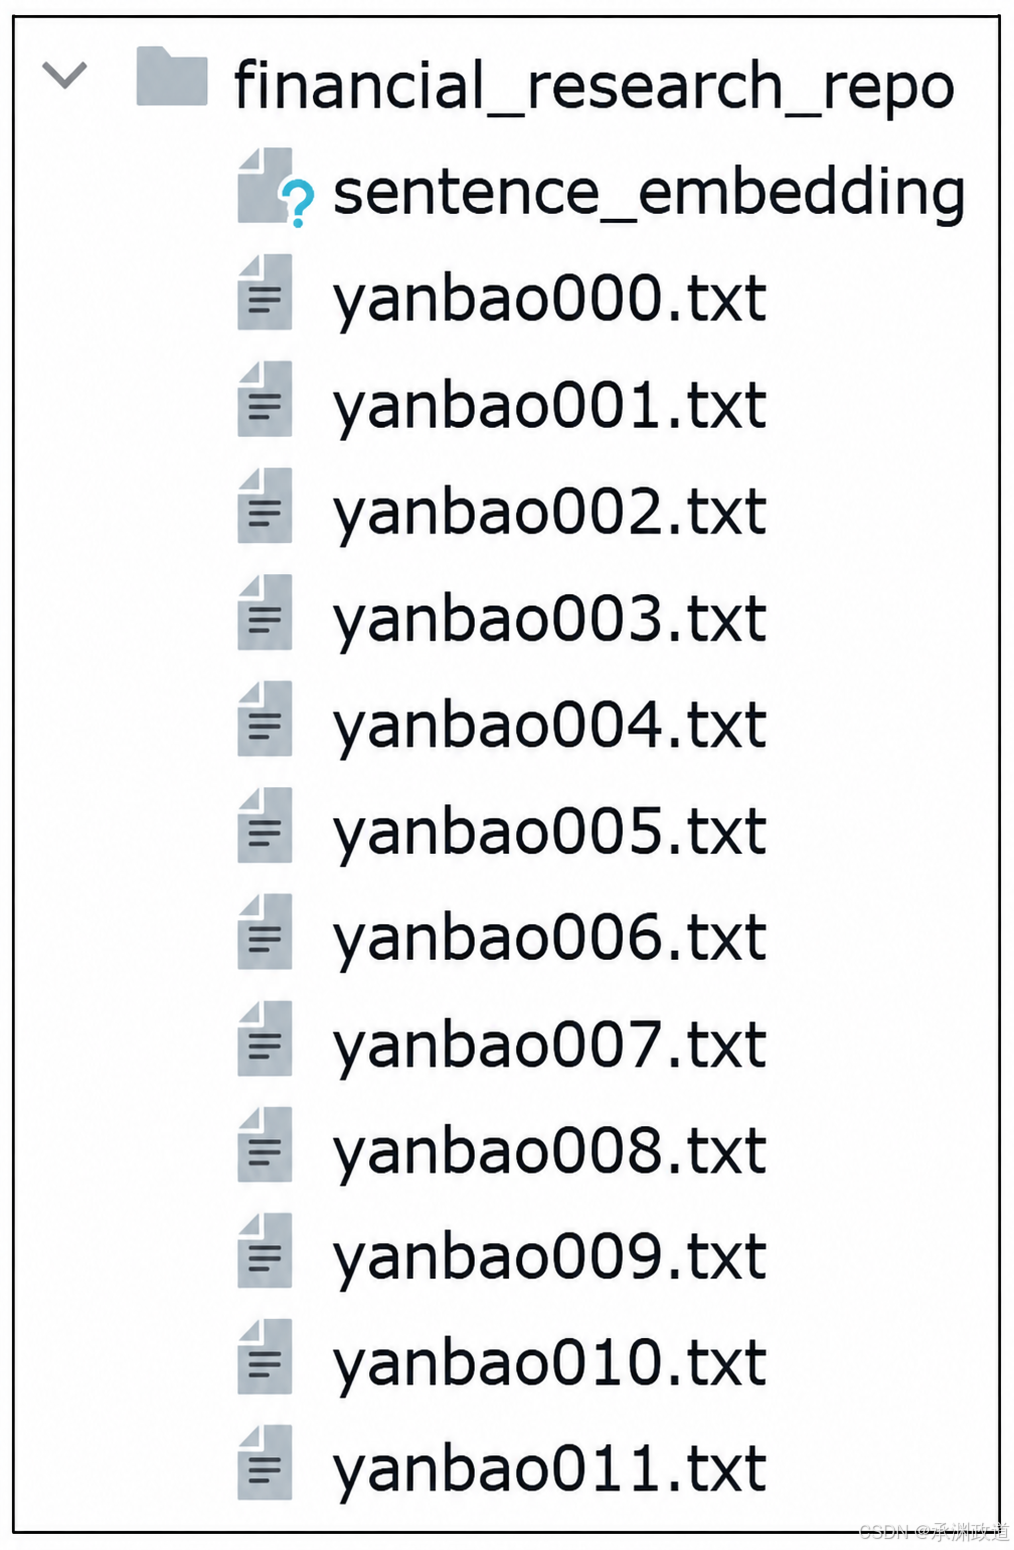
为了增加本节的难度,为需要查询的内容额外添加了干扰文本,分别是yanbao001与yanbao007,可以预先查阅和比较.
2.2获取专业(范畴内)文档与编码存储
在前面的分析中,想要完成一条完整的知识链,首先要根据所提出的问题获取所有涉及的文档.对于此问题的回答,一个非常简单的答案就是将所有的文档"喂"给ChatGLM,之后根据问题要求其回答是否相关.
这样是可行的,但是在实际应用这种方法时一般会产生如下问题:
- 文档长度过长,无法一次性喂给ChatGLM读取.
- 文档数量过多,ChatGLM阅读花费的时间过多.
- 查询内容雷同,使得ChatGLM多次重复阅读相同内容,浪费成本.
- 第一次查询的结果无法存档.
- 产生的结果较为分散,无法聚焦于具体问题.
对于ChatGLM来说,一次性输入较多的文档内容会使得模型产生爆显存的问题;同时,如果文档内容过多,在一定时间内要求阅读过多的文本内容,则会花费大量ChatGLM的时间;再就是当查询的内容相同或类似时,会白白浪费查询成本.对于结果来说,由于ChatGLM本身具有一定的不确定性,对于第一次查询结果的输出可能并不是很确定,缺乏一个统一的标准,产生的结果往往较分散,并且无法对其进行统一标准的存储.因此,仅仅使用ChatGLM完成结果的输出并不合适.
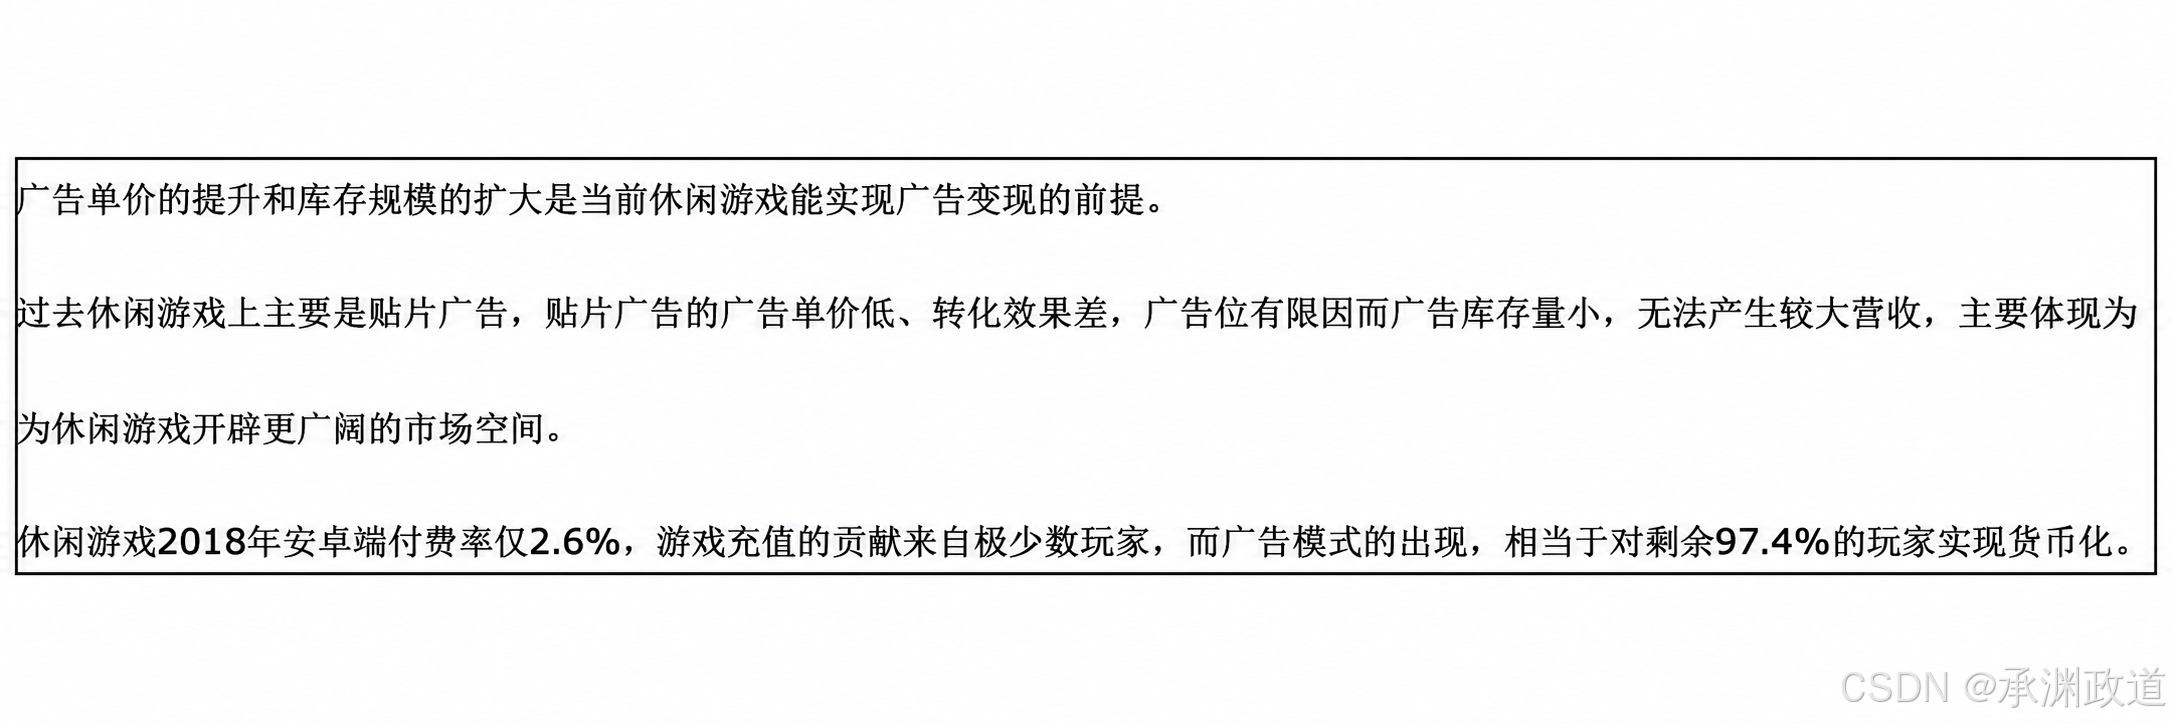
而对于文档级别的文本抽取和比对,目前比较常用的方法是使用深度学习的文档级对比工具来完成,即首先传入文档信息,在文档编码成Embedding后,再将文档信息的编码存储下来,之后通过相关性算法对查询内容的编码和现有存储的编码进行比较.涉及的部分内容如图所示.
下面通过代码实现这部分内容,首先获取完整的文档内容,代码如下:
python
from transformers import BertTokenizer, BertModel
import torch

embedding_model_name = "shibing624/text2vec-base-chinese"
embedding_model_length = 512  # 对于任何长度的文本,模型在处理时都有一个长度限制

# load model from HuggingFace Hub
tokenizer = BertTokenizer.from_pretrained(embedding_model_name)
model = BertModel.from_pretrained(embedding_model_name)

sentences = []

# 这里先对每个文件进行读取
import os

path = "./dataset/financial_research_reports/"
filelist = [path + i for i in os.listdir(path)]

for file in filelist:
    if file.endswith(".txt"):
        with open(file, "r", encoding="utf-8") as f:
            lines = f.readlines()
            lines = "".join(lines)  # 注意这里要做成一个文本
            sentences.append(lines[:embedding_model_length])
需要注意的是,对于任何长度的文本,我们在使用模型进行处理时都有一个特定的输入长度,在这里选用长度为512的文本进行截断,可以根据自己的硬件条件以及对各种深度学习模型的熟悉程度选择不同的长度进行文本截断.
接下来使用深度学习模型对文本进行Embedding处理,本例中选择"shibing624/text2vec-base-chinese"进行文本的Embedding处理,这是一个较常用的文本Embedding化的工具.完整代码如下:
python
kg_vector_stores = {
    '大规模金融研报': './dataset/financial_research_reports',
    '初始化': './dataset/cache',
}  # 可以替换成自己的知识库,如果没有,则需要设置为None

from transformers import BertTokenizer, BertModel
import torch

embedding_model_name = "shibing624/text2vec-base-chinese"
embedding_model_length = 512  # 对于任何长度的文本,都有一个长度限制

# Mean Pooling - 对最终的Embedding结果进行压缩
def mean_pooling(model_output, attention_mask):
    token_embeddings = model_output[0]  # First element of model_output contains all token embeddings
    input_mask_expanded = attention_mask.unsqueeze(-1).expand(
        token_embeddings.size()
    ).float()

    return torch.sum(
        token_embeddings * input_mask_expanded, 1
    ) / torch.clamp(input_mask_expanded.sum(1), min=1e-9)


# 从HuggingFace服务器中加载模型
tokenizer = BertTokenizer.from_pretrained(embedding_model_name)
model = BertModel.from_pretrained(embedding_model_name)

sentences = []

# 这里先对每个文档进行读取
import os

path = "./dataset/financial_research_reports/"
filelist = [path + i for i in os.listdir(path)]

for file in filelist:
    if file.endswith(".txt"):
        with open(file, "r", encoding="utf-8") as f:
            lines = f.readlines()
            lines = "".join(lines)  # 注意这里要做成一个文本
            sentences.append(lines[:embedding_model_length])

# 对文本进行编码
encoded_input = tokenizer(
    sentences,
    padding=True,
    truncation=True,
    return_tensors='pt'
)

# 使用模型进行推断
with torch.no_grad():
    model_output = model(**encoded_input)

# 对推断结果进行均值池化压缩
sentence_embeddings = mean_pooling(
    model_output,
    encoded_input['attention_mask']
)

print("Sentence embeddings:")
print(sentence_embeddings)
print(sentence_embeddings.shape)

import numpy as np

sentence_embeddings_np = sentence_embeddings.detach().numpy()

np.save(
    "./dataset/financial_research_reports/sentence_embeddings_np.npy",
    sentence_embeddings_np
)
可以清楚地看到,对于读取的文本文档内容,模型通常会先对其进行编码化处理,然后针对长度不同的文档内存,通过mean的方式将其压缩成同一幅度大小的Embedding编码,最后对生成的Embedding编码进行存储.
2.3查询文本编码的相关性比较与排序
本小节进行相关性文本的比较与排序.按照前面的分析可知,文本编码的目的是对输入的查询文
本进行比较,计算其相关性排序,从而确定查询文本与已有文本的相关程度.
需要注意的是,这一阶段与上一阶段相似,也要对输入的查询文本内容进行编码,因此需要同样的编码方式.完整的相关性比较代码如下:
python
import numpy
from utils import mean_pooling, compute_sim_score

from transformers import BertTokenizer, BertModel
import torch

embedding_model_name = "shibing624/text2vec-base-chinese"

# Load model from HuggingFace Hub
tokenizer = BertTokenizer.from_pretrained(embedding_model_name)
model = BertModel.from_pretrained(embedding_model_name)

query = ["雅生活服务的人工成本占营业成本的比例是多少"]

# 转化成Token
query_input = tokenizer(
    query,
    padding=True,
    truncation=True,
    return_tensors='pt'
)

# 计算输入Query的Embeddings
with torch.no_grad():
    model_output = model(**query_input)

# Perform pooling. In this case, mean pooling.
query_embedding = mean_pooling(
    model_output,
    query_input['attention_mask']
)

print(query_embedding.shape)

import numpy as np

sentence_embeddings_np = np.load(
    "./dataset/financial_research_reports/sentence_embeddings_np.npy"
)

for i in range(len(sentence_embeddings_np)):
    score = compute_sim_score(
        sentence_embeddings_np[i],
        query_embedding[0]
    )
    print(i, score)
从代码来看,首先将文本转换成Token格式,之后使用模型计算Query的Embedding编码,最后将查询Query的Embedding编码与上一步存档的Embedding编码内容进行相关性计算.
前面使用BM25完成了文本的相关性计算,并且提供了相关性计算的公式.可以认为BM25是前面介绍的TF-IDF的一个变种,它基于字符出现的频率计算不同文本之间的相关性.
我们现在需要计算的目标并不是一系列的长字符,更倾向于对文本内容的语义理解,因此在这个阶段的相关性计算上,需要使用单独的计算方法来计算涉及语义的文本相关性问题.
对于文本相似度计算,研究人员在自然语言处理中提出了多种解决方案,其中最常用的是文本的余弦相似度计算,公式如下:
similarity ( A , B ) = A ⋅ B ∥ A ∥ × ∥ B ∥ = ∑ i = 1 n A i × B i ∑ i = 1 n A i 2 × ∑ i = 1 n B i 2 \operatorname{similarity}(A,B) =\frac{A\cdot B}{\|A\|\times\|B\|} =\frac{\sum_{i=1}^{n}A_i\times B_i} {\sqrt{\sum_{i=1}^{n}A_i^2}\times\sqrt{\sum_{i=1}^{n}B_i^2}} similarity(A,B)=∥A∥×∥B∥A⋅B=∑i=1nAi2 ×∑i=1nBi2 ∑i=1nAi×Bi
公式中A和B分别代表文本A和文本B构成的编码向量,后续通过计算这个编码向量的值,从而计算出两个文本之间的相关性(相似度).其实现代码如下:
python
import numpy as np
     def compute_sim_score( v1: np.ndarray, v2: np.ndarray) -> float:
     return v1.dot(v2) / (np.linalg.norm(v1) * np.linalg.norm(v2))
对查询文本和存储文本进行相关性比较的完整代码如下:
python
import numpy
from utils import mean_pooling, compute_sim_score
from transformers import BertTokenizer, BertModel
import torch

embedding_model_name = "shibing624/text2vec-base-chinese"

# Load model from HuggingFace Hub
tokenizer = BertTokenizer.from_pretrained(embedding_model_name)
model = BertModel.from_pretrained(embedding_model_name)

query = ["雅生活服务的人工成本占营业成本的比例是多少"]

# 对文本进行编码
query_input = tokenizer(
    query,
    padding=True,
    truncation=True,
    return_tensors='pt'
)

# 使用模型进行推断
with torch.no_grad():
    model_output = model(**query_input)

# 对推断结果进行均值池化压缩
query_embedding = mean_pooling(
    model_output,
    query_input['attention_mask']
)

print(query_embedding.shape)

import numpy as np

sentence_embeddings_np = np.load(
    "./dataset/financial_research_reports/sentence_embeddings_np.npy"
)

# 依次计算不同的句向量相似度
for i in range(len(sentence_embeddings_np)):
    score = compute_sim_score(
        sentence_embeddings_np[i],
        query_embedding[0]
    )
    print(i, score)
最终打印结果如图所示.
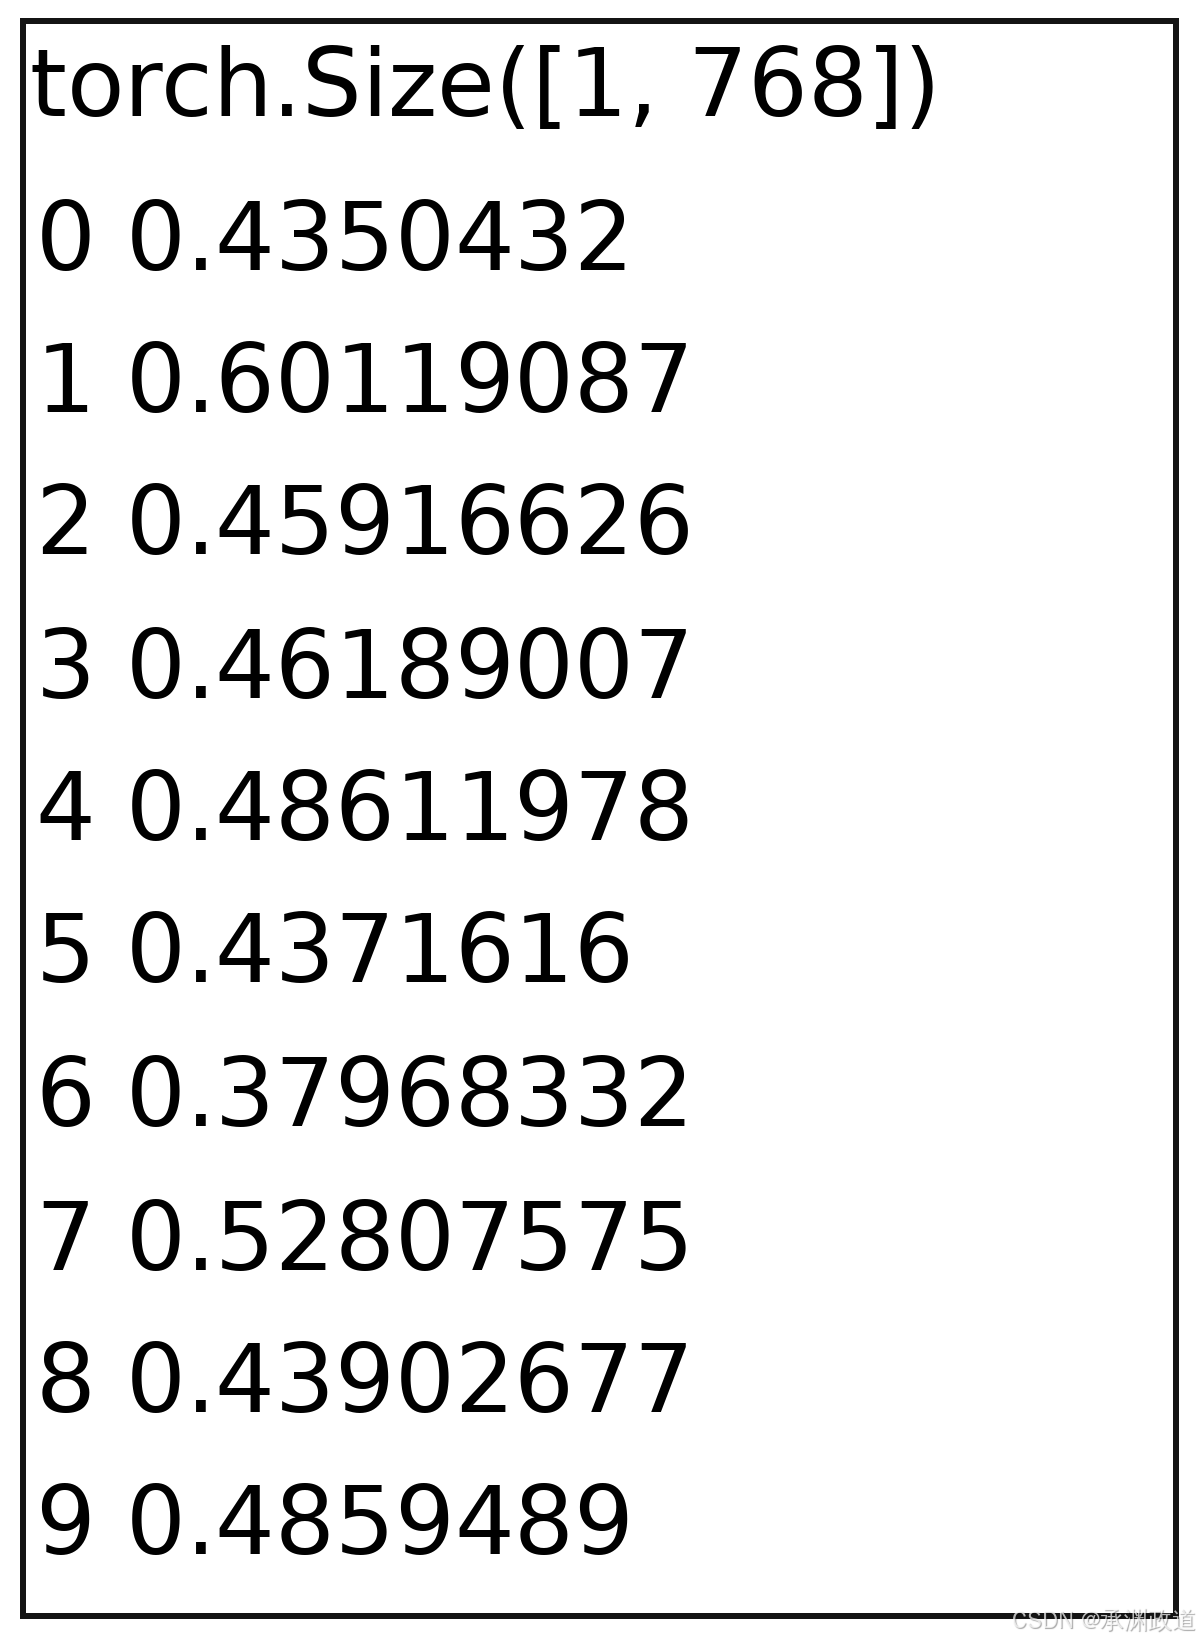
这里只截取了部分结果,可以看到前两名的分数排名分别是研报1和研报7,在读取前期对研报1和研报7的内容都进行了阅读,发现研报1和研报7虽然都涉及我们所查询的目标,但是其侧重点不同,相对于研报7的内容,研报1包含更多我们所需要的目标.
2.4基于知识链的ChatGLM本地化知识库检索与智能答案生成
相信经过前面的分析,对于在多个文档中查找最相关的文档有了一定的了解.接下来将查找到
的相关文档重新进行文本比对,将与问题最相关的若干条文档内容输入ChatGLM中,阅读并反馈查询问题的答案.
这部分工作较简单,可以参考前面的讲解完成这部分内容的学习.需要注意的是,我们查询的问题可能并不存在于输入的文本内容中,对于某些问题,ChatGLM会根据以往的训练内容自动生成答案,但是这个答案可能并不是我们想要的,只是依靠文档内容得到的.因此,在这里创建相关的Prompt时,需要显式地告诉ChatGLM不可以凭借经验或者以往的训练内容来回答问题.Prompt的设置如下:
python
prompt = f'严格根据文档内容来回答问题,回答不允许编造成分要符合原文内容,问题是"{question}",文档
内容如下:\n'
下面给出基于知识链的ChatGLM本地化知识库检索与智能答案生成模型的完整代码.
knowledge_chain_chatGLM_step0代码如下:
python
kg_vector_stores = {
    '大规模金融研报': './dataset/financial_research_reports',
    '初始化': './dataset/cache',
}  # 可以替换成自己的知识库,如果没有,则需要设置为None

from transformers import BertTokenizer, BertModel
import torch

embedding_model_name = "shibing624/text2vec-base-chinese"
embedding_model_length = 512  # 对于任何长度的文本,都有一个长度限制

# Mean Pooling - Take attention mask into account for correct averaging
def mean_pooling(model_output, attention_mask):
    token_embeddings = model_output[0]  # First element of model_output contains all token embeddings

    input_mask_expanded = attention_mask.unsqueeze(-1).expand(
        token_embeddings.size()
    ).float()

    return torch.sum(
        token_embeddings * input_mask_expanded, 1
    ) / torch.clamp(input_mask_expanded.sum(1), min=1e-9)


# Load model from HuggingFace Hub
tokenizer = BertTokenizer.from_pretrained(embedding_model_name)
model = BertModel.from_pretrained(embedding_model_name)

sentences = []

# 这里先对每个文档进行读取
import os

path = "./dataset/financial_research_reports/"
filelist = [path + i for i in os.listdir(path)]

for file in filelist:
    if file.endswith(".txt"):
        with open(file, "r", encoding="utf-8") as f:
            lines = f.readlines()
            lines = "".join(lines)  # 注意这里要做成一个文本
            sentences.append(lines[:embedding_model_length])

# Tokenize sentences
encoded_input = tokenizer(
    sentences,
    padding=True,
    truncation=True,
    return_tensors='pt'
)

# Compute token embeddings
with torch.no_grad():
    model_output = model(**encoded_input)

# Perform pooling. In this case, mean pooling.
sentence_embeddings = mean_pooling(
    model_output,
    encoded_input['attention_mask']
)

print("Sentence embeddings:")
print(sentence_embeddings)
print(sentence_embeddings.shape)

import numpy as np

sentence_embeddings_np = sentence_embeddings.detach().numpy()

np.save(
    "./dataset/financial_research_reports/sentence_embeddings_np.npy",
    sentence_embeddings_np
)
knowledge_chain_chatGLM_step1代码如下:
python
import numpy
from utils import mean_pooling, compute_sim_score

from transformers import BertTokenizer, BertModel
import torch

embedding_model_name = "shibing624/text2vec-base-chinese"

# Load model from HuggingFace Hub
tokenizer = BertTokenizer.from_pretrained(embedding_model_name)
model = BertModel.from_pretrained(embedding_model_name)

query = ["雅生活服务的人工成本占营业成本的比例是多少"]

# Tokenize sentences
query_input = tokenizer(
    query,
    padding=True,
    truncation=True,
    return_tensors='pt'
)

# Compute token embeddings
with torch.no_grad():
    model_output = model(**query_input)

# Perform pooling. In this case, mean pooling.
query_embedding = mean_pooling(
    model_output,
    query_input['attention_mask']
)

print(query_embedding.shape)

import numpy as np

sentence_embeddings_np = np.load(
    "./dataset/financial_research_reports/sentence_embeddings_np.npy"
)

# 依次计算不同的句向量相似度
for i in range(len(sentence_embeddings_np)):
    score = compute_sim_score(
        sentence_embeddings_np[i],
        query_embedding[0]
    )
    print(i, score)
knowledge_chain_chatGLM_step2代码如下:
python
import utils

query = ["雅生活服务的人工成本占营业成本的比例是多少"]

context_list = []

with open("./dataset/financial_research_reports/yanbao001.txt", "r", encoding="UTF-8") as f:
    lines = f.readlines()
    for line in lines:
        line = line.strip()
        context_list.append(line)

print("经过文本查询的结果如下:")
sim_results = utils.get_top_n_sim_text(
    query=query[0],
    documents=context_list
)
print(sim_results)
print("-----------------------------------------")

from transformers import AutoTokenizer, AutoModel

tokenizer = AutoTokenizer.from_pretrained(
    "THUDM/chatglm-6b",
    trust_remote_code=True
)

model = AutoModel.from_pretrained(
    "THUDM/chatglm-6b",
    trust_remote_code=True
).half().cuda()

print("由ChatGLM根据文档的严格回答的结果如下:")

prompt = utils.strict_generate_prompt(query[0], sim_results)

response, _ = model.chat(
    tokenizer,
    prompt,
    history=[]
)

print(response)
print("-----------------------------------------")
3.基于ChatGLM的一些补充内容
前面较少涉及Prompt,下面将着重介绍此方面的内容.
3.1语言的艺术------Prompt的前世今生
通过前面的演示,应该对Prompt有了一定的了解,即通过输入特定的"语言组合",使得模型能够更好地适配各种任务.因此,合适的Prompt对于模型的效果至关重要.大量研究表明,Prompt的微小差别可能会造成效果的巨大差异.研究者就如何设计Prompt做出了各种各样的努力,如自然语言背景知识的融合、契合目标的约束条件、不再拘泥于语言形式的Prompt探索等,如图所示.
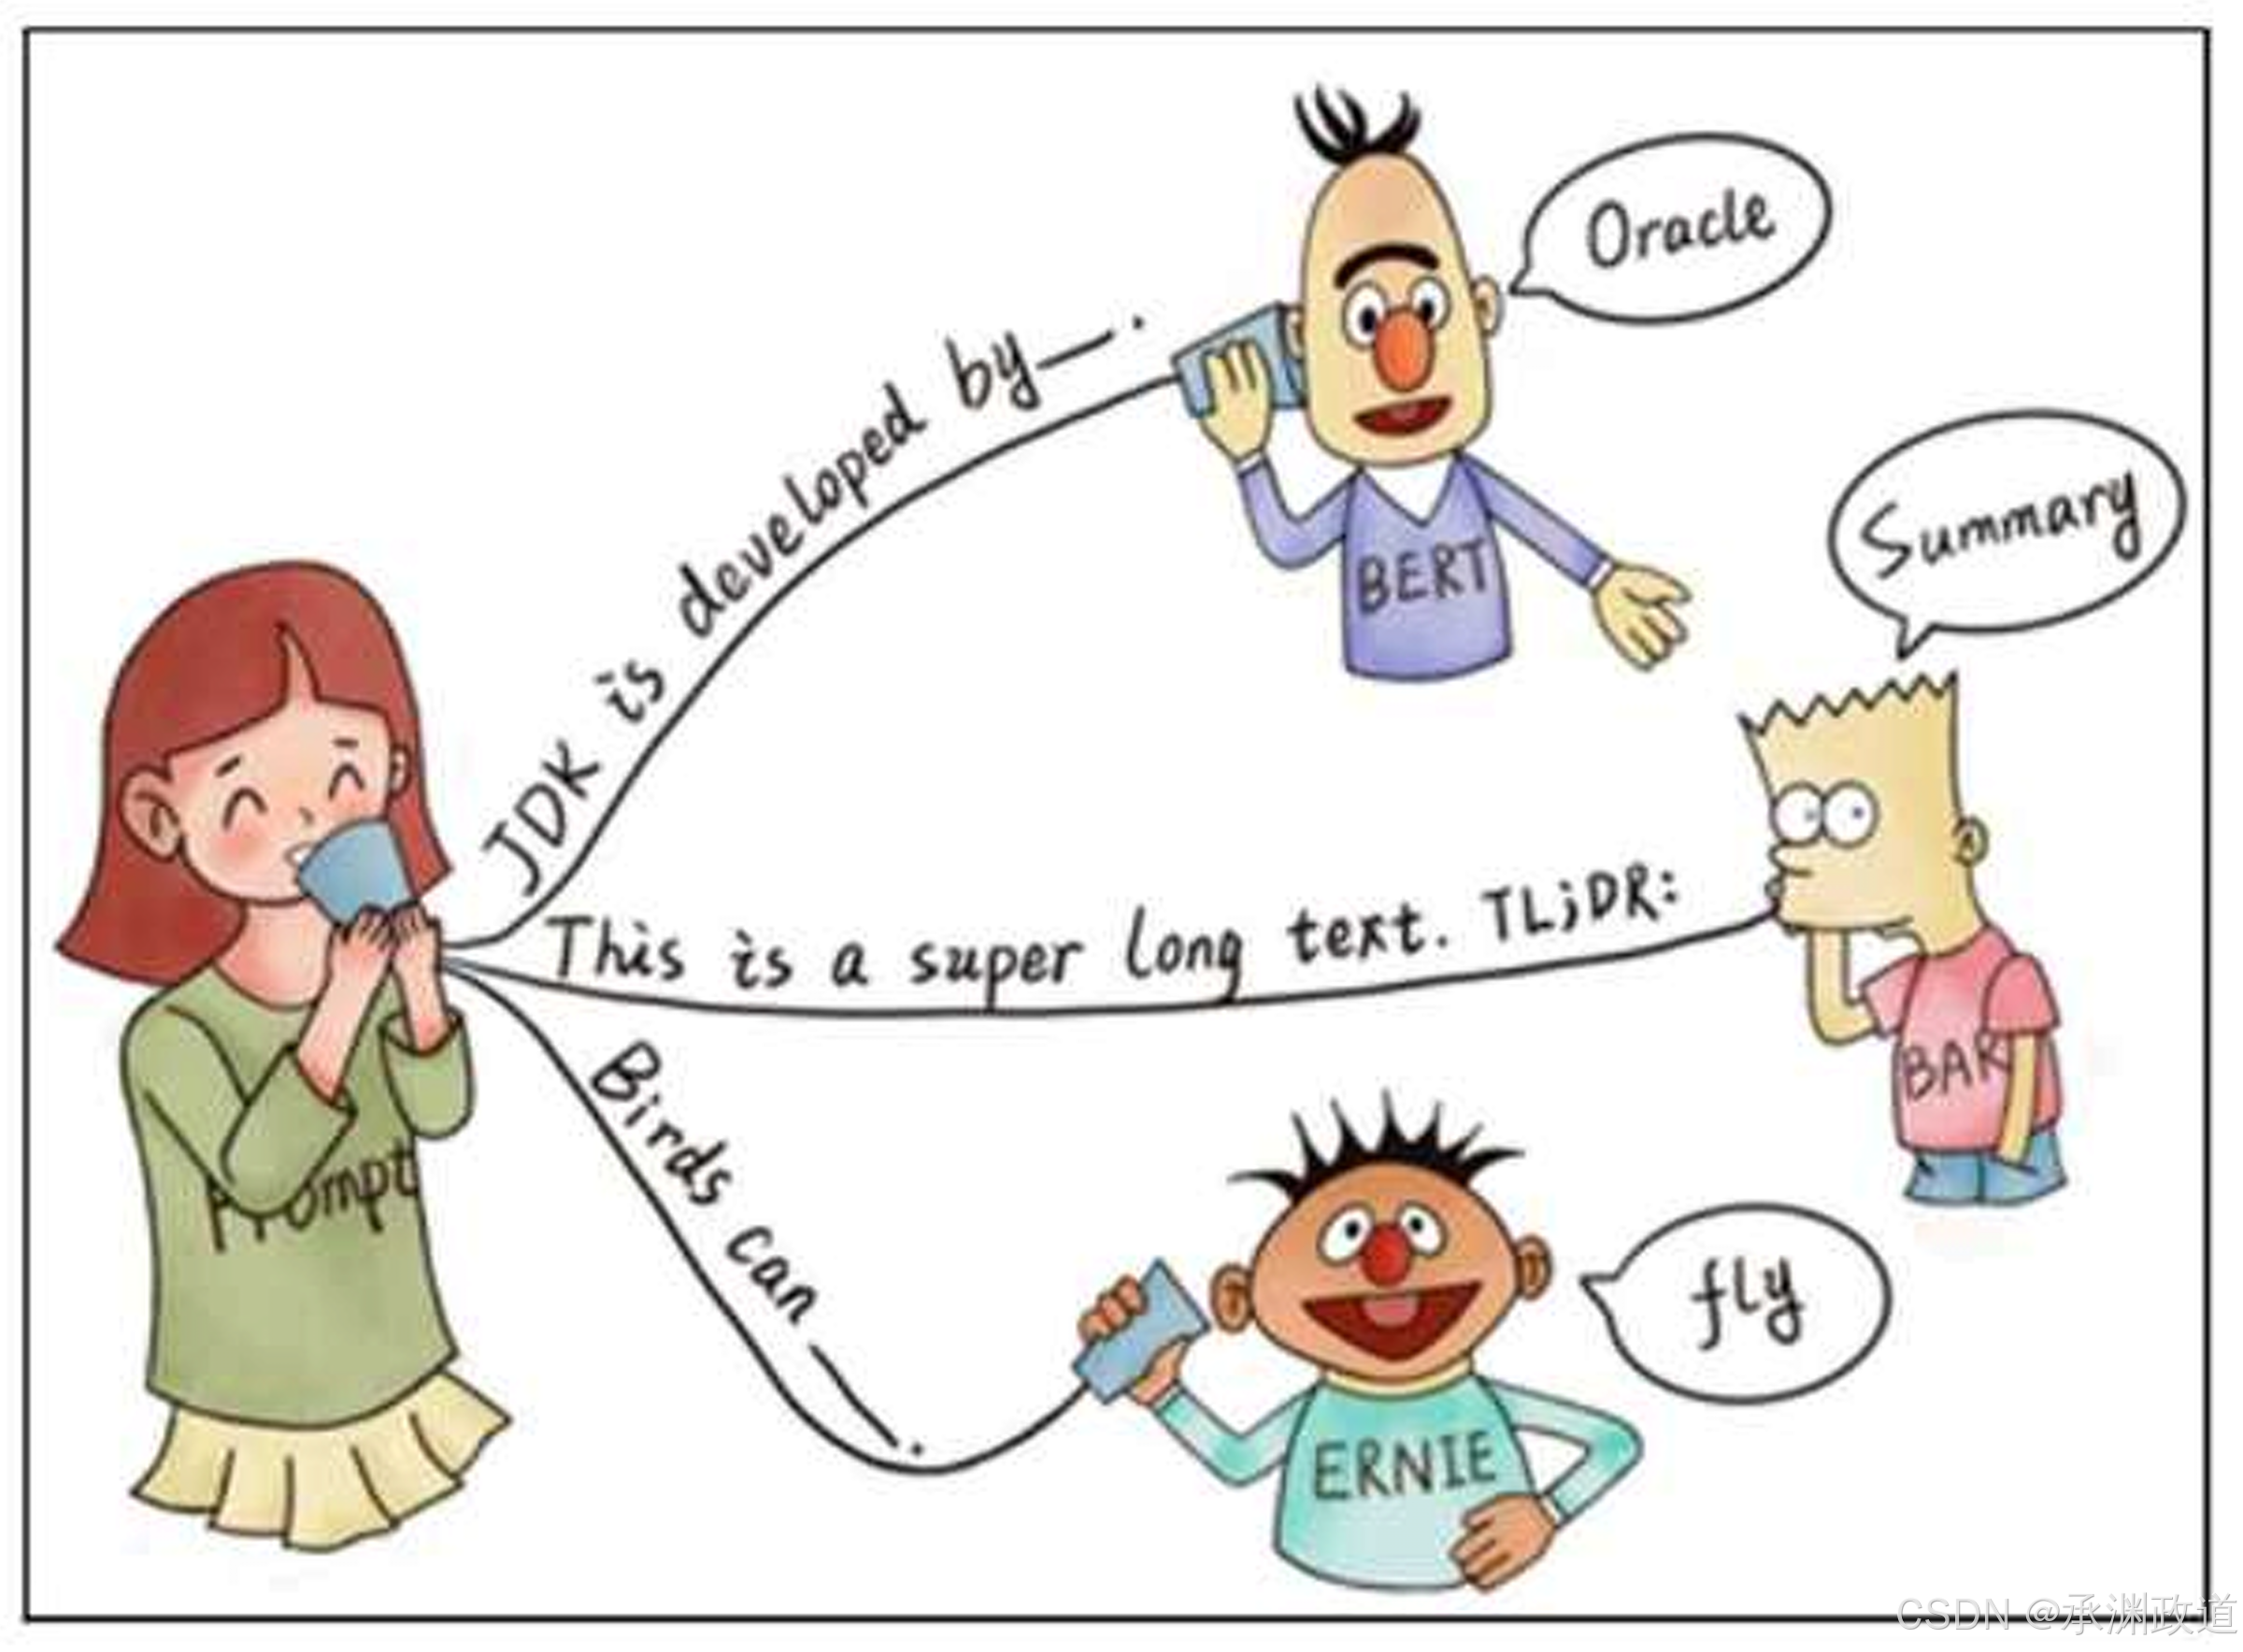
Prompt刚刚出现的时候,还不叫作Prompt,它只是研究人员为了下游任务设计出来的一种输入形式或模板,它能够帮助语言模型"回忆"起自己在预训练时"学习"到的东西,因此逐渐被称呼为Prompt.
例如,在对电影评论进行二分类的时候,最简单的提示模板是". It was mask.",但是该模板并没
有突出该任务的具体特性,我们可以为其设计一个能够突出该任务特性的模板,例如"The movie review is . It was mask.",然后根据mask位置的输出结果映射到具体的标签上.
可以看到,在实际应用中,用户最常用到的就是Prompt设计,其设计需要考虑以下两项内容:
- Prompt的适配.
- 设计Prompt模板.
1.Prompt的适配
Prompt的形状主要指的是任务的目标和类型.Prompt在实际应用中选择哪一种,主要取决于任务的形式和模型的类别.一般来说,完形填空类型的Prompt和遮蔽语言模型的训练方式非常类似,因此,对于使用遮蔽语言模型的任务来说,完形填空类型的Prompt更加合适;对于生成任务来说,或者使用自回归语言模型解决的任务,带有提问的Prompt更加合适;全文生成类型的Prompt较为通用,因此对于多种任务,全文生成类型的Prompt均适用.另外,对于文本分类任务,Prompt模板通常采用的是问答的形式.
2.设计Prompt模板
Prompt最开始就是从手工设计模板开始的.模板设计一般基于人类的自然语言知识,力求得到语义流畅且高效的模板.由于大型语言模型在预训练过程中见过了大量的人类世界的自然语言,很自然地受到了影响,因此在设计模板时需要符合人类的语言习惯.
对于Prompt的研究和探索是基于自然语言处理大模型发展而来的,其主要作用是引导模型的内容生成,先定角色,后说背景,再提要求,最后定风格.这是Prompt设计和使用的基本方法,展开详细介绍的话就是另一本实战方面的了,因此这里不再过多阐述,相信后续会持续与Prompt进行交流,从而掌握更多的使用方法和技巧.
3.2清华大学推荐的ChatGLM微调方法
下面使用Linux系统完成对ChatGLM的微调,注意这里只简单介绍,更多微调相关内容请参考之后的内容.
在学习了使用ChatGLM进行文本问答或者文本抽取后,相信大家一定想要尝试更多的场景,一个非常简单的想法是利用其生成一些广告文案来辅助我们的日常工作.
但是问题在于,对于部分特定的文本生成或者问答,原有的ChatGLM由于没有学习过对应的内容,因此在生成的时候可能并不会生成所需要的目标文档.为了解决这个问题,ChatGLM官方给我们提供了对应的微调方案,P-Tuning就是一种对预训练语言模型进行少量参数微调的技术.
所谓预训练语言模型,是指在大规模的语言数据集上训练好的、能够理解自然语言表达并从中学习语言知识的模型.P-Tuning所做的就是根据具体的任务对预训练的模型进行微调,让它更好地适应具体的任务.相比于重新训练一个新的模型,微调可以大大节省计算资源,同时也可以获得更好的性能表现.
一次训练迭代会以1的批处理大小进行16次累加的前后向传播,等效为16的总批处理大小,此时最低只需6.7GB显存.若想在同等批处理大小下提升训练效率,则可在二者乘积不变的情况下加大per_device_train_batch_size的值,但这样会带来更多的显存消耗,请根据实际情况酌情调
整.
至于使用模型进行推理,在推理时需要同时加载原ChatGLM-6B模型以及PrefixEncoder的权重,可以使用evaluate.sh脚本,其中要特别注意参数部分,此时需要载入训练后的参数,最后还要提醒一下,这里的微调是基于Linux操作系统的,更详细的微调方案将在后文详细讲解.
3.3一种新的基于ChatGLM的文本检索方案
首先来回顾一下前面是如何基于ChatGLM进行文档问答的,其中心思路是"先检索,再整合",大
致思路如下:
- 首先准备好文档,把每个文档切成若干小的模块.
- 调用文本转向量的接口,将每个模块转为一个向量,并存入向量数据库.
- 当用户发来一个问题的时候,将问题同样转为向量,并检索向量数据库,得到相关性最高的一个模块.
- 将问题和检索结果合并重写为一个新的请求发给ChatGLM进行文档问答.
这里实际上是将用户请求的Query和Document进行匹配,也就是所谓的问题-文档匹配.问题-文档匹配的问题在于问题和文档在表达方式上存在较大差异.
通常Query以疑问句为主,而Document则以陈述说明为主,这种差异可能会影响最终匹配的效果.一种改进方法是,跳过问题和文档匹配部分,先通过Document生成一批候选的问题-答案匹配,当用户发来请求的时候,首先是把Query和候选的Question进行匹配,进而找到相关Document片段,此时的具体思路如下:
- 首先准备好文档,并整理为纯文本的格式,把每个文档切成若干个小的模块.
- 调用ChatGLM的API,根据每个模块生成5个候选的Question,使用的Prompt格式为"请根据下面的文本生成5个问题:......".
- 调用文本转向量的接口,将生成的Question转为向量,存入向量数据库,记录Question和原始模块的对应关系.
- 当用户发来一个问题的时候,将问题同样转为向量,并检索向量数据库,得到相关性最高的一个
Question,进而找到对应的模块. - 将问题和模块合并重写为一个新的请求发给ChatGLM进行文档问答.
限于篇幅,这就不具体实现了,请自行尝试完成.
4.小结
本文介绍了ChatGLM的高级应用,即基于知识链的多专业跨领域文档挖掘的方法.这是目前有关ChatGLM甚至自然语言处理大模型领域最前沿的研究方向.除了本文中讲解的两个例子外,基于大模型的应用场景涵盖自然语言处理、计算机视觉、推荐系统、医疗健康、智能交通、金融服务等多个领域.
这些场景需要使用大规模的深度学习模型,并在大规模计算环境中进行训练和推理,以提高精度和效率.本文只是抛砖引玉,相信在学习完后,会对大模型的应用有进一步的了解,并且可以开发出更多基于深度学习大模型的应用.
🚀真正的勇者不是流泪的人,而是含泪奔跑的人!
敬请期待下一篇文章内容
每日心灵鸡汤: 家庭对儿女的不同期待,背后藏着怎样的生存逻辑?
有人问我,谈下"穷养儿、富养女"这个观点?其实,是传统资源匮乏家庭里形成的一套生存策略:对男孩所谓"穷养",本质是希望他更早承受压力、更早独立、更早出去赚钱,因为传统家庭默认男性未来要承担更多经济责任;对女孩所谓"富养",很多时候也不是为了真正提高她的认知、能力和选择权,而是希望她见过一点好的生活以后,未来选择伴侣时,更看重对方有没有足够的经济能力,甚至通过婚姻完成家庭资源的向上迁移.所以这里的"穷"和"富",本质上都围绕资源配置:男孩被要求成为资源生产者,女孩被期待找到更强的资源提供者.真正的教育应该反过来:无论男女,都应该拥有自己创造财富的能力,也都应该拥有不因为财富而轻易依附一个人的判断力和选择权.