一、为什么需要知识蒸馏
BERT 语义能力强,但参数量约 102M,模型文件约 390MB。直接部署会带来较大的内存占用和推理成本。
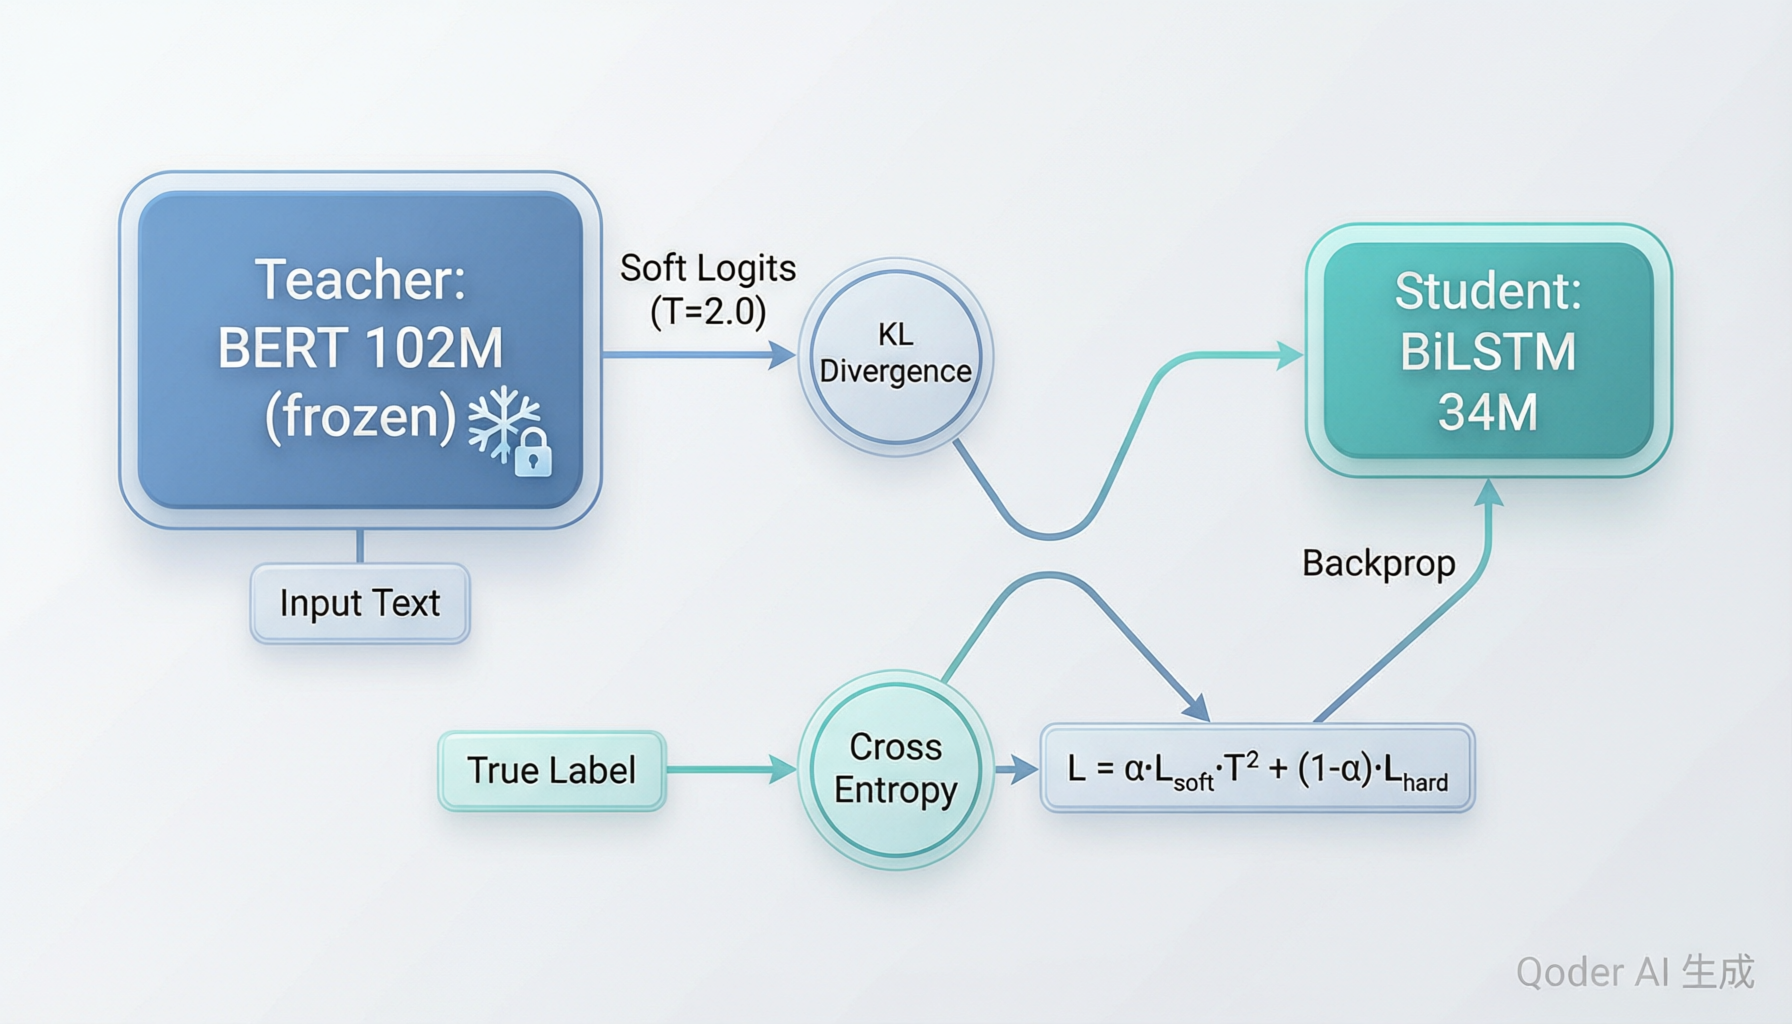
知识蒸馏的目标是:使用 BERT 作为教师模型,让更轻量的 BiLSTM 学习教师模型的输出知识,在尽量保留效果的同时降低部署成本。
二、教师模型与学生模型
text
教师模型:BERT-base-chinese,约 102M 参数
学生模型:BiLSTM,约 34M 参数
学生模型复用 BERT 词表,通过 Embedding、双向 LSTM 和全连接层完成分类。
三、软标签与硬标签
普通训练只使用真实标签,例如"物流问题"。这叫硬标签。
教师模型输出的不只是最终类别,还会输出每个类别的概率分布。例如:物流 0.70、质量 0.20、客服 0.08、虚假营销 0.02。这种分布包含类别之间的相似关系,叫软标签。
蒸馏训练同时学习两种信息:
text
教师输出 -> 软损失
真实标签 -> 硬损失
四、蒸馏损失
text
L = alpha * L_soft * T^2 + (1 - alpha) * L_hardL_soft:学生模仿教师概率分布的 KL 散度;L_hard:学生对真实标签的交叉熵;T:温度参数,用于软化概率分布;alpha:软损失权重。
推荐的标准实现如下:
python
with torch.no_grad():
    teacher_logits = teacher_model(input_ids, attention_mask)

student_logits = student_model(input_ids, attention_mask)

student_log_probs = F.log_softmax(
    student_logits / temperature, dim=-1
)
teacher_probs = F.softmax(
    teacher_logits / temperature, dim=-1
)

soft_loss = F.kl_div(
    student_log_probs,
    teacher_probs,
    reduction="batchmean",
) * temperature ** 2

hard_loss = F.cross_entropy(student_logits, labels)
loss = alpha * soft_loss + (1 - alpha) * hard_loss
教师模型使用 eval() 和 no_grad(),学生模型才参与反向传播。
五、蒸馏效果
现有实验资料显示:
| 任务 | BERT | 蒸馏 BiLSTM | 结果 |
|---|---|---|---|
| 投诉分流 Accuracy | 88.8% | 89.3% | 小幅提升 |
| 广告检测 Accuracy | 98.4% | 95.5% | 有一定损失 |
学生模型参数量约为教师模型的三分之一,模型体积也明显降低。
六、为什么学生模型可能超过教师模型
这并不意味着学生模型全面强于教师模型。可能原因包括:
- 教师模型在当前数据上存在过拟合;
- 蒸馏软标签提供了额外正则化;
- 学生模型结构更适合当前短文本任务;
- 单次实验存在随机波动。
严谨比较时应使用多个随机种子并报告均值和方差。
七、项目中遇到的实现问题
不同蒸馏脚本对 KL 散度输入处理不完全一致。标准做法是学生输入 log_softmax,教师输入 softmax,并乘以 T^2。实际工程中应统一实现,避免数学定义和代码行为不一致。
八、总结
知识蒸馏的核心不是简单复制预测结果,而是让轻量学生模型学习教师模型的概率分布和决策信息。它体现了 AI 工程中"精度、延迟、模型大小三者平衡"的思想。