TIP 2026
自监督图像融合
SSVIF:没有标签也可以学习语义
自监督
PAPER SHARE
SSVIF的自监督语义注入
IEEE TIP 2026 · Visible-Infrared Fusion · Self-Supervised Segmentation
一句话读懂: SSVIF解决了实际存在的一个问题:传统的融合方法对下游的任务没有关心,但是任务导向的融合又需要大量的分割标签。它通过两条不同的路径得到的分割预测相互制约,把语义监督由原来的"人工标签"变成现在的"跨分割一致性"。
论文 SSVIF: Self-Supervised Segmentation-Oriented Visible and Infrared Image Fusion
作者 Zixian Zhao, Xingchen Zhang*
论文链接 https://ieeexplore.ieee.org/document/11570838
单位 Fusion Intelligence Laboratory, Department of Computer Science, University of Exeter
代码链接 https://github.com/CnoyZ/SSVIF
研究动机 01
任务导向融合的核心矛盾是:要得到语义,就必须有人来标语义?
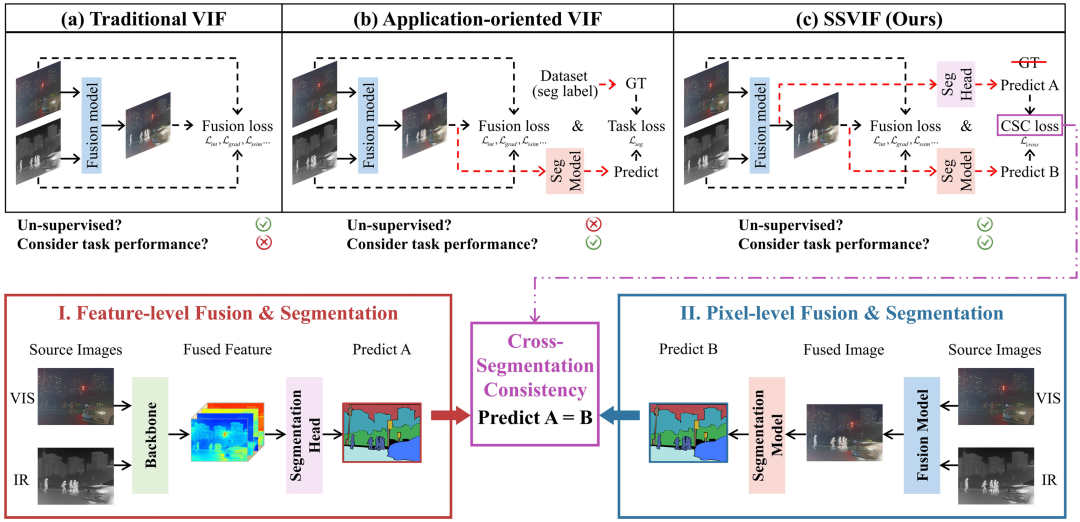
传统的Visible-Infrared Fusion(VIF)主要是为了优化像素强度、梯度、结构相似性等等低层的目标来生成出高质量的图像,但是并不能保证分割的效果。检测更友好。
因此就产生了application-orientedVIF:把分割/检测损失直接加到融合训练中去。但是代价也是直接的,即要给任务打上标签。对于红外-可见光配对的数据,大规模逐像素分割标注的成本非常高。
SSVIF 问题意识很明确:能否不用人为分隔的标签,仍然使融合模型学习到对于语义分割有帮助的高阶特征?
02 主要内容
CSC:使"特征级分割"与"图像级分割"对于同一个场景产生相同的结论
SSVIF 构造出两条具有不同的输入、归纳偏置的分割路径:A 路径直接在融合特征上接 segmentation head;B 路径首先生成融合图像,然后用单独的 segmentation model 做预测。
作者所做的一個重要假設是:兩條路徑都會有噪音,但是稳定的、跨模态共享的语义结构容易在两条路线上反复出现;由于模态噪声或者融合伪影所造成的非语义模式,很难得到两路一致的支持。
在训练过程中,对每一像素都进行比较,并选出置信度更高的那一方作为伪标签,然后同时约束两个分支。最后 CSC 的损失是:
L_hyb 由交叉熵和Dice loss组成。
Dice 项表示区域级别的重叠,对于早期零散、碎片化的伪标签噪声来说,它是天然不友好的,这也是作者使用它来缓解 confirmation bias 的原因之一。
03 训练策略
为什么要做两个阶段的训练呢?因为开始的时候两边都是"不可靠"的
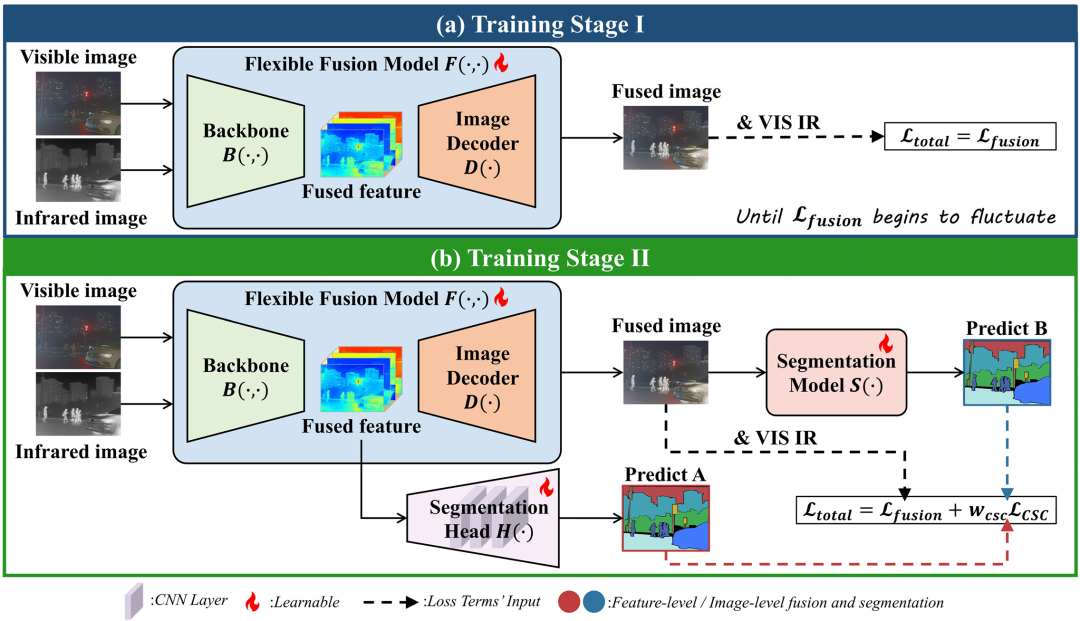
从第一轮epoch开始就让融合模型和两个分割分支互相监督的话,就会出现一个鸡生蛋的问题:融合图像/特征还很不稳定,分割预测也较差;而低质量的分割又会反过来误导融合。
所以StageI只对融合损失进行优化;当epoch平均融合损失开始回升的时候,作者认为这是fused-only优化接近饱和的一个实际信号,于是就切换到了Stage II,并且加入了CSC来进行联合训练。总损失为:
该策略的重点并不是去寻找一个理论上最优的切换点,而是在于先使融合模型得到一个比较稳定的基本跨模态结构,然后再让自监督语义约束进来。
04 动态权重
GDWA:自动平衡"图像融合得好"和"语义分割得好"
Stage II 同时包含了低层融合目标以及高层CSC目标,固定的权重很容易造成一边压过另一边的情况。SSVIF 为该问题设计了Gradient-and-Descent-based Weight Adjustment(GDWA)。
它同时接收两个信号:梯度范数 反映任务目前对于共享融合参数所造成的影响,损失下降率表示任务收敛的速度。当任务既"影响力大",又"收敛速度慢"的时候,就会获得更大的权重。CSC 动态权重写为:
这样做并不是为了让CSC越大越好,而是要在训练的过程中保持融合的质量和下游语义之间的一种动态平衡。
结果解读 05
实验:不进行标签分割,融合质量、mIoU仍然可以同步提高
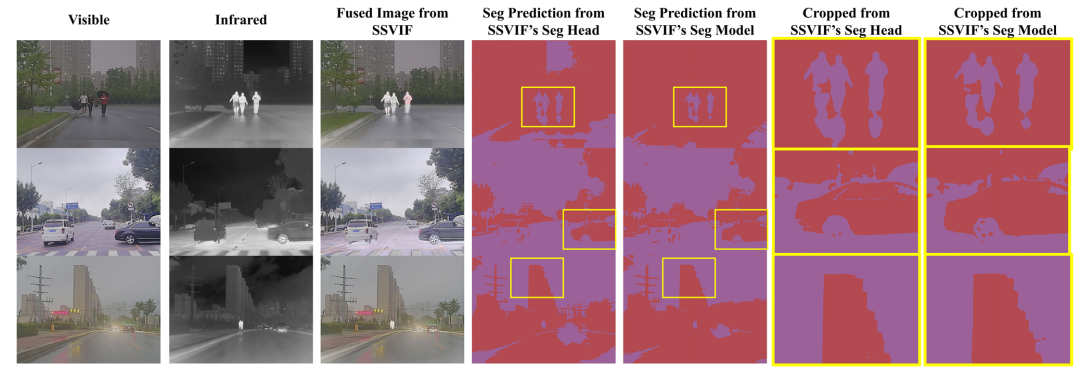
在FMB数据集中,SSVIF的MI、VIF、Qabf、SSIMΣ分别为4.76、0.88、0.70、1.02 ΔE=4.34;在MSRS中,MI/VIF/Qabf/SSIMΣ/MSS分别为4.33/1.02/0.67/1.03/1.05ΔE 2.57。论文中提到,在大多数融合指标方面都处于领先地位,并且不需要依靠人工segmentationlabel。
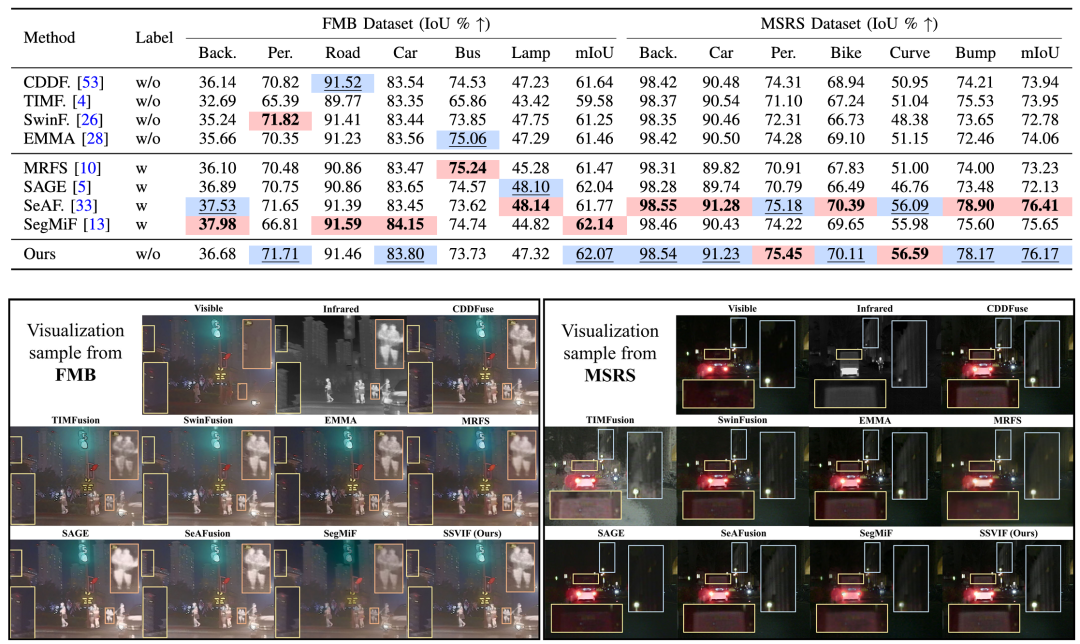
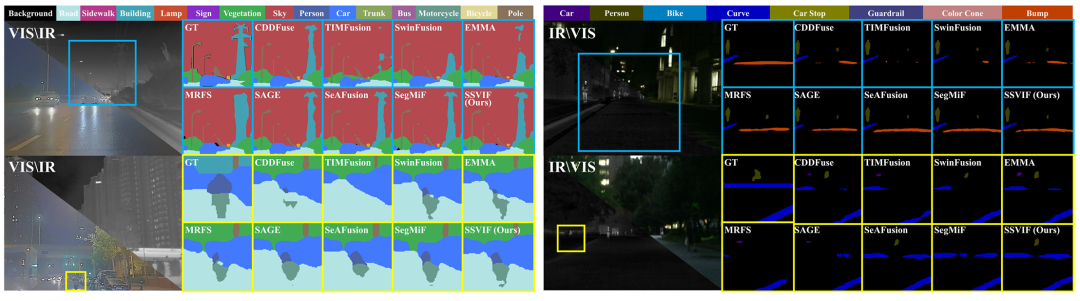
更重要的就是Table III的消融:以SwinFusion为例,原始训练框架的mIoU为61.3,接入SSVIF之后提高到了62.1 ;MI由原来的3.85提高到了现在的4.76。将SSVIF套用到EMMA、SeAF、FreqGAN、DiffFusion等不同的融合模型上,也会普遍地得到语义或者融合指标上的改善,这就说明它更像是一个可迁移训练框架不是仅仅为一个固定的backbone服务。
在GDWA消融的过程中,完整的治疗方法达到了mIoU 62.1,同时取得了MI 4.76、Qabf 0.70、SSIMΣ 1.02;去掉CSC、去掉两阶段策略或者推迟切换都会造成不同程度的降低。
06 总结和思考
把"语义监督"用一致性的关系来代替
SSVIF最有趣的地方并不是简单的在融合网络上加上一个自监督loss,而是在于重新定义了任务导向融合的监督来源:语义并不一定来源于人工GT,也可以来自于不同的融合路径之间稳定的出现的一致结构。
它还保留了非常实用的部署属性------分割模型和segmentation head主要服务于训练,推理的时候只保留fusion model,因此不会把任务分支的额外开销永远地带入到部署中去。
但是,自监督语义仍然受到伪标签质量的影响,在类别细粒度、复杂的局部目标以及严重的模态错位的情况下,两个分支的一致并不一定就是"语义正确"。之后如果能够结合更强的跨模态语义先验、开放词汇分割或者更加可靠地进行不确定性筛选的话,那么无标签任务导向融合的能力边界将会被进一步扩大。
--- END ---