精彩专栏推荐订阅:在下方主页👇🏻👇🏻👇🏻👇🏻
💖🔥作者主页 :计算机毕设木哥🔥 💖
文章目录
- 一、项目介绍
- 二、视频展示
- 三、开发环境
- 四、系统展示
- 五、代码展示
- 六、项目文档展示
- 七、项目总结
- [<font color=#fe2c24 >大家可以帮忙点赞、收藏、关注、评论啦 👇🏻](#fe2c24 >大家可以帮忙点赞、收藏、关注、评论啦 👇🏻)
一、项目介绍
高光谱观测能同时反映植被光谱指纹与温湿、土壤、海拔等环境因子,但样点量大、指标多,若只停在表格核对,很难把光谱差异、生态胁迫和入侵分布串成可对照的结论,教学与业务侧也缺少「分析结果可查、可管、可看」的一体化入口。本文通过开发一个基于大数据的植被光谱特征与环境因子关联分析及可视化系统,用以帮助解决高光谱样点关联结果分散、难对照展示的问题。
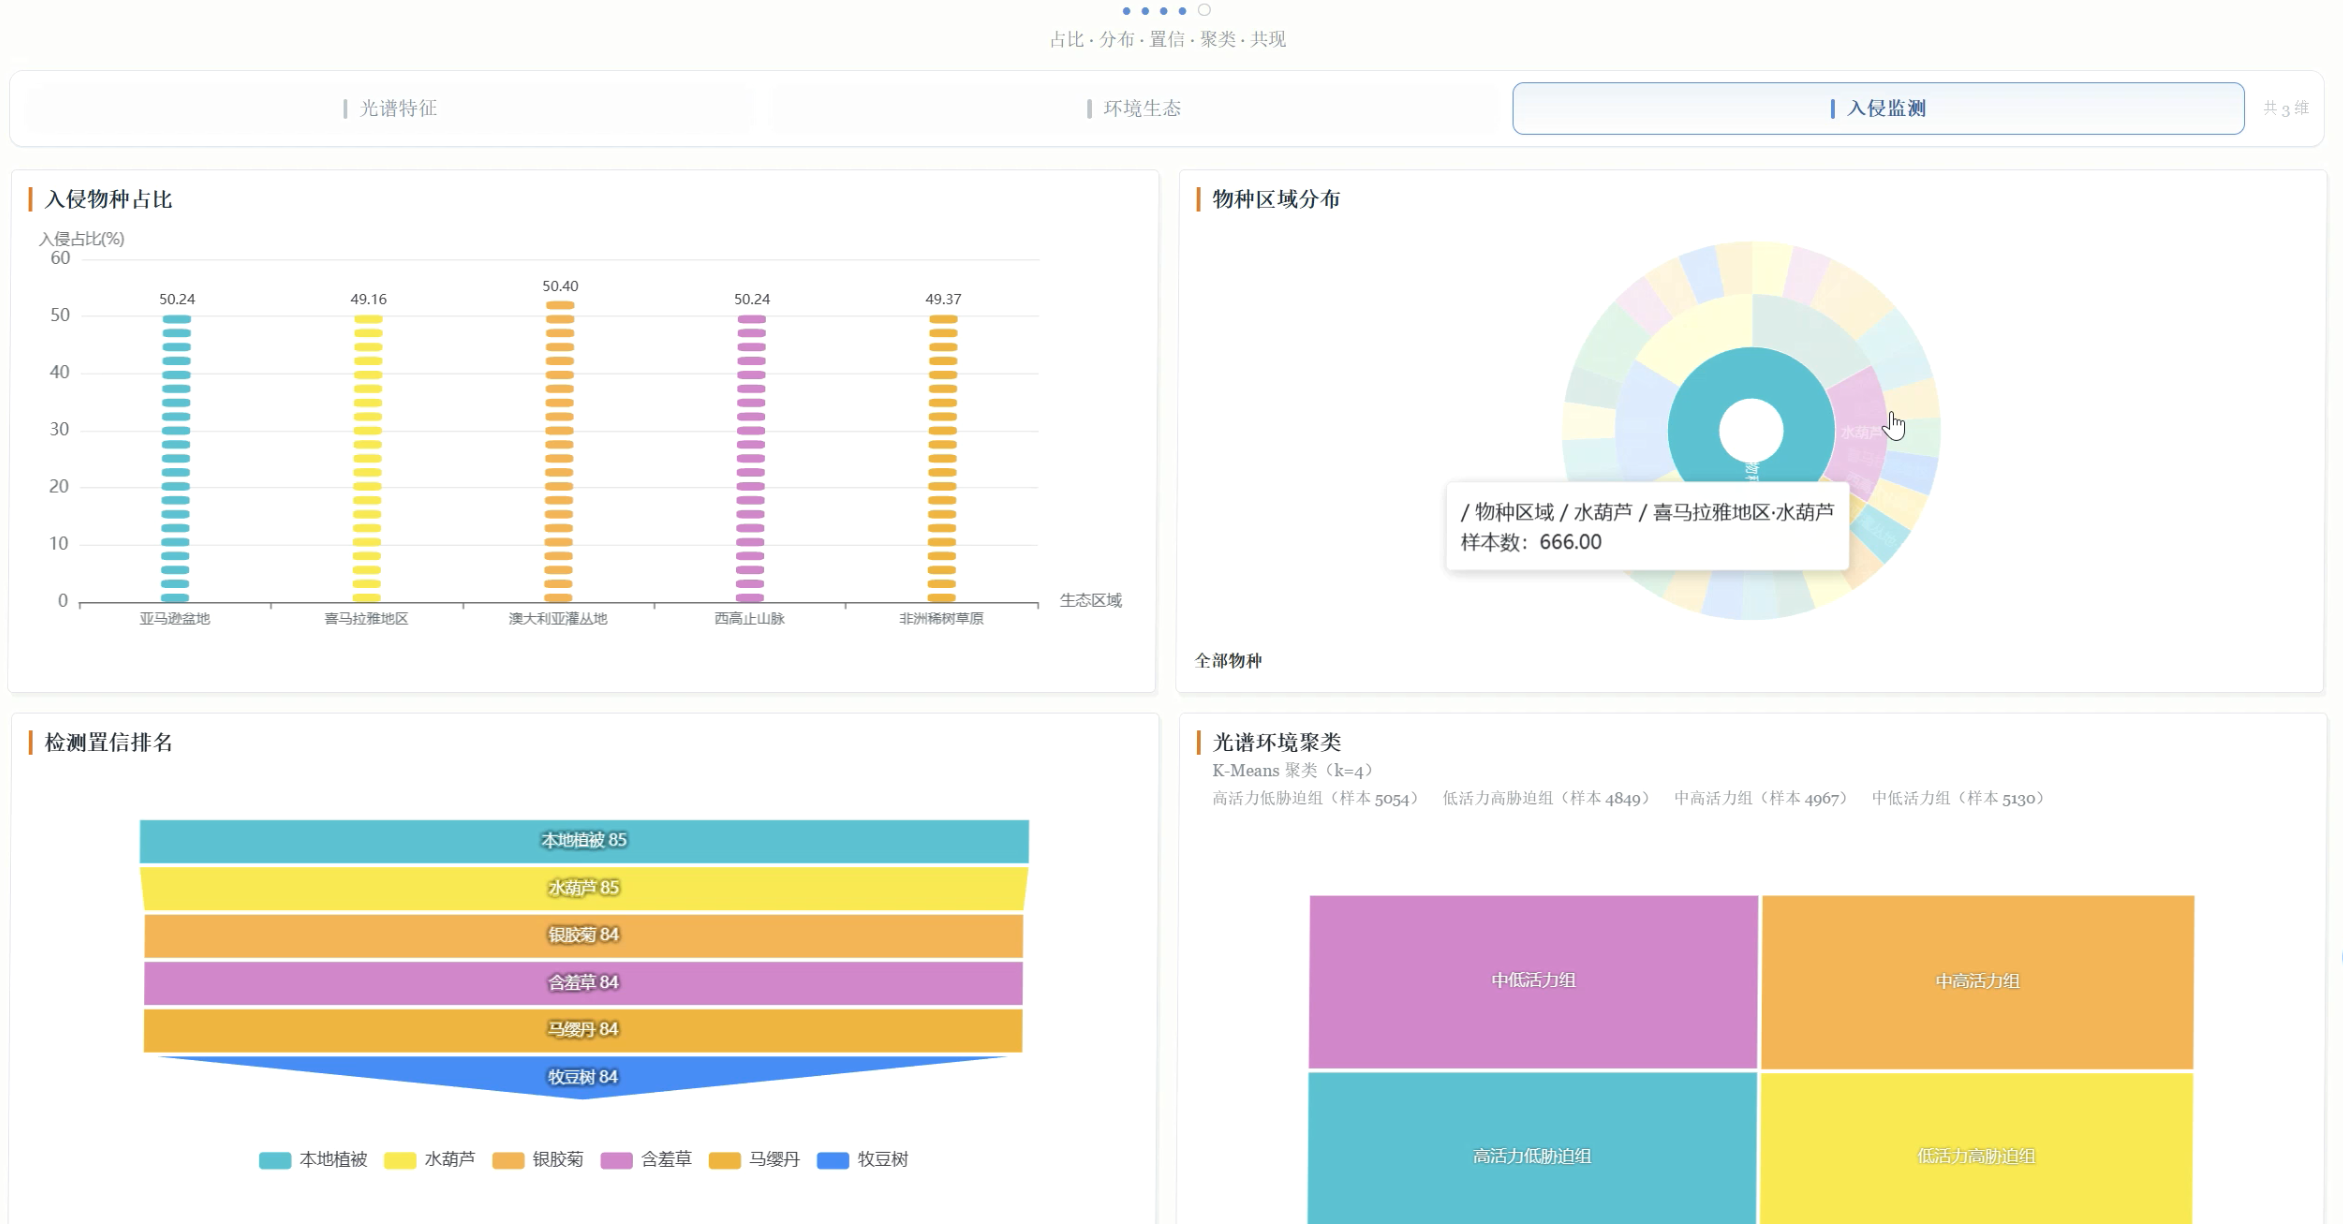
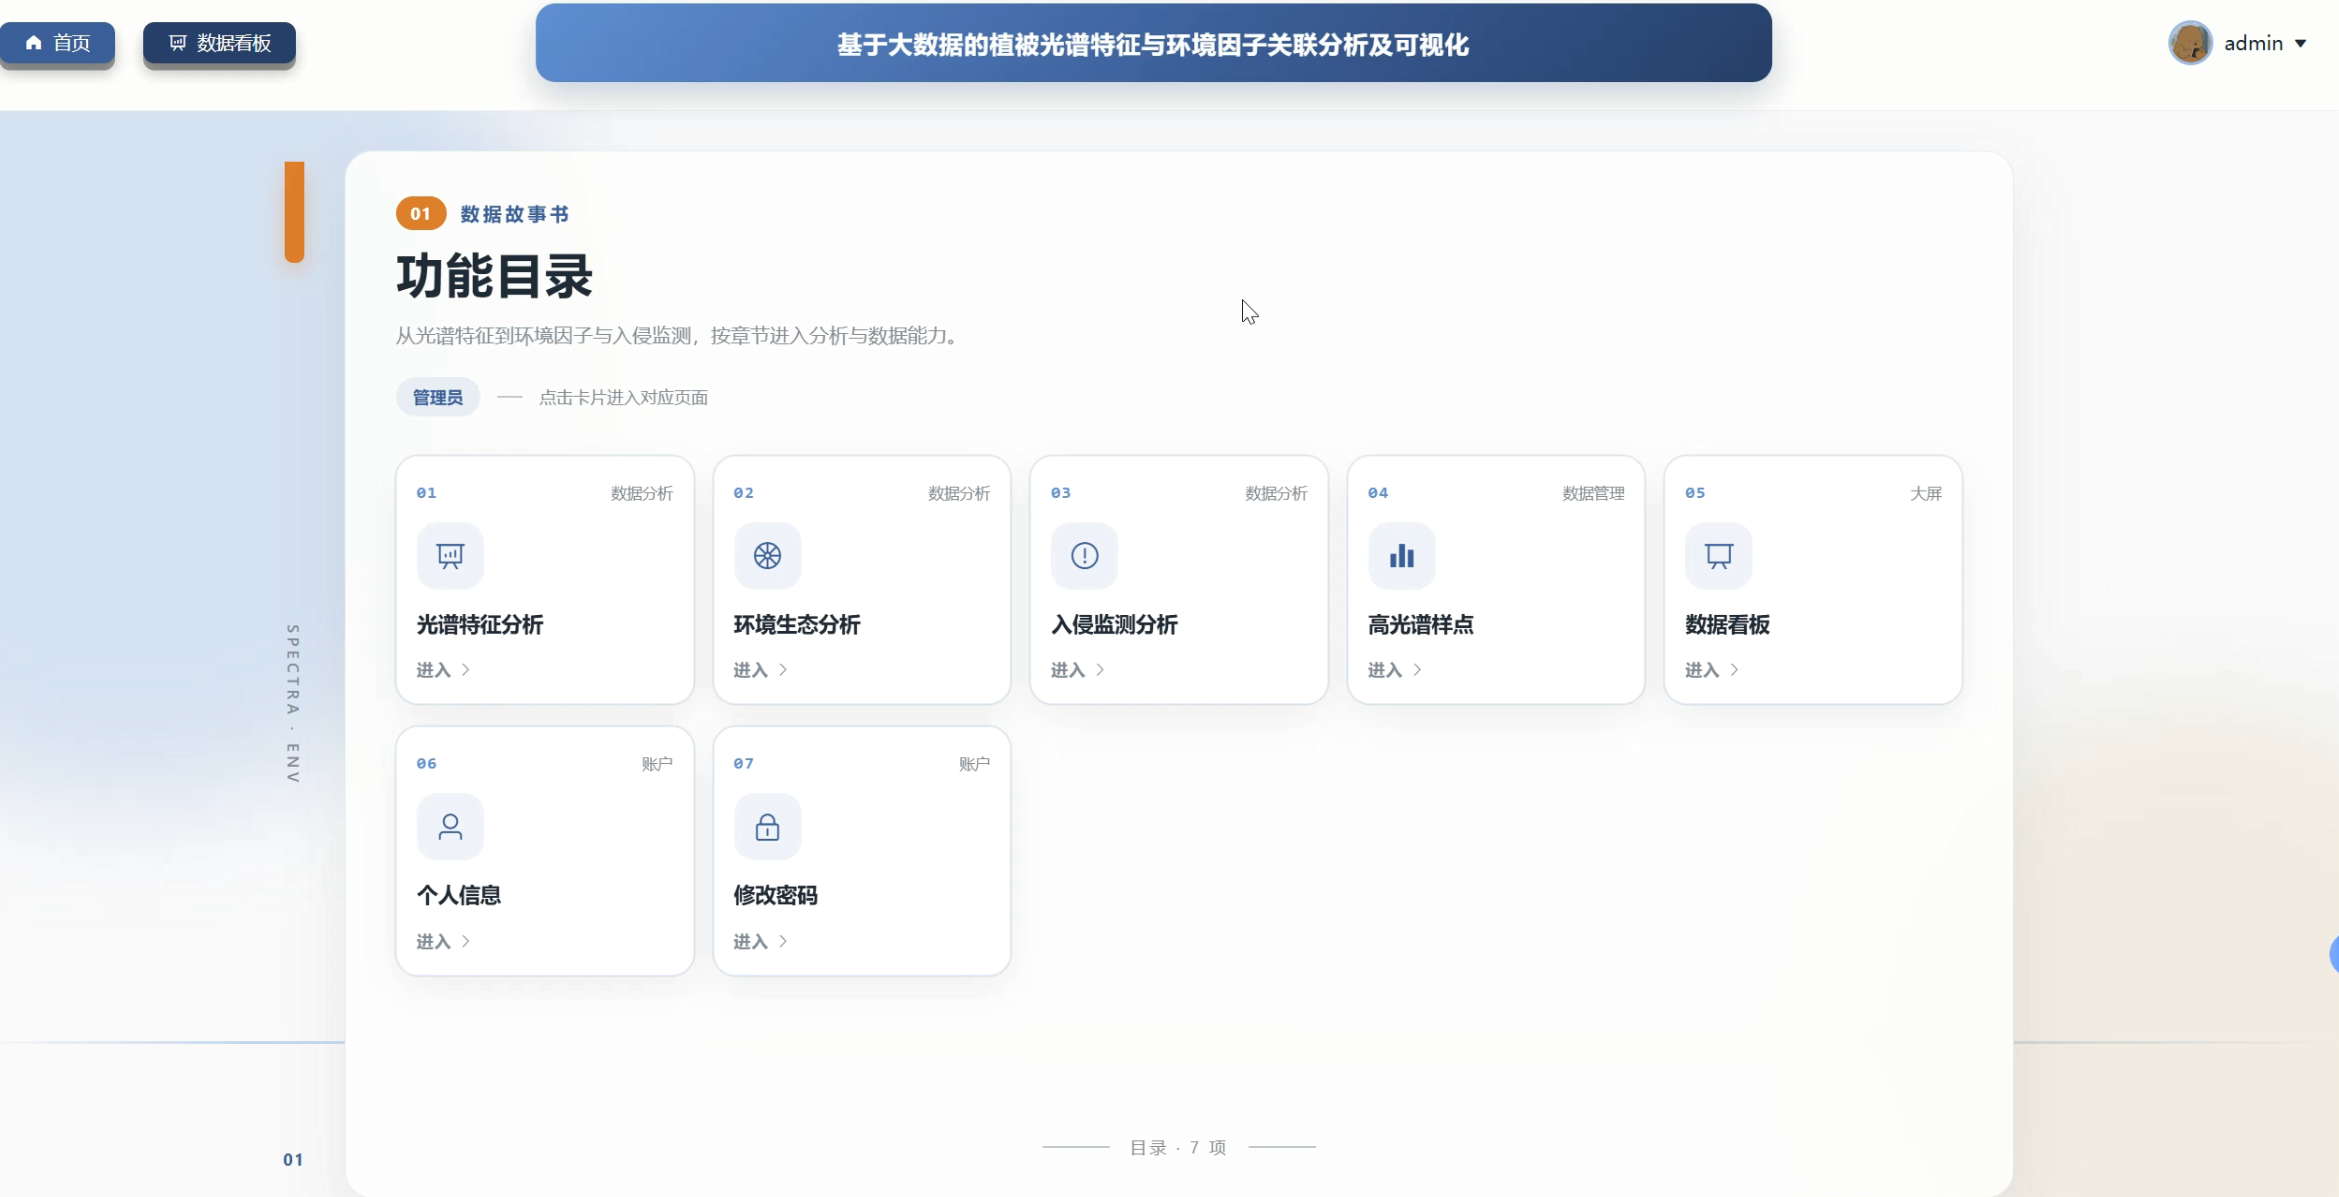
系统采用 Hadoop 与 HDFS 存放数据,用 PySpark 完成预处理及光谱、生态、入侵三类共十五项分析,其中光谱---环境联合特征经标准化后做 K-Means 分群,区域---植被类型---物种状态组合用 FP-Growth 挖掘共现关系,分析结果经 Django 接口写入 MySQL,前端以 Vue 与 ECharts 呈现分析页、可视化大屏及高光谱样点管理。功能上支持光谱特征、环境生态、入侵监测三维图表浏览,提供数据看板总览,并支持样点增删改查与管理员账户维护。
经过系统测试,本系统能满足毕业设计演示、遥感与生态相关课程实验,以及需要对照光谱---环境---入侵结果的管理或研究人员的查阅与样点维护需求,把分析结果收拢到可浏览的页面与大屏上,便于课题展示与日常核对。
二、视频展示
基于大数据的植被光谱特征与环境因子关联分析及可视化
三、开发环境
- 大数据技术:Hadoop、Spark、Hive
- 开发技术:Python、Django框架、Vue、Echarts
- 软件工具:Pycharm、DataGrip、Anaconda
- 可视化 工具 Echarts
四、系统展示
系统页面模块展示:
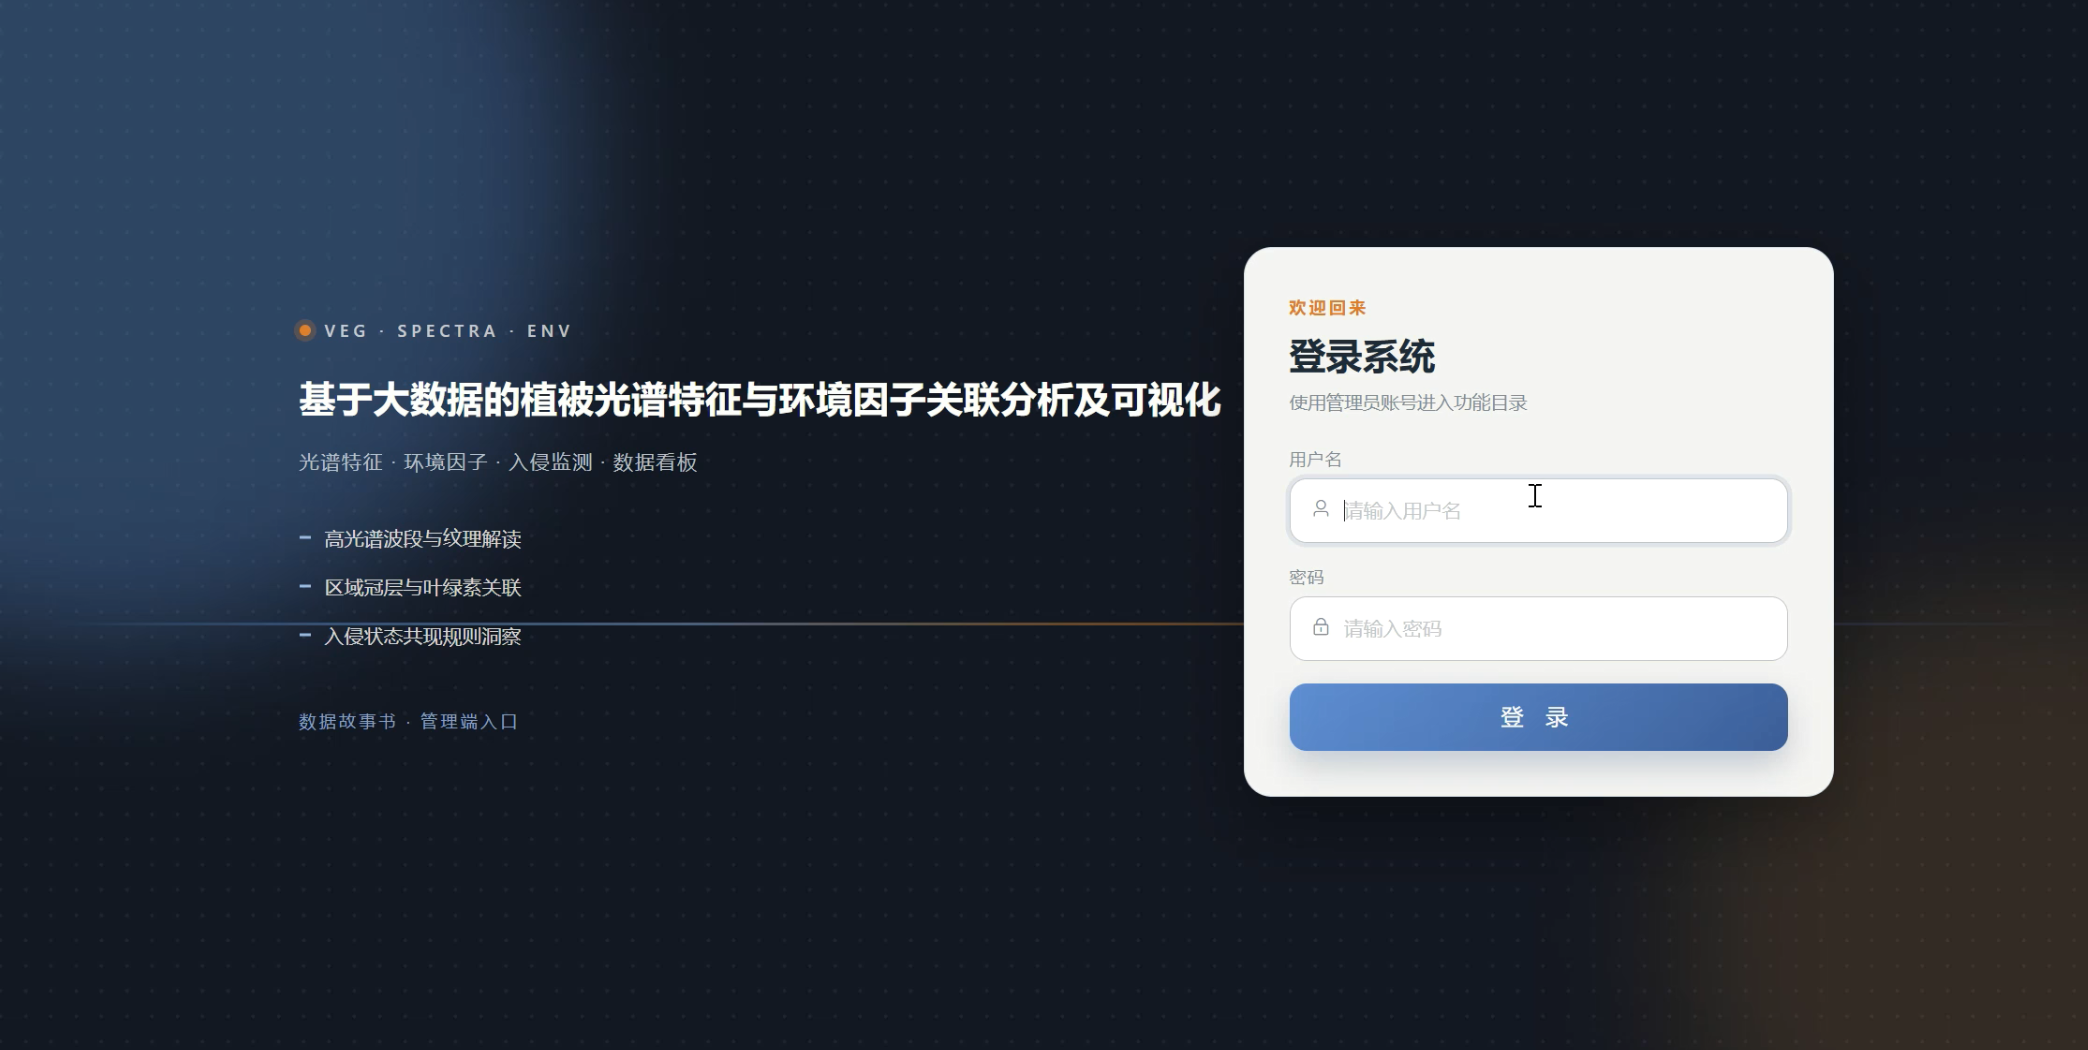
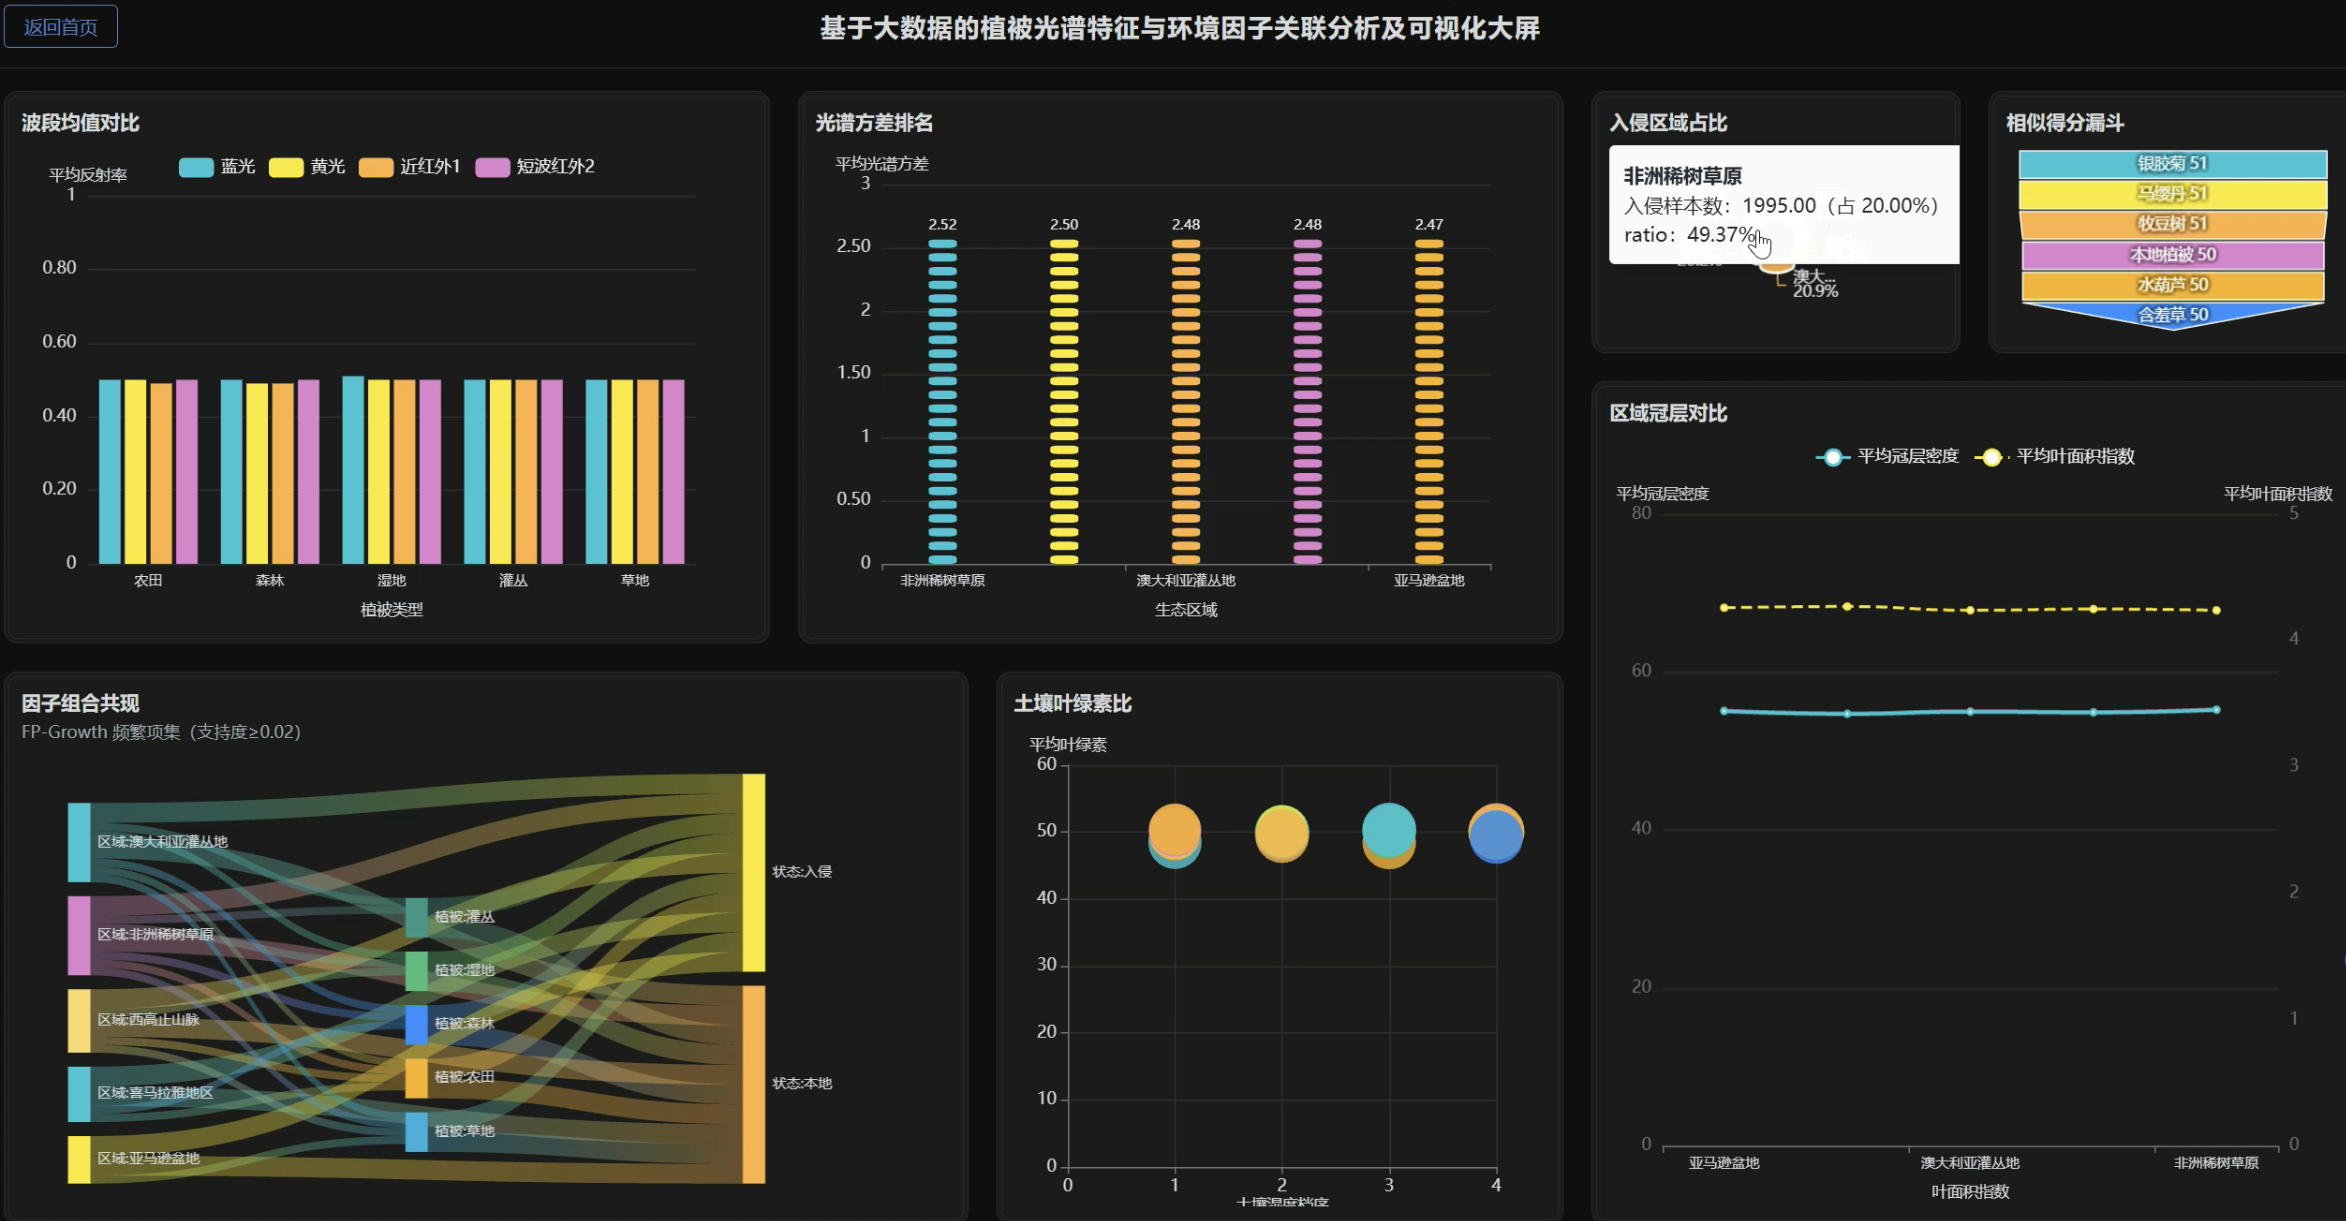
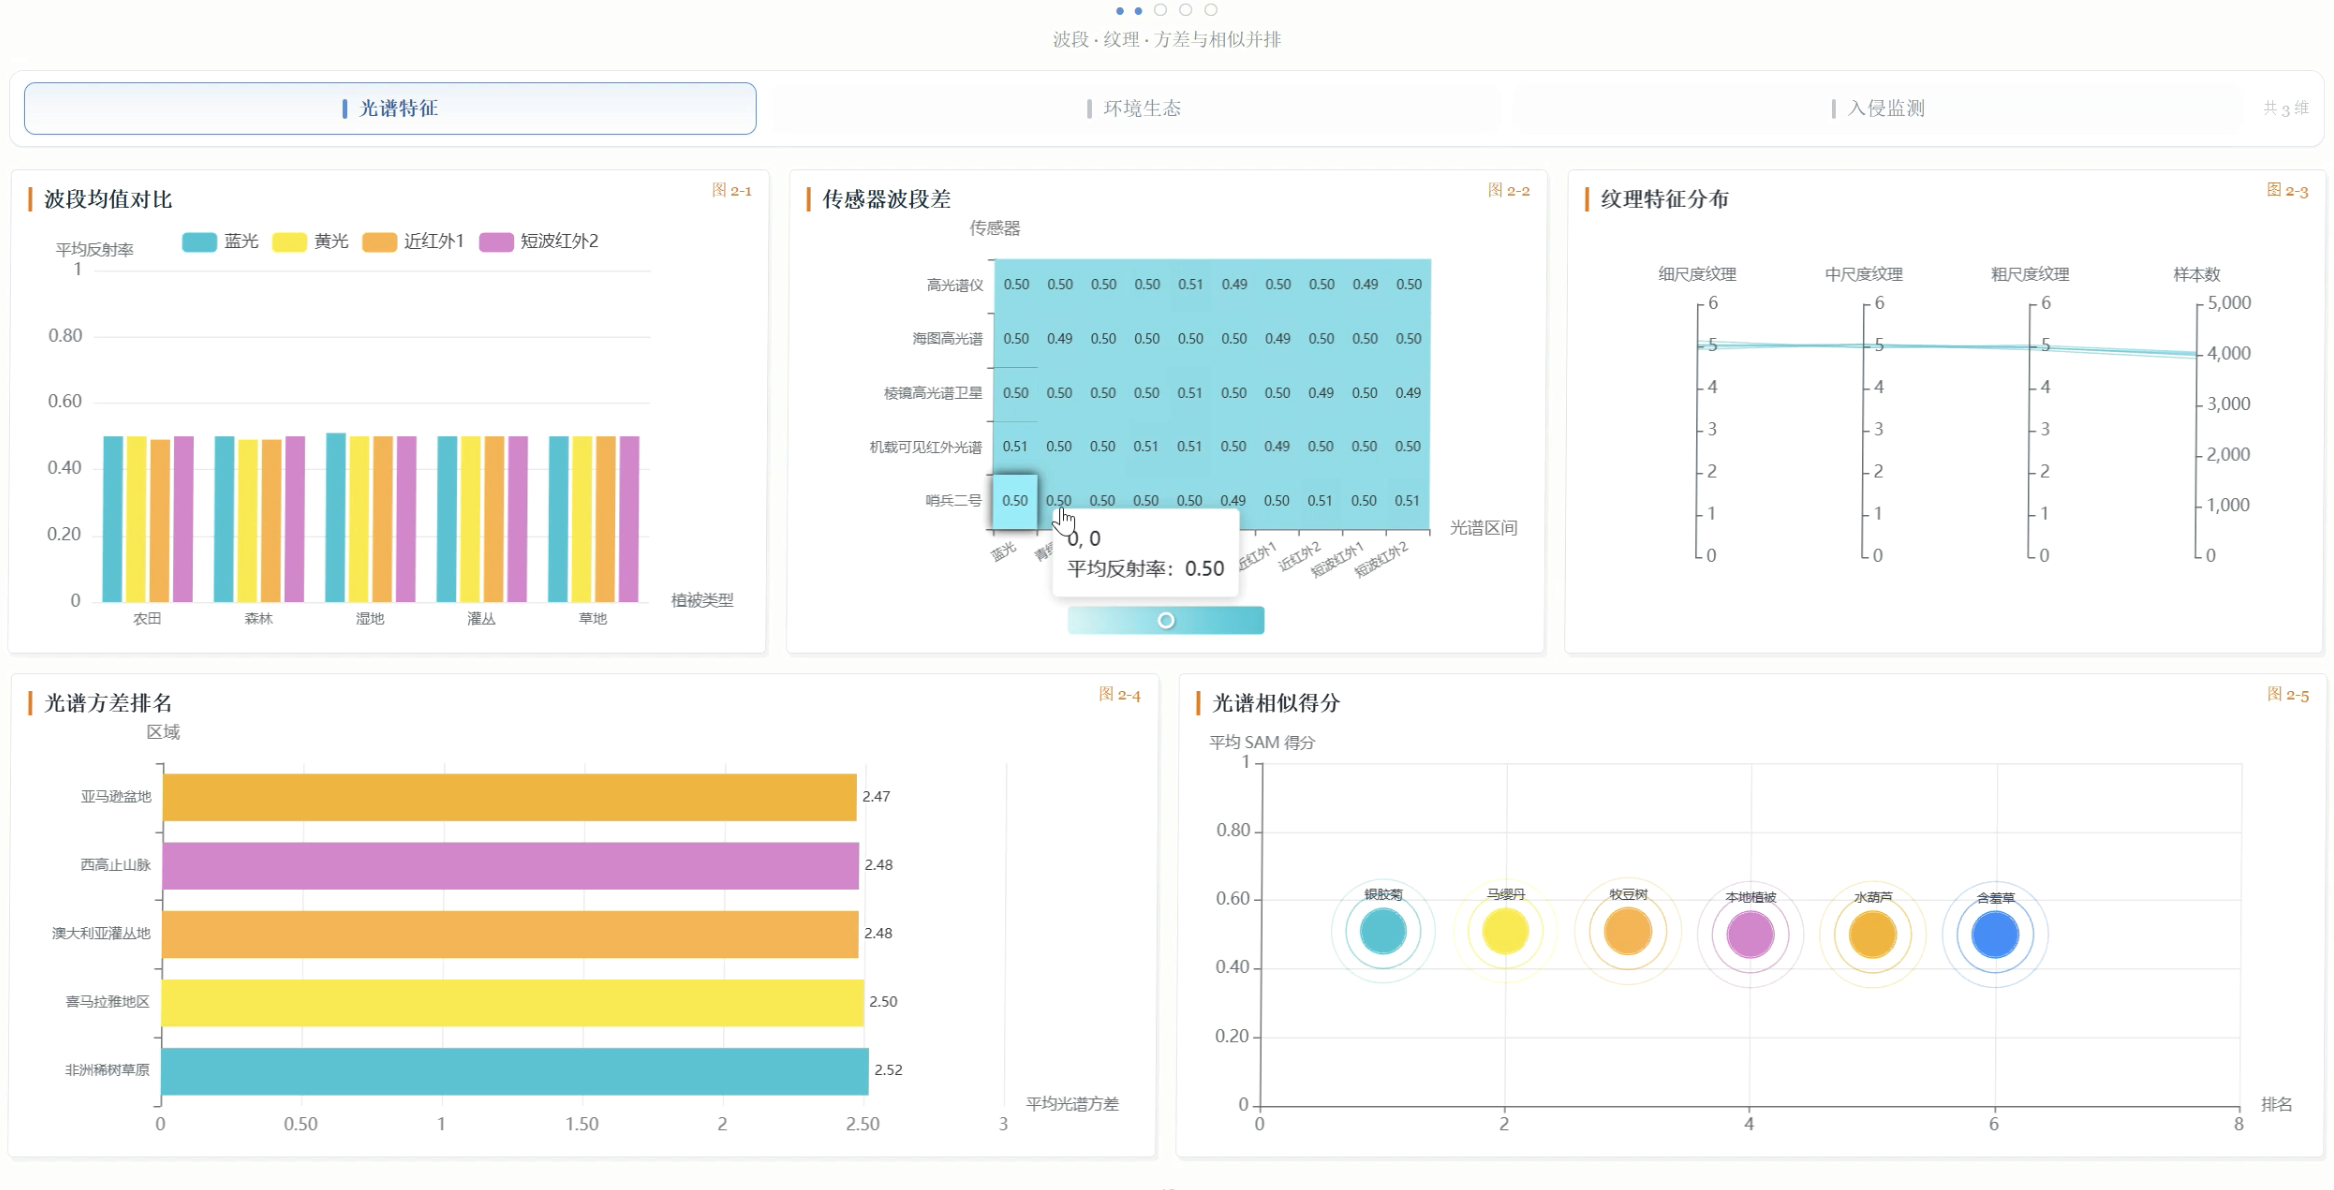
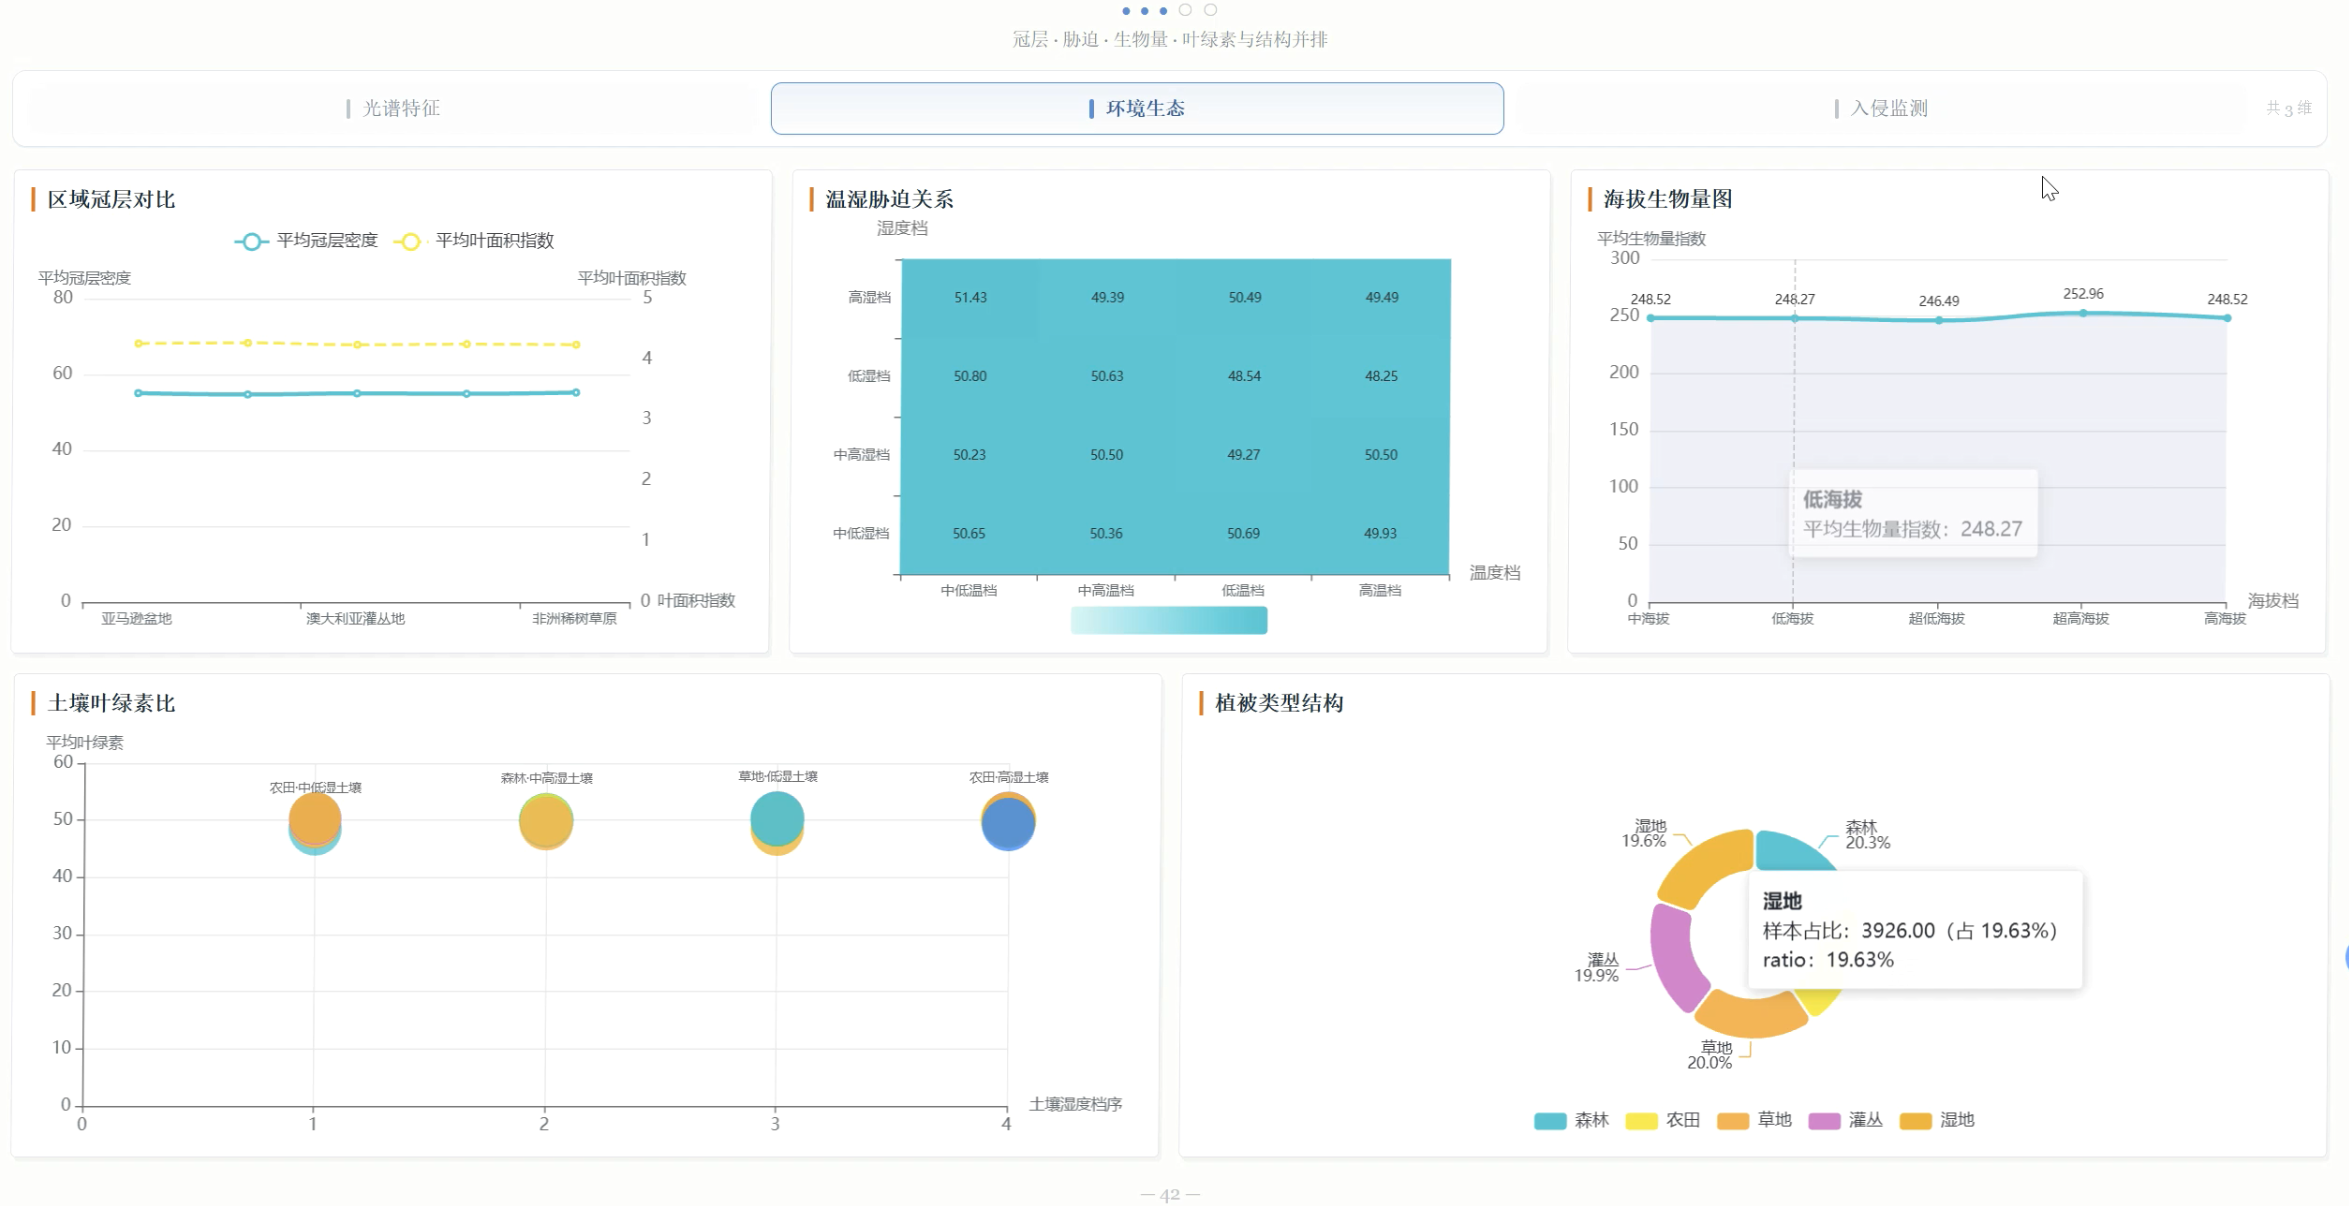
五、代码展示
bash
def kmeans_spectral_env_clusters_analysis(input_df):
    """光谱---环境联合特征 K-Means(k=4);按簇心相对排序贴中文语义名。"""
    logger.info("开始分析: 光谱环境聚类")
    feature_cols = [
        'Canopy_Density', 'Leaf_Area_Index', 'Chlorophyll_Content', 'Soil_Moisture',
        'Temperature', 'Humidity', 'Spectral_Band_1', 'Spectral_Band_4', 'Spectral_Band_8',
        'Spectral_Variance', 'Vegetation_Stress_Index', 'Biomass_Index',
    ]
    work = input_df
    for cname in feature_cols:
        work = work.filter(col(cname).isNotNull())
    for cname in feature_cols:
        work = work.withColumn(cname, col(cname).cast('double'))
    n = work.count()
    logger.info(f"读取行数(过滤后): {n}")

    assembler = VectorAssembler(inputCols=feature_cols, outputCol='features_raw')
    assembled = assembler.transform(work)
    scaler = StandardScaler(
        inputCol='features_raw', outputCol='features', withStd=True, withMean=True
    )
    scaled = scaler.fit(assembled).transform(assembled)

    kmeans = KMeans(featuresCol='features', predictionCol='cluster_id', k=4, seed=42)
    model = kmeans.fit(scaled)
    pred = model.transform(scaled)
    logger.info(f"聚类簇数: 4")

    agg_exprs = [
        spark_round(spark_avg(col(c)), 2).alias(f'avg_{c.lower()}') for c in feature_cols
    ]
    agg_exprs.append(spark_count(lit(1)).alias('sample_cnt'))
    profile = pred.groupBy('cluster_id').agg(*agg_exprs)

    centers_pdf = profile.orderBy('cluster_id').toPandas()
    logger.info("各簇中心特征:\n" + centers_pdf.to_string(index=False))

    # 综合得分:冠层+叶面积+叶绿素+生物量 - 胁迫(相对排序)
    score_map = {}
    for _, row in centers_pdf.iterrows():
        cid = int(row['cluster_id'])
        score = (
            float(row['avg_canopy_density'])
            + float(row['avg_leaf_area_index'])
            + float(row['avg_chlorophyll_content']) / 10.0
            + float(row['avg_biomass_index']) / 50.0
            - float(row['avg_vegetation_stress_index']) / 20.0
        )
        score_map[cid] = score
    ranked = sorted(score_map.keys(), key=lambda x: score_map[x])
    name_ladder = ['低活力高胁迫组', '中低活力组', '中高活力组', '高活力低胁迫组']
    id_to_name = {cid: name_ladder[i] for i, cid in enumerate(ranked)}
    logger.info(f"簇号→语义名(按综合得分升序): {id_to_name}")

    mapping_expr = col('cluster_id')
    for cid, cname in id_to_name.items():
        mapping_expr = when(col('cluster_id') == lit(cid), lit(cname)).otherwise(mapping_expr)
    result = profile.withColumn('cluster_name', mapping_expr).withColumn(
        'profile_desc',
        lit('簇特征均值见各 avg_* 列;语义名按综合活力相对排序生成'),
    ).orderBy('cluster_id')

    path = write_result_csv(result, 'kmeans_spectral_env_clusters.csv')
    logger.info(f"保存到: {path} 成功")
    return result


def fpgrowth_region_veg_status_analysis(input_df):
    """区域---植被类型---物种状态三项集 FP-Growth(支持度≥0.02)。"""
    logger.info("开始分析: 因子组合共现")
    work = input_df.filter(
        col('Region_Name').isNotNull()
        & col('Vegetation_Type').isNotNull()
        & col('Species_Status').isNotNull()
    )
    n = work.count()
    logger.info(f"读取行数(过滤后/事务数): {n}")

    baskets = work.select(
        array(
            F.concat(lit('区域:'), col('Region_Name')),
            F.concat(lit('植被:'), col('Vegetation_Type')),
            F.concat(lit('状态:'), col('Species_Status')),
        ).alias('items')
    )

    fp = FPGrowth(itemsCol='items', minSupport=0.02, minConfidence=0.3)
    model = fp.fit(baskets)
    freq = model.freqItemsets
    logger.info(f"频繁项集条数: {freq.count()}")

    result = freq.withColumn(
        'support',
        spark_round(col('freq').cast('double') / lit(float(n)), 4),
    ).withColumn(
        'items_text',
        F.concat_ws(' + ', col('items')),
    ).select(
        col('items_text').alias('items'),
        'freq',
        'support',
    ).orderBy(desc('support'))

    path = write_result_csv(result, 'fpgrowth_region_veg_status.csv')
    logger.info(f"保存到: {path} 成功")
    return result
六、项目文档展示

七、项目总结
本课题面向高光谱植被观测中光谱特征与环境因子难以对照、入侵分布不便汇总的问题,设计并实现了「基于大数据的植被光谱特征与环境因子关联分析及可视化」系统。数据侧约 2 万条样点经清洗与类别中文化后写入 HDFS,再用 PySpark 完成光谱特征、环境生态、入侵监测三个维度共十五项分析;其中光谱---环境联合特征经标准化后用 K-Means 分群,区域---植被类型---物种状态组合用 FP-Growth 挖掘共现关系。结果落入 MySQL,经 Django 接口对外提供,前端以 Vue 与 ECharts 展示三维分析页与可视化大屏,并支持高光谱样点增删改查及管理员账户维护。系统把关联计算结果收拢到可浏览页面,便于毕业设计演示、课程实验及日常查阅核对。
大家可以帮忙点赞、收藏、关注、评论啦 👇🏻
💖🔥作者主页 :计算机毕设木哥🔥 💖