7> 🔥作者:it毕设实战小研🔥
💖简介:java、微信小程序、安卓;定制开发,远程调试 代码讲解,文档指导,ppt制作💖
精彩专栏推荐订阅:在下方专栏👇🏻👇🏻👇🏻👇🏻
💕💕文末获取源码
文章目录
- 1、基于大数据的白鹿的抖音评论分析与可视化分析设计与实现-前言介绍
-
- 1.1背景
- 1.2课题功能、技术
- [1.3 意义](#1.3 意义)
- 2、基于大数据的白鹿的抖音评论分析与可视化分析设计与实现-研究内容
- 3、基于大数据的白鹿的抖音评论分析与可视化分析设计与实现-开发技术与环境
- 4、基于大数据的白鹿的抖音评论分析与可视化分析设计与实现-功能介绍
- 5、基于大数据的白鹿的抖音评论分析与可视化分析设计与实现-论文参考
- 6、基于大数据的白鹿的抖音评论分析与可视化分析设计与实现-成果展示
- 7、代码展示
- 8、结语(文末获取源码)
本次文章主要是介绍基于大数据的白鹿的抖音评论分析与可视化的设计与实现
1、基于大数据的白鹿的抖音评论分析与可视化分析设计与实现-前言介绍
1.1背景
随着短视频平台的快速发展,抖音已成为公众获取娱乐资讯、表达观点和参与互动的重要媒介。演员白鹿作为具有较高关注度的公众人物,其相关抖音视频下的评论数据规模较大,评论内容中包含了用户的情感倾向、地域分布、活跃时间、点赞互动、热点话题及用户偏好等多维度信息。传统人工浏览评论的方式不仅效率较低,而且难以从海量、非结构化的文本数据中提取有价值的信息,无法直观发现粉丝群体的情感变化、热门评论规律以及异常互动行为。因此,如何利用大数据技术对抖音评论进行采集、清洗、存储、分析和可视化展示,成为本课题需要解决的核心问题。基于此,设计并实现一个面向白鹿抖音评论的数据分析与可视化系统,能够帮助管理者快速了解评论舆情、粉丝互动特征和内容传播效果,同时也为明星社交媒体评论分析提供一定的参考价值。
1.2课题功能、技术
本课题采用Python作为主要开发语言,构建"数据采集与处理层、数据分析层、后端服务层、前端展示层"相结合的系统架构。在大数据处理方面,使用Hadoop分布式文件系统存储原始评论数据,利用Spark完成评论清洗、去重、分词、情感统计、时间聚合和地域聚合等任务,并通过Hive建立评论数据仓库,实现结构化查询与离线分析;系统将处理后的结果同步至MySQL数据库,为Django后端接口提供数据支持。前端采用Vue框架开发,结合ECharts实现多维度可视化展示。系统主要包括情感与互动分析、地域与时间分析、内容挖掘分析和数据大屏四个模块,具体包含情感分布、时段情感对比、情感点赞对比、热评点赞排行、地域评论分布、地域情感交叉、地域平均点赞、单日位次波动、高频关键词、评论聚类画像、标签关联流向、异常评论散点、评论长度分层、地理情感热力、时段评论趋势以及活跃用户排行等功能。同时,系统使用K-means聚类算法对评论文本特征、评论长度、点赞数量和情感得分等数据进行聚类,形成不同类型的评论用户画像。
1.3 意义
本课题的研究与实现具有一定的实践意义和应用价值。首先,通过Hadoop、Spark和Hive等大数据技术,可以提高海量抖音评论数据的存储能力与处理效率,解决传统关系型数据库在处理大量文本数据时性能有限的问题。其次,系统通过情感分析、关键词统计、互动排行和聚类分析等方式,将原本零散、复杂的评论文本转化为可量化、可理解的分析结果,使用户能够更直观地掌握白鹿抖音账号下粉丝的关注重点、情感态度和互动行为。再次,借助Vue与ECharts构建的可视化页面和数据大屏,可以以图表、地图、词云、散点图和排行图等形式展示分析结果,提升数据阅读效率与系统交互体验。最后,本系统不仅可以用于白鹿相关抖音评论的分析,也能够经过少量配置后迁移至其他明星、品牌、影视作品或短视频账号的评论分析场景,为网络舆情监测、粉丝运营、内容优化和传播效果评估提供数据支撑。
2、基于大数据的白鹿的抖音评论分析与可视化分析设计与实现-研究内容
1、数据采集:使用Python编写数据采集程序,对白鹿抖音视频评论相关数据进行获取,采集字段主要包括评论编号、用户昵称、评论内容、发布时间、点赞数量、用户所在地、回复数量等信息。采集后的原始数据以JSON或CSV格式保存,并上传至Hadoop分布式文件系统,为后续数据处理与分析提供基础数据支持。
2、数据清洗与处理:利用Python、Spark和Hive对原始评论数据进行清洗与结构化处理,主要包括去除重复评论、过滤空值和无效字符、统一时间格式、处理缺失地域信息、转换点赞数量字段及去除广告评论等。同时对评论文本进行中文分词、停用词过滤和关键词提取,形成可供分析的数据集。
3、数据分析:基于清洗后的评论数据,从情感、互动、时间、地域和文本内容等多个维度开展分析。系统统计积极、中性、消极评论的占比,对比不同时段的情感变化和点赞情况,并分析各地区评论数量、平均点赞数及情感差异。同时结合热评排行、高频词和异常评论识别,挖掘用户关注热点。
4、数据可视化:采用Vue与ECharts实现评论数据的可视化展示,将复杂的数据分析结果转化为柱状图、饼图、折线图、地图、词云图、散点图和排行图等形式。系统展示情感分布、时段评论趋势、地域评论分布、热评点赞排行、关键词统计、用户活跃度及异常评论情况,提高数据阅读和决策效率。
5、模型构建:采用K-means聚类算法构建评论聚类分析模型,选取评论长度、点赞数量、情感得分、高频词特征等作为聚类指标,并对数据进行标准化处理。通过聚类结果将评论划分为高互动积极型、普通讨论型、低互动型和负面反馈型等类别,形成较为直观的评论用户画像。
6、Web系统开发:系统后端采用Django框架开发,负责用户登录、数据查询、分析结果接口以及数据库交互等功能;前端采用Vue框架构建页面,实现菜单导航、图表交互和数据展示。MySQL用于存储用户信息及分析结果,前后端通过RESTful API进行通信,最终实现完整的评论分析与可视化Web系统。
3、基于大数据的白鹿的抖音评论分析与可视化分析设计与实现-开发技术与环境
- 开发语言:Python
- 大数据技术:hadoop、spark、hive
- 框架:Django后端框架、Vue前端框架、Echarts可视化
- 机器学习算法:K-means聚类分析
- 软件工具:Pycharm
- 数据库:MySQL
4、基于大数据的白鹿的抖音评论分析与可视化分析设计与实现-功能介绍
1个角色:管理员
可视化分析:
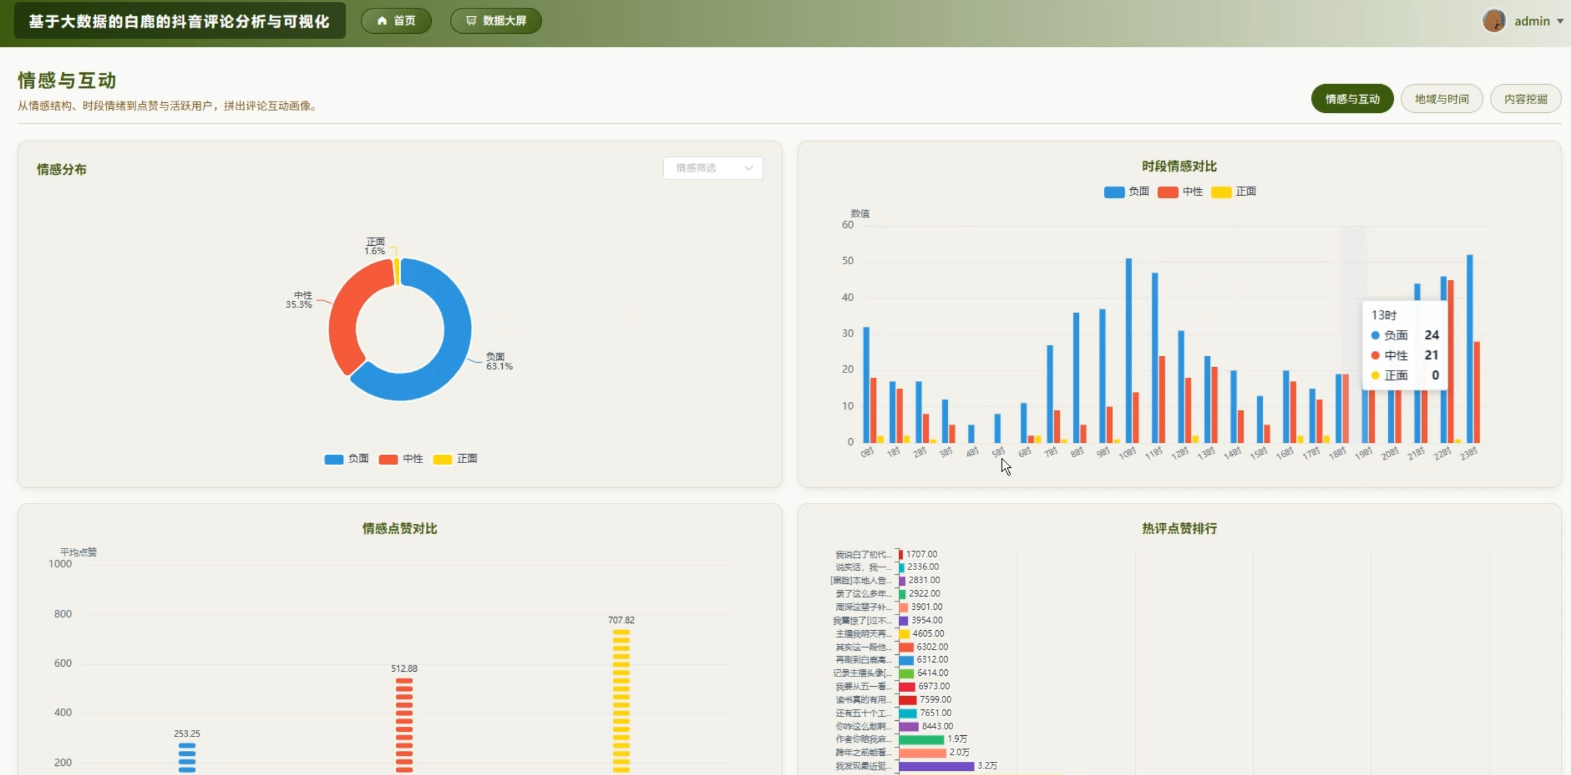
情感与互动分析:情感分布、时段情感对比、情感点赞对比、热评点赞排行
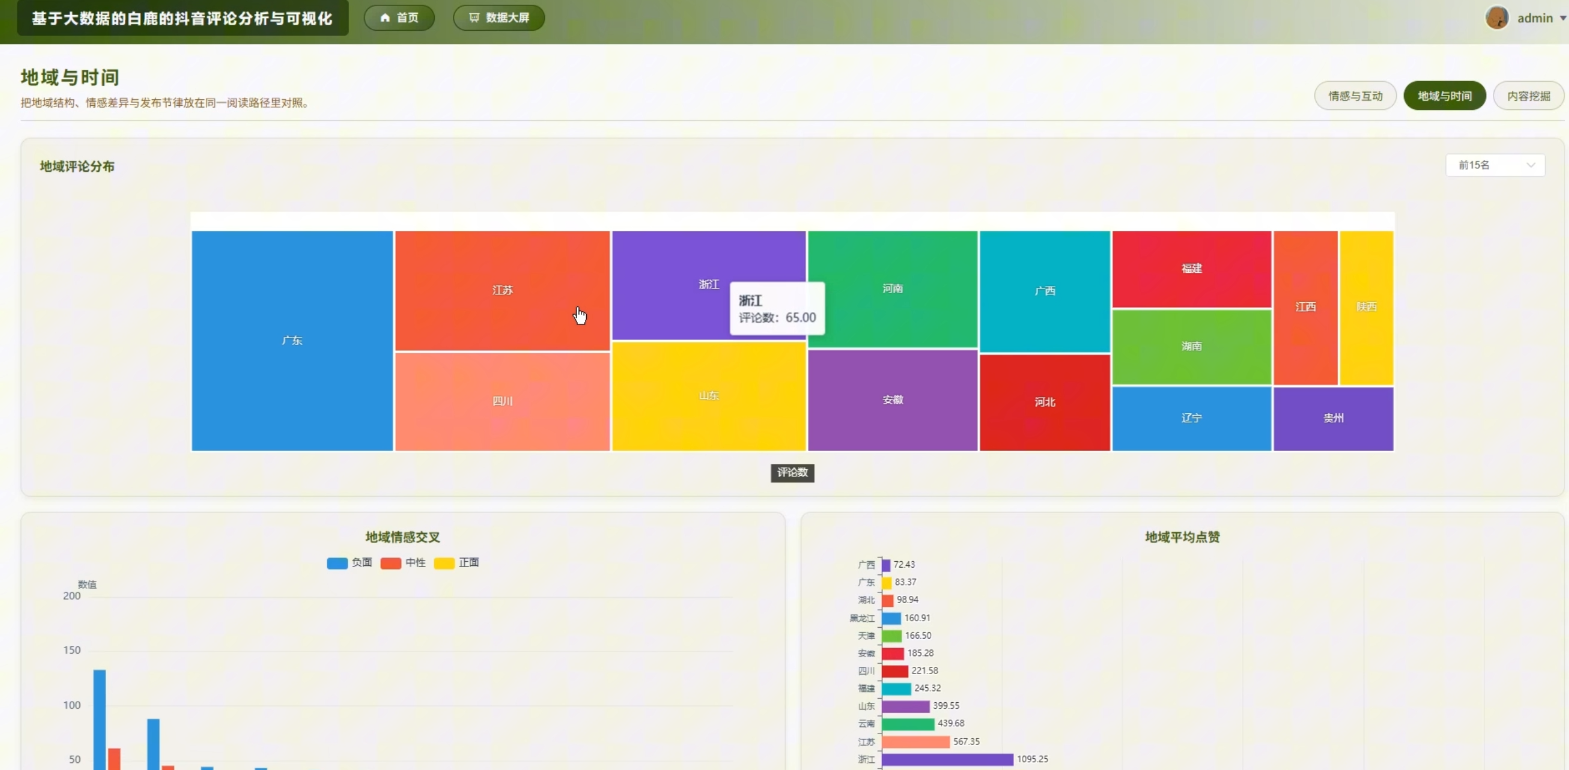
地域与时间分析:地域评论分布、地域情感交叉、地域平均点赞、单打位次波动
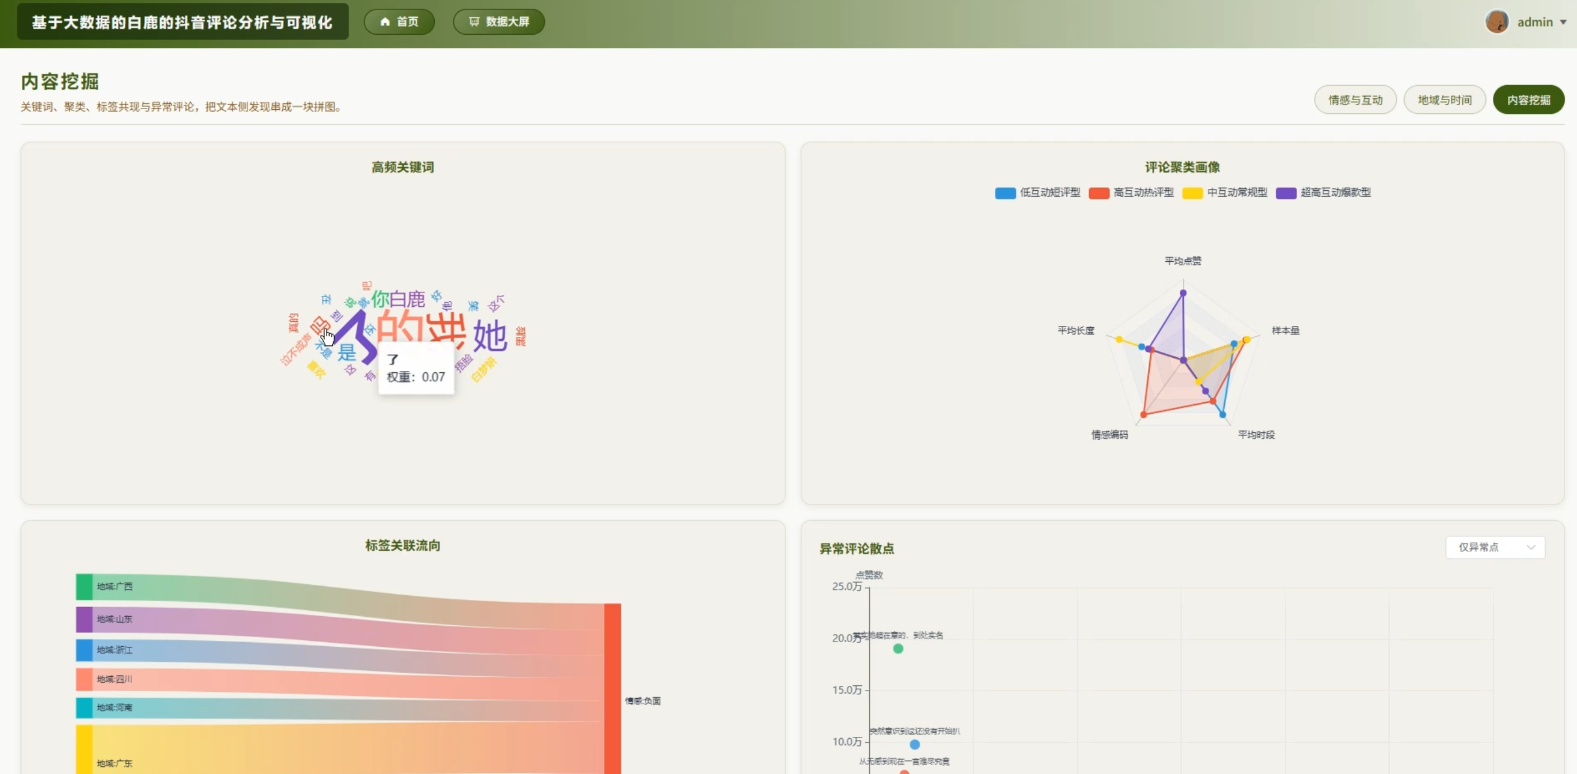
内容挖掘分析: 高频关键词、评论聚类画像、标签关联流向、异常评论散点
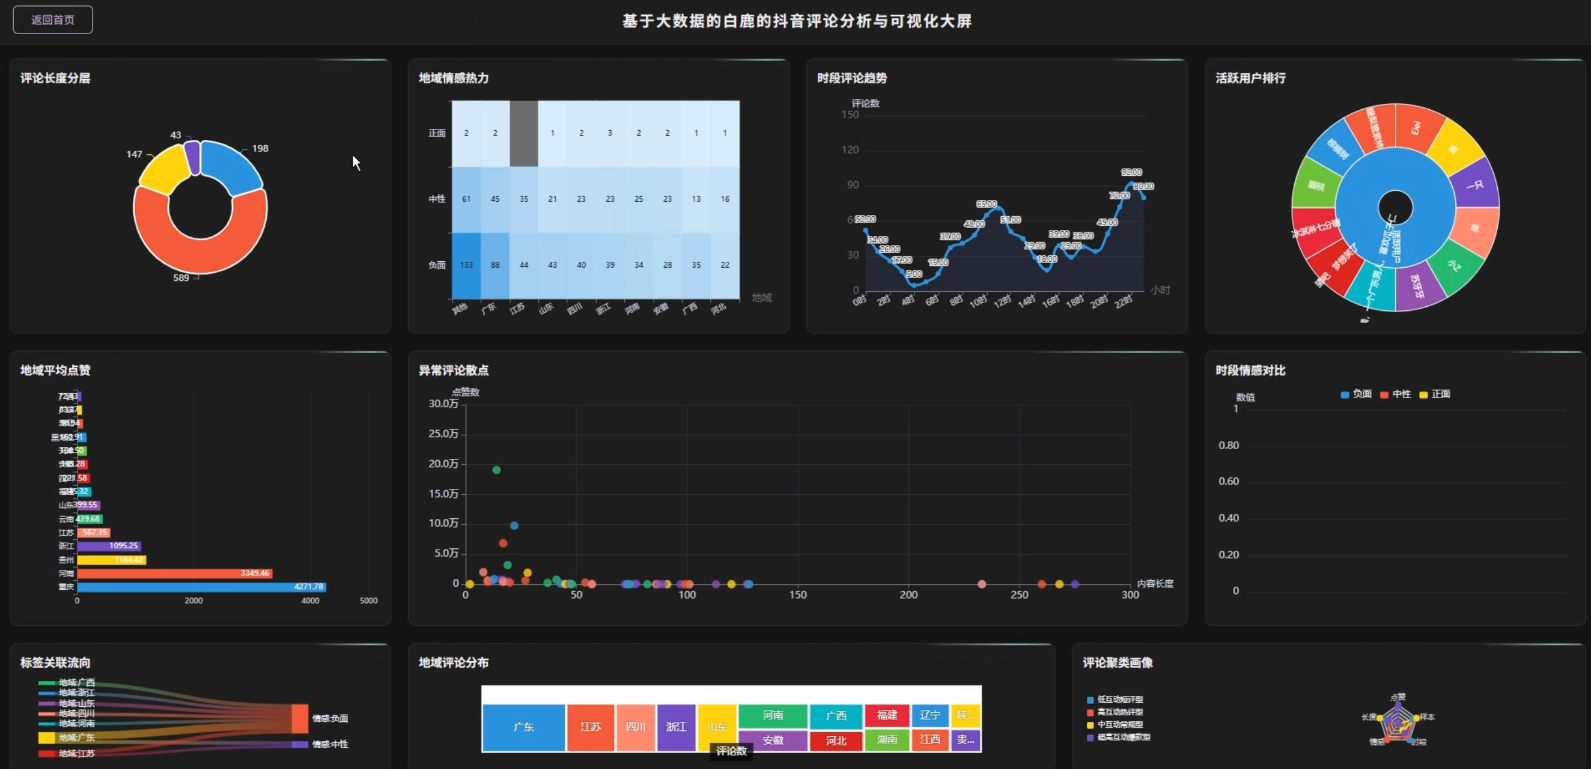
大屏:评论长度分层、地理情感热力、时段评论趋势、活跃用户排行、异常评论散点、评论聚类画像
5、基于大数据的白鹿的抖音评论分析与可视化分析设计与实现-论文参考
6、基于大数据的白鹿的抖音评论分析与可视化分析设计与实现-成果展示
6.1演示视频
6.2演示图片
☀️情感与互动分析☀️
☀️地域与时间分析☀️
☀️内容挖掘分析☀️
☀️大屏可视化☀️
7、代码展示
1.评论情感分析与情感分布统计功能【代码如下(示例):】
bash
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, udf, count
from pyspark.sql.types import StringType
from snownlp import SnowNLP

spark = SparkSession.builder \
    .appName("BaiLuCommentSentimentAnalysis") \
    .enableHiveSupport() \
    .getOrCreate()

def get_sentiment(text):
    if not text or len(text.strip()) == 0:
        return "中性"
    score = SnowNLP(text).sentiments
    if score >= 0.6:
        return "积极"
    elif score <= 0.4:
        return "消极"
    return "中性"

sentiment_udf = udf(get_sentiment, StringType())

comment_df = spark.sql("""
    SELECT comment_id, comment_content, like_count, publish_time
    FROM baidu_comment_db.douyin_comments
    WHERE comment_content IS NOT NULL
""")

result_df = comment_df.withColumn(
    "sentiment_label",
    sentiment_udf(col("comment_content"))
)

sentiment_count_df = result_df.groupBy("sentiment_label") \
    .agg(count("comment_id").alias("comment_count"))

sentiment_count_df.write \
    .format("jdbc") \
    .option("url", "jdbc:mysql://127.0.0.1:3306/bailu_comment") \
    .option("dbtable", "sentiment_distribution") \
    .option("user", "root") \
    .option("password", "123456") \
    .mode("overwrite") \
    .save()

spark.stop()
2.热评点赞排行功能【代码如下(示例):】
bash
from rest_framework.views import APIView
from rest_framework.response import Response
from rest_framework import status
from .models import DouyinComment

class HotCommentRankingView(APIView):
    """热评点赞排行接口"""

    def get(self, request):
        limit = int(request.GET.get("limit", 10))

        comments = DouyinComment.objects.filter(
            comment_content__isnull=False
        ).exclude(
            comment_content=""
        ).order_by("-like_count")[:limit]

        result = []
        for index, item in enumerate(comments, start=1):
            result.append({
                "rank": index,
                "commentId": item.comment_id,
                "nickname": item.nickname,
                "content": item.comment_content,
                "likeCount": item.like_count,
                "publishTime": item.publish_time.strftime("%Y-%m-%d %H:%M:%S")
                if item.publish_time else "",
                "province": item.province or "未知"
            })

        return Response({
            "code": 200,
            "message": "热评点赞排行获取成功",
            "data": result
        }, status=status.HTTP_200_OK)
8、结语(文末获取源码)
💕💕
💟💟如果大家有任何疑虑,或者对这个系统感兴趣,欢迎点赞收藏、留言交流啦!
💟💟欢迎在下方位置详细交流。
🔥作者:it毕设实战小研🔥
💖简介:java、微信小程序、安卓;定制开发,远程调试 代码讲解,文档指导,ppt制作💖
精彩专栏推荐订阅:在下方专栏👇🏻👇🏻👇🏻👇🏻