一张图尺寸正确、没有乱码、文件哈希也对,为什么仍然可能完全不能发?
因为这些检查只证明"文件存在且结构正常",没有证明画面真的符合题目。手握钢笔的图库照片可以没有任何文字,也可以通过尺寸、OCR 和感知哈希检查,但它仍然可能和"模型输出的隐形签名"毫无关系。
据智谱官方文档,截至 2026 年 9 月 4 日,glm-5.3-flash 是原生多模态模型,输入支持图像、视频、文本和文件,输出为文本;图片可以通过 URL 或 Base64 Data URL 放进 messages[].content[],也支持结构化输出。这让它适合承担 Agent Loop 里的自动视觉复核,但前提是代码真的把 PNG 传给模型。
先区分结构检查和视觉判断
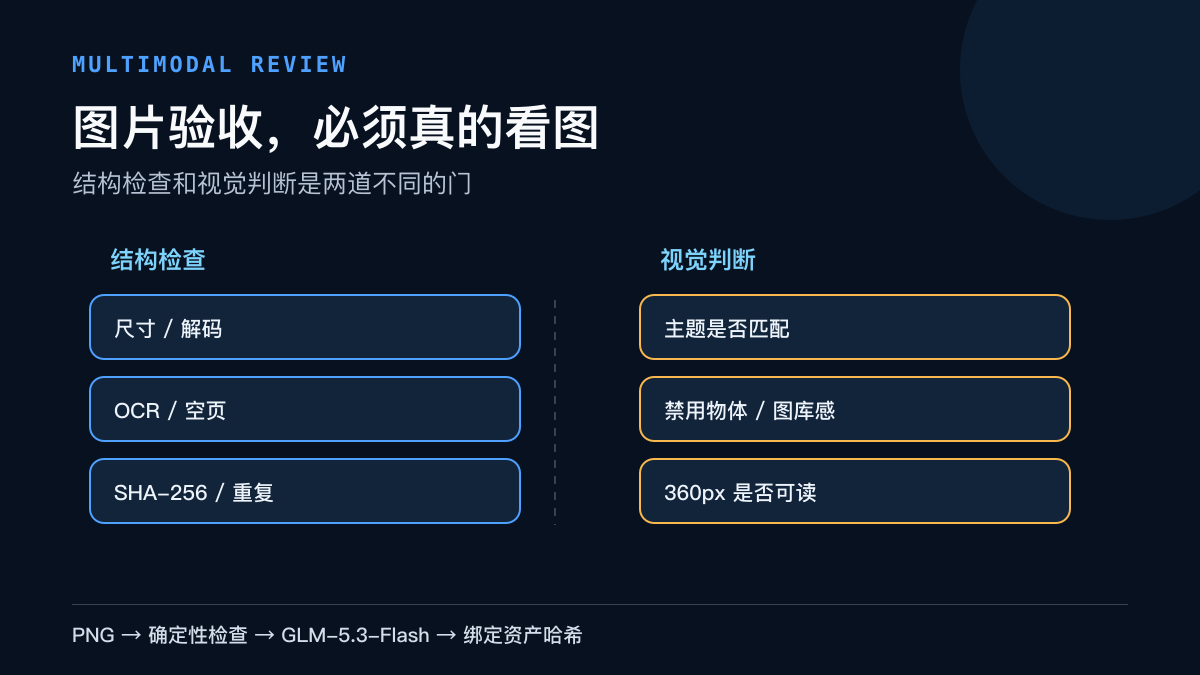
图片流水线里常见的自动检查大致分成两类。
一类是确定性结构检查:
- 图片能否解码,尺寸和比例是否正确;
- OCR 是否发现不该出现的文字;
- 文件是否为空,页面是否溢出;
- SHA-256 是否与审批记录一致;
- 六张卡片是否意外导出了同一份文件。
第二类才是视觉判断:
- 主体是不是提示词要求的对象;
- 是否出现禁用物体,例如手、钢笔、品牌标识;
- 画面是否像随手找来的图库照片;
- 标题缩到信息流尺寸后能否读清;
- 这张图换成另一个主题是否仍然成立;
- 图有没有给正文增加证据,而不只是装饰。
前一类适合用代码硬判,后一类需要真正理解像素内容。把两类结果都叫"视觉验收",会让报告看起来完整,实际却留下明显的质量缺口。
视觉结论还必须留下逐页理由,不能只返回一个总分。
请求体必须包含真实图片
只把 visualBrief、文件名或生图提示词交给模型,得到的是"按意图猜图",不是审图。OpenAI 兼容的请求可以这样组织:
typescript
type ReviewAsset = {
  file: string;
  sha256: string;
  mimeType: "image/png" | "image/jpeg";
  base64: string;
};

function imagePart(asset: ReviewAsset) {
  return {
    type: "image_url",
    image_url: {
      url: `data:${asset.mimeType};base64,${asset.base64}`,
    },
  };
}

const response = await fetch(`${baseUrl}/chat/completions`, {
  method: "POST",
  headers: {
    "content-type": "application/json",
    authorization: `Bearer ${apiKey}`,
  },
  body: JSON.stringify({
    model: "glm-5.3-flash",
    messages: [{
      role: "user",
      content: [
        { type: "text", text: buildReviewPrompt(reviewSpec, assets) },
        ...assets.map(imagePart),
      ],
    }],
    temperature: 0.1,
  }),
});
这里最重要的不是模型名,而是 content 已经从字符串变成了图文内容块。请求日志还应记录资产数量和哈希,但不要记录完整 Base64,避免日志暴涨和素材泄漏。
如果团队正在补这一类上线检查,可以把现有流程和AI 系统上线前检查项逐项对照,重点看视觉输入、审批证据和失败后的回退是否真的存在,而不是只有一行 passed=true。
审核结果必须绑定资产哈希
视觉模型说"通过"以后,图片仍可能被人工覆盖。若审批文件只记录文件路径,新的图片会沿用旧结论。
可以把审核结果收紧成下面的结构:
json
{
  "reviewer": "glm-5.3-flash",
  "reviewedAt": "2026-09-03T12:00:00.000Z",
  "assets": [
    {
      "file": "slide-01.png",
      "sha256": "<64-char-hex>",
      "briefMatch": true,
      "forbiddenObjects": [],
      "headlineReadable": true,
      "topicSpecific": true,
      "stockPhotoRisk": "low",
      "note": "画面主体与隐形签名机制一致,缩略标题仍可读"
    }
  ],
  "verdict": "pass"
}
进入下一阶段前重新计算文件哈希。任何一张图不一致,整份视觉结论立即失效。这不是为了追求形式完整,而是阻止"先审图、后换图"的来源断链。
一组图不能只看 contact sheet
接触表适合判断六页是不是同一模板换字,但它会把小字号和局部错误缩得看不见。更稳妥的输入组合是:
- 一张 contact sheet,用于检查整组节奏和构图重复;
- 一张真实 360 像素信息流缩略图,用于判断封面两秒可读性;
- 每一页原图,用于检查具体对象、文字层级和页面信息增量;
- 长文章同时提供桌面与窄屏整页截图,检查移动端溢出和图片位置。
多图审核时要在提示词里建立顺序映射,例如 asset-01 = contact-sheet.png。否则模型提到"第三张图"时,后续系统无法确认它指的是第 3 页还是第三个附件。
失败结果应该回到明确阶段
视觉审核不能只输出一句"建议优化"。不同问题应回到不同节点:
typescript
function routeFailure(issue: VisualIssue) {
  switch (issue.code) {
    case "forbidden-object":
    case "stock-photo-risk":
    case "brief-mismatch":
      return "base-image";
    case "headline-unreadable":
    case "layout-overflow":
    case "page-shape-repeat":
      return "render";
    case "information-gain-missing":
      return "brief";
    default:
      return "human-review";
  }
}
每次重做生成新的资产哈希,再重新执行结构检查和视觉检查。设置有限重试次数;连续失败后进入人工复核,而不是无限生图。
先用已知坏样本校准
接入视觉模型后,先不要批量跑新图,而要准备一组结果已知的样本:
- 图片里明确有禁用的手和钢笔;
- 360 像素下标题无法辨认;
- 六页实际是同一圆角卡片模板;
- 页面下半部分为空;
- 插图可以无损换到任何 AI 主题;
- 页面描述与实际信息增量不一致。
这些样本必须被阻断。再加入几组合格样本,观察误杀。只有正反样本都稳定,视觉模型才是门禁,而不是新的"自动通过器"。
最终的可靠分工很清楚:代码负责尺寸、哈希、OCR、重复和溢出;多模态模型负责看懂画面;人只处理模型冲突、新视觉机制和抽样复核。这样 Agent Loop 才能日常独立运行,同时保留可追查的质量边界。