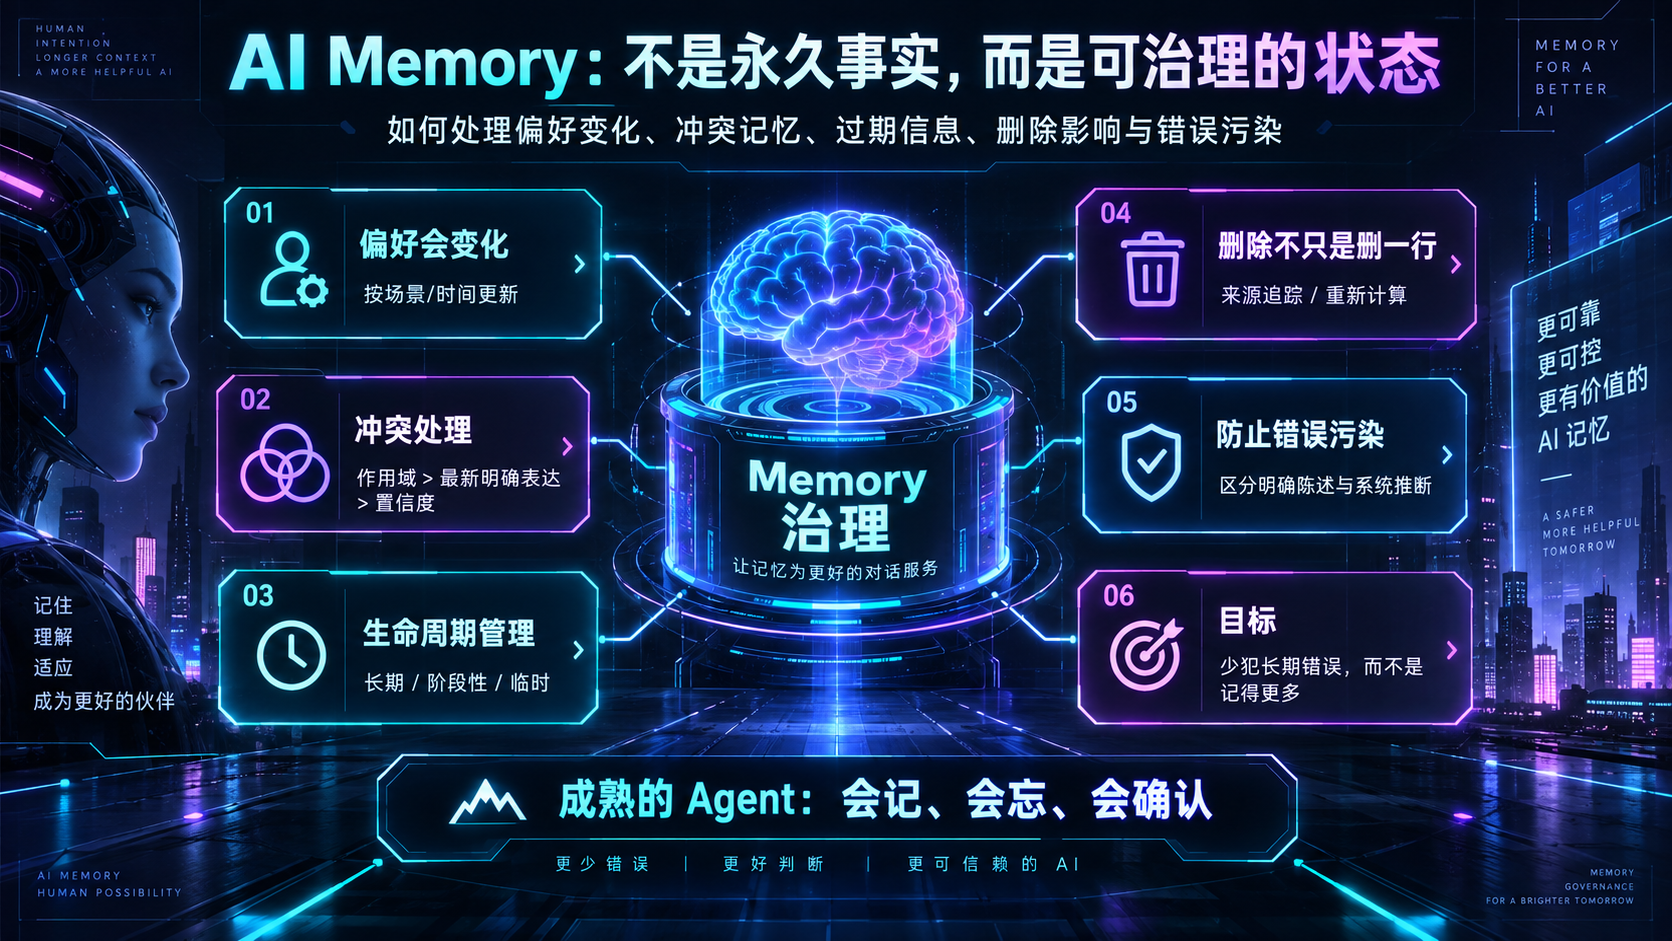
你让一个 AI 助手长期记住你的偏好:写方案时简洁一点、会议纪要先给结论、默认使用中文。几周后,你换了工作场景,希望它输出更正式、更详细。问题来了:旧偏好还算数吗?如果系统里同时存在"喜欢简洁"和"需要详细分析",Agent 应该听谁的?更麻烦的是,一条错误记忆如果被反复调用,会不会越用越"像真的"?
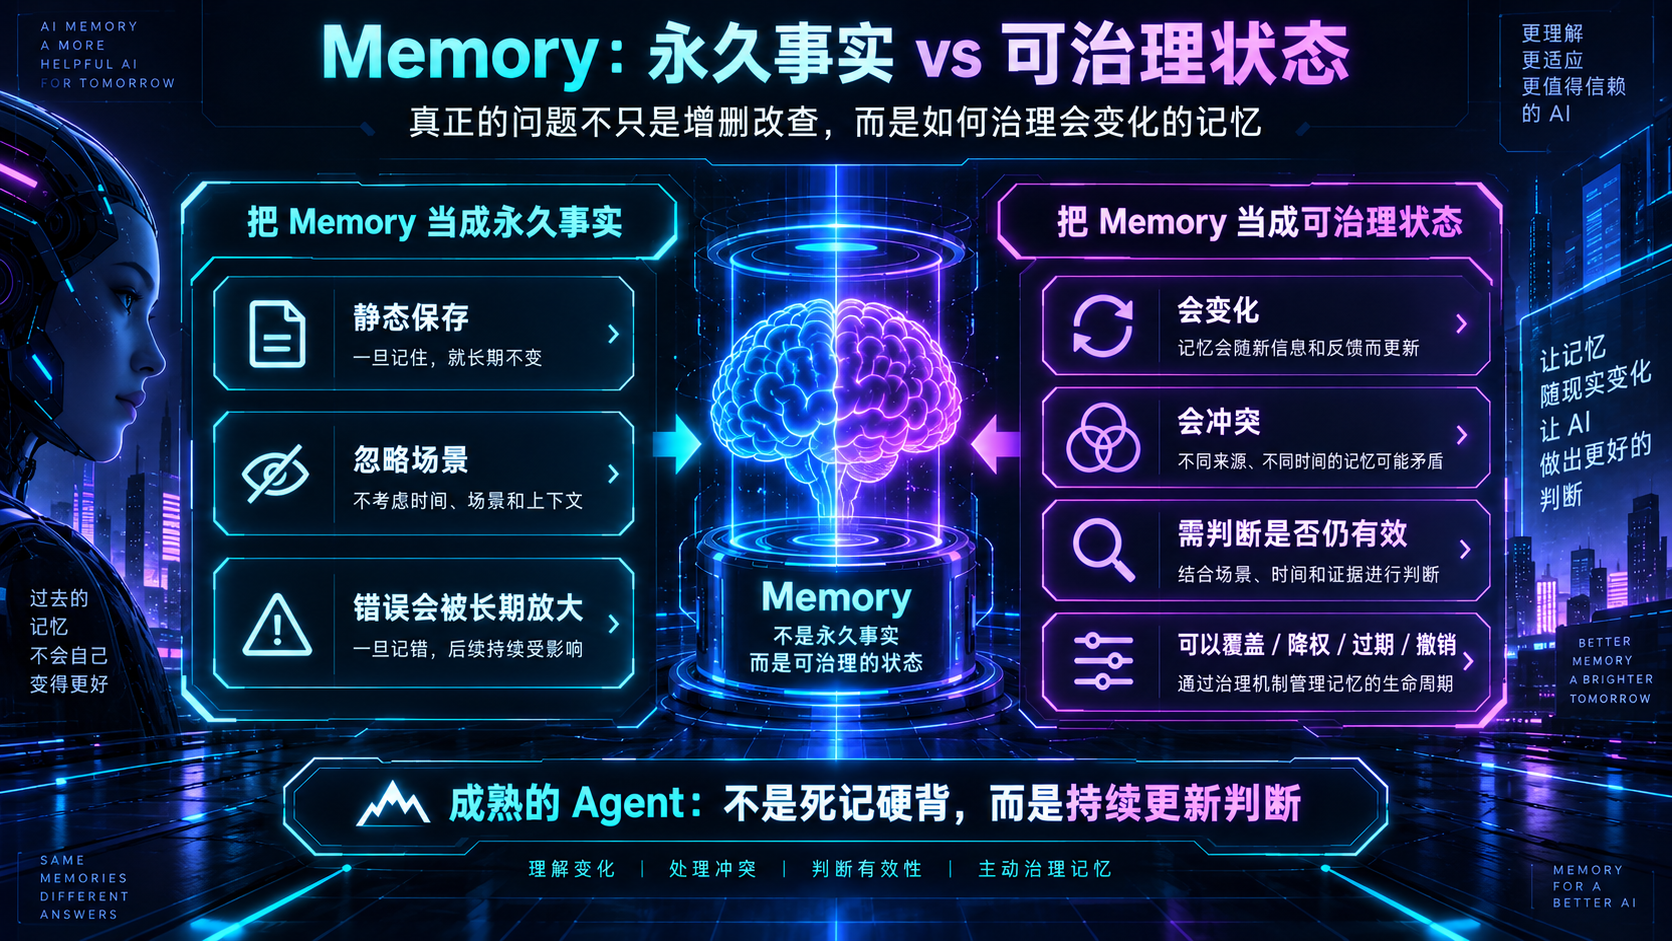
这类问题表面上是在讨论 Memory 的增删改查,真正涉及的是一个更重要的判断:Memory 不应该被当成永久事实,而应该被当成一组会变化、会冲突、需要治理的状态。
用户偏好会变,所以 Memory 必须允许被覆盖
很多系统把"记住用户偏好"理解成写入一条长期记录,然后持续复用。这样做简单,但很危险。
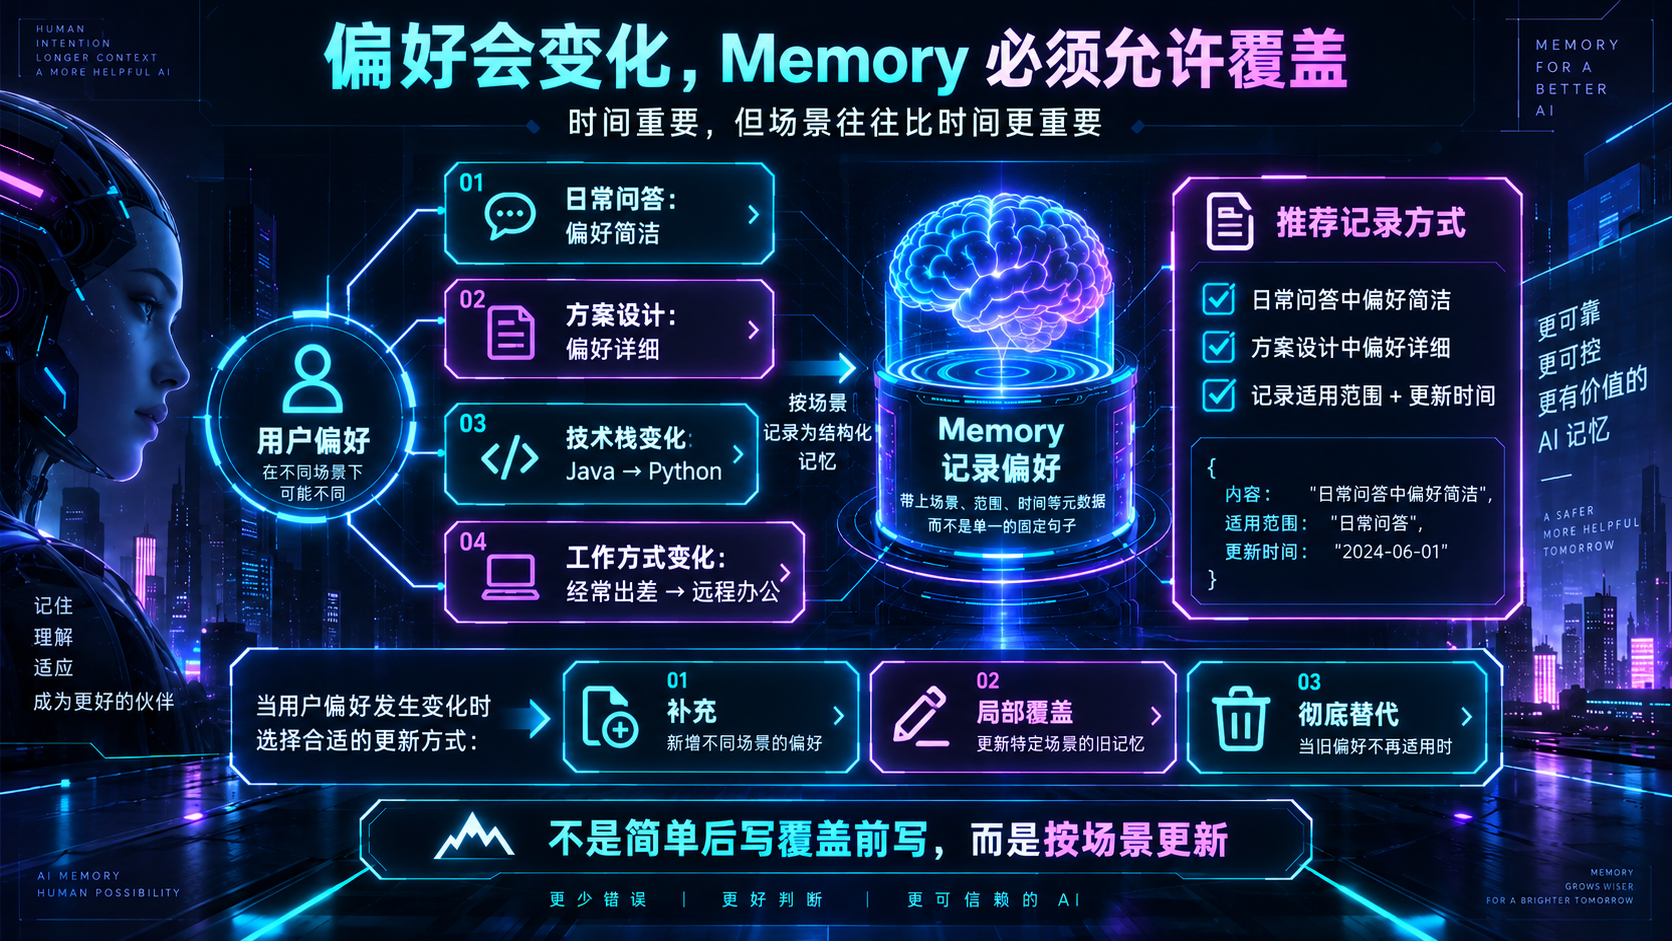
人的偏好天然具有时间性和场景性。一个用户可能平时喜欢简短回答,但写投标方案时希望详细;过去习惯 Java,后来转向 Python;之前经常出差,后来改成远程办公。旧信息没有完全错误,只是适用条件变了。
更稳妥的做法,是给 Memory 增加"适用范围"和"更新时间"。例如,不记录"用户喜欢简洁回答",而记录"在日常问答中偏好简洁;在方案设计中偏好详细"。当新偏好出现时,不必立刻抹掉旧记录,而是判断它是补充、局部覆盖,还是彻底替代。
这意味着 Memory 的更新规则要比"后写覆盖前写"更聪明。时间很重要,但场景往往比时间更重要。
两条 Memory 冲突时,不要急着选一条"真相"
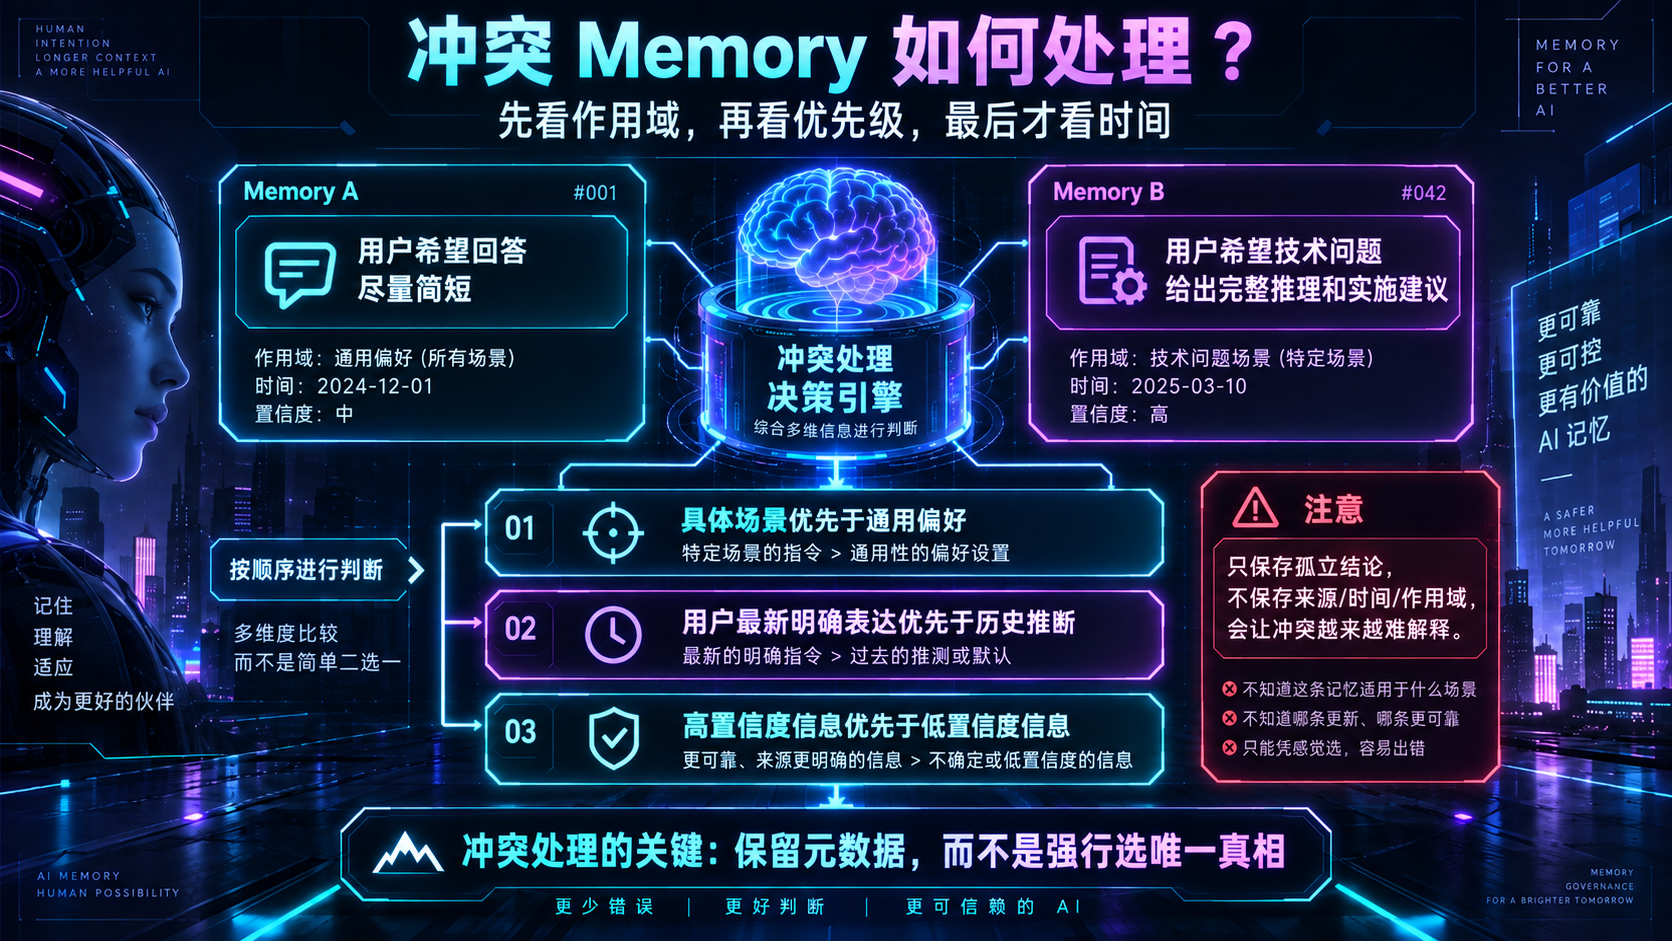
假设系统里有两条记录:
"用户希望回答尽量简短。"
"用户希望技术问题给出完整推理和实施建议。"
这两条并不一定真的冲突。前者可能是通用偏好,后者是技术场景下的特殊要求。合理的处理方式,是先看作用域,再看优先级,最后才看时间。
可以把冲突处理理解成三层规则:具体场景优先于通用偏好;用户最新明确表达优先于历史推断;高置信度信息优先于低置信度信息。
真正危险的是系统只保存一句孤立结论,却不保存它从哪里来、什么时候产生、适用于什么环境。没有这些元数据,Memory 越多,冲突越难解释。
Memory 不一定要"永久保存",很多信息应该自动过期
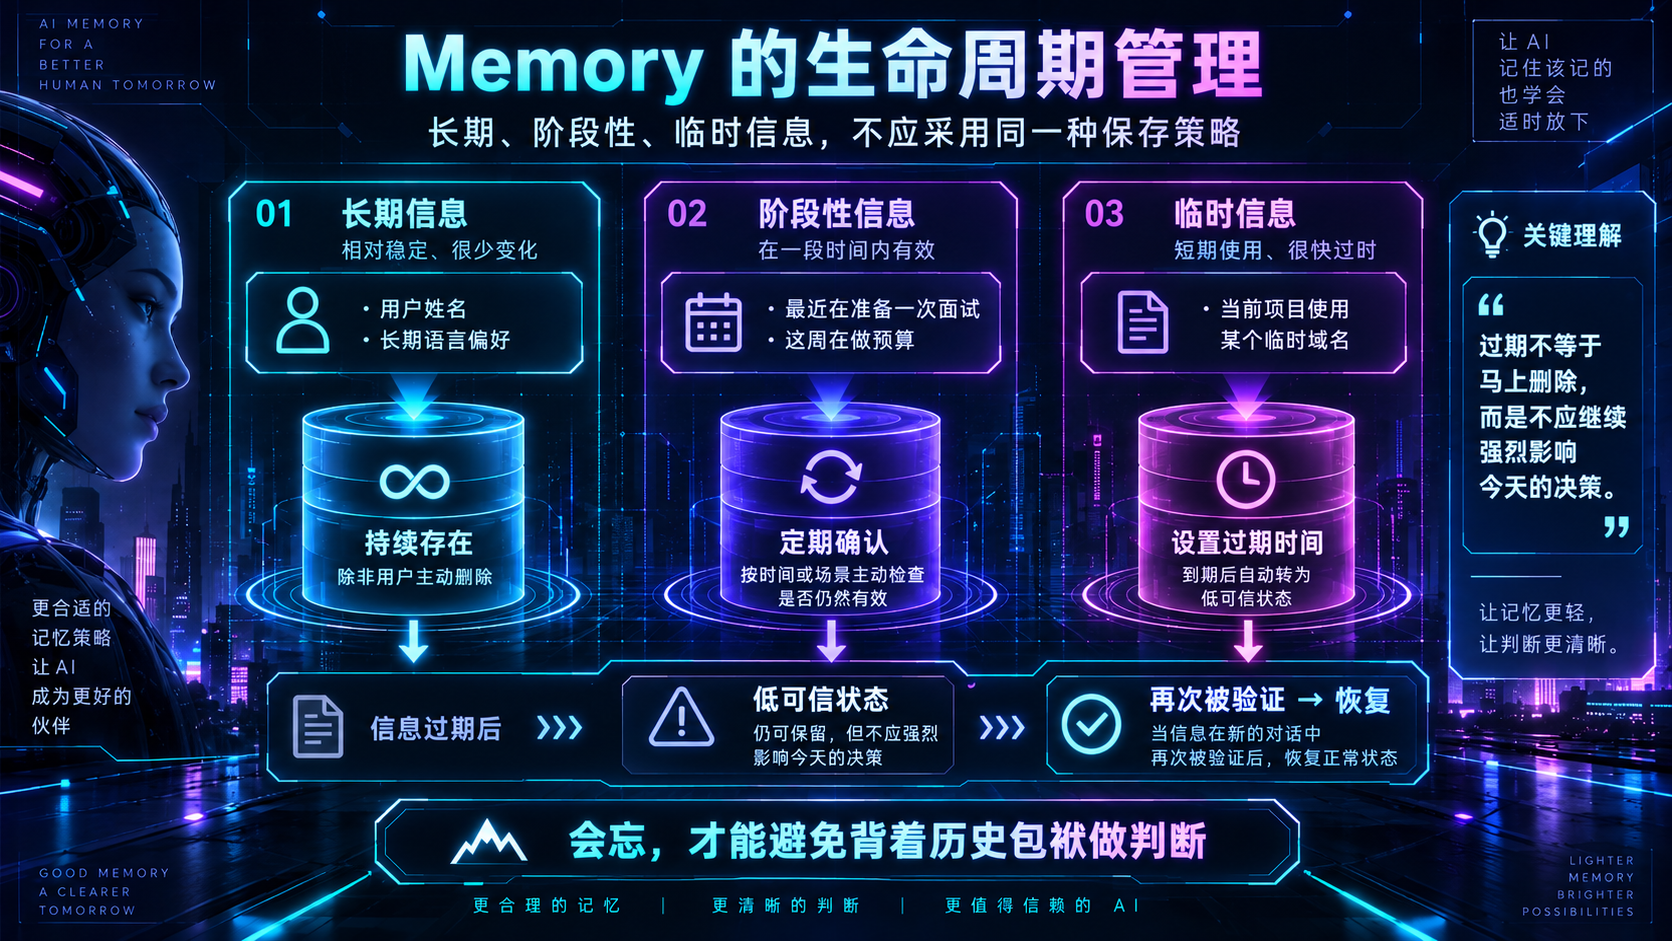
有些 Memory 很稳定,比如用户姓名、长期语言偏好;有些则明显具有保质期,比如"最近在准备一次面试""这周在做预算""当前项目使用某个临时域名"。
如果所有信息都永久保留,Agent 很快会背着一大包历史包袱做判断。
因此,Memory 最好区分长期、阶段性和临时信息。长期信息可以持续存在;阶段性信息需要定期确认;临时信息可以设置过期时间。过期不一定意味着立即删除,也可以先进入"低可信状态",只有再次被验证时才恢复。
这有点像联系人备注。五年前写下的"正在找工作"并不是假信息,只是不应该继续参与今天的决策。
删除 Memory,不只是删数据库里的一行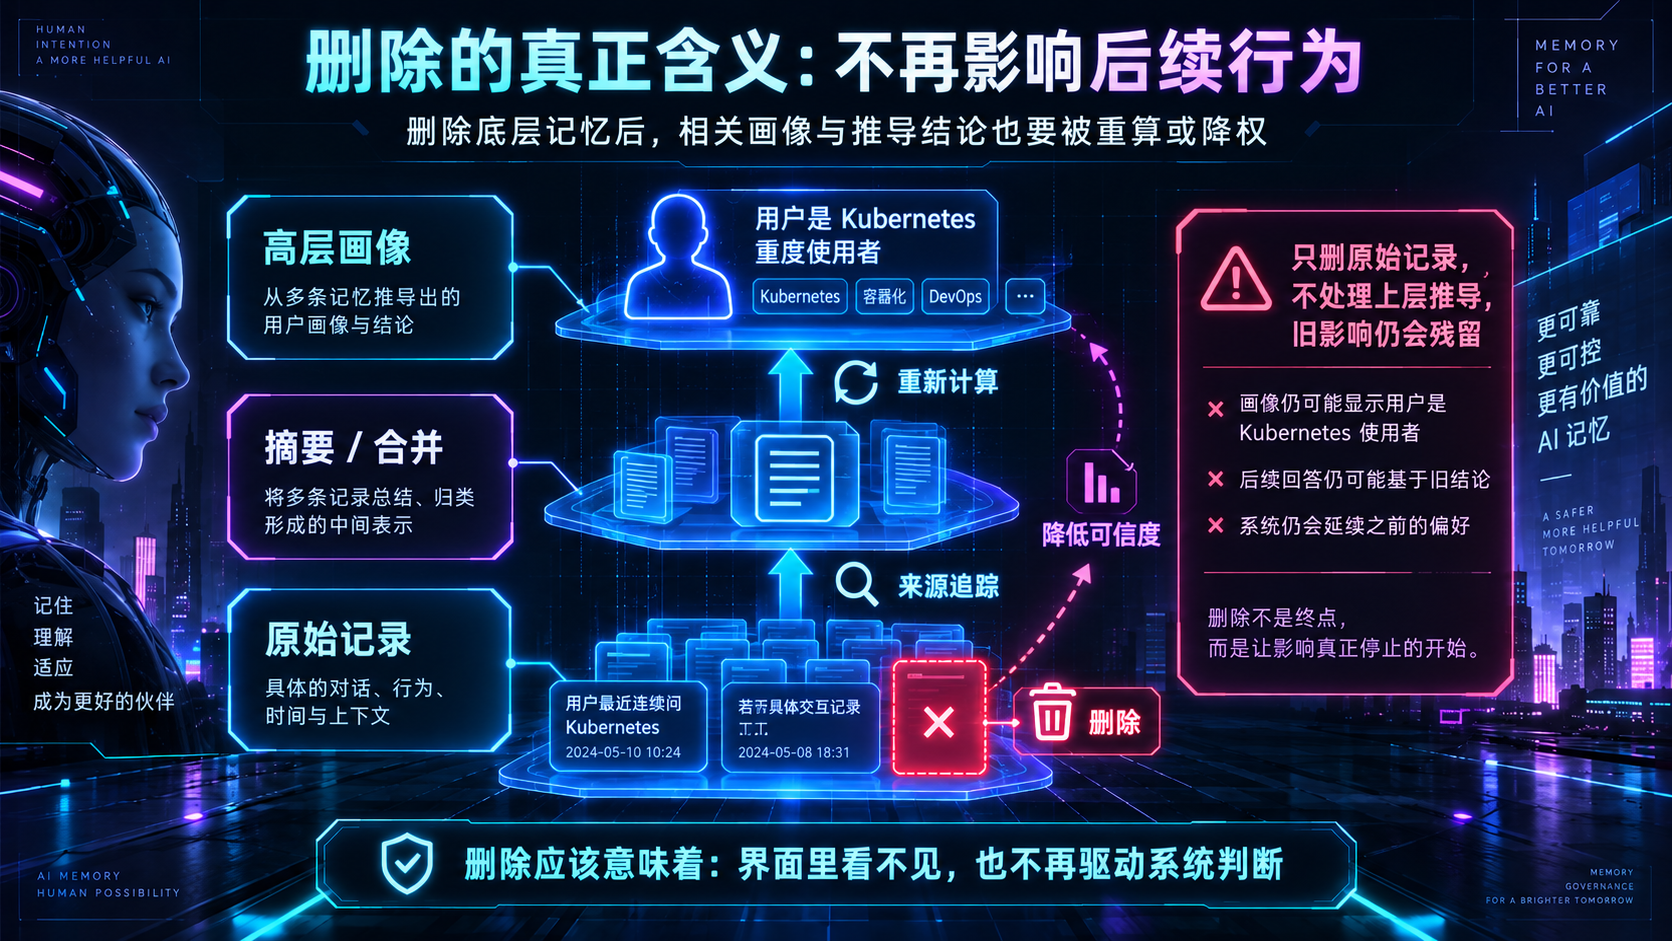
用户说"不要再记住这件事",系统真正需要做的,通常不只是删除一条记录。
一条 Memory 可能已经被摘要、合并,甚至写入更高层的用户画像。例如,系统先记住"用户最近连续问 Kubernetes",后来总结成"用户是 Kubernetes 重度使用者"。此时只删掉最初几条记录,推导出来的画像仍可能继续影响回答。
因此,删除机制最好支持"来源追踪"。每条高层 Memory 应该知道自己由哪些信息推导而来。当底层证据被删除后,相关结论也要重新计算,至少降低可信度。
对用户来说,删除应该意味着"不再影响后续行为",而不仅是"界面里看不见了"。
防止错误 Memory 污染 Agent,关键是让记忆可以被质疑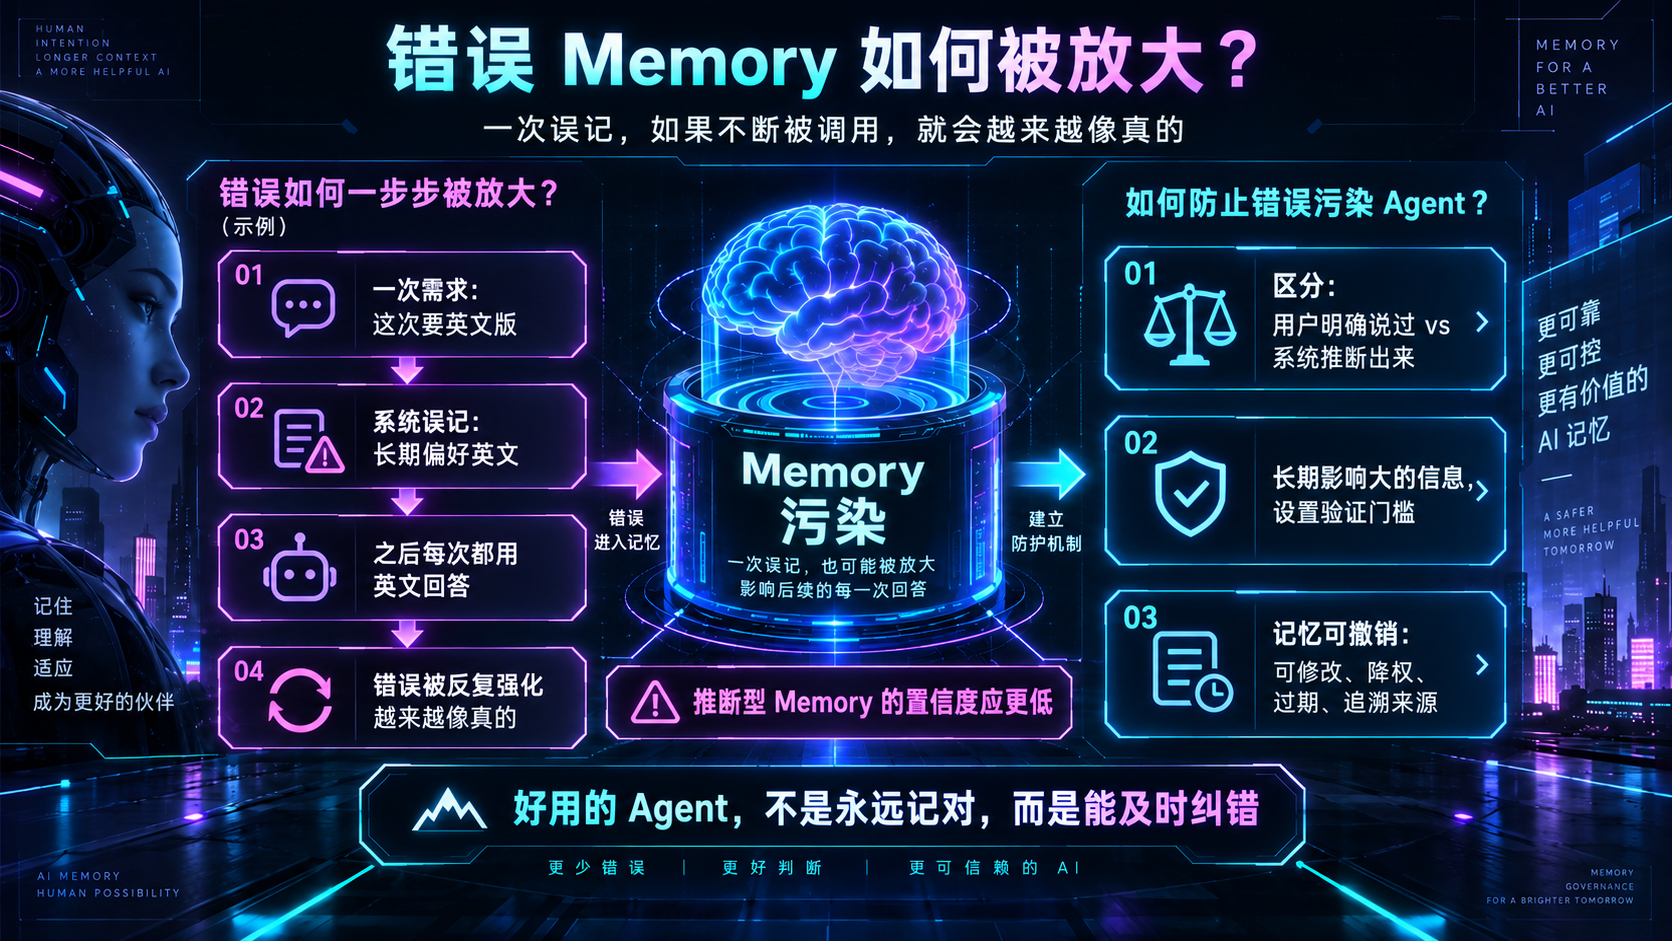
最麻烦的情况不是 Memory 会错,而是系统默认 Memory 不会错。
假设 Agent 误把"用户这次要英文版"记成"用户长期偏好英文"。之后每次都用英文回答,用户又没有及时纠正,这条错误记录就可能不断被重复强化。久而久之,系统甚至会把它当成稳定偏好。
避免这种污染,至少需要三道保护。
第一,区分"用户明确说过"和"系统推断出来"。推断型 Memory 的置信度应该更低。第二,对长期影响较大的信息设置验证门槛,不要因为一次行为就写入永久偏好。第三,让 Memory 具备可撤销性:可以修改、降权、过期,也可以追溯来源。
一个好用的 Agent,不应该拥有"永远正确的记忆",而应该拥有"可以修正的记忆"。
Memory 管理的目标,不是记得更多,而是少犯长期错误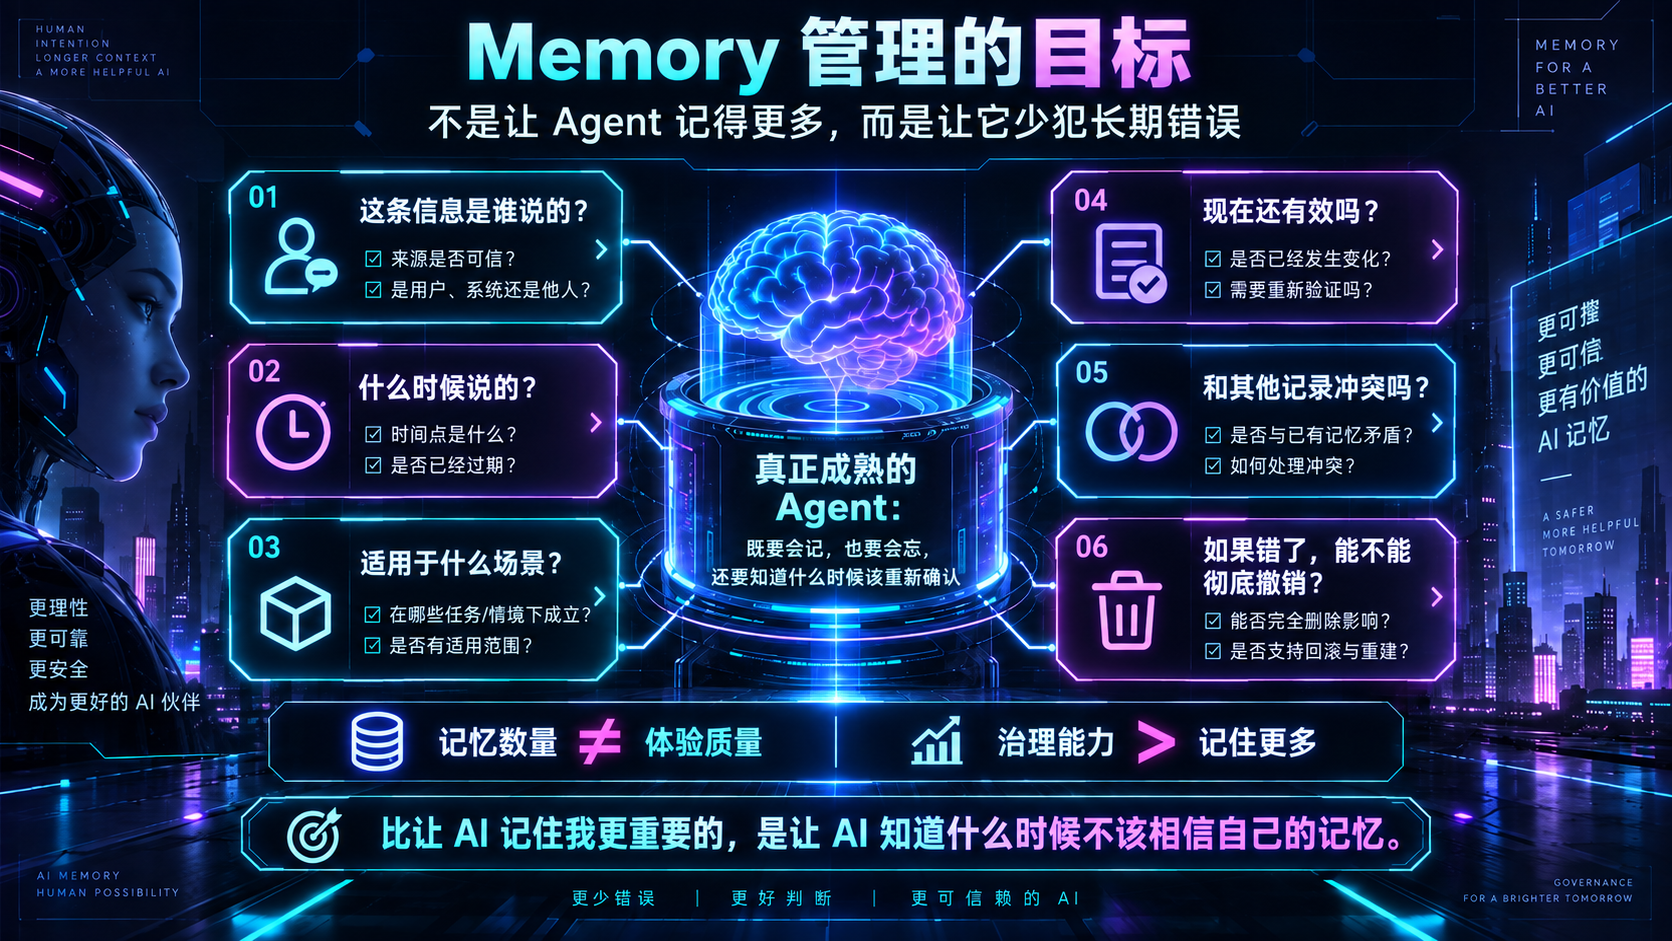
很多人设计 Memory 时,最先想到的是容量:怎样让 Agent 记住更多信息。但从长期体验看,真正决定质量的往往不是记忆数量,而是治理能力。
一个可靠的 Memory 系统至少要回答几个问题:这条信息是谁说的?什么时候说的?适用于什么场景?现在还有效吗?和其他记录冲突吗?如果错了,能不能彻底撤销?
如果这些问题没有答案,记忆越丰富,Agent 反而越容易被过去绑架。
所以,比"让 AI 记住我"更重要的,是让 AI 知道什么时候不该相信自己的记忆。Memory 不是静态档案,而是一套持续更新的判断系统。真正成熟的 Agent,既要会记,也要会忘,还要知道什么时候该重新确认。