精彩专栏推荐订阅:在下方主页👇🏻👇🏻👇🏻👇🏻
💖🔥作者主页 :计算机毕设木哥🔥 💖
文章目录
- 一、项目介绍
- 二、视频展示
- 三、开发环境
- 四、系统展示
- 五、代码展示
- 六、项目文档展示
- 七、项目总结
- [<font color=#fe2c24 >大家可以帮忙点赞、收藏、关注、评论啦 👇🏻](#fe2c24 >大家可以帮忙点赞、收藏、关注、评论啦 👇🏻)
一、项目介绍
健身房会员规模持续扩张,手环打卡、课程预约、膳食记录等渠道每日产出大量用户行为数据,但多数场馆仍停留在基础信息录入层面,缺少对运动负荷、饮食结构与体征指标之间关联的深度分析能力,导致运营决策和个性化服务缺乏数据支撑。本文通过开发一个基于大数据的用户健身行为数据分析与可视化系统,用以帮助解决健身房用户行为数据的整合分析与可视化呈现问题,为管理者和用户提供可交互的决策参考工具。
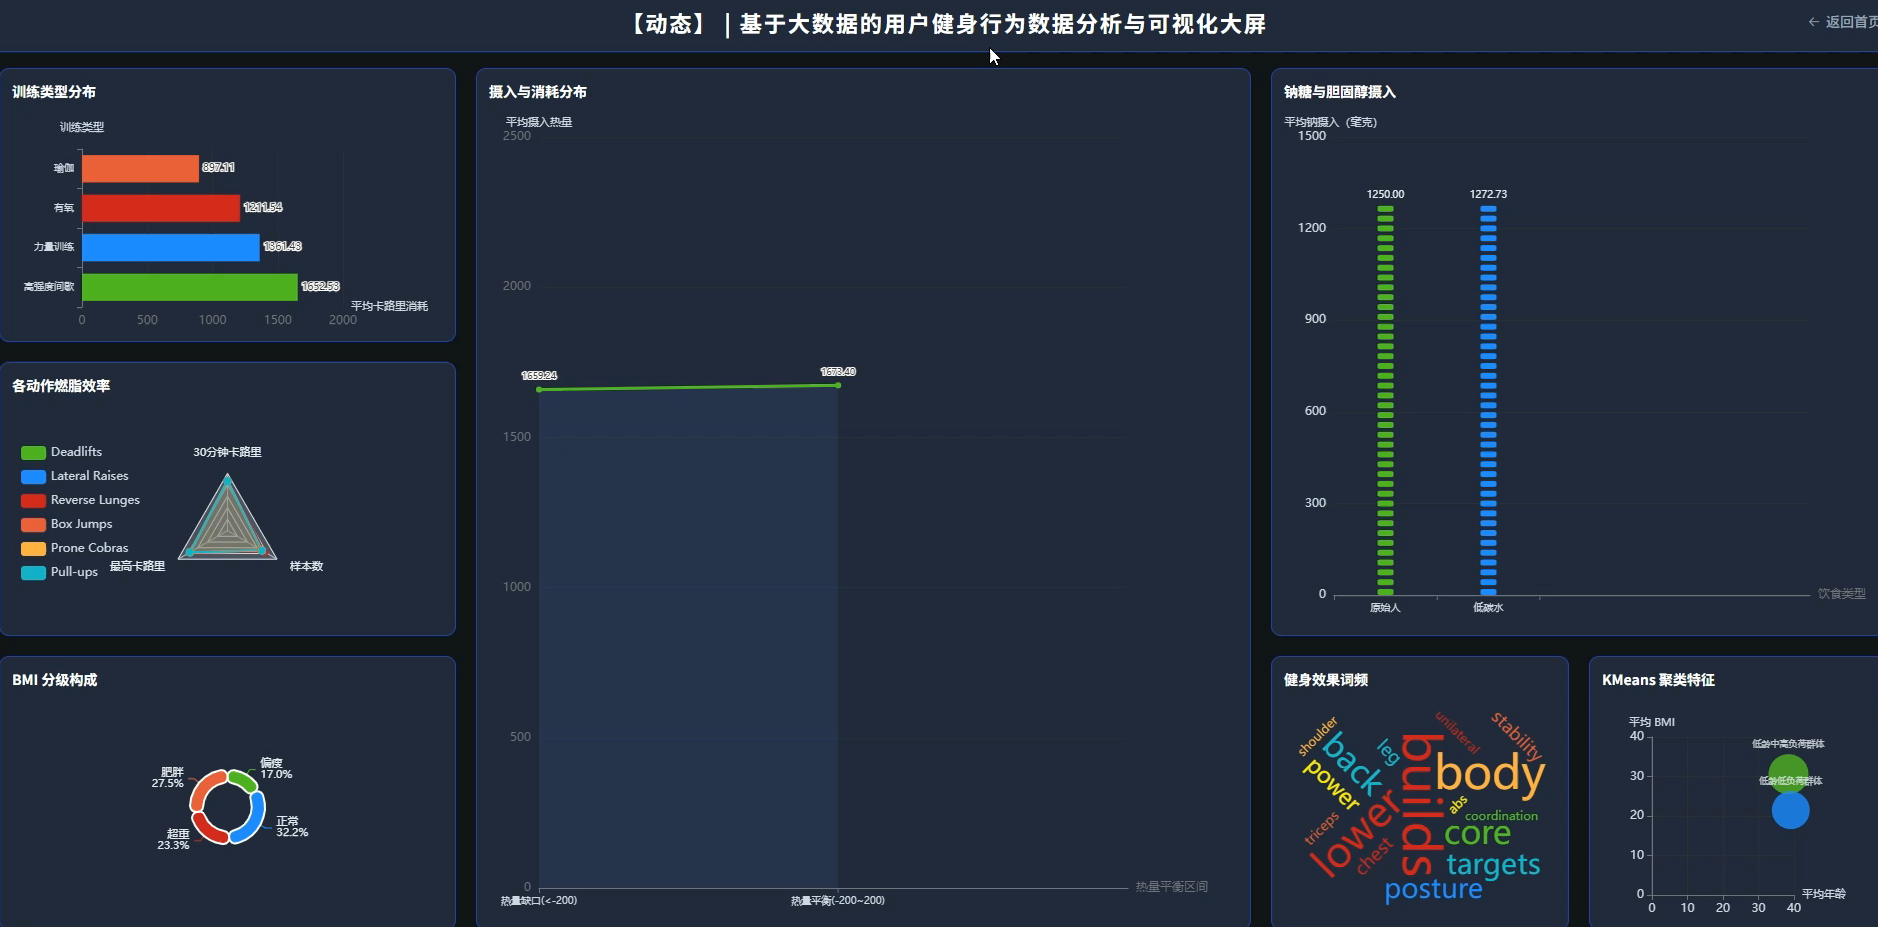
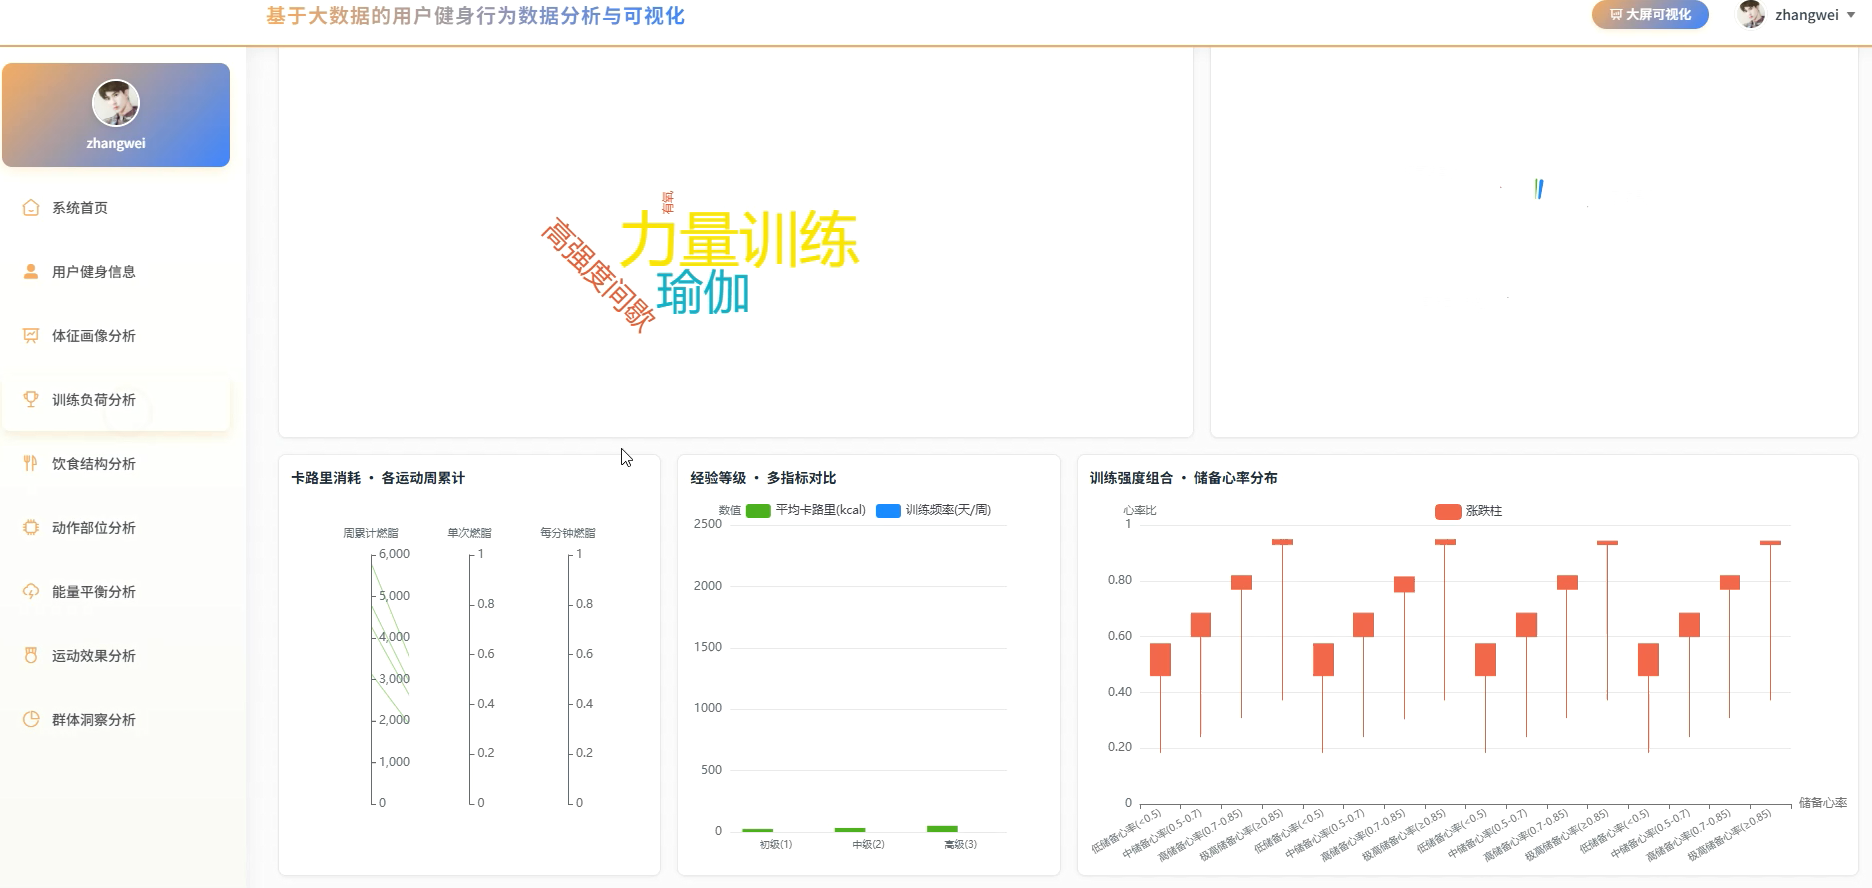
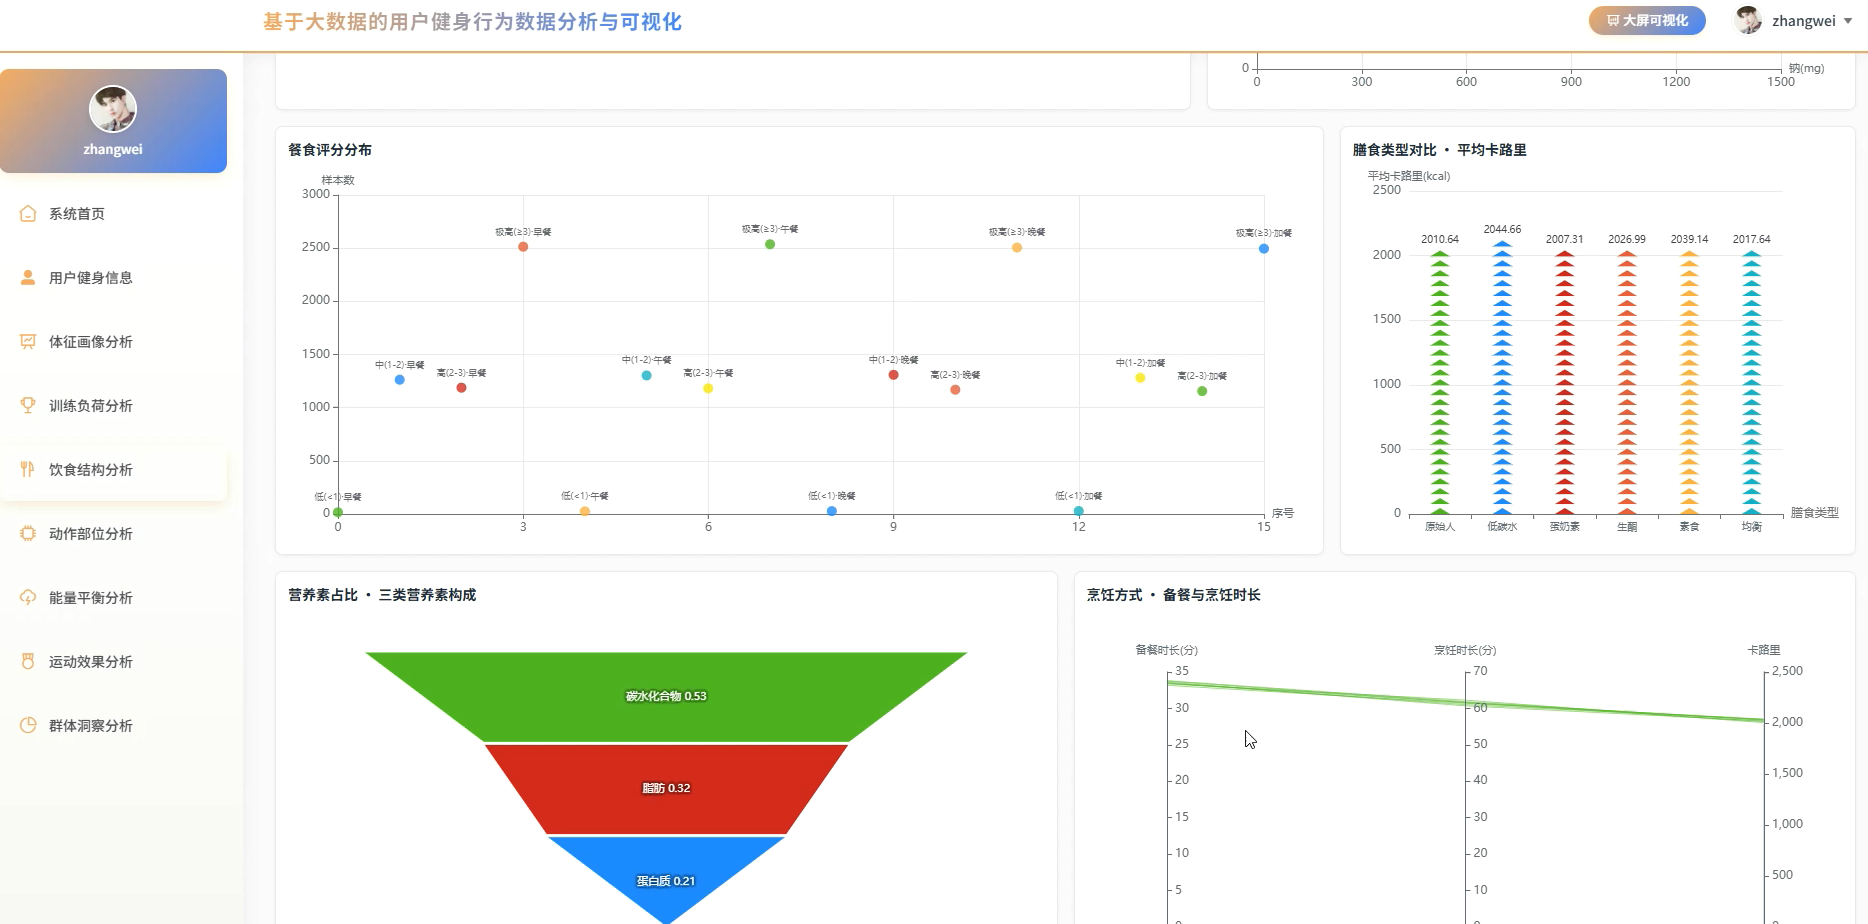
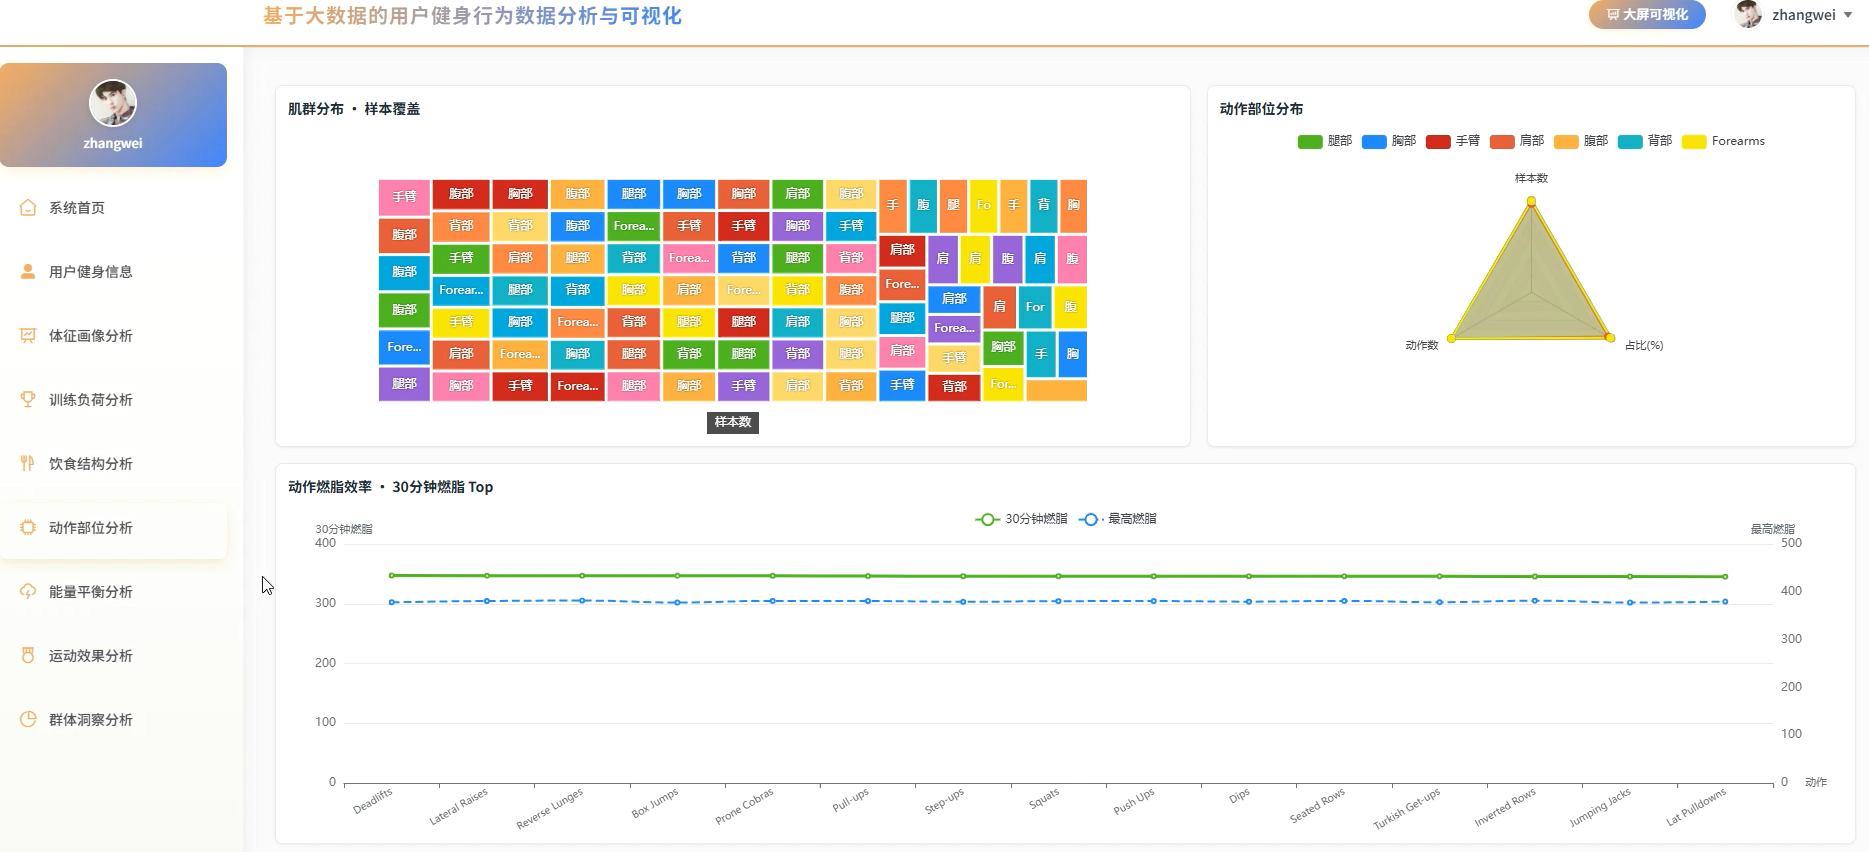
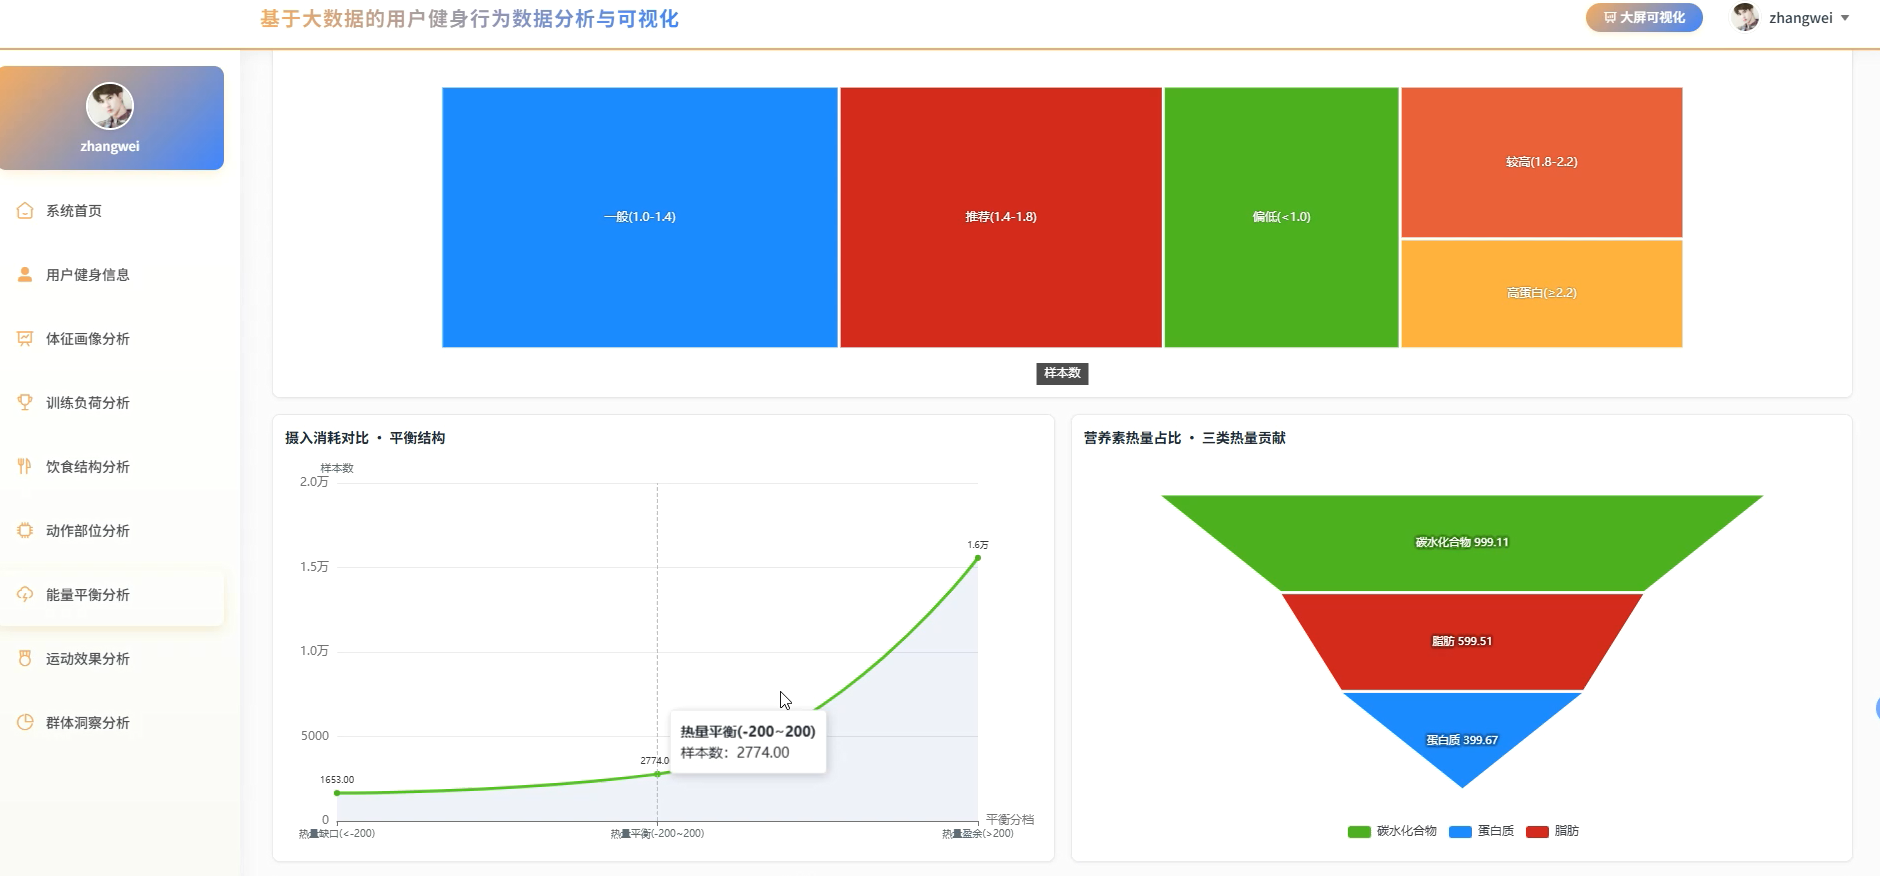
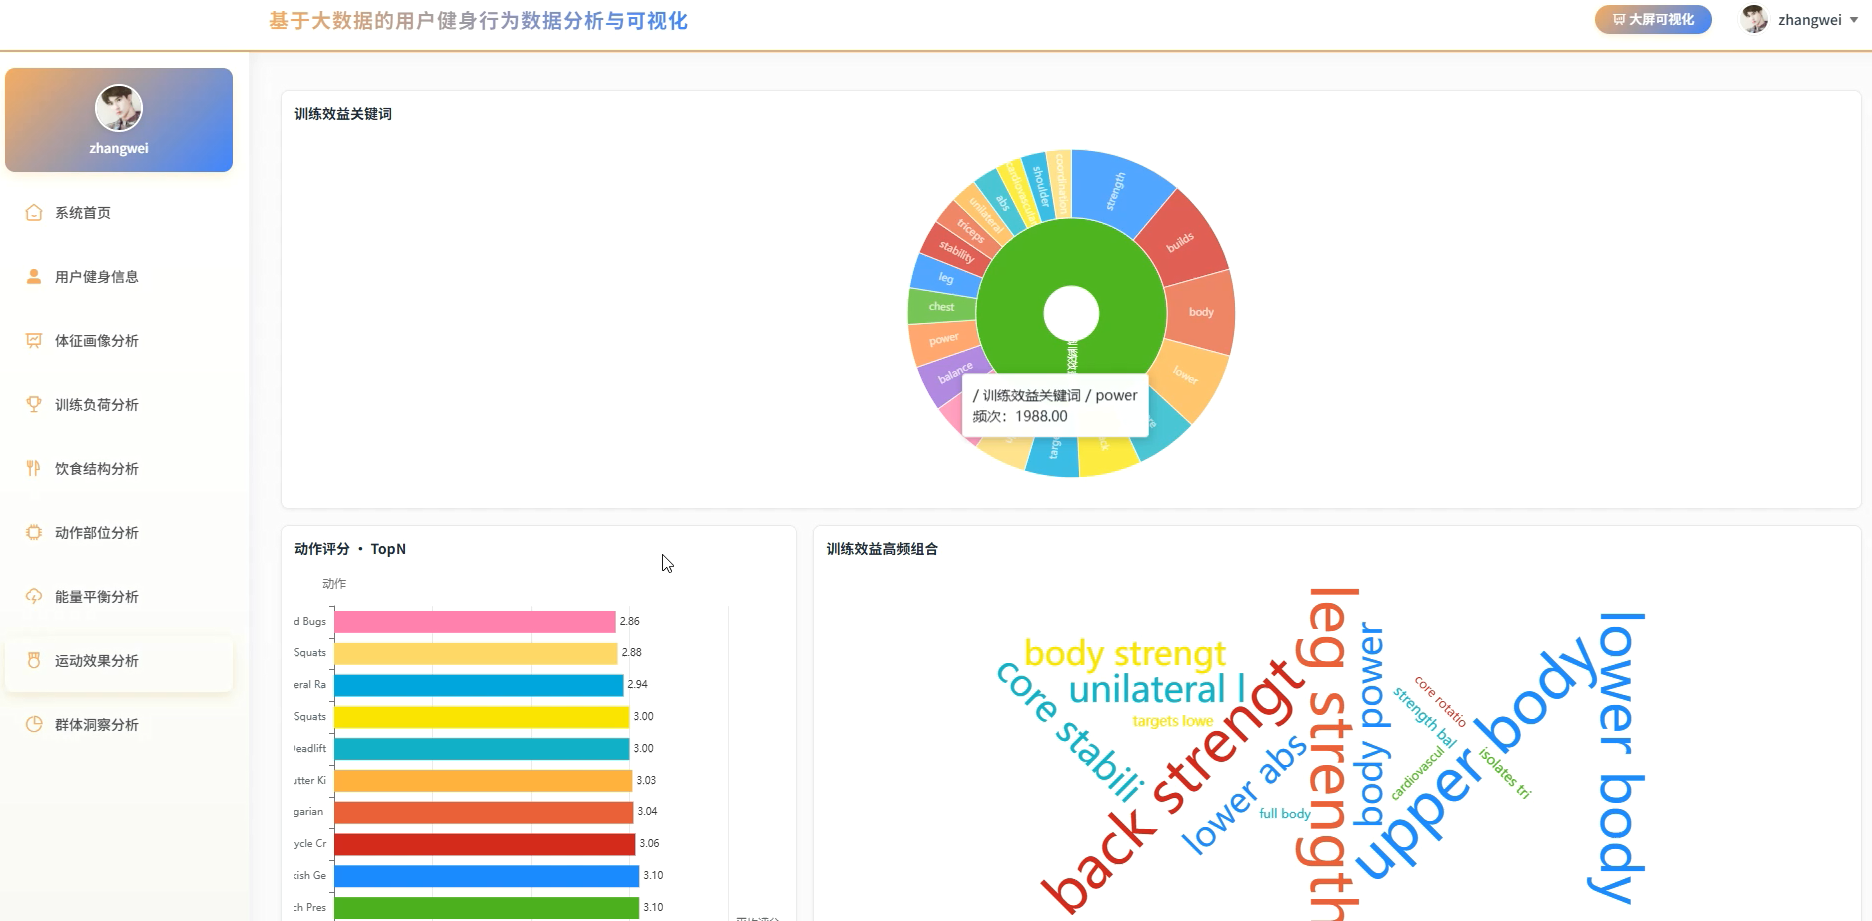
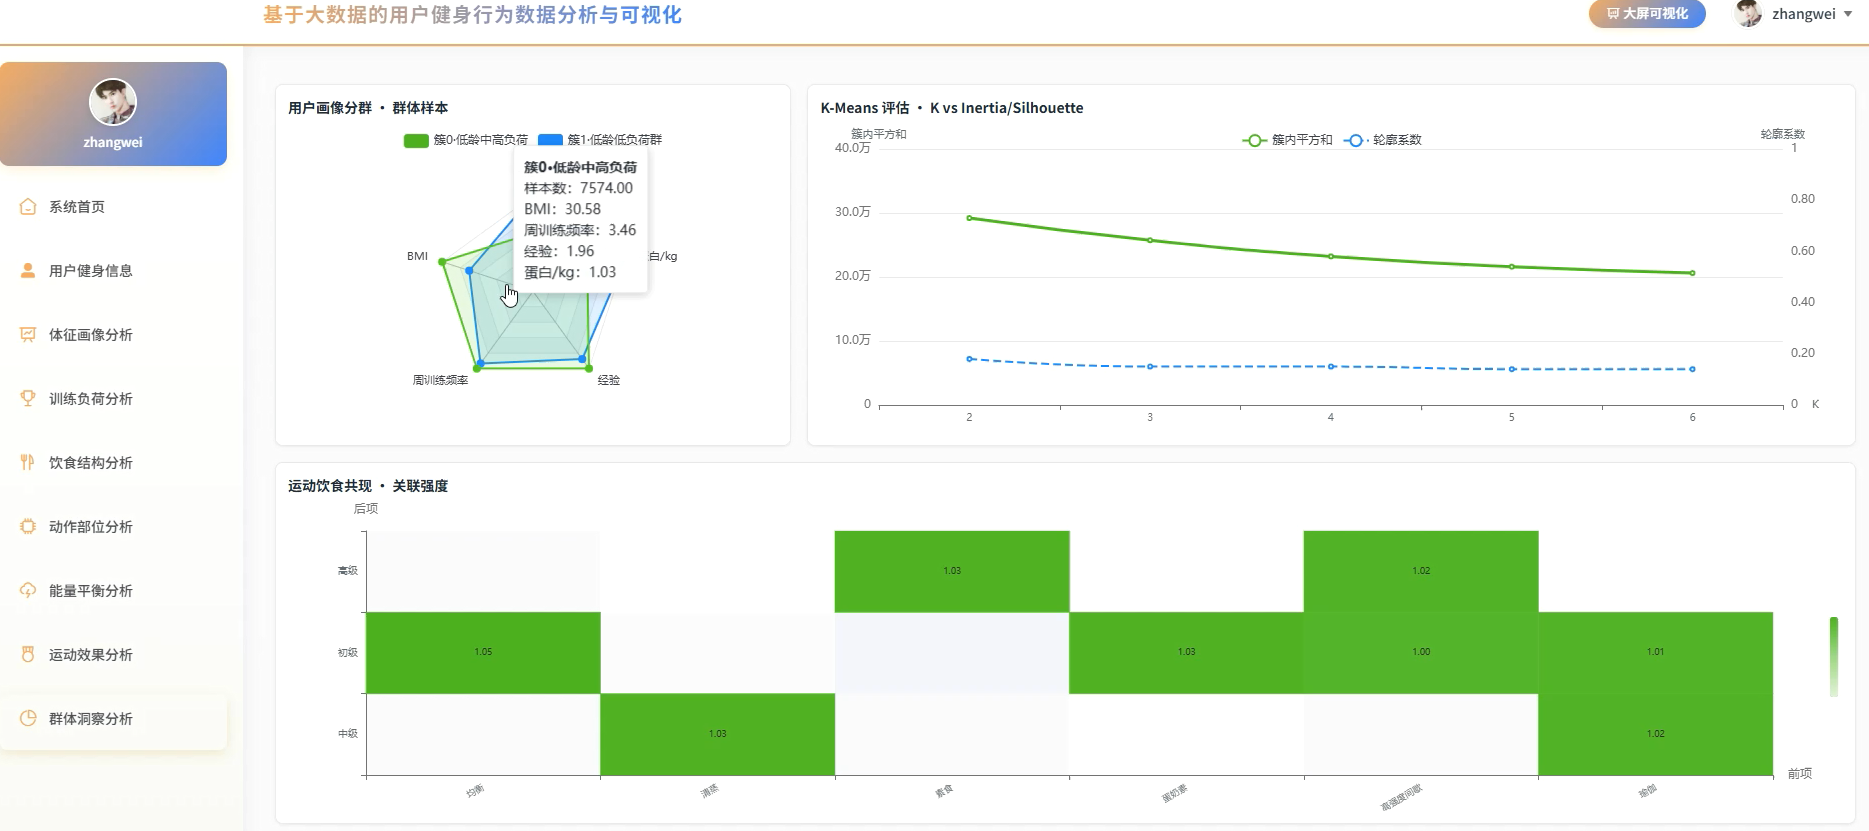
系统采用PySpark读取HDFS上的原始数据集完成缺失值处理与字段类型校验,利用分布式计算框架对20000条样本、54个字段进行聚合统计与衍生指标计算。前端基于Vue框架集成ECharts图表库,输出体征画像、训练负荷、饮食结构、动作部位、能量平衡、运动效果六个业务维度的统计图表与大屏看板,同时部署K-Means用户聚类、Isolation Forest异常检测、FP-Growth关联规则三个算法分析模块,对全部分析结果按管理员与用户双角色做权限拆分与展示。
经系统测试,该系统能满足健身房运营人员对用户群体特征识别与异常训练定位的需求,同时为普通用户提供自身数据与分组基准的对比查看能力,其数据驱动思路对同类健身服务场景的分析工具有一定的参考价值。
二、视频展示
计算机毕设选题做什么好?基于大数据的用户健身行为数据分析
三、开发环境
- 大数据技术:Hadoop、Spark、Hive
- 开发技术:Python、Django框架、Vue、Echarts
- 软件工具:Pycharm、DataGrip、Anaconda
- 可视化 工具 Echarts
四、系统展示
系统页面模块展示:
五、代码展示
bash
import pyspark.sql.functions as F
from pyspark.sql import SparkSession
from pyspark.sql.types import DoubleType, StringType, IntegerType
import pandas as pd

spark = SparkSession.builder \
    .appName("FitnessBehaviorAnalysis") \
    .config("spark.sql.adaptive.enabled", "true") \
    .getOrCreate()

# 读取CSV,显式指定编码处理BOM
df = spark.read \
    .option("header", "true") \
    .option("inferSchema", "true") \
    .option("encoding", "utf-8-sig") \
    .csv("hdfs:///fitness_data/Final_data.csv")

# 剔除异常列(序列化泄漏字段)
drop_cols = ["Burns Calories (per 30 min)_bc", "meal_name", "BMI_calc"]
df_clean = df.drop(*[c for c in drop_cols if c in df.columns])

# 数值字段保留2位小数
numeric_cols = ["Age", "Weight", "Height", "BMI", "Fat_Percentage",
                "Max_BPM", "Avg_BPM", "Session_Duration", "Calories_Burned"]
for col_name in numeric_cols:
    if col_name in df_clean.columns:
        df_clean = df_clean.withColumn(col_name, F.round(F.col(col_name), 2))

# 缓存清洗后数据集
df_clean.cache()
df_clean.write.mode("overwrite").csv("output/fitness_preprocessed_data.csv", header=True)
六、项目文档展示

七、项目总结
本课题围绕健身房用户行为数据的整合分析与可视化呈现,设计并实现了一套基于大数据的健身行为数据分析系统。系统以20000条真实用户运动与饮食记录为基础,覆盖体征画像、训练负荷、饮食结构、动作部位、能量平衡、运动效果、群体洞察七个业务分析维度,前端采用Vue框架与ECharts图表库构建可交互的大屏看板,后端通过PySpark连接Hadoop分布式存储完成数据清洗与聚合统计,支持按管理员与用户双角色展示不同颗粒度的分析结果。在算法应用层面,系统部署了K-Means聚类用于用户画像分群,结合肘部法则自动确定最佳分组数,输出各群体核心特征标签;采用Isolation Forest对训练数据进行异常检测,识别心血管负荷或燃脂效率偏离正常范围的样本;同时利用FP-Growth算法挖掘运动类型、膳食风格、烹饪方式、装备需求与难度等级之间的频繁项集与关联规则,揭示运动与饮食组合中的典型共现场景。整体而言,系统能够帮助运营人员快速识别高消耗用户群与异常训练行为,同时为普通用户提供自身数据与分组基准的对比参考,其数据驱动的分析框架对同类健身服务场景的用户行为理解与运营决策具备实际参考价值。
大家可以帮忙点赞、收藏、关注、评论啦 👇🏻
💖🔥作者主页 :计算机毕设木哥🔥 💖