精彩专栏推荐订阅:在下方主页👇🏻👇🏻👇🏻👇🏻
💖🔥作者主页 :计算机毕设木哥🔥 💖
文章目录
- 一、项目介绍
- 二、视频展示
- 三、开发环境
- 四、系统展示
- 五、代码展示
- 六、项目文档展示
- 七、项目总结
- [<font color=#fe2c24 >大家可以帮忙点赞、收藏、关注、评论啦 👇🏻](#fe2c24 >大家可以帮忙点赞、收藏、关注、评论啦 👇🏻)
一、项目介绍
移动互联网催生了大量用户饮食行为数据,这些数据背后隐藏着品类偏好、时段活跃度与地域口味差异等规律。传统餐饮运营多依赖经验判断,缺乏对行为数据的系统挖掘与利用。本文通过开发基于大数据的用户美食数据分析与可视化系统,用以帮助运营者从行为数据中识别用户画像与消费倾向,支撑精细化决策。
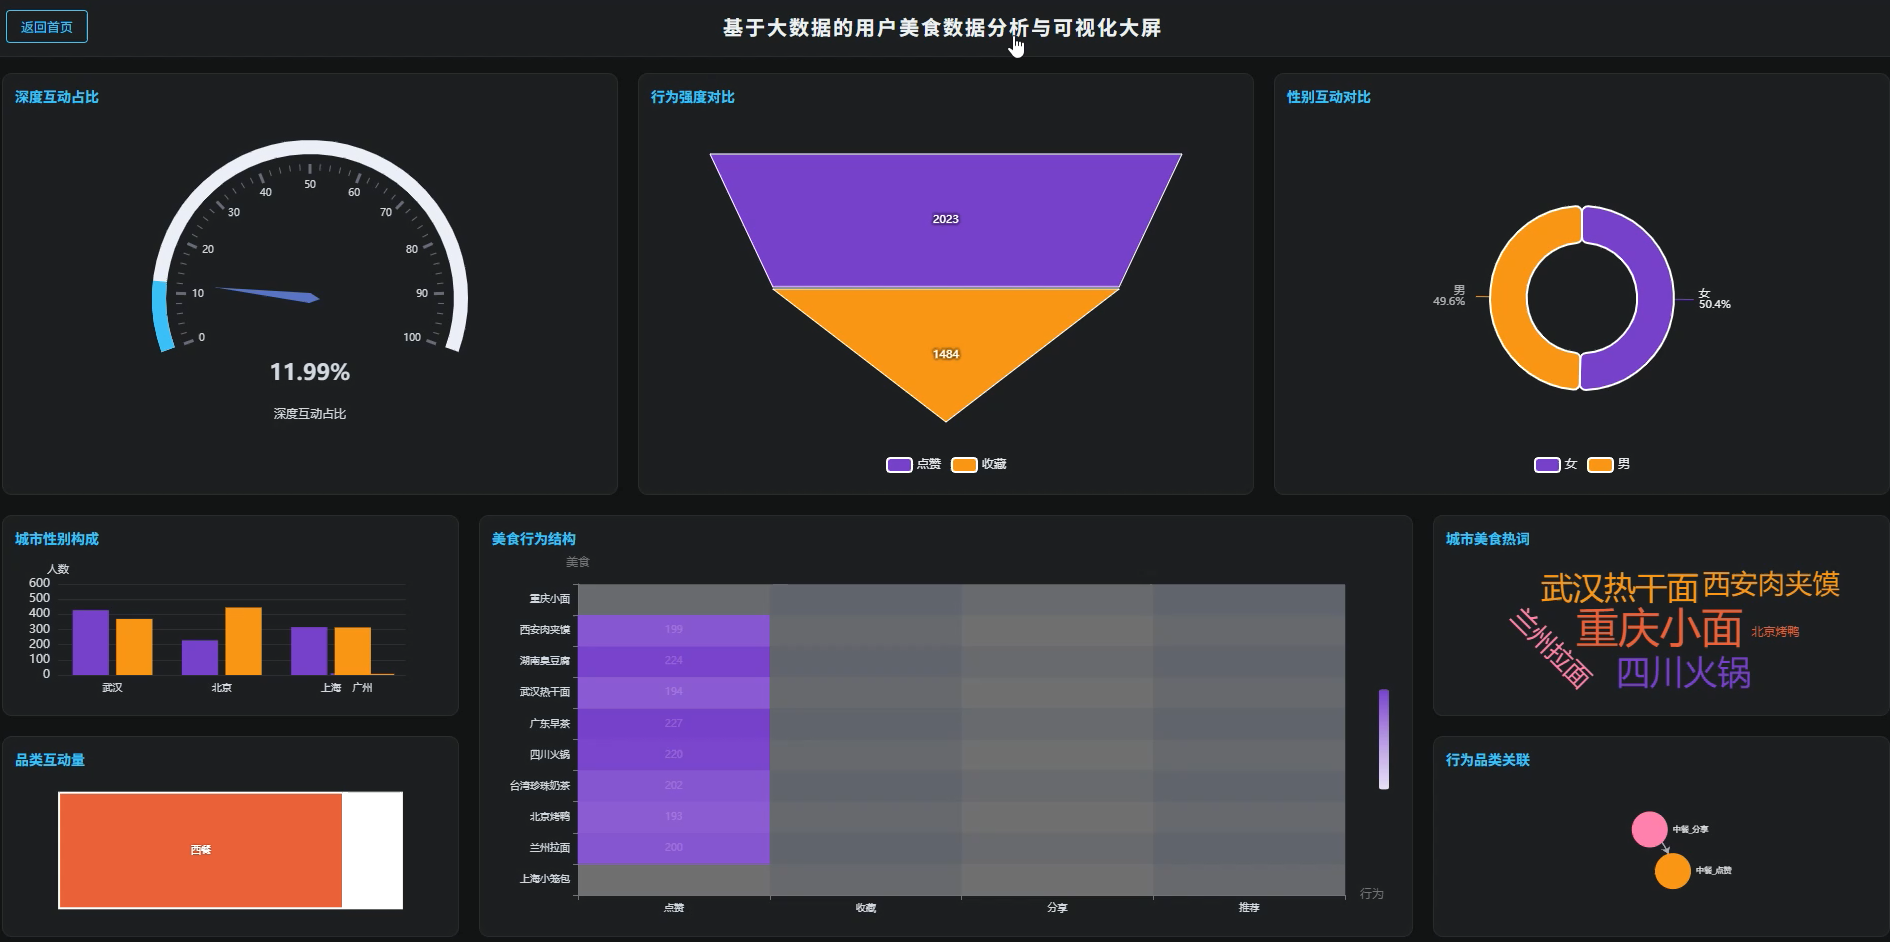
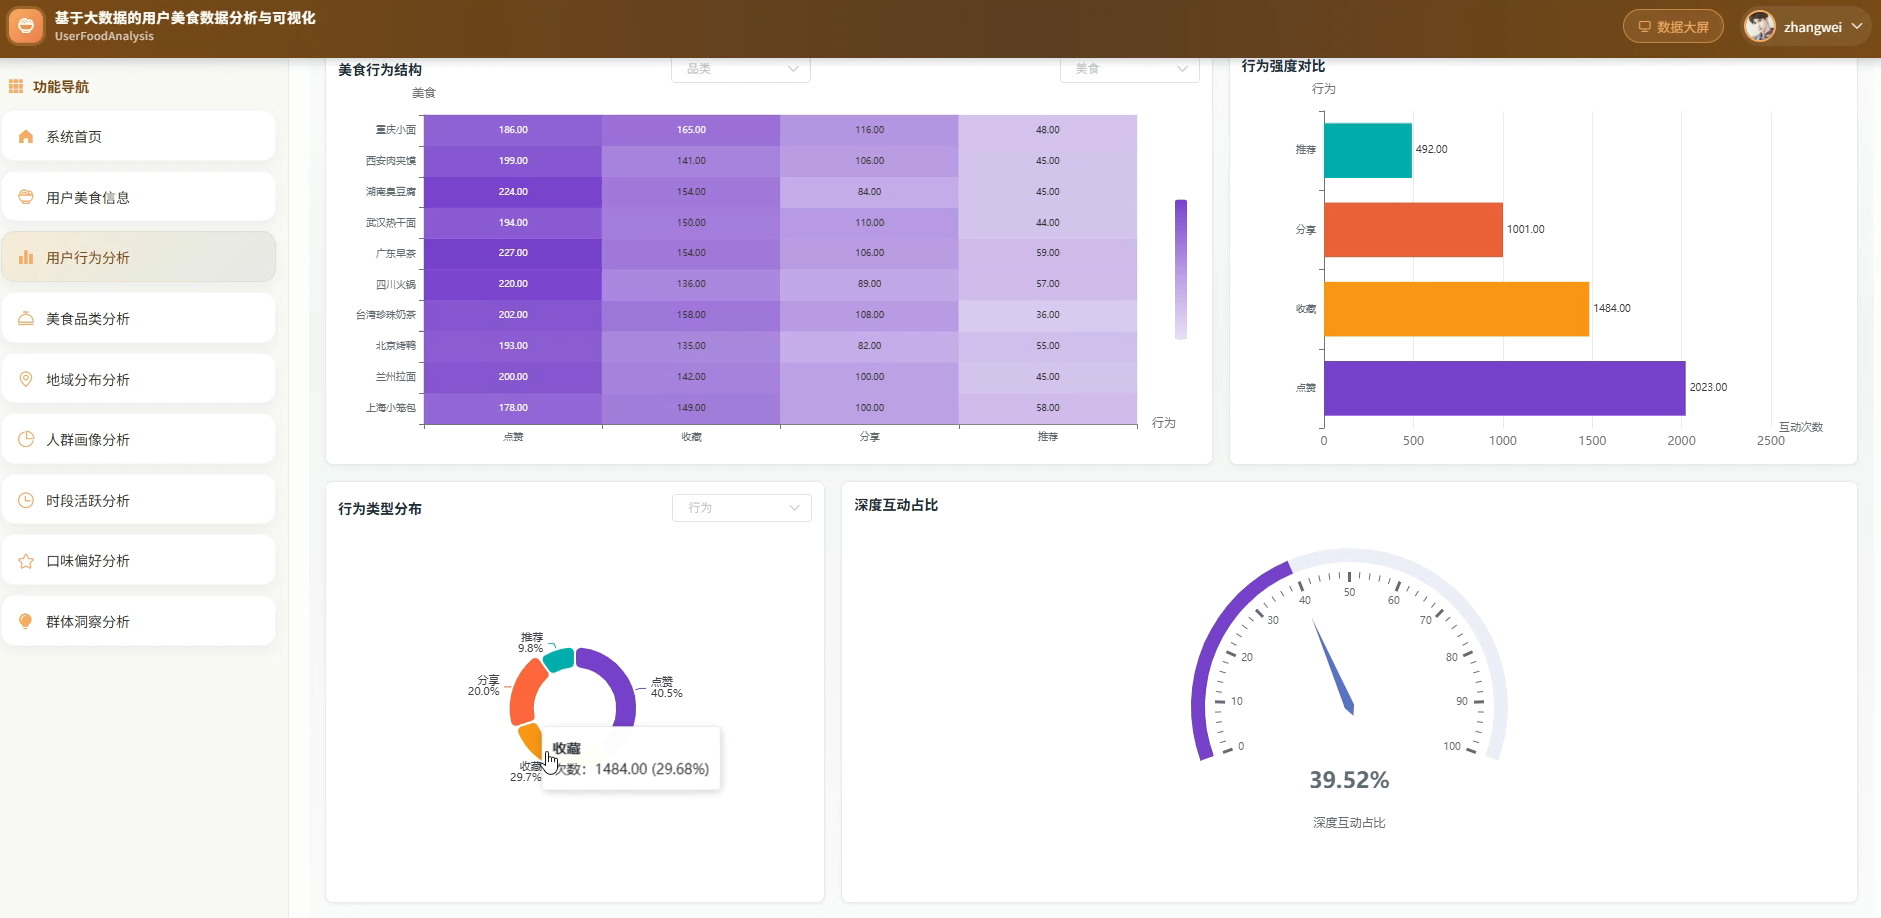
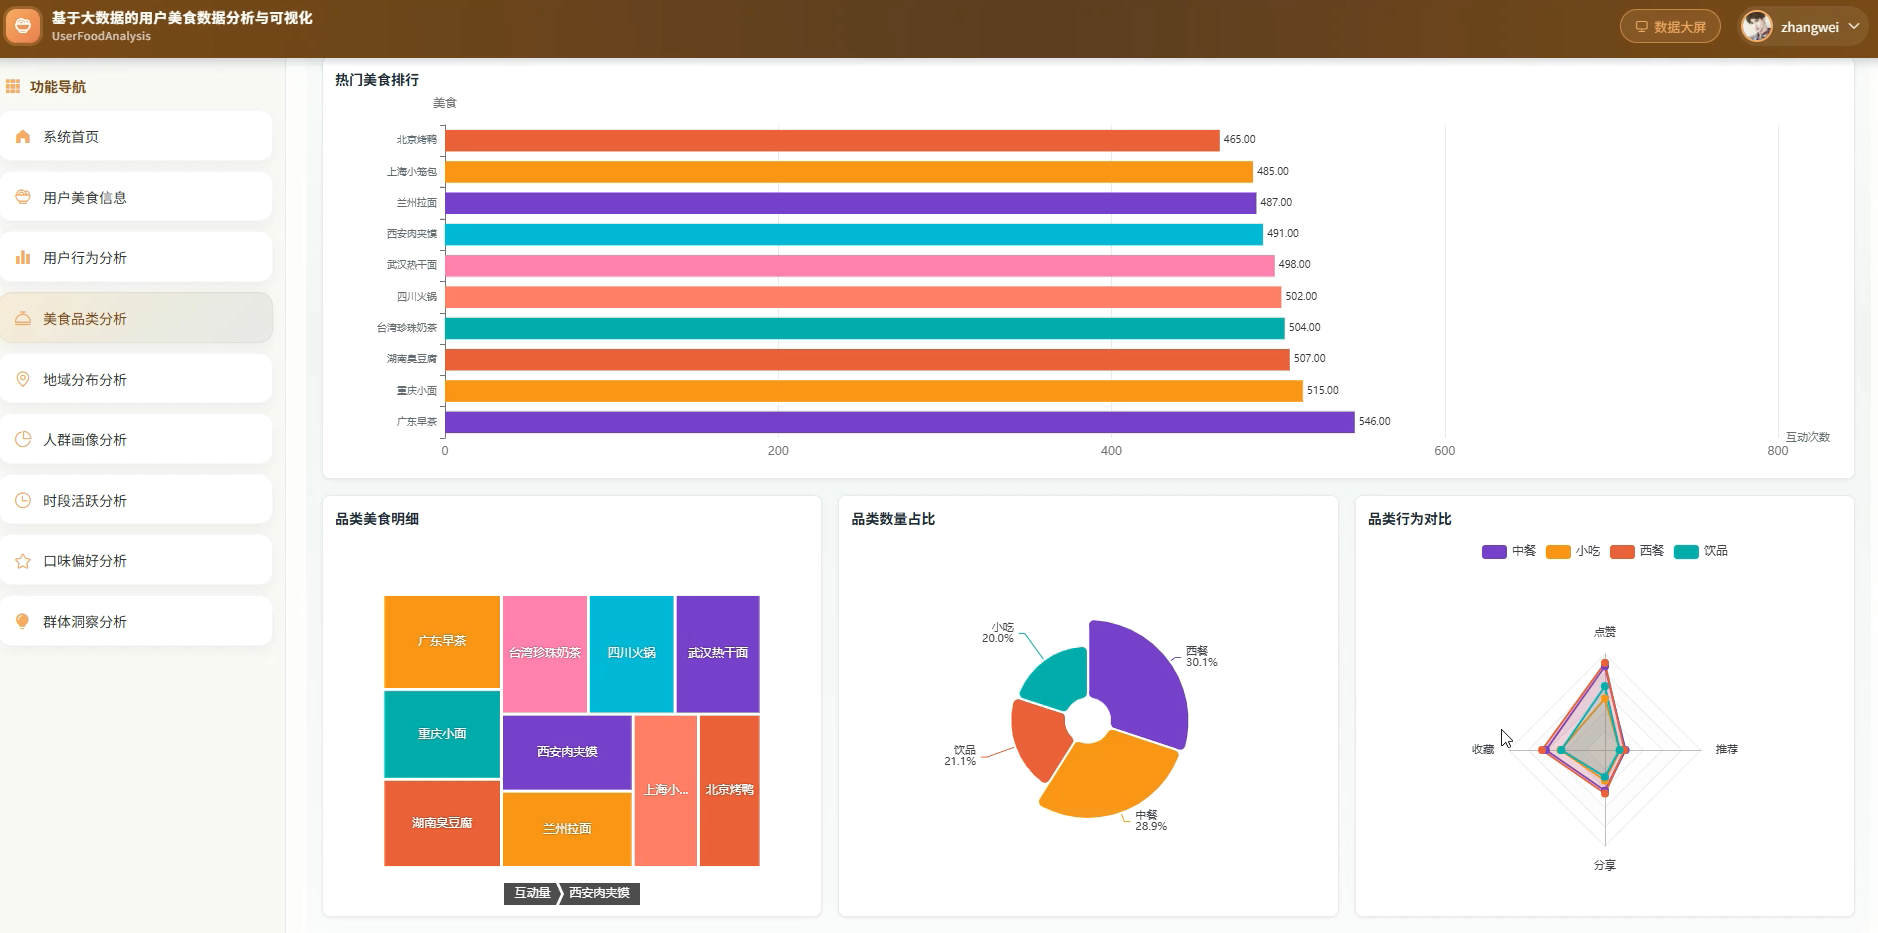
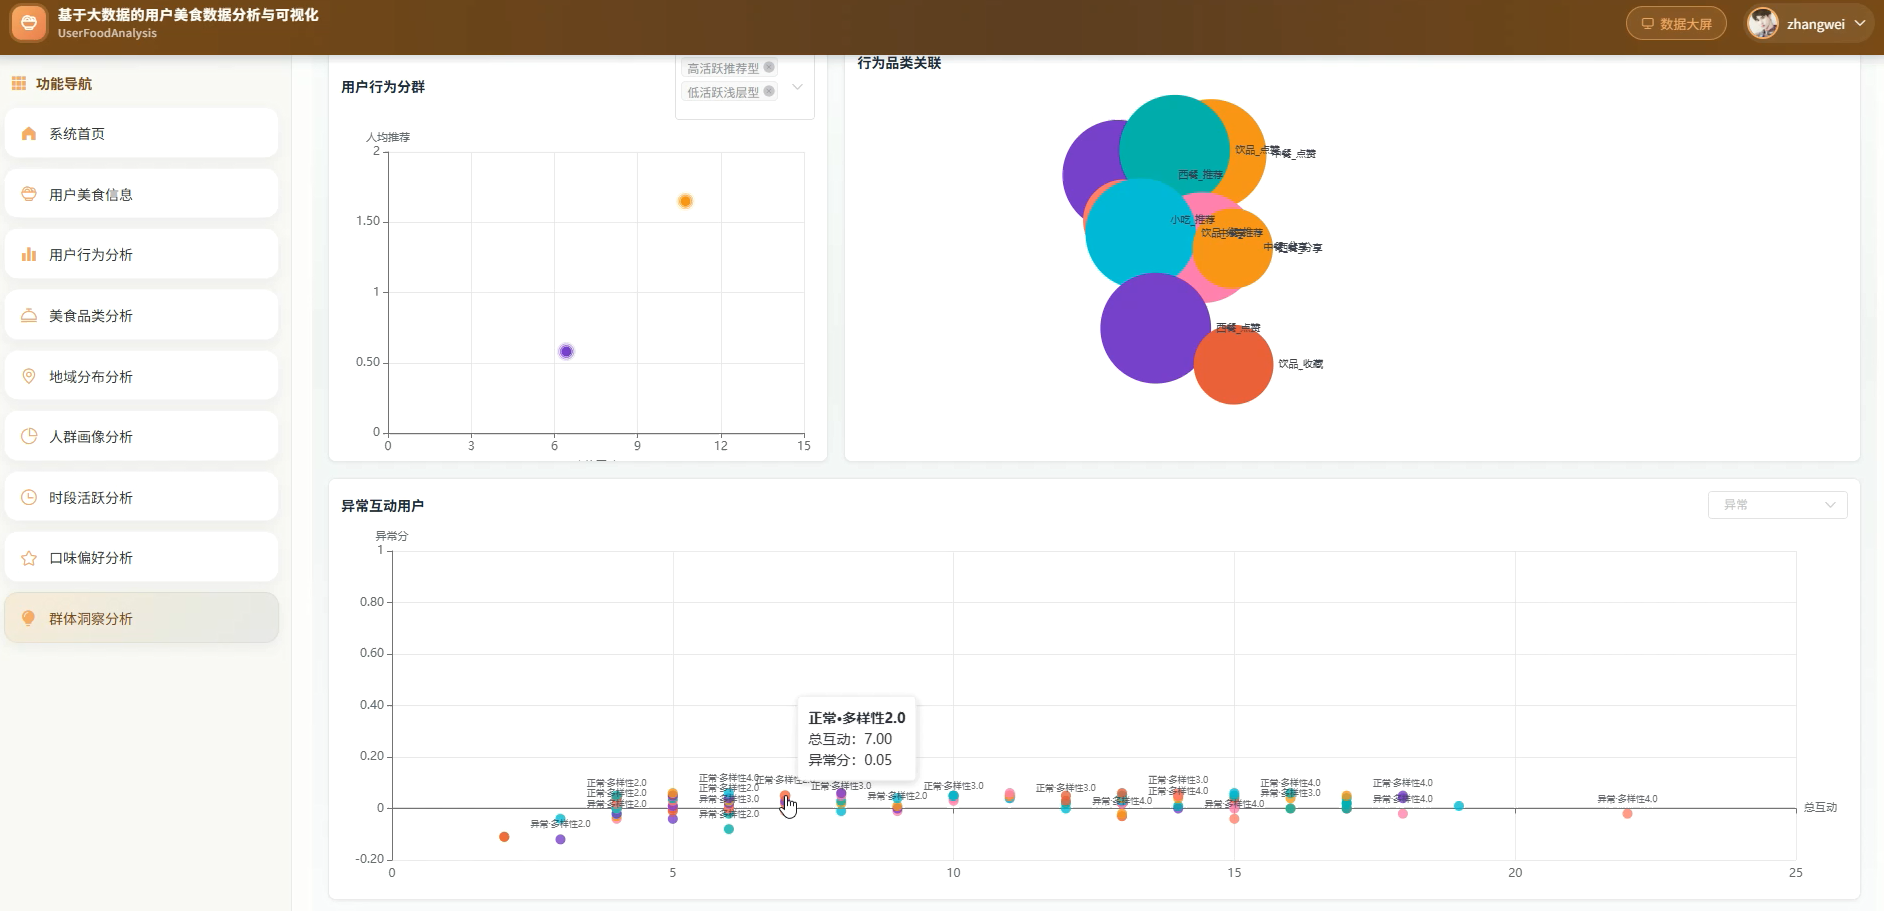
系统以Hadoop存储原始行为数据,PySpark完成清洗、派生与聚合计算,后端采用Flask提供API,前端Vue结合ECharts绘制可视化大屏。系统设计了用户行为、美食品类、地域分布、人群画像、时段活跃、口味偏好、群体洞察七个分析模块,群体洞察模块包含K-Means用户分群、FP-Growth行为品类关联挖掘和Isolation Forest异常互动检测三类算法,分析结果以图表与标签形式在前端展示。
经过系统测试,本系统能帮助餐饮运营者快速了解不同城市、年龄段、性别用户的互动偏好与口味差异,为内容推送、菜品优化和用户分层提供数据参考,对餐饮数据化运营有一定实用价值。
二、视频展示
计算机毕设选题做什么好?基于大数据的用户美食数据分析与可视化
三、开发环境
- 大数据技术:Hadoop、Spark、Hive
- 开发技术:Python、Django框架、Vue、Echarts
- 软件工具:Pycharm、DataGrip、Anaconda
- 可视化 工具 Echarts
四、系统展示
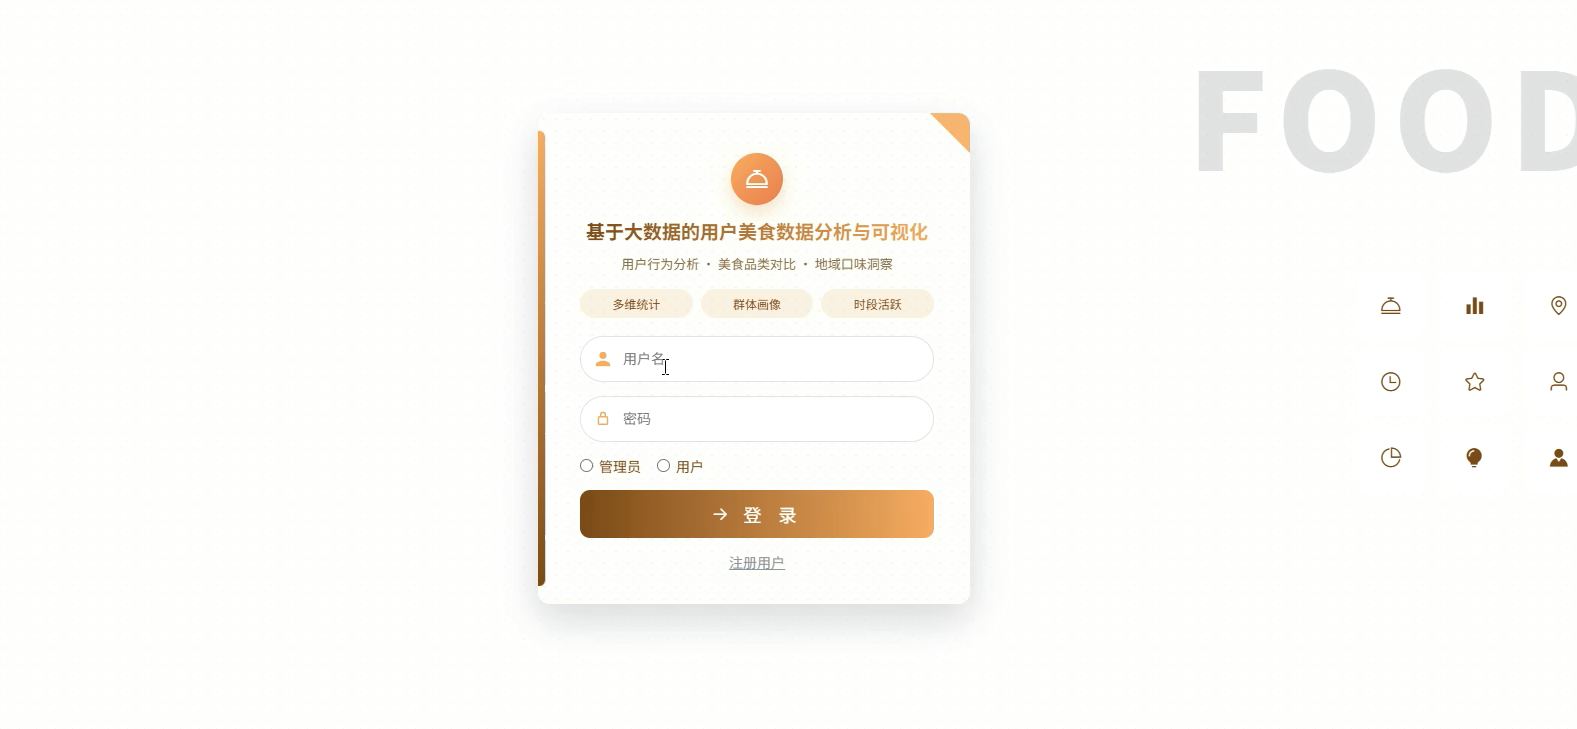
系统页面模块展示:
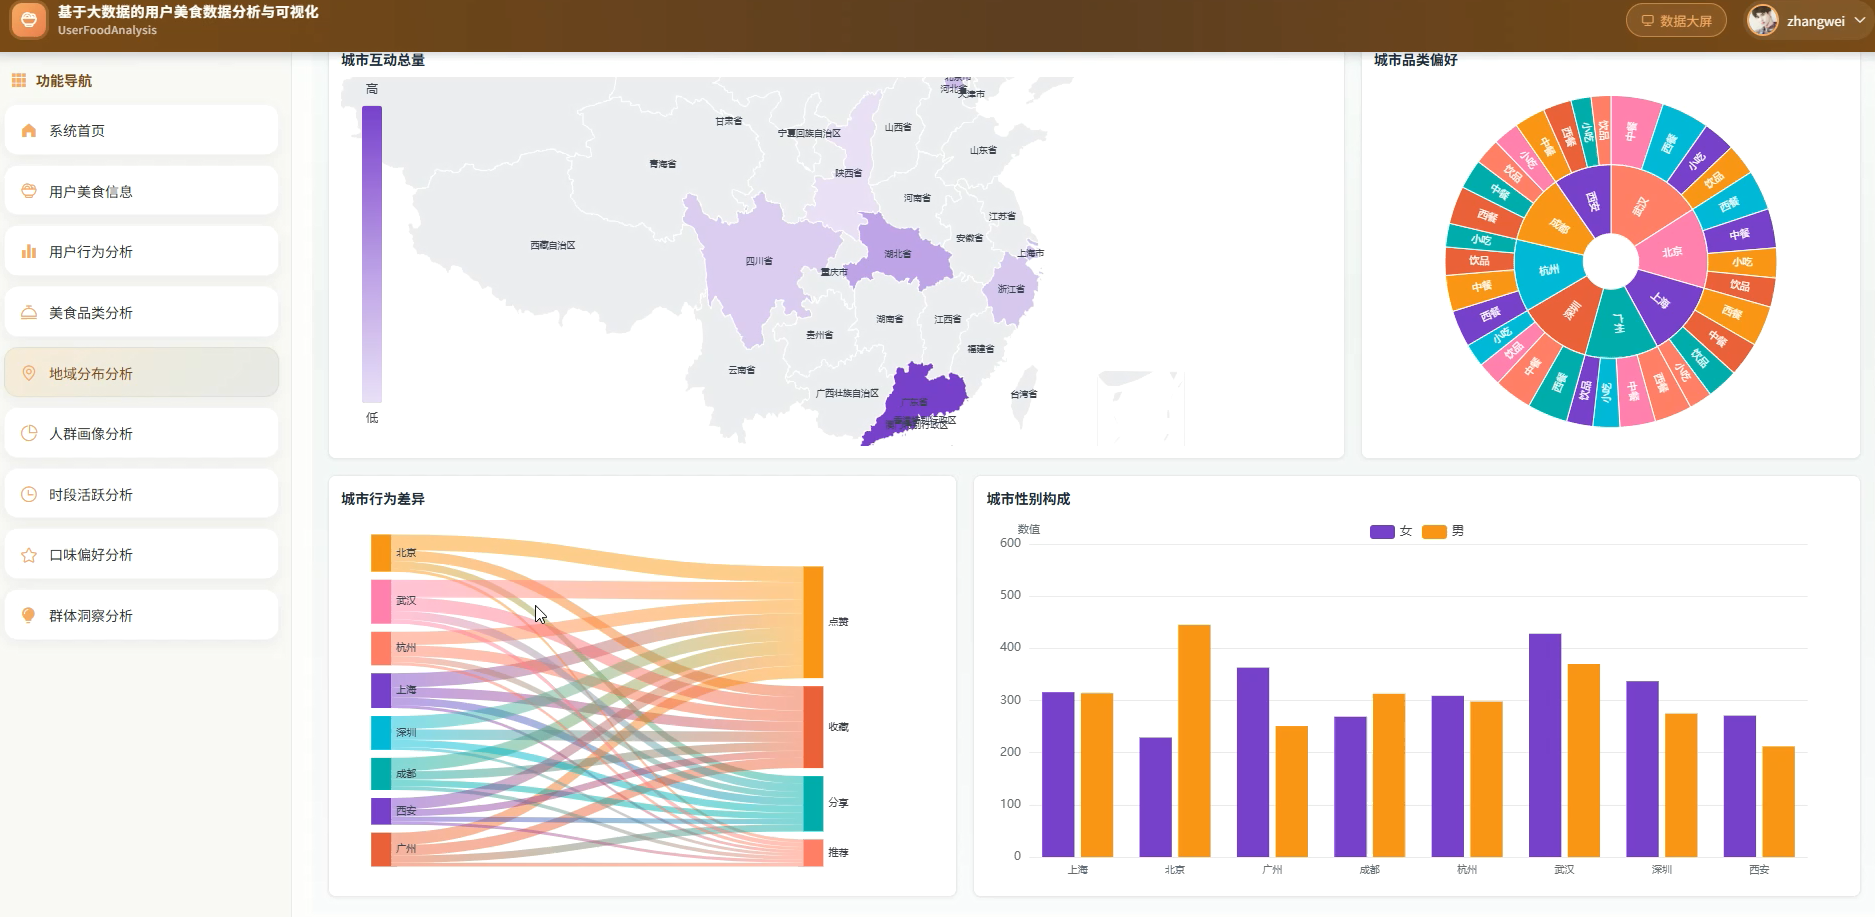
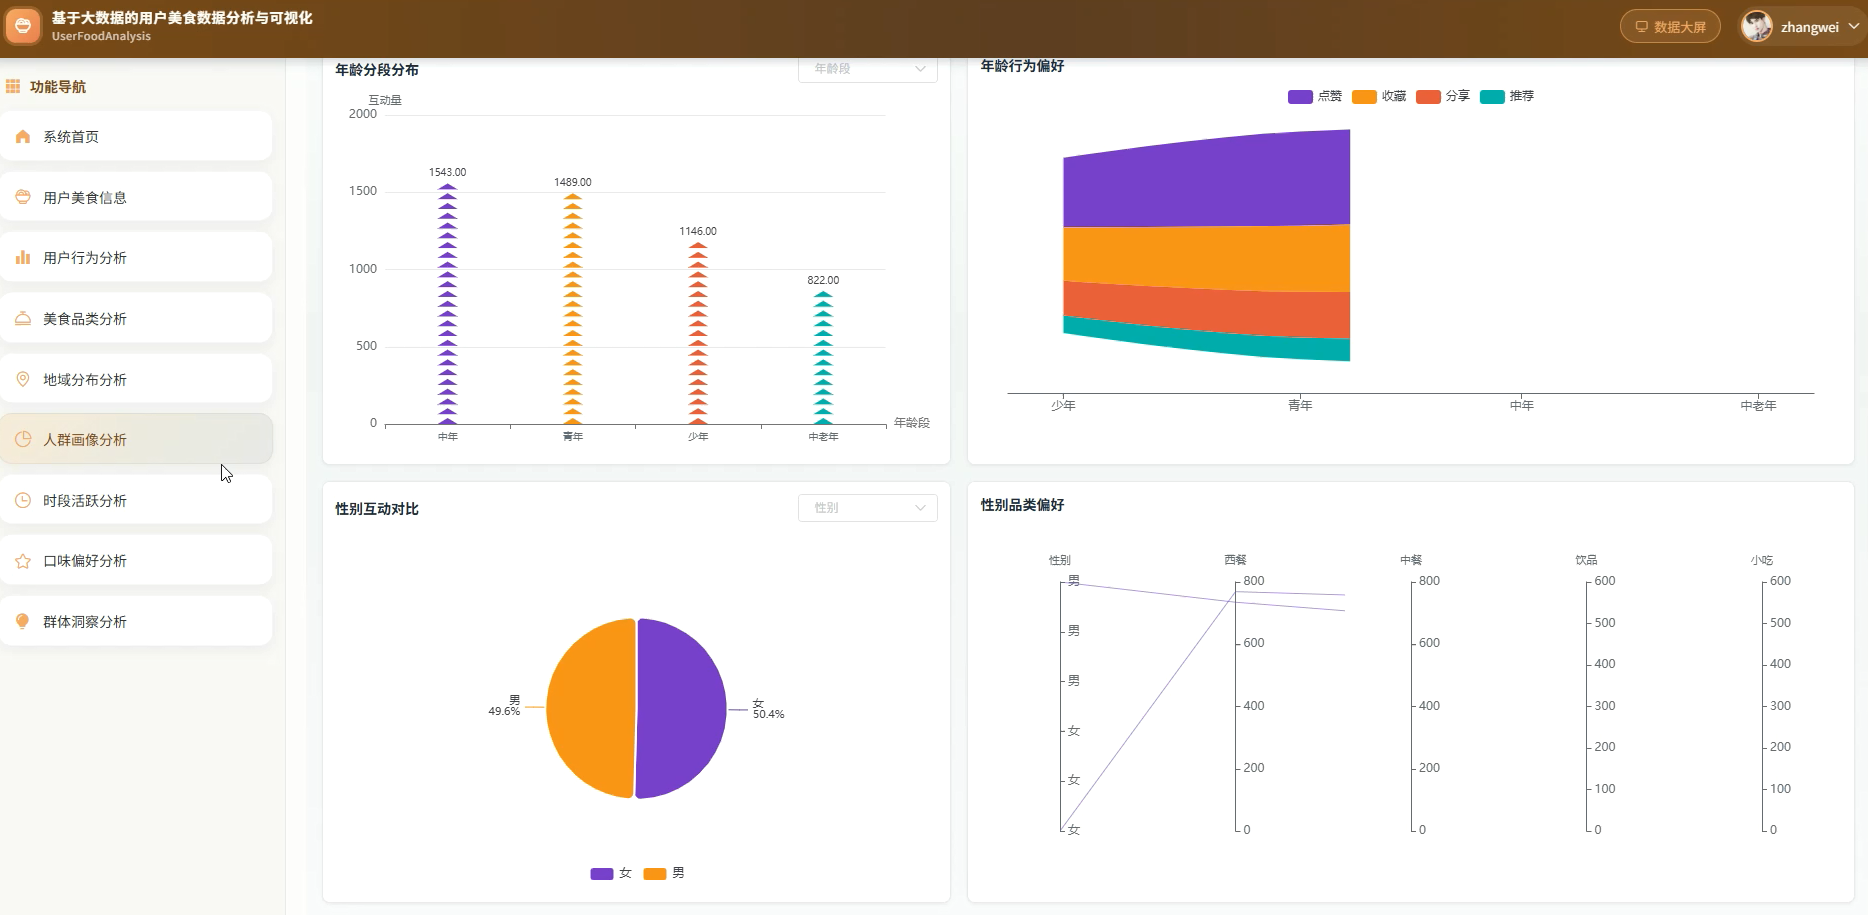
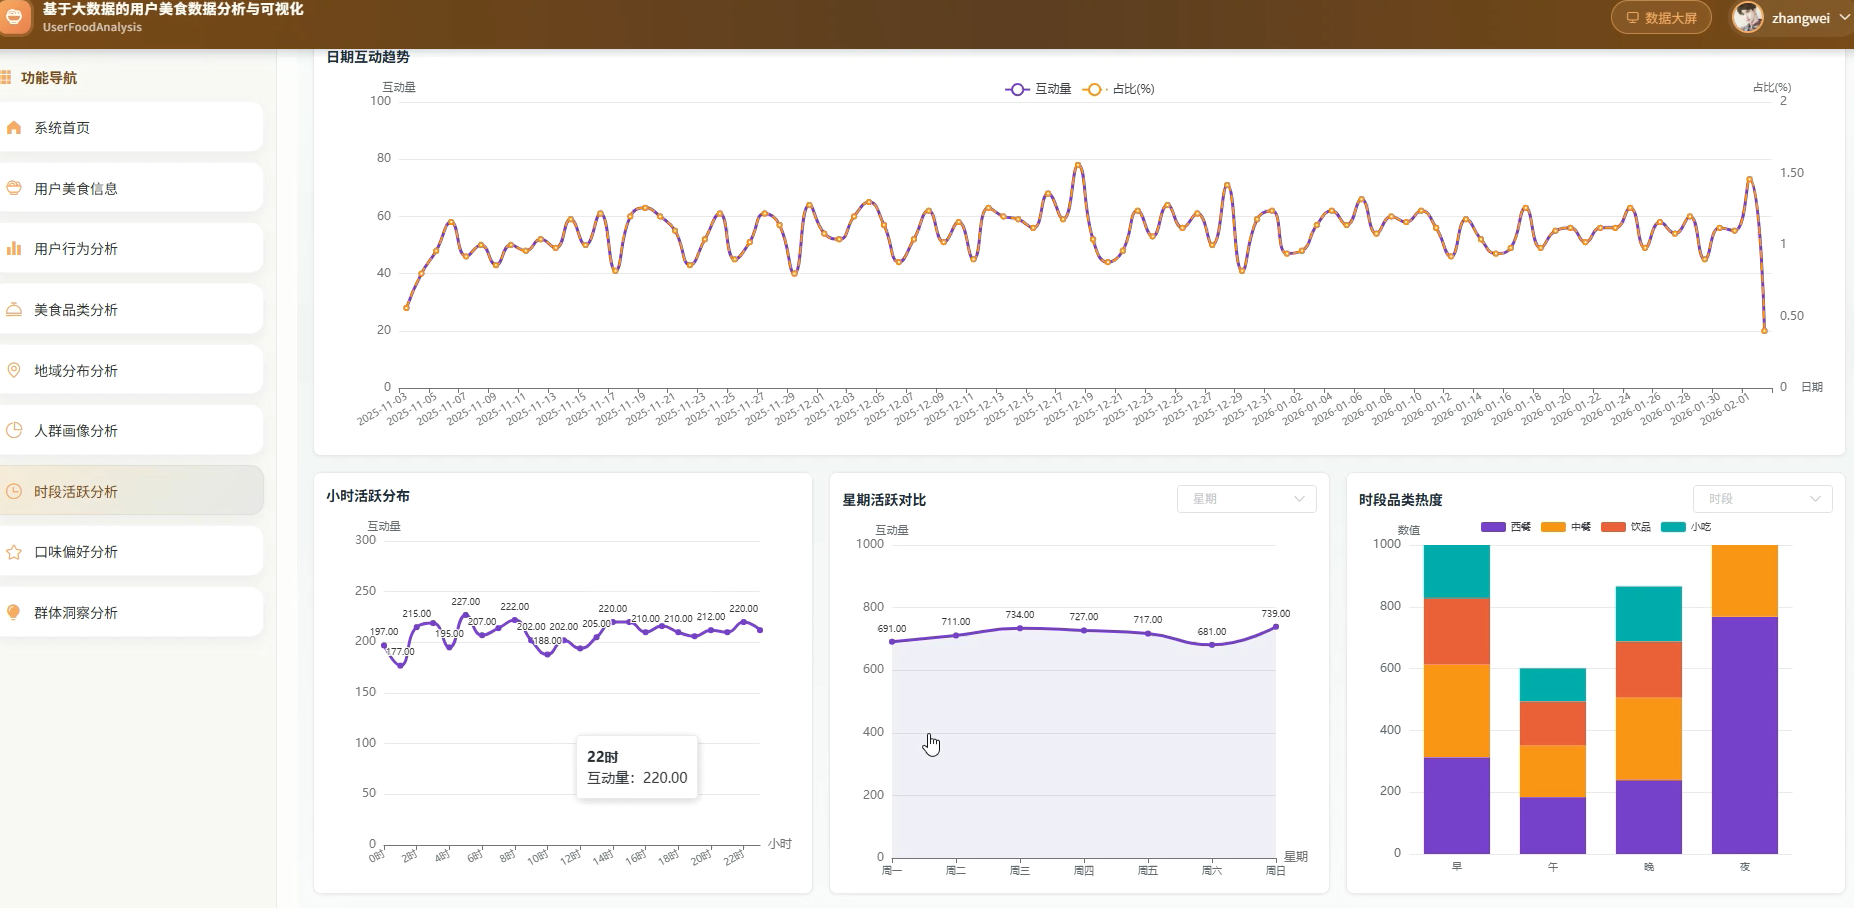
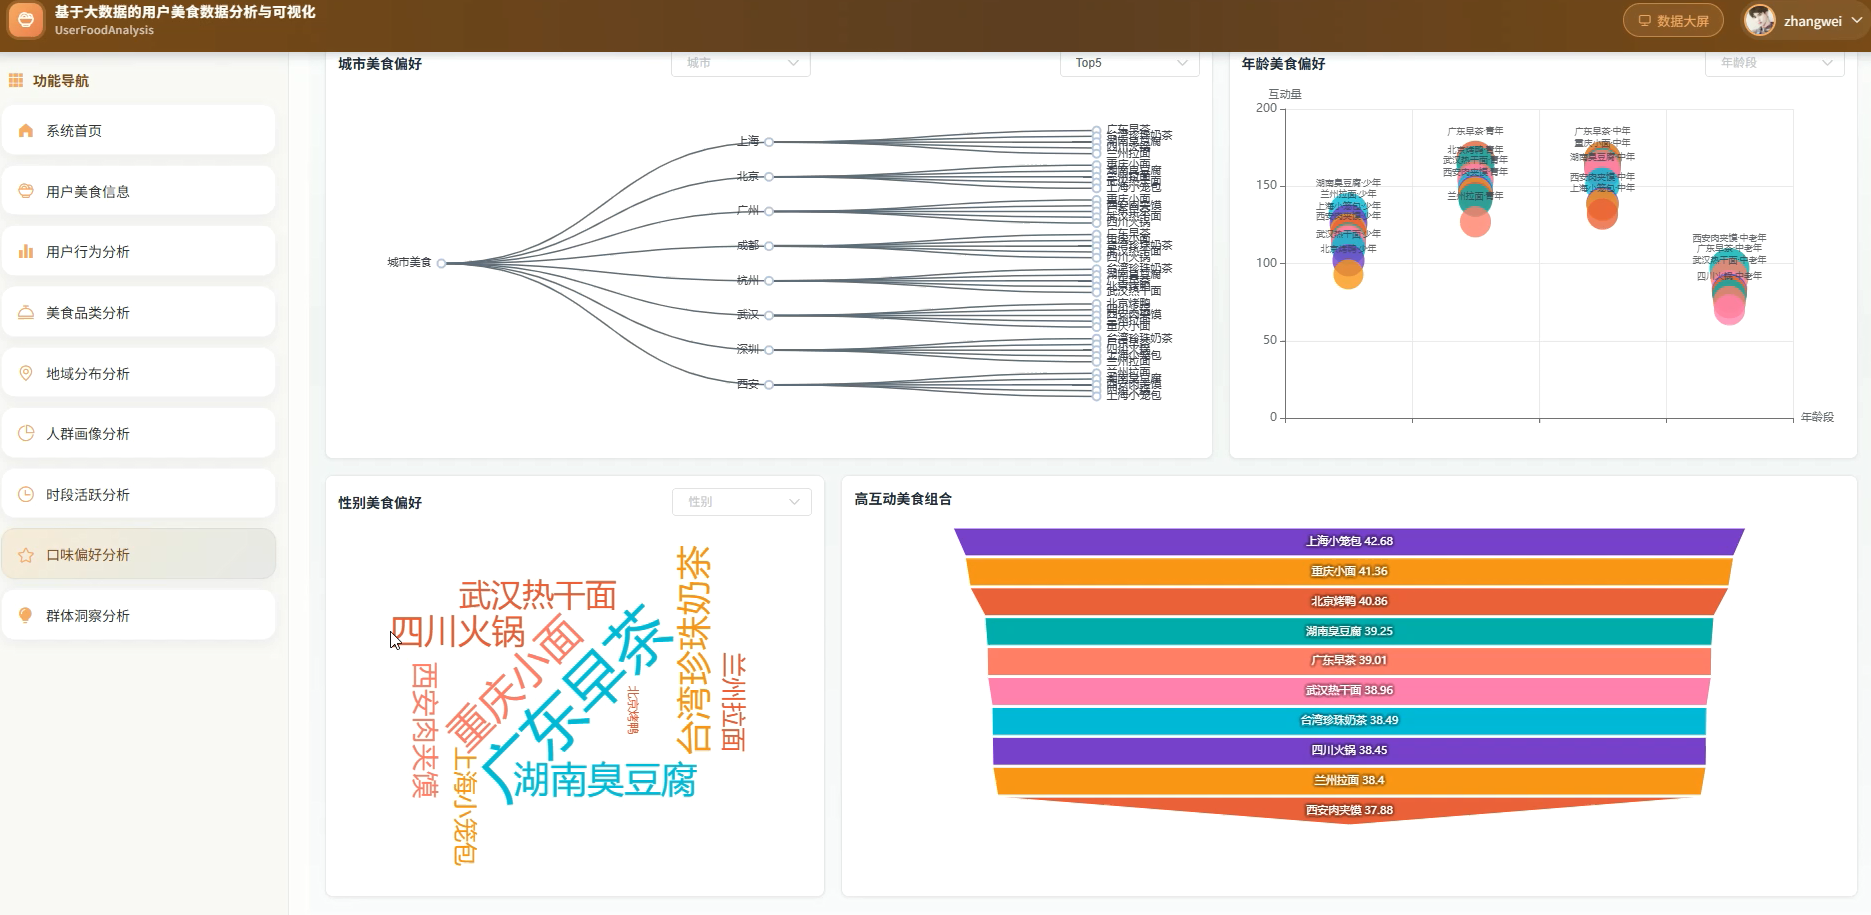
五、代码展示
bash
# preprocess.py
from pyspark.sql import SparkSession
from pyspark.sql.functions import (
    col, hour, dayofweek, date_format, when,
    count, sum as _sum, avg, max, min, round as _round
)
from pyspark.sql.types import IntegerType, FloatType
import os

spark = SparkSession.builder \
    .appName("FoodBehaviorPreprocess") \
    .config("spark.sql.adaptive.enabled", "true") \
    .getOrCreate()

# 读取原始数据
df = spark.read.csv(
    "dataset/美食_behavior_data_0202_1006.csv",
    header=True,
    encoding="utf-8-sig"
)

print(f"原始数据行数: {df.count()}")
df.printSchema()

# ---- 1. 时间字段解析与派生 ----
df = df.withColumn("hour", hour(col("behavior_time")))
df = df.withColumn("weekday", dayofweek(col("behavior_time")))
df = df.withColumn("date", date_format(col("behavior_time"), "yyyy-MM-dd"))

# 时段划分:早(6-10) / 午(10-14) / 晚(14-19) / 夜(19-6)
df = df.withColumn(
    "period",
    when((col("hour") >= 6) & (col("hour") < 10), "早")
    .when((col("hour") >= 10) & (col("hour") < 14), "午")
    .when((col("hour") >= 14) & (col("hour") < 19), "晚")
    .otherwise("夜")
)

# ---- 2. 年龄分箱 ----
df = df.withColumn(
    "age_group",
    when(col("user_age") <= 22, "16-22")
    .when(col("user_age") <= 30, "23-30")
    .when(col("user_age") <= 40, "31-40")
    .otherwise("41+")
)

# ---- 3. 派生行为权重(用于后续加权计算) ----
action_weight = {
    "点赞": 1.0,
    "分享": 1.5,
    "收藏": 2.0,
    "推荐": 3.0
}

for action, weight in action_weight.items():
    df = df.withColumn(
        f"weight_{action}",
        when(col("action") == action, weight).otherwise(0.0)
    )

df = df.withColumn("behavior_weight",
    col("weight_点赞") + col("weight_分享") +
    col("weight_收藏") + col("weight_推荐")
)

# ---- 4. 派生深度互动标识 ----
df = df.withColumn(
    "is_deep_action",
    when((col("action") == "收藏") | (col("action") == "推荐"), 1).otherwise(0)
)

# ---- 5. 数据质量校验 ----
print("缺失值统计:")
for field in df.columns:
    null_count = df.filter(col(field).isNull()).count()
    print(f"  {field}: {null_count}")

# 年龄范围校验
age_stats = df.select(
    min("user_age").alias("min_age"),
    max("user_age").alias("max_age"),
    avg("user_age").alias("avg_age")
).collect()[0]
print(f"年龄范围: {age_stats['min_age']} - {age_stats['max_age']}, 均值: {age_stats['avg_age']:.1f}")

# ---- 6. 写入预处理结果 ----
output_path = "output/food_behavior_preprocessed_data.csv"
df.coalesce(1).write.csv(output_path, header=True, mode="overwrite")

print(f"预处理完成,数据已写入: {output_path}")
spark.stop()
六、项目文档展示

七、项目总结
本课题围绕餐饮行为数据的多维度分析与可视化展开,以5000条真实用户互动记录为基础,构建了覆盖用户行为、美食品类、地域分布、人群画像、时段活跃、口味偏好及群体洞察七个分析维度的可视化系统。技术实现上,采用PySpark完成数据清洗、时间特征派生与聚合统计,通过HDFS进行原始数据存储,后端Flask提供API接口,前端Vue配合ECharts绘制大屏图表。算法层面,群体洞察模块集成了K-Means用户行为分群,依据互动深度与品类偏好将用户划分为高深度互动型、高频推荐型等画像群体;FP-Growth挖掘品类与行为之间的关联规则,揭示中餐加收藏与小吃加点赞等交叉运营机会;Isolation Forest对用户的多维行为特征进行异常检测,自动标定互动结构偏离常规的用户。系统同时支持管理端与用户端双角色,两端图表展示与数据查询功能一致,仅后台权限做隔离。测试结果表明,本系统能够帮助运营者快速定位不同城市、年龄段、性别用户的互动偏好与口味差异,为菜品优化、内容推送和用户分层运营提供数据支撑,对餐饮数据化决策具有一定实用价值。
大家可以帮忙点赞、收藏、关注、评论啦 👇🏻
💖🔥作者主页 :计算机毕设木哥🔥 💖