如果把时间拨回 2023 年,大模型市场其实很好理解。
ChatGPT 几乎就是 AI 的代名词。
到了 2026 年,事情已经完全不同。
OpenAI 有 GPT-6 Astra,Anthropic 有 Claude Fable 5.1,Google 把 Gemini 推进到 3.8,Grok 开始猛烈进攻 Coding 和 Agent;与此同时,中国出现了 Kimi K3、GLM-5.3、Qwen3.8、DeepSeek V4、MiniMax M3、Seed2.1 等一批已经能够直接参加全球竞争的模型。
今天真正的问题已经不再是:
"哪个 AI 最聪明?"
而是:
"你到底需要一个研究员、程序员、数字员工,还是一个便宜到可以调用一亿次的基础设施?"
这是理解 2026 年 AI 格局最重要的一件事。
一张表看懂目前最有代表性的模型
以下不是单纯 Benchmark 排名,而是我结合推理、Coding、Agent、多模态、长上下文、速度和实际产品能力给它们做的定位。由于 2026 年 9 月刚好有多款新模型发布,第三方排行榜数据仍在持续更新,因此这里更强调能力特征,而不是争论相差一两分的榜单成绩。
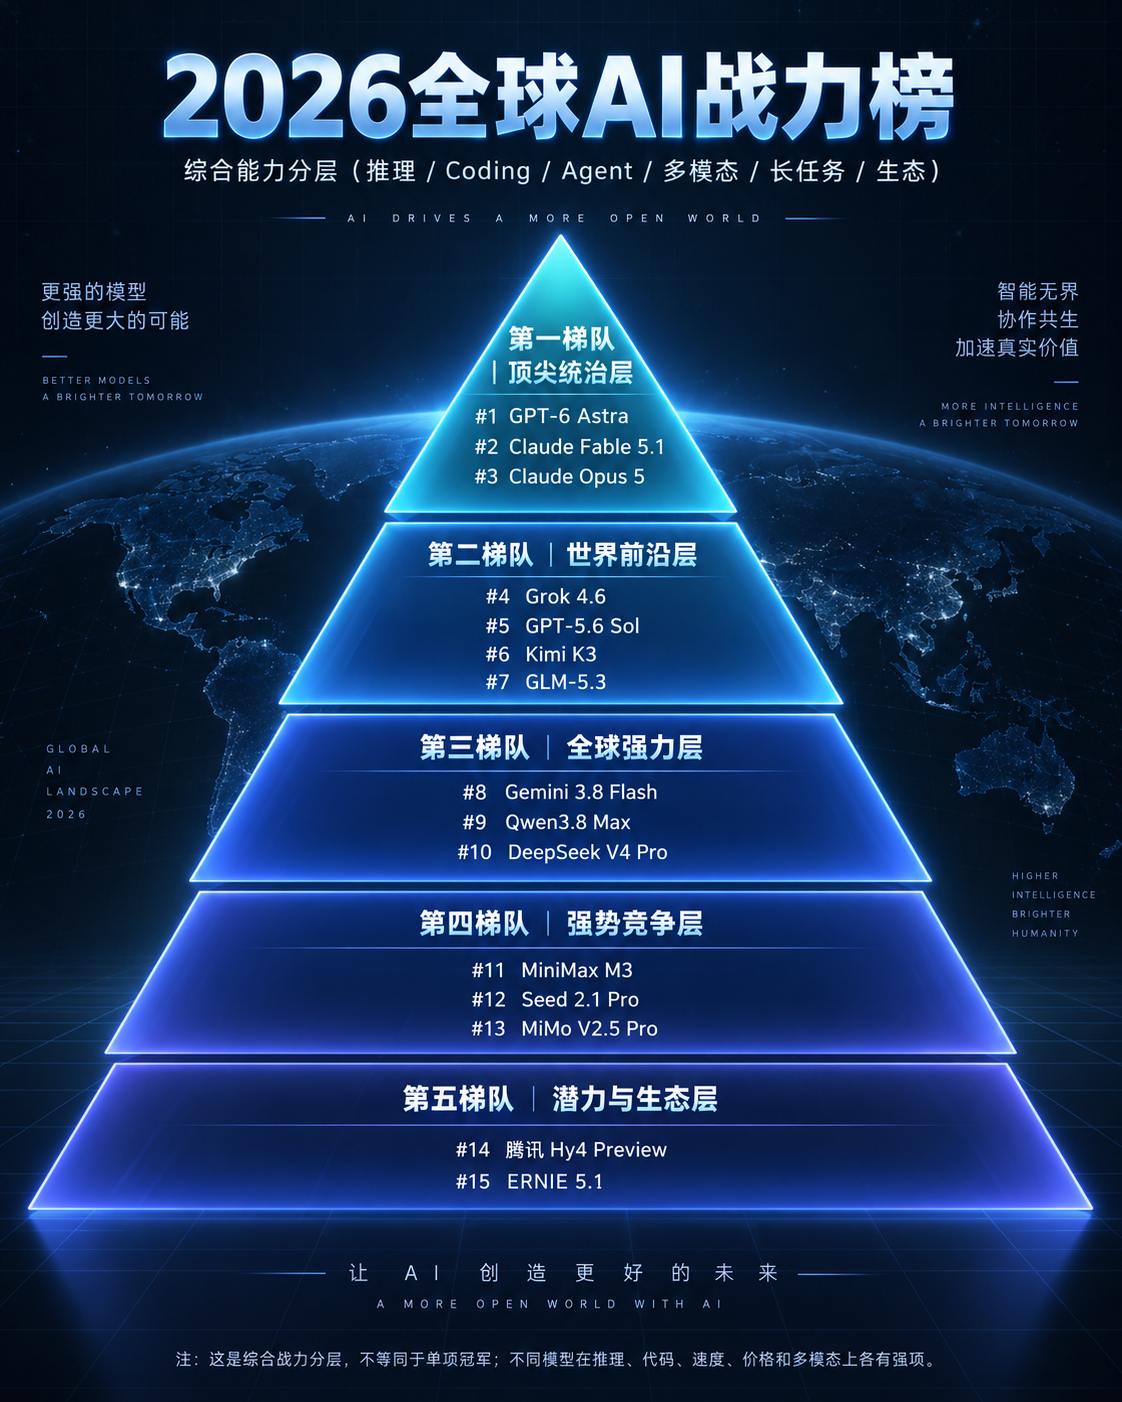
| 模型 | 最突出的能力 | 更像什么 | 主要短板 |
|---|---|---|---|
| GPT-6 Astra | Agent、电脑操作、复杂工作流 | 超级数字员工 | 成本高、刚发布 |
| Claude Fable 5.1 | 深度推理、科研、复杂 Coding | 超级研究员 | 贵,深度模式等待时间长 |
| Grok 4.6 | Coding、长程 Agent | 激进型高级工程师 | 综合生态不如 OpenAI/Google |
| Gemini 3.8 Flash | 极高速度、多模态、Agent | 超高速全能执行者 | 极难推理并非始终第一 |
| Kimi K3 | 深度研究、长上下文、开放权重 | 研究型专家 | 慢 |
| GLM-5.3 | Coding、Agent、开放权重 | AI 软件工程师 | 原生多模态相对弱 |
| Qwen3.8 Max | 全面、多模态、开发生态 | AI 全栈平台 | 单项不一定第一 |
| DeepSeek V4 Pro | Coding、推理、Agent、效率 | 高性价比工程师 | 多模态不是核心优势 |
| MiniMax M3 | 多模态 + Agent + Coding | 开放式多模态 Agent | 推理上限略弱于顶级闭源 |
| Seed2.1 Pro | 真实办公、多模态、工具执行 | 生产力助手 | 全球开发者生态仍在扩张 |
GPT-6 Astra:AI 开始从"回答问题"变成"完成工作"
2026 年 9 月 3 日,OpenAI 发布 GPT-6 Astra。
如果只是看"它又比上一代 Benchmark 高多少",其实会错过 Astra 最重要的变化。
OpenAI 对 Astra 的核心定位是:
end-to-end work。
它针对的已经不是"一问一答",而是整个任务链:
研究资料
→ 打开网页
→ 调用工具
→ 操作电脑
→ 写代码
→ 修改文件
→ 创建表格
→ 制作演示文稿
→ 检查结果
→ 根据用户新的要求继续调整。
OpenAI 官方把 Astra 定位为目前最强的复杂推理、Coding、Computer Use、Research 和文档创作模型,API 上下文达到约 105 万 Token,并支持多档 reasoning effort。(OpenAI)
这其实代表了 OpenAI 对下一阶段 AI 的判断:
模型的终点不是更好的聊天机器人,而是能独立完成任务的数字劳动者。
所以如果让我评价 Astra,我不会说它只是"智商第一"。
更准确的说法是:
它可能是目前综合行动能力最完整的 AI 之一。
这也是为什么未来"Agent 能力"很可能比传统考试 Benchmark 更重要。
Claude Fable 5.1:如果你只问"谁最会思考",Claude 依然恐怖
Anthropic 在 9 月 1 日推出了 Claude Fable 5.1。
Claude 的路线与 OpenAI 有一点明显区别。
如果说 GPT-6 Astra 越来越像:
一个能够调用各种软件完成任务的员工,
那么 Claude 越来越像:
一个坐在办公室里连续思考几个小时的顶级研究员。
Anthropic 将 Fable 5.1 定位为其最先进的 Coding 和 Knowledge Work 模型,并特别强调科研能力。(Anthropic)
Artificial Analysis 的最新测试中,Fable 5.1 的最高推理配置处于全球最前沿,1M 上下文,而且尤其擅长复杂知识工作和推理任务。(人工分析)
Claude 有一种很特别的优势:
复杂任务做得越久,它的价值越明显。
例如:
研究一家上市公司十年的变化;
阅读几十份合同;
理解一个几十万行代码的项目;
设计一个复杂系统架构;
分析科研论文并寻找其中的逻辑漏洞。
这些任务不是要求 AI "瞬间回答"。
而是要求:
别忘记目标,别中途跑偏,能持续思考。
Claude 在这类工作上的口碑一直很强。
它的问题也很明显:
高档 reasoning 很贵,而且有时你会等很久。
所以 Fable 很像一辆 F1 赛车。
性能很强,但你不会拿它每天去楼下买菜。
Grok 4.6:曾经是"会玩梗的 AI",现在却开始变成顶级程序员
Grok 是这两年变化最大的模型之一。
早期 Grok 最大的标签还是:
X、实时信息、表达风格大胆。
到了 Grok 4.6,SpaceXAI 明显把重点转向:
Coding + 长程 Agent + Knowledge Work。
官方明确表示 4.6 针对长时间运行的 Agent、代码库工作、研究和复杂交互任务进行了强化,并提供 500K 上下文以及多档推理强度。(X.ai)
这也是为什么你现在打开 Cursor,会直接看到:
Cursor Grok 4.6。
它已经进入 GitHub Copilot、Cursor 等真正的程序开发环境。(X.ai)
Grok 现在最让我看重的不是聊天能力,而是:
它愿意连续干活。
让它:
理解项目
→ 找 Bug
→ 改十几个文件
→ 跑测试
→ 继续修
→ 再检查
这种任务很适合它。
因此如果你的核心使用场景就是 Cursor,我甚至不会完全按照全球综合排名选模型。
在 Coding Agent 场景中,Grok 4.6 可以直接进入世界最强的一档。
Gemini 3.8 Flash:名字叫 Flash,但已经不能把它理解成"小模型"
Google 今年最值得关注的模型可能不是一个叫"Ultra"的庞然大物。
而是:
Gemini 3.8 Flash。
Google 在 9 月 2 日发布它时,把它称为目前最聪明的 workhorse model,并重点提升软件工程、Agent 和多步骤推理。(blog.google)
更夸张的是它的输入能力。
Gemini 可以同时处理:
文本、图片、音频、视频。
上下文达到约 1M。
第三方测试还显示它拥有极高的 Token 输出速度;具体实时数字会随着服务端和评测更新而变化,但它明显处于目前旗舰模型中的高速阵营。(人工分析)
所以 Gemini 3.8 Flash 最可怕的并不是:
"每一道数学题都是世界第一。"
而是:
已经拥有接近旗舰的智能,同时跑得像一个高速模型。
这对于真正部署 AI 的企业非常关键。
因为用户不会只调用一次模型。
未来一个 Agent 为了完成任务,可能需要调用模型:
50 次、100 次甚至几百次。
当 Agent 时代到来之后:
速度本身就是智能的一部分。
Kimi K3:中国模型第一次真正站到开放权重智能前沿
如果只看 2026 年中国模型,我非常看重 Kimi K3。
原因不是因为"Kimi 在国内很火"。
而是 K3 已经进入世界顶级开放权重模型的竞争区间。
Artificial Analysis 最新数据显示,Kimi K3 Max 在其开放权重模型样本中位于最前沿,并提供约 1M Token 上下文以及图像输入。(人工分析)
Kimi 的产品基因其实非常明显。
从早期超长文本开始,它一直特别擅长:
读很多东西以后再回答问题。
所以 Kimi 非常适合:
投资研究、行业研究、论文研究、大型资料整理、长文档分析。
它不像一个追求最快响应的模型。
更像一个:
"资料都给我,我读完以后再告诉你结论。"
因此,如果让我选择一个国产模型专门帮我做 Deep Research,Kimi 会排得非常靠前。
GLM-5.3:中国 Coding Agent 领域最容易被低估的选手
很多普通用户对智谱的印象可能还停留在几年前的 ChatGLM。
但现在的 GLM 已经完全不是一个层级。
GLM-5.3 在 Artificial Analysis 当前开放权重模型测试中紧随 Kimi K3,同时输出速度明显更快,并提供 1M 上下文。(人工分析)
它的路线非常明确:
Coding + Engineering + Agent。
也就是说,它不是特别想成为:
"最会陪你聊天的 AI。"
它更想成为:
能够真正进入开发环境工作的模型。
这一点在未来会非常重要。
因为 Coding 可能是 Agent 最早真正产生巨大经济价值的行业。
程序开发本身高度数字化:
AI 可以读取文件,可以运行命令,可以检查测试,可以看到错误,可以修改代码。
相比于让机器人去现实世界拧螺丝:
AI 接管一部分软件工程工作的门槛低得多。
所以 GLM 的路线是很聪明的。
Qwen3.8 Max:阿里真正厉害的不是一个模型,而是一整套 AI 基础设施
如果让我挑一个最难简单评价的模型,那可能是 Qwen。
因为单独看 Qwen3.8 Max:
很强,但不一定每一个榜单都第一。
可是当你把整个 Qwen 生态摆出来,就完全不一样了。
Qwen3.8 Max 最新 0902 版本强化了大型软件工程、长时间自主开发、多工具协作、图表理解、文档解析和视觉能力,同时维持 1M 上下文。(AlibabaCloud)
阿里的真正优势是:
一个开发者几乎可以围绕 Qwen 搭完整套 AI 产品。
需要旗舰模型,有 Max。
需要高速模型,有 Flash。
需要开源部署,有开放权重版本。
需要图片、视频、语音,又有对应模型体系。
所以 Qwen 更像:
AI 时代的操作系统级基础设施。
如果我是个人用户,我不一定每天首先打开 Qwen。
但如果我是一个要做 AI 产品的公司:
Qwen 一定是必须认真评估的技术栈。
DeepSeek V4 Pro:它不需要永远世界第一,仍然可能改变整个市场
DeepSeek 最重要的贡献,可能并不是某一天 Benchmark 第一。
它真正改变的是:
大家对"顶级智能应该卖多少钱"的预期。
DeepSeek V4 Pro 正式版在 2026 年 8 月上线,重点提升了 Agent 和 Coding,并支持 low、high、max 三档推理强度;官方公布的 Terminal Bench 2.1 成绩达到 87.9。(DeepSeek API Docs)
更重要的是,它仍然维持了 DeepSeek 一贯的路线:
强能力 + 开放 + 低成本。
第三方数据显示 V4 Pro 0813 Max 拥有约 1M 上下文,而且推理成本远低于很多闭源旗舰。(人工分析)
这意味着一个很现实的问题:
假设 Fable 能把任务完成到 95 分。
DeepSeek只能做到 90 分。
单次任务你可能选择 Fable。
但是如果企业每天要跑:
1000 万次任务呢?
这时候成本差异可能比那 5 分能力差距更加重要。
所以大模型行业真正的战争绝对不会只有"智商榜"。
还有:
单位智能成本。
而 DeepSeek 仍然是这个方向最危险的竞争者之一。
MiniMax M3:开放模型正在补上多模态和 Computer Use
过去开放权重模型往往有一个问题:
文字和代码不错,但真正涉及图片、视频、GUI、电脑操作,就需要另外一套系统。
MiniMax M3 想解决的就是这个问题。
它把:
Coding、Agent、1M Context、图片、视频以及 Desktop Computer Use
整合进一个开放权重模型。(MiniMax)
这件事的重要性其实很高。
因为未来 Agent 不可能永远只活在命令行里。
真正的数字员工需要:
看到页面
理解页面
点击按钮
填写表格
阅读图表
处理视频
操作软件。
MiniMax 的方向,就是让开放模型逐渐拥有这些能力。
Seed2.1:字节真正关注的是"用户最后有没有把事情做完"
字节跳动的 Seed 路线和很多研究公司不同。
它很强调:
Real-world Productivity。
Seed2.1 官方甚至明确表示,相比只关注静态 Benchmark,他们更加关注模型在真实工作流中的表现。
其升级重点包括项目规划、文件处理、跨工具任务、企业级 Coding、多模态理解等能力,并已经进入豆包、TRAE 和火山引擎。(字节跳动种子)
这其实特别符合字节的产品文化。
不是:
"论文里模型有多强?"
而是:
"普通用户点击这个按钮以后,到底能不能成功?"
很多 AI 公司最终真正拉开差距的,可能恰恰就是这最后 10%。
2026 年真正发生的变化:模型正在开始"分职业"
现在再说:
"哪个大模型最好?"
其实越来越像在问:
"医生、律师、程序员、研究员,哪个职业最好?"
这个问题本身已经不完整了。
如果我要研究一个极难的问题,我可能会选择 Claude Fable。
如果我要一个 AI 真的控制电脑完成整个任务,我会重点看 GPT-6 Astra。
如果我要在 Cursor 里连续改一个大型代码库,Grok 4.6、Claude、GPT 和 GLM 都值得比较。
如果我要处理视频、音频、图片和百万 Token 内容,Gemini 的吸引力非常强。
如果我要国产开放模型做 Deep Research,Kimi K3 很突出。
如果我要构建自己的 AI 产品,Qwen 的整个生态极有价值。
如果每天要调用数百万甚至数亿次模型,DeepSeek 的成本优势可能直接改变商业模式。
这意味着大模型竞争正在经历一个非常类似于汽车行业的阶段。
早期只有一个问题:
"这辆车能不能跑?"
后来才出现:
跑车、SUV、卡车、家用车、赛车。
AI 也一样。
2023 年,我们关心:
"AI 到底聪不聪明?"
2026 年,我们开始关心:
"这个 AI 最适合干什么?"
中美 AI 的竞争也已经发生了变化
美国当前最强的优势依然非常明显。
OpenAI、Anthropic、Google 等公司在最前沿闭源模型、Agent 系统、Computer Use、科研能力和完整产品体系上依然拥有很强的领先优势。
但是中国出现了另一个非常有意思的现象:
最强开放权重模型的竞争,越来越有"中国主场"的感觉。
Kimi K3、GLM-5.3、DeepSeek V4,以及 Qwen、MiniMax 等开放模型已经构成一个非常庞大的生态。第三方评测中,Kimi K3 和 GLM-5.3 都位于当前开放权重模型的领先区域。(人工分析)
所以未来很可能出现一种格局:
美国继续推动:
"最强闭源智能。"
而中国大量公司同时推动:
"足够接近最强、但更加开放和便宜的智能。"
谁最终胜出,现在远没有答案。
最后:未来真正重要的不是"IQ",而是 AI 的有效劳动
我认为 2026 年以后,再看大模型排行榜,应该逐渐少问一个问题:
"Benchmark 谁最高?"
而多问三个问题:
它能完成多长的任务?
任务做了 50 步以后,它还记不记得自己在干什么?
它到底能不能把一个现实世界的问题完整交付?
因为模型从 80 分进步到 85 分当然重要。
但真正改变社会的时刻不是:
AI 又答对了一道更难的数学题。
而是:
以前一个人需要工作三天才能完成的事情,一个 AI 可以自己做完。
当这个变化开始大规模发生时,大模型就不再只是一个"聊天工具"。
它会逐渐变成:
一种新的劳动形式。
而从 GPT-6 Astra、Claude Fable、Grok、Gemini,到 Kimi、GLM、Qwen、DeepSeek,我们现在正在看到的,可能正是这个转折点的开始。