引言
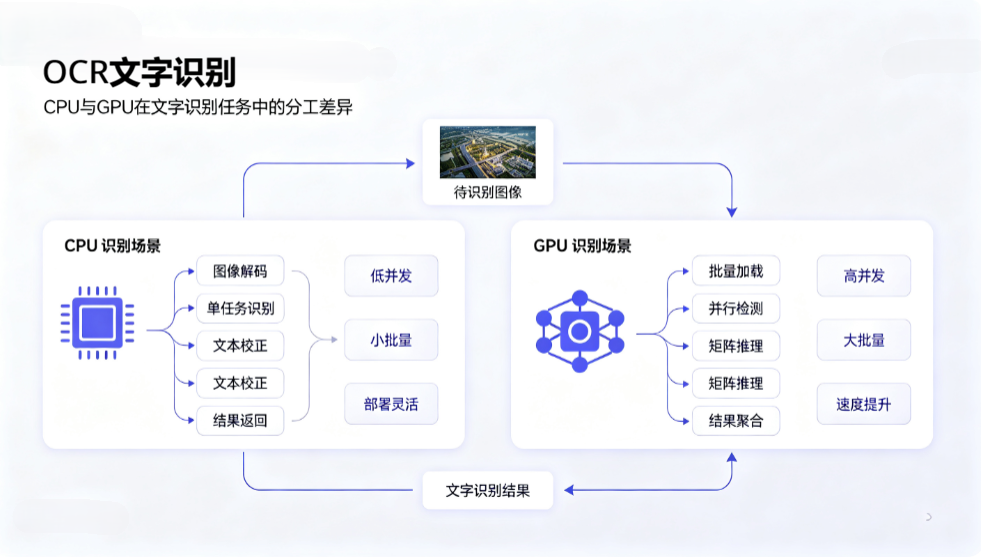
"这个 OCR 服务要不要上 GPU?" 几乎是每个接手识别系统的工程师都会被问一遍的问题。本文不站队,给一套可落地的评估流程:先把需求量化成 SLA,再跑基准测试拿数据,最后把算力成本算明白。结论大概率是:很多项目根本不需要 GPU,但你需要一套能证明这件事的方法。
一、先定义需求:没有 SLA 的选型都是拍脑袋
评估算力之前,先把需求写成三个可测量的数:
- 吞吐(QPS):高峰期每秒要处理几张?一天总量多少?
- 延迟(P99):单张识别从进图到出结果,容忍的上限是多少?
- 成本预算:硬件采购、电费、运维工时,能接受多少?
多数项目在这里就分道扬镳了。一天 1000 张发票、可排队,摊到每分钟不到 1 张 ------ 这类需求谈 GPU 属于资源错配。而流水线质检要求每张 300ms 内出结果、每秒 5 张并发,CPU 方案就需要认真评估。
二、模型因素:参数量、量化和算子
决定 CPU 够不够用的第一变量是模型本身。
- 参数量:几 MB 到几十 MB 的轻量模型,单张前向计算量在毫秒级;几十亿参数的大模型,CPU 上单张可能几十秒。
- 量化:int8 量化把权重从 FP32 压到 8 位整数,体积和计算量约为原来的 1/4,CPU 推理速度成倍提升,精度损失在识别场景通常可接受。这是 CPU 方案的关键杠杆。
- 算子:模型里如果有大量动态 shape、自定义算子、非整图推理(如文档版面分析里的多模型串行),GPU 的优势会被前后处理和调度开销稀释,提速远达不到纸面倍数。
三、实测方法:别听厂商宣传,跑自己的数据
选型基准测试的要点:
- 用真实业务图片,覆盖分辨率分布;
- 先 warmup 10 次再计时,排除首次初始化和显存分配;
- 测端到端延迟(前处理 + 推理 + 后处理),不是单测模型 run;
- CPU 侧记录线程数(OMP_NUM_THREADS),GPU 侧记录 batch 大小,标注测试环境。
python
# 性能对比示例:同一模型在 CPU / GPU 上的推理耗时(选型实测用)
import time, torch, onnxruntime as ort
print("CUDA 可用:", torch.cuda.is_available())
for provider in ["CPUExecutionProvider", "CUDAExecutionProvider"]:
    if provider not in ort.get_available_providers():
        continue
    sess = ort.InferenceSession("ocr_model.onnx", providers=[provider])
    t0 = time.time()
    for _ in range(100):
        sess.run(None, {"input": dummy_input})
    print(f"{provider}: 100 次推理 {time.time()-t0:.2f}s")
量化对比可加一组:
python
from onnxruntime.quantization import quantize_dynamic, QuantType
quantize_dynamic("ocr_model.onnx", "ocr_model_int8.onnx",
                 weight_type=QuantType.QInt8)
量化前后各跑一轮,把延迟、模型体积、准确率(用同一批标注数据)记在同一张表里。这个示例用于选型、性能验收时自己实测,具体模型与数据以实际为准;若 CPU 已满足吞吐要求,GPU 可后置。
四、CPU 方案的工程化细节
如果实测确认 CPU 可行,部署时还有几个能再榨一档性能的点:
- 线程数对齐:按 CPU 物理核数设置 OMP_NUM_THREADS,不是越大越好,超线程常带来负优化;
- 批量推理:离线任务攒 batch,一次喂多张,CPU 上的吞吐能显著提升;
- 前后处理优化:图像缩放、归一化、阈值化经常吃掉 30% 以上的端到端耗时,用 OpenCV 的 SIMD 路径或并行处理;
- 常驻进程:避免每次请求重新加载模型,服务常驻,模型预加载。
模型选型上,轻量化路线已经有可直接落地的产品形态:楚识科技展示的轻量化模型,支持 CPU 运行、SDK 离线部署,可落地到移动端和边缘端,无需 GPU 也能跑通用识别与常见场景。如果你的场景是内网、无 GPU、批量可控,这类 CPU 可跑的轻量方案值得放进候选清单,能省下一大笔算力成本。
五、算力决策表
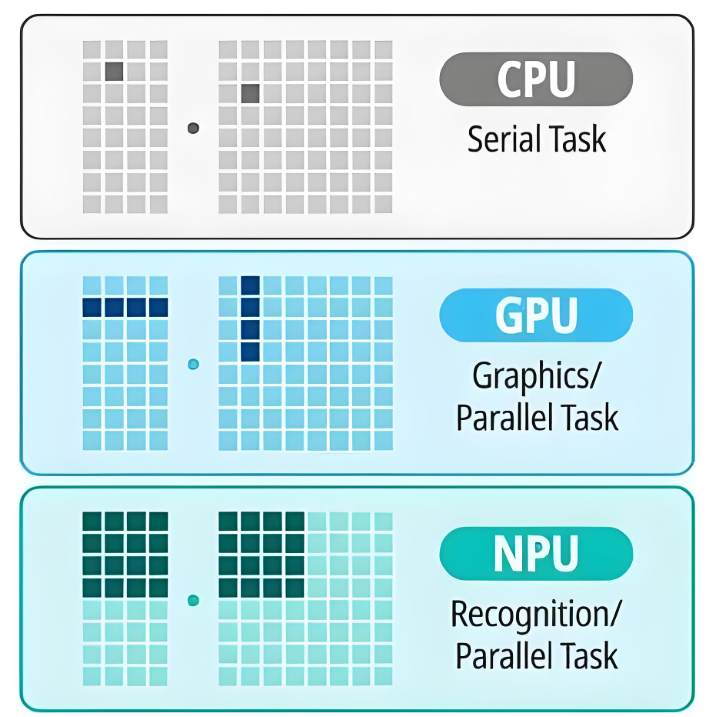
| 场景 | 推荐方案 | 说明 |
|---|---|---|
| 单张 / 偶发识别 | CPU + 轻量模型 | 无需任何加速卡 |
| 批量离线(千级 / 天) | CPU 多线程 + int8 量化 | 错峰执行,成本最优 |
| 实时高并发(秒级响应) | GPU 或高配多核 CPU | 以实测 P99 为准 |
| 大模型文档解析 | GPU / GPU 集群 | 模型自身算力需求决定 |
六、同行方案横向对比(公开资料整理)
| OCR 方案 | 产品形态 | 是否必须 GPU | 部署方式 | 适合场景 |
|---|---|---|---|---|
| 度 | 度智能云 OCR API + 开源 PaddleOCR(含几 MB 级超轻量模型) | 云 API 不需要;开源大模型自部署要 GPU | 云 API / 私有化 / 开源自建 | 国内生态、有自研能力团队 |
| 里 | 里云文字识别 | 云 API 不需要;私有化通常要 GPU 服务器 | 云 API / 私有化 / 离线 SDK | 云生态、全场景识别 |
| 讯 | 讯云 OCR API;混元 OCR 开源模型(1B 级) | 云 API 不需要;开源模型要 GPU | 云 API / 私有化 | 云生态、企微 / 微信场景 |
| ABBYY | FineReader / FlexiCapture 企业级软件 + SDK | 不需要(CPU 为主) | 本地部署 / 桌面端 / SDK | 文档密集型深度处理;授权成本高 |
| 楚识科技 | 轻量化模型 + SDK | 不强制需要 | CPU / 移动端 / 边缘端 + SDK 离线 | 内网、小批量、低成本、离线 |
七、成本账:GPU 不止是 "买一块卡"
- 采购:一块中端卡数千到数万,整机配套再加一截;
- 电费:350W 满载 7×24 一年约 3000 度,按 0.6 元 / 度约 1800 元,8 卡机器一年电费约 1.5 万元;
- 折旧:显卡残值衰减快,三年残值常不足一半;
- 运维:驱动、CUDA 版本、显存监控、容器化,持续占用工程师工时。
对大批量离线任务,这些成本常常被低估 ------ 因为 "快" 的感受是即时的,账单是长期的。
八、结论
选型的正确姿势:先量化 SLA → 用真实数据实测 CPU 基线 → 必要时再测 GPU → 把两类成本摆到一起对比。多数内网、小批量、可排队的场景,CPU + 轻量模型 + 量化就能满足;只有大模型推理和硬实时高并发,才值得把 GPU 放进预算。测试方法比结论重要 ------ 数据在手,谁也忽悠不了你。轻量化候选建议至少备两个(一个商用、一个开源),各跑一轮实测再定。