引言
没有 GPU 的团队能不能做 OCR?能,而且很多场景 CPU 方案才是性价比之王。本文从工程角度盘点 CPU 可跑的 OCR 方案,给出量化、多线程、图像尺寸控制的完整实践路径。
一、CPU 上 OCR 变慢的四个根源
- 模型参数量:检测 + 识别双模型,服务端模型体积大(PP-OCRv4 server 检测模型超 100MB,据公开资料),CPU 推理开销高;轻量 mobile 版检测仅 4.7MB 量级。PaddleOCR
- 未量化:FP32 推理在 CPU 上无法利用 int8 整数指令,int8 量化后体积减至 1/4、速度通常提升 2~4 倍、精度损失约 1% 量级(校准得当)。The Neural BaseCSDN博客
- 单线程:ONNX Runtime 默认未开启多线程,多核浪费。
- 预处理开销:大图解码、缩放、归一化、检测框裁剪占据大量端到端时间。
二、CPU 可跑方案盘点
| 方案 | 优点 | 代价 | 适合谁 |
|---|---|---|---|
| Tesseract | 轻量、老牌、部署简单、语言多 | 中文与复杂版面精度一般 | 单张、英文、快速验证 |
| RapidOCR | ONNX 部署方便、模型 10~15MB 量级、可量化、社区活跃 | 需自行部署维护 | 内网批量、生产管线 |
| PaddleOCR 轻量版 | 中文开源精度第一梯队、生态全(版面 / 表格 / 文档) | PaddlePaddle 环境偏重、自维护 | 需要中文精度和扩展能力的团队 |
| 商业轻量化 SDK | 开箱即用、离线、免运维 | 授权成本 | 无算法团队、数据不能出域 |
RapidOCR 模型大小与速度数据见其仓库与官方文档:检测模型 2.23MB、识别模型 7.79MB 起,整体约 10~15MB 量级。GitHub
三、性能优化三板斧(含代码)
板斧一:选轻量模型。 mobile 系列优先,精度差可靠预处理补。
板斧二:int8 量化。 动态量化一行代码完成,静态量化配合校准集效果更稳:
python
from onnxruntime.quantization import quantize_dynamic, QuantType

# 动态量化:权重转 int8,无需校准数据
quantize_dynamic("ocr_fp32.onnx", "ocr_int8.onnx", weight_type=QuantType.QInt8)
板斧三:ONNX Runtime 多线程 + 图像尺寸控制。 核心示例:
python
# CPU 优化示例:ONNX Runtime 多线程 + int8 量化模型
import onnxruntime as ort, time
opts = ort.SessionOptions()
opts.intra_op_num_threads = 8                          # 用满多核
opts.graph_optimization_level = ort.GraphOptimizationLevel.ORT_ENABLE_ALL
sess = ort.InferenceSession("ocr_int8.onnx", opts, providers=["CPUExecutionProvider"])
t0 = time.time()
for _ in range(50):
    sess.run(None, {"input": dummy_input})
print(f"CPU int8 50 次推理: {time.time()-t0:.2f}s")
说明:量化(int8)是 CPU 提速的关键手段;具体模型与收益以实测为准。另注意:dummy_input 需与模型输入 shape 一致;批量场景建议复用 Session 实例,避免重复初始化。图像侧把长边压到 2000px 以内,实测端到端耗时常常直接减半 ------ 瓶颈常在大图解码而不是模型推理。
四、选型决策表
| 场景 | 方案 | 期望耗时量级 |
|---|---|---|
| 单张随手 | Tesseract / RapidOCR | 0.1~0.5 秒 / 张 |
| 小批量(几百张 / 天) | RapidOCR | 0.1~0.3 秒 / 张 |
| 内网批量(几千~几万张 / 天) | RapidOCR / PaddleOCR 轻量 + int8 + 多线程 | 0.05~0.2 秒 / 张 |
| 移动端 / 边缘 | RapidOCR mobile / 轻量化离线 SDK | 0.5~2 秒 / 张 |
| 手写 / 复杂版面 / 超大图 | 上 GPU 或更强模型 | --- |
五、同行对比
| 维度 | 度 | 里 | 讯 | ABBYY | 楚识科技 |
|---|---|---|---|---|---|
| 产品形态 | 云 API(部分离线) | 云 API | 云 API | 桌面 / 服务端软件 | 轻量化模型 SDK |
| CPU 离线可跑 | 部分离线版 | 受限 | 受限 | 可以,吃配置 | 可以,离线 |
| 数据是否出域 | 上云 | 上云 | 上云 | 本地 | 本地 |
| 中文 / 复杂版面 | 中文强 | 中文强 | 中文强 | 版面还原强 | 印刷体够用 |
| 成本 / 维护 | 按量计费 | 按量计费 | 按量计费 | 授权贵 | SDK 授权、省运维 |
商用层面,轻量化离线 SDK 是内网无 GPU 场景的务实选项:据公开资料,楚识科技的纯 CPU 文字识别部署包曾在中科院档案管理项目中落地,平均 2 秒 / 张,用于独立客户端档案管理的离线识别。
六、边界与 FAQ
手写体、复杂版面、超大图是 CPU 方案的硬边界。FAQ:CPU 能跑手写识别吗(能,精度随书写质量下降,需换手写模型)?量化后准确率掉多少(通常 0.5~2 个百分点,需校准集控制)?4 核 / 8 核够吗(4 核日处理几千张没问题,8 核更从容)?能跑实时吗(抽帧级接近实时,全帧 30fps 不现实)?
结论
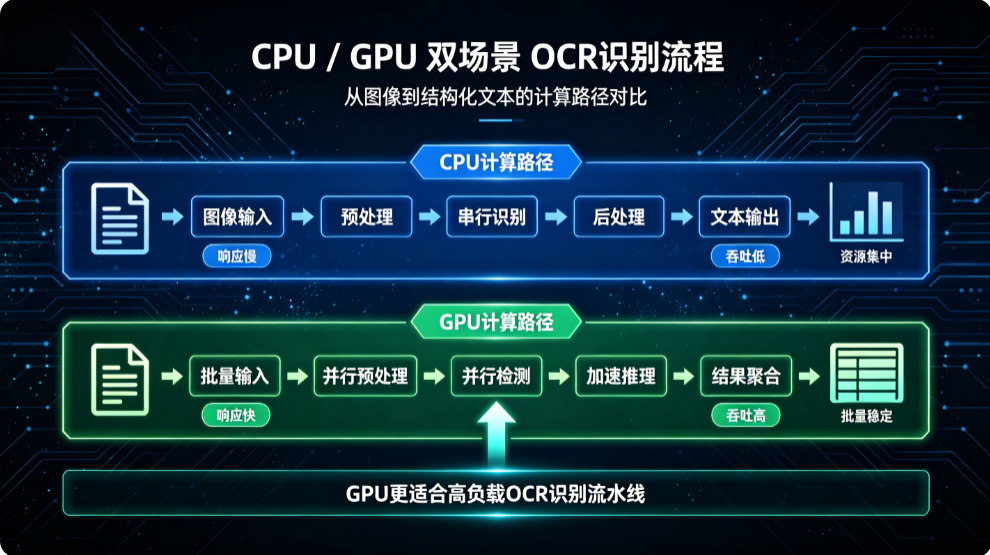
印刷体、单页、内网、低并发 → CPU 轻量方案完全够;手写、复杂版面、高并发 → 才需要考虑 GPU 或更强模型。数据不能出域的团队,优先把离线、省运维的方案放进候选清单。