注意:该项目只展示部分功能,如需了解,文末咨询即可。
本文目录
- [1 开发环境](#1 开发环境)
- [2 系统设计](#2 系统设计)
- [3 系统展示](#3 系统展示)
- [3.1 功能展示视频](#3.1 功能展示视频)
- [3.2 大屏页面](#3.2 大屏页面)
- [3.3 分析页面](#3.3 分析页面)
- [3.4 基础页面](#3.4 基础页面)
- [4 更多推荐](#4 更多推荐)
- [5 部分功能代码](#5 部分功能代码)
1 开发环境
发语言:python
采用技术:Spark、Hadoop、Django、Vue、Echarts等技术框架
数据库:MySQL
开发环境:PyCharm
2 系统设计
随着药品数据在名称、治疗类别、剂型、规格剂量、生产厂商、适应症和管控分类等维度上不断累积,传统单机统计方式在数据装载、清洗和多维交叉分析方面难以满足高效处理与稳定输出的需求。该背景下,本项目以 medicine 数据集为对象,依托 HDFS 完成数据装载与存储,结合 pandas 进行预处理,并使用 Spark 对药品多维度属性进行统计分析与模式挖掘,为药品大数据分析与可视化系统提供数据基础。
系统开发意义在于将分散的药品属性转化为可统计、可对比、可挖掘的结构化结果,通过品类结构、剂型分布、规格剂量、厂商格局、适应症谱和管控分类等分析,呈现药品市场与管控特征,并借助 K-Means 聚类、FP-Growth 关联规则和 Isolation Forest 异常检测发现属性组合模式与异常剂量,为药品数据可视化、结构洞察和辅助决策提供可靠依据。
本项目围绕药品多维度属性大数据分析与统计展开,以 medicine 数据集为对象,基于 HDFS 完成数据装载,利用 pandas 进行预处理,并通过 Spark 执行多维统计与模式挖掘。预处理阶段对表头进行英文化,统一为 snake_case 字段,清洗类别字段空值,解析 strength 中的 mg 数值并生成 strength_value,完成品类、剂型、适应症、管控分类和厂商的中文映射,数值保留两位小数,输出本地 CSV 并同步至 HDFS。分析阶段读取预处理数据,从品类结构、剂型分布、规格剂量、厂商格局、适应症谱、管控分类等角度开展占比、排名、交叉对比和差异分析,同时使用 K-Means 聚类、FP-Growth 关联规则和 Isolation Forest 异常检测进行模式洞察,输出各类 CSV 结果,为药品多维度属性可视化提供数据支撑。
数据装载与预处理:研究 HDFS 目录重建、文件上传、SafeMode 检查、pandas 清洗、字段规范化、剂量解析、中文枚举映射、本地与 HDFS 结果保存,为后续分析提供干净数据。
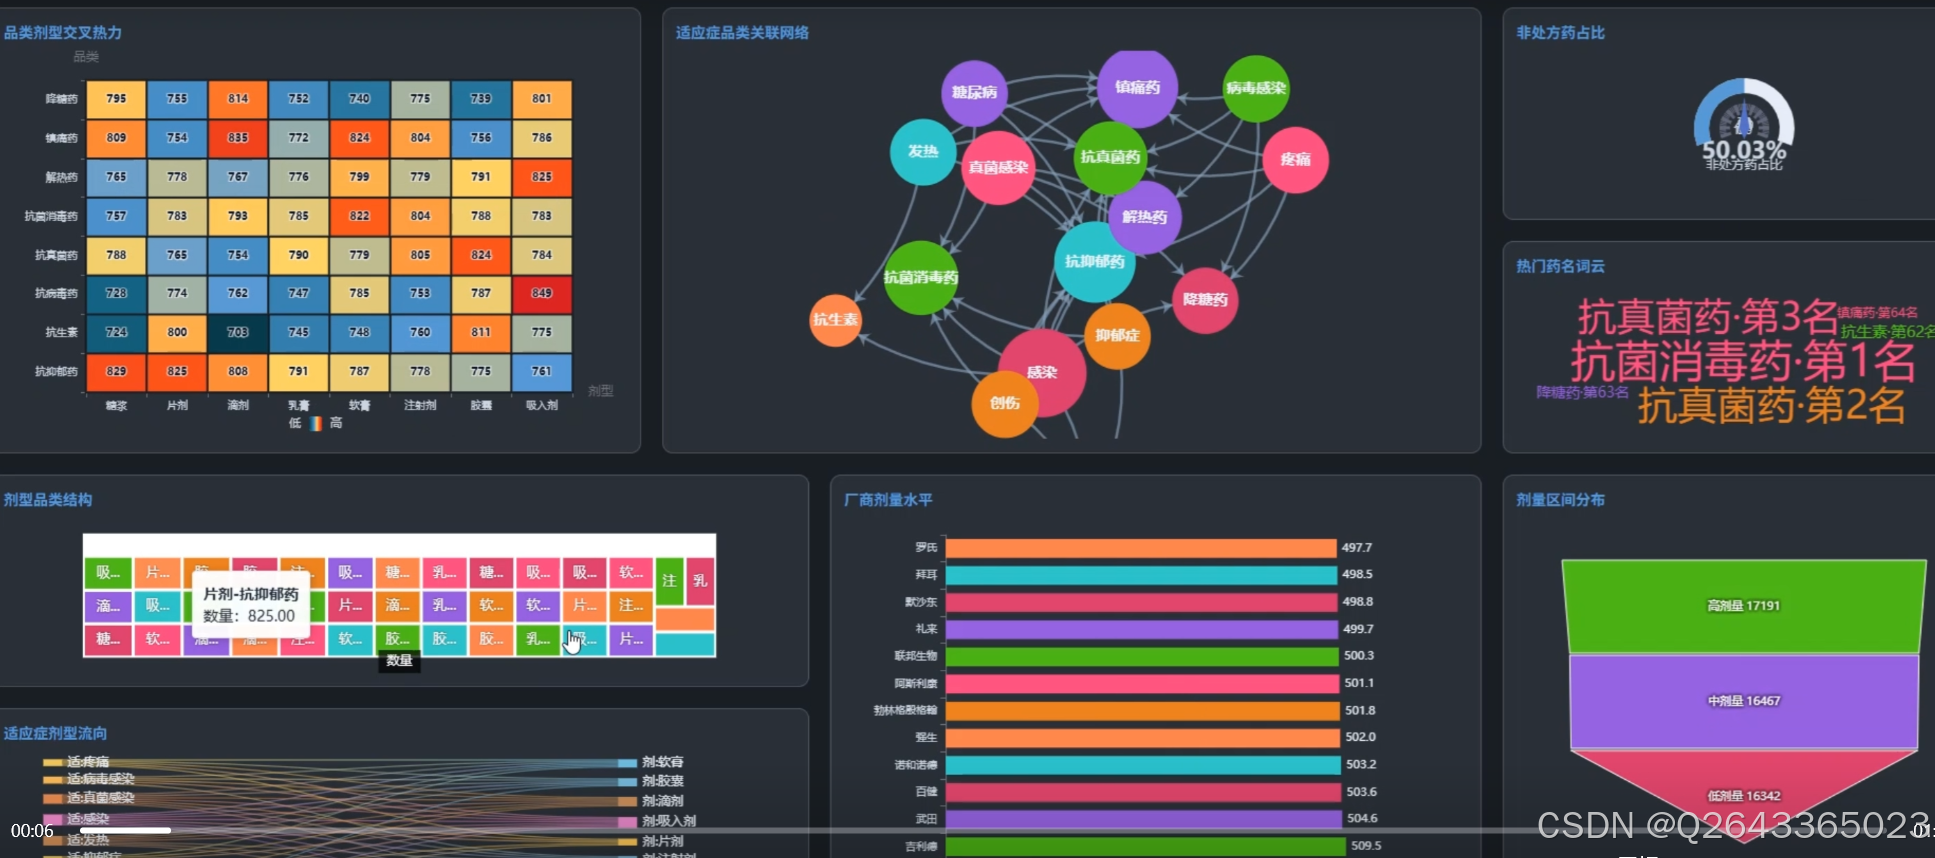
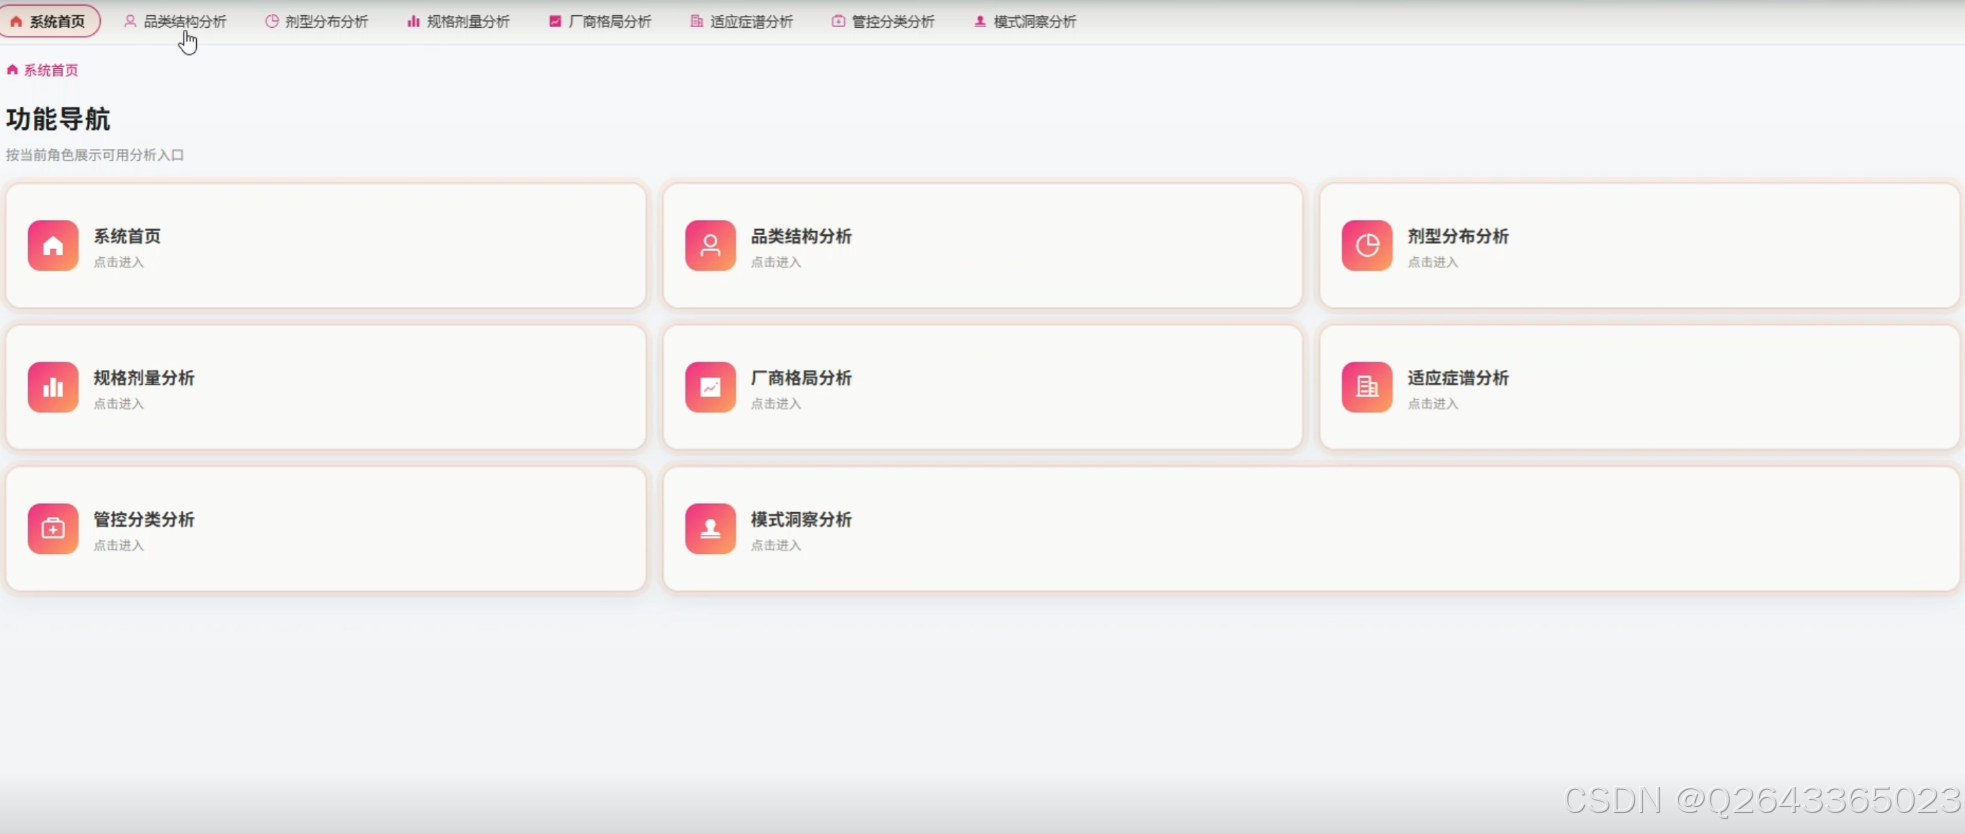
品类结构分析:研究治疗类别占比、品类数量排名、品类与管控分类对比、热门药名排名、品类与剂型交叉构成,呈现药品品类结构。
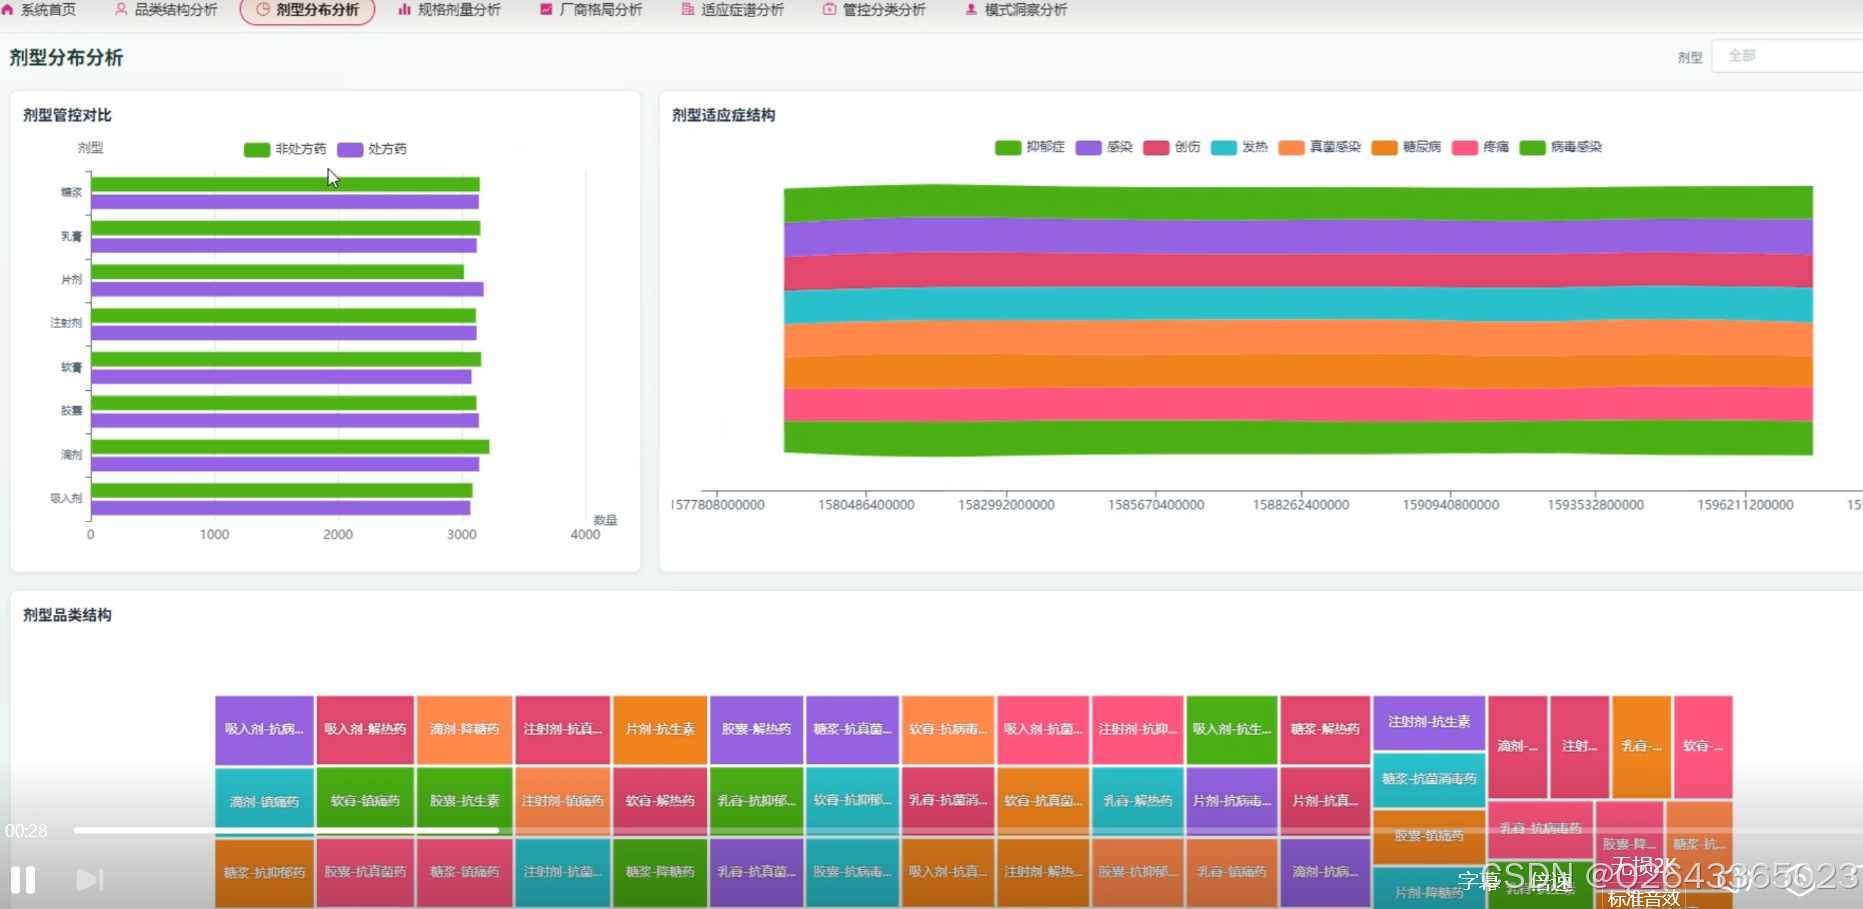
剂型分布分析:研究剂型数量占比、剂型与管控分类对比、剂型与适应症关系、剂型品类结构、主流剂型排名,反映剂型分布特征。
规格剂量分析:研究剂量低中高分箱、品类平均剂量、剂型平均剂量、管控分类剂量对比、厂商剂量水平,刻画规格剂量差异。
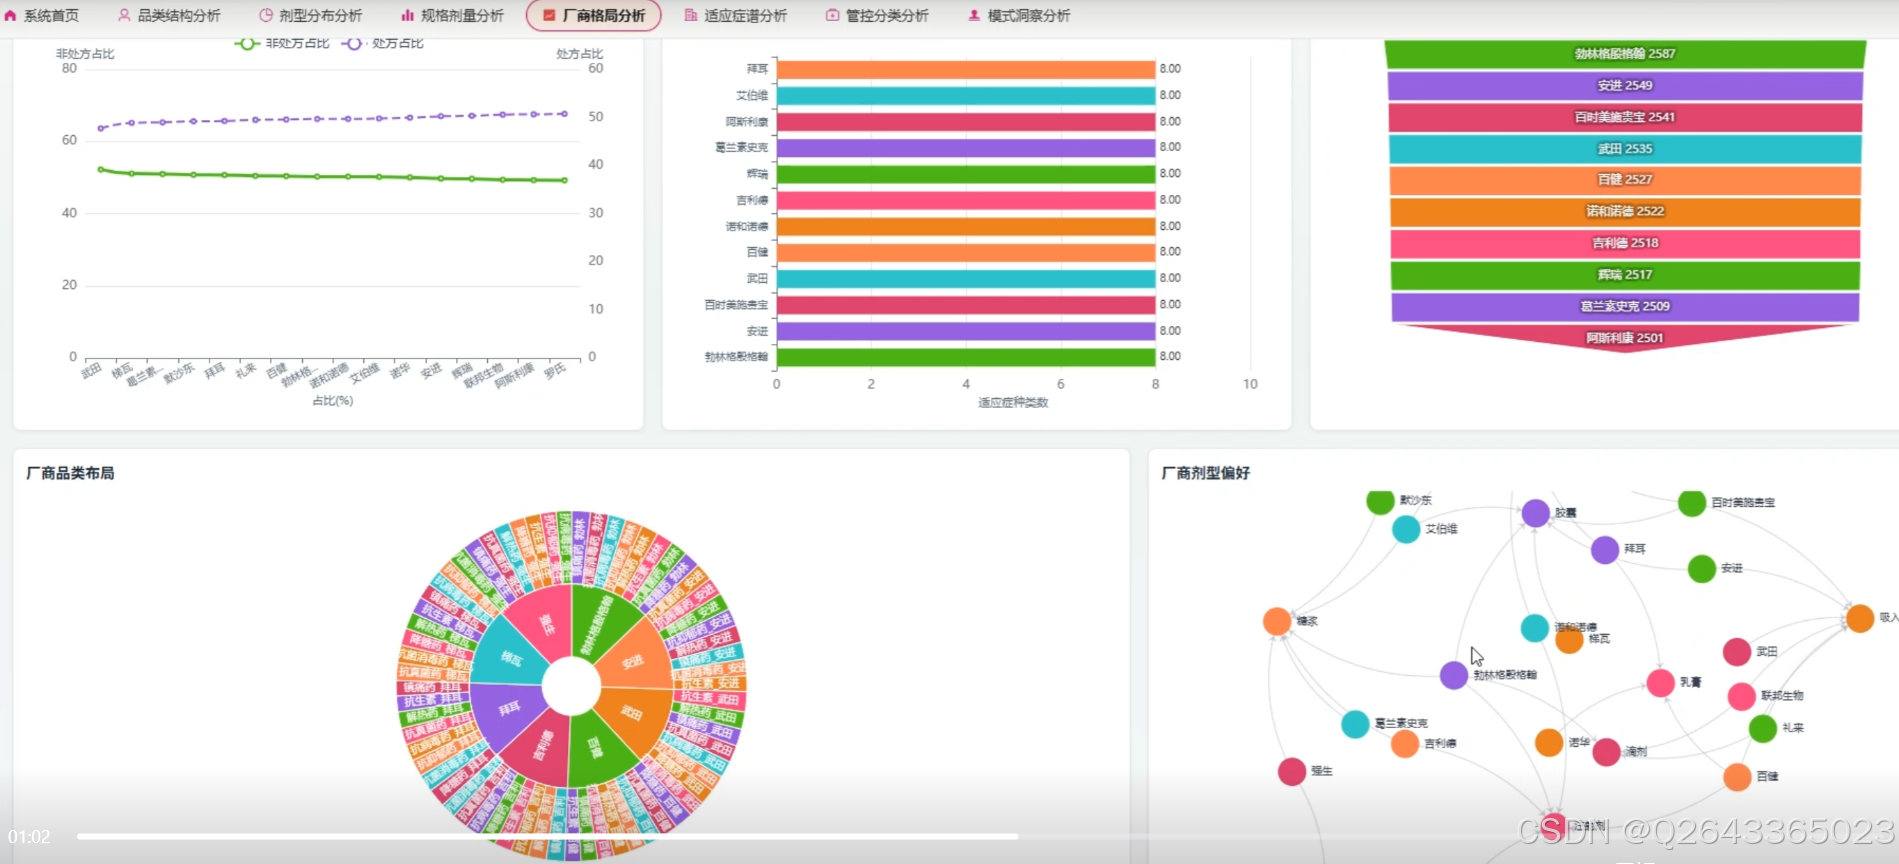
厂商格局分析:研究厂商产量排名、厂商品类布局、厂商非处方药占比、厂商剂型偏好、厂商适应症覆盖,展示厂商竞争与布局。
适应症谱分析:研究适应症数量占比、适应症与品类关联、适应症与管控分类对比、适应症剂型结构、适应症剂量水平,描绘适应症谱系。
管控分类分析:研究非处方药与处方药总体占比、管控分类下品类差异、剂型差异、适应症差异、剂量差异,比较管控分类特征。
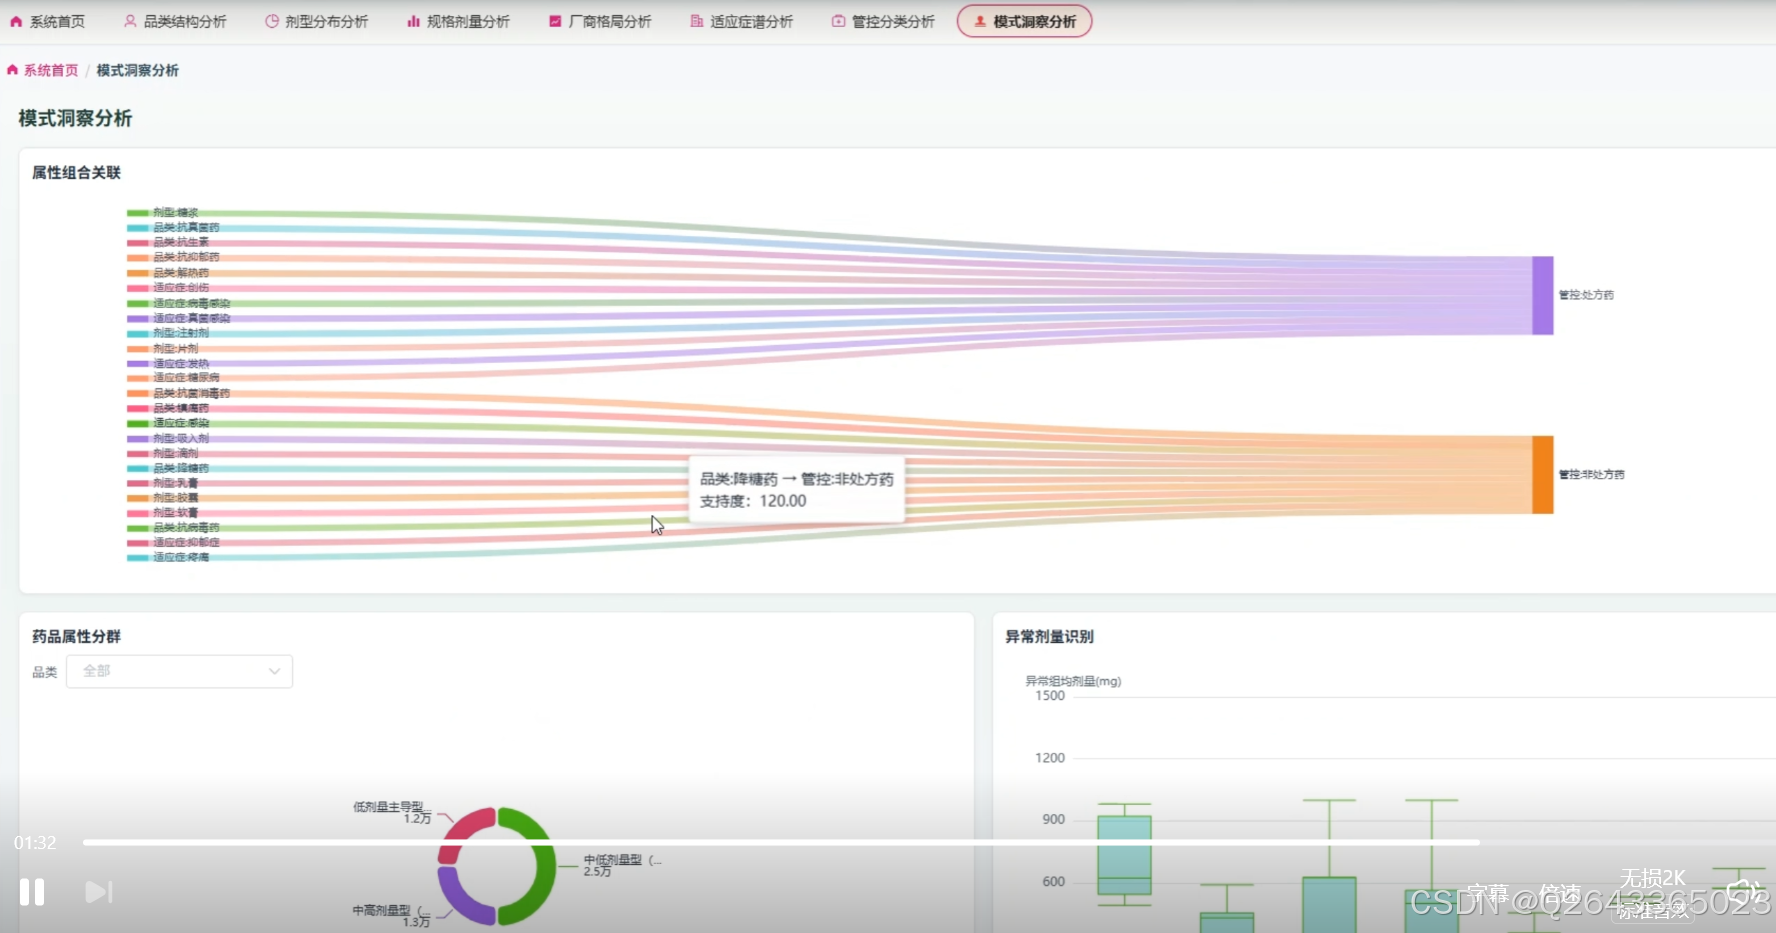
模式洞察分析:研究药品属性 K-Means 分群、品类/剂型/适应症/管控组合的 FP-Growth 关联规则、基于 Isolation Forest 的异常剂量识别,挖掘潜在模式与异常。
3 系统展示
3.1 功能展示视频
基于大数据的药品多维度属性分析与可视化的设计与实现
!!!请点击这里查看功能演示!!!
3.2 大屏页面
3.3 分析页面
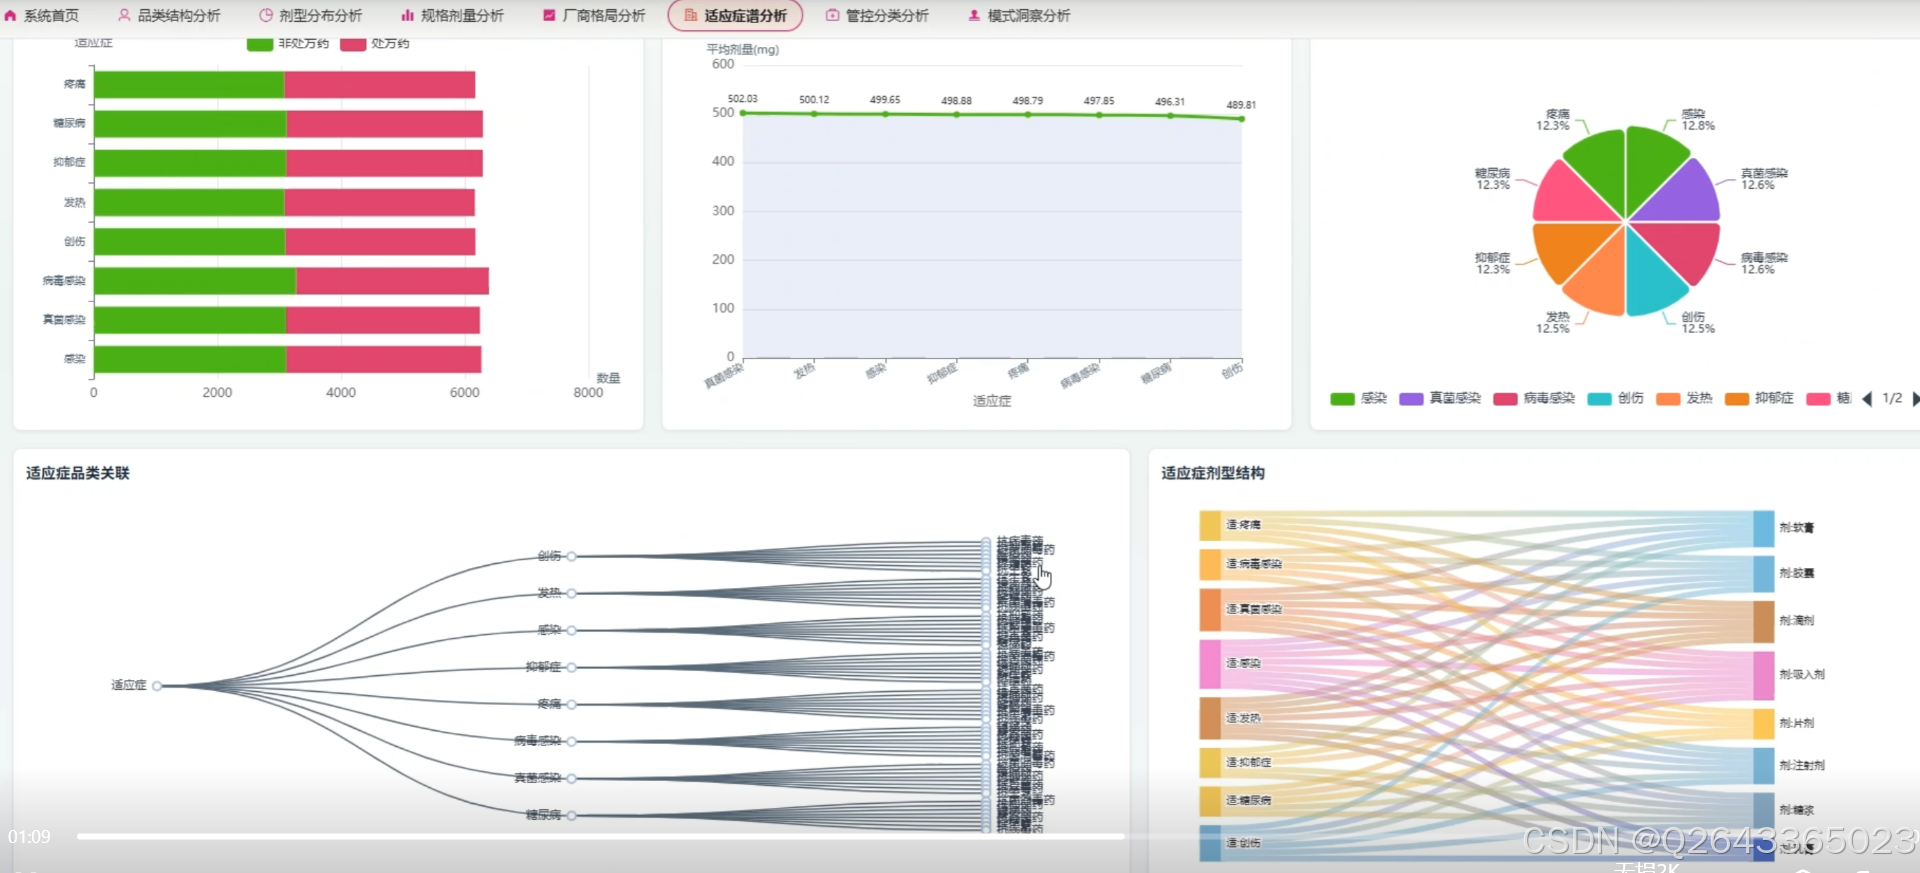
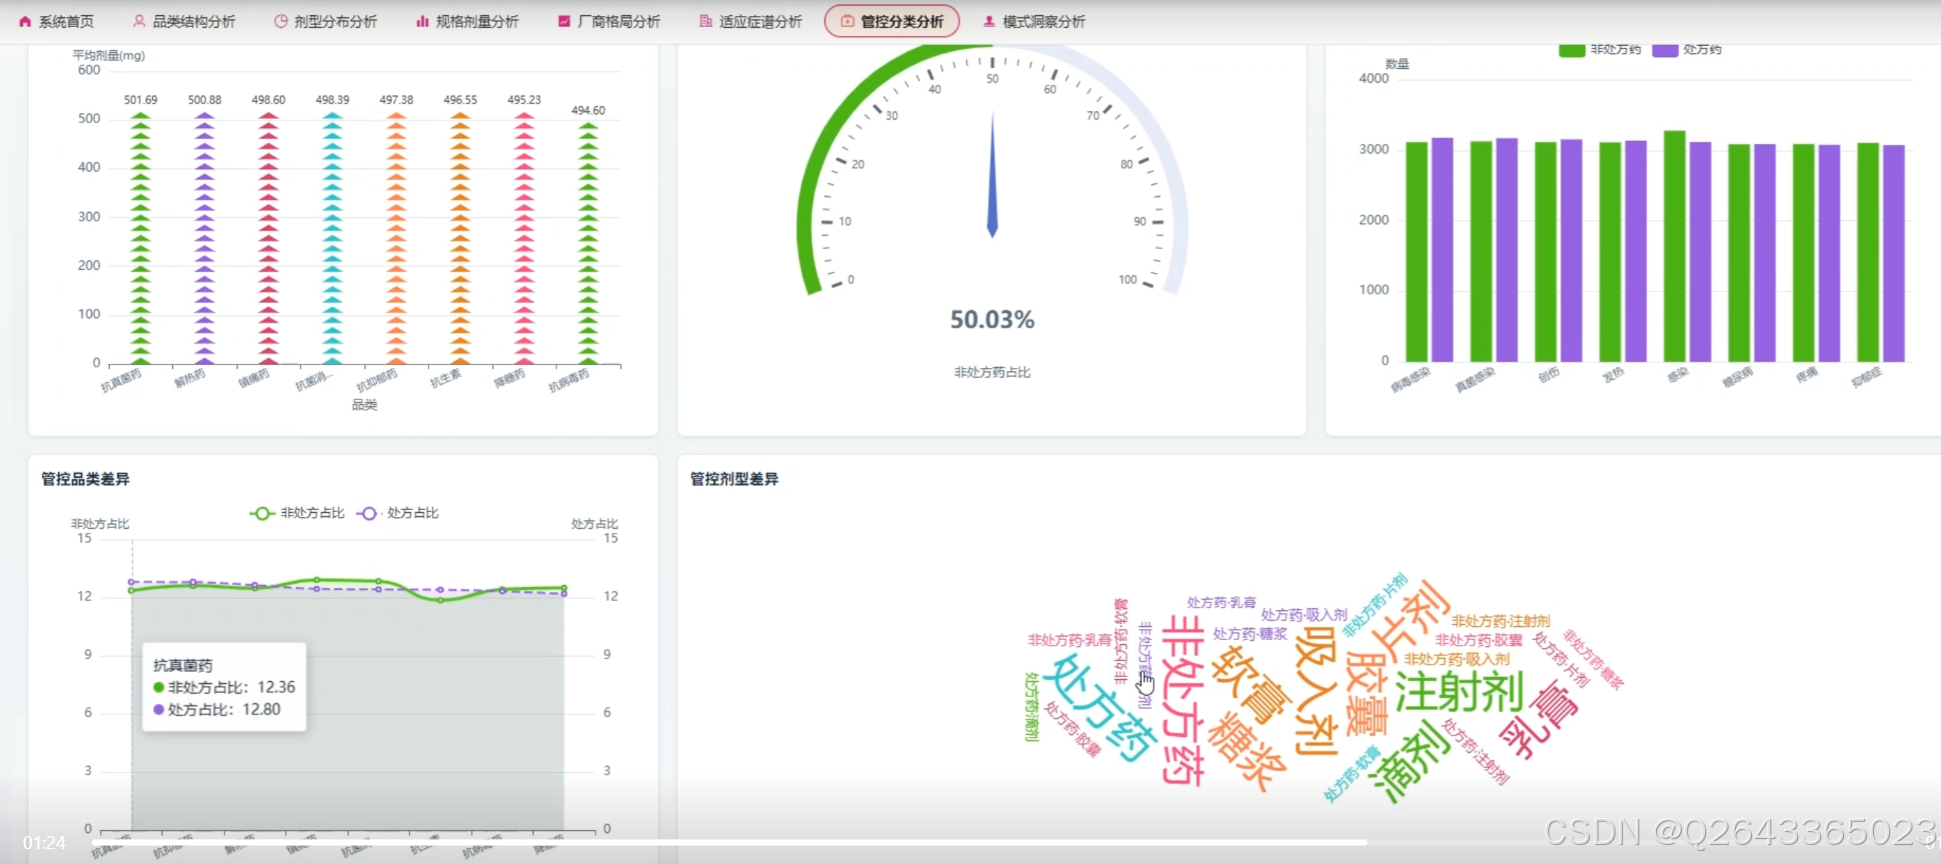
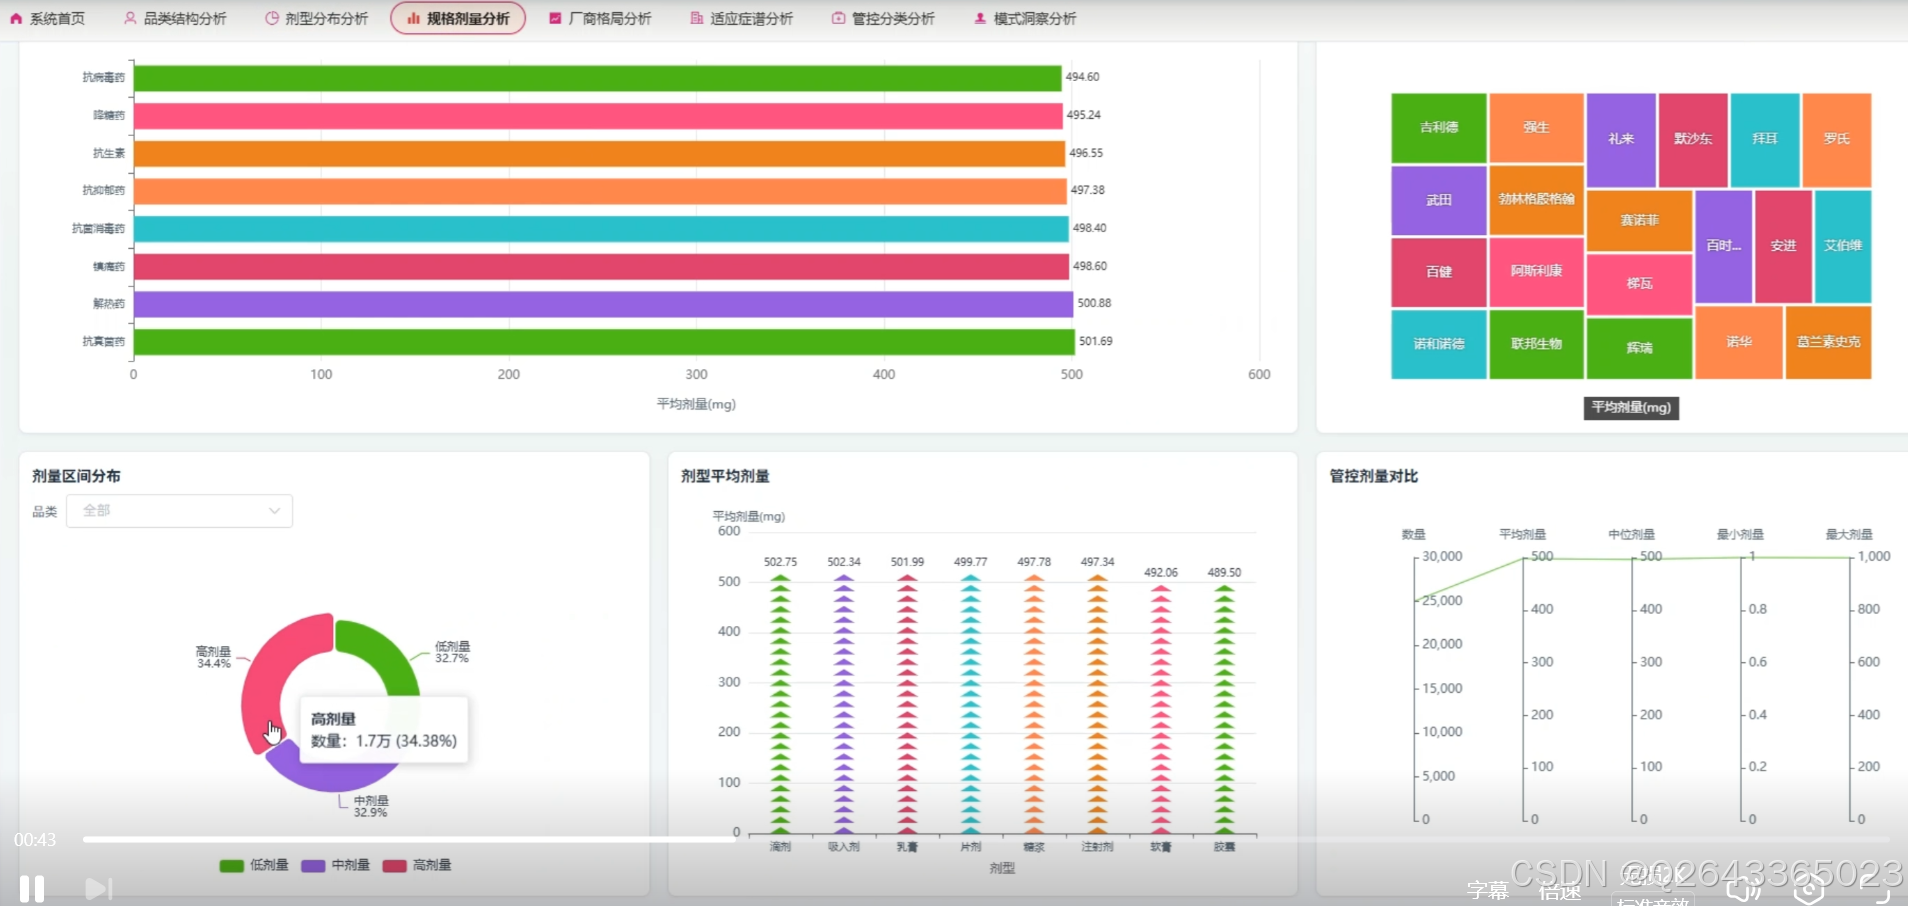
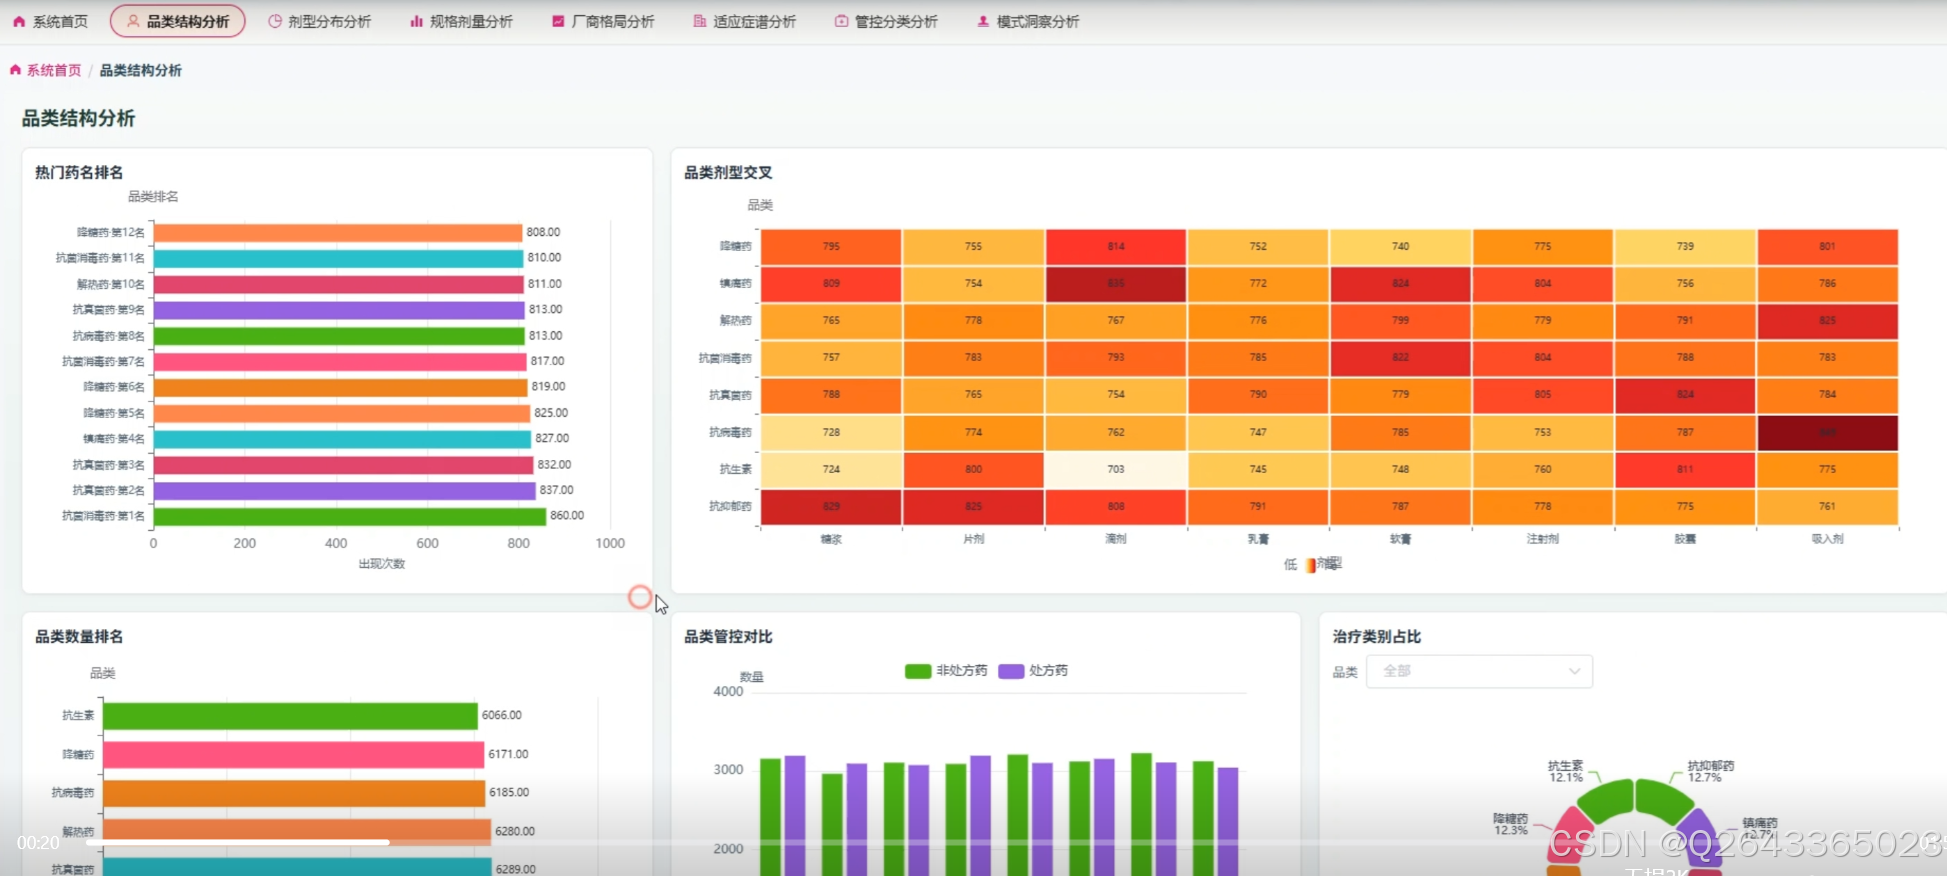
3.4 基础页面
4 更多推荐
计算机专业毕业设计新风向,2026年大数据 + AI前沿60个毕设选题全解析,涵盖Hadoop、Spark、机器学习、AI等类型
计算机专业毕业设计选题深度剖析,掌握这些技巧,让你的选题轻松通过,文章附35个优质选题助你顺利通过开题!
【避坑必看】26届计算机毕业设计选题雷区大全,这些毕设题目千万别选!选题雷区深度解析
紧跟风口!2026计算机毕设新赛道:精选三大热门领域下的创新选题, 拒绝平庸!毕设技术亮点+功能创新,双管齐下
纯分享!2026届计算机毕业设计选题全攻略(选题+技术栈+创新点+避坑),这80个题目覆盖所有方向,计算机毕设选题大全收藏
计算机专业毕业设计选题深度剖析,掌握这些技巧,让你的选题轻松通过,文章附35个优质选题助你顺利通过开题!
5 部分功能代码
python
def medicine_attribute_cluster_analysis(input_df):
    """
    药品属性分群分析(K-Means)。
    特征:strength_value + 品类/剂型/适应症/管控 one-hot,标准化后聚类。
    """
    logger.info("开始分析: medicine_attribute_cluster_analysis")
    base = input_df.filter(
        col('strength_value').isNotNull()
        & col('category').isNotNull()
        & col('dosage_form').isNotNull()
        & col('indication').isNotNull()
        & col('classification').isNotNull()
    ).withColumn('strength_value', col('strength_value').cast('double'))

    cat_cols = ['category', 'dosage_form', 'indication', 'classification']
    staged = base
    index_cols = []
    for c in cat_cols:
        idx = f'{c}_idx'
        staged = StringIndexer(
            inputCol=c, outputCol=idx, handleInvalid='skip'
        ).fit(staged).transform(staged)
        index_cols.append(idx)

    assembler = VectorAssembler(
        inputCols=['strength_value'] + index_cols,
        outputCol='features_raw',
    )
    featured = assembler.transform(staged)
    scaler = StandardScaler(
        inputCol='features_raw', outputCol='features', withMean=True, withStd=True
    )
    featured = scaler.fit(featured).transform(featured)

    evaluator = ClusteringEvaluator(
        featuresCol='features', predictionCol='cluster_id', metricName='silhouette'
    )
    best_k, best_score, best_model, best_pred = 4, -1.0, None, None
    for k in [3, 4, 5, 6]:
        km = KMeans(featuresCol='features', predictionCol='cluster_id', k=k, seed=42)
        model = km.fit(featured)
        pred = model.transform(featured)
        score = float(evaluator.evaluate(pred))
        if score > best_score:
            best_k, best_score, best_model, best_pred = k, score, model, pred

    pred_pdf = best_pred.select(
        'cluster_id', 'strength_value', 'category', 'dosage_form', 'indication', 'classification'
    ).toPandas()

    rows = []
    cluster_stats = []
    for cid, g in pred_pdf.groupby('cluster_id'):
        avg_dose = float(round(g['strength_value'].mean(), 2))
        cluster_stats.append({
            'cluster_id': int(cid),
            'sample_count': int(len(g)),
            'avg_strength': avg_dose,
            'main_category': _mode_label(g, 'category'),
            'main_dosage_form': _mode_label(g, 'dosage_form'),
            'main_indication': _mode_label(g, 'indication'),
            'main_classification': _mode_label(g, 'classification'),
        })

    result_pdf = pd.DataFrame(cluster_stats)
    path = _write_csv_pattern_insight(result_pdf, 'medicine_attribute_cluster_analysis')
    logger.info(f"保存到: {path} 成功")
    return result_pdf


def attribute_association_analysis(input_df):
    """
    属性组合关联分析(FP-Growth)。
    每条记录视为事务:品类/剂型/适应症/管控 四项;过滤提升度≤1 的弱规则。
    """
    logger.info("开始分析: attribute_association_analysis")
    base = input_df.filter(
        col('category').isNotNull()
        & col('dosage_form').isNotNull()
        & col('indication').isNotNull()
        & col('classification').isNotNull()
    )
    n_rows = base.count()

    items_df = base.select(
        array(
            concat(lit('品类:'), col('category')),
            concat(lit('剂型:'), col('dosage_form')),
            concat(lit('适应症:'), col('indication')),
            concat(lit('管控:'), col('classification')),
        ).alias('items')
    )

    fp = FPGrowth(itemsCol='items', minSupport=0.02, minConfidence=0.3)
    model = fp.fit(items_df)
    rules = model.associationRules

    strong = rules.filter(col('lift') > 1.0)
    freq = model.freqItemsets.withColumn(
        'itemset_support', spark_round(col('freq') / lit(float(n_rows)), 2)
    )
    strong_str = strong.select(
        col('antecedent'),
        col('consequent'),
        spark_round(col('confidence'), 2).alias('confidence'),
        spark_round(col('lift'), 2).alias('lift'),
    )
    result = (
        strong_str.join(
            freq.select(
                col('items').alias('antecedent'),
                col('itemset_support').alias('support'),
            ),
            on='antecedent',
            how='left',
        )
        .select(
            concat_ws(' & ', col('antecedent')).alias('antecedent'),
            concat_ws(' & ', col('consequent')).alias('consequent'),
            col('support'),
            col('confidence'),
            col('lift'),
        )
        .orderBy(desc('lift'), desc('confidence'))
    )
    result = result.withColumn(
        'rule_desc',
        concat(col('antecedent'), lit(' → '), col('consequent')),
    )
    path = _write_csv_pattern_insight(result, 'attribute_association_analysis')
    logger.info(f"保存到: {path} 成功")
    return result


def anomaly_dose_detection_analysis(input_df):
    """
    异常剂量识别分析(Isolation Forest)。
    参数:n_estimators=200, contamination=0.05, random_state=42。
    """
    logger.info("开始分析: anomaly_dose_detection_analysis")
    base = input_df.filter(
        col('strength_value').isNotNull()
        & col('category').isNotNull()
        & col('dosage_form').isNotNull()
    ).select('strength_value', 'category', 'dosage_form', 'indication', 'classification', 'name')
    n_rows = base.count()

    staged = base.withColumn('strength_value', col('strength_value').cast('double'))
    for c in ['category', 'dosage_form']:
        staged = StringIndexer(
            inputCol=c, outputCol=f'{c}_idx', handleInvalid='skip'
        ).fit(staged).transform(staged)

    feat_pdf = staged.select(
        'strength_value', 'category_idx', 'dosage_form_idx',
        'category', 'dosage_form', 'indication', 'classification', 'name',
    ).toPandas()

    X = feat_pdf[['strength_value', 'category_idx', 'dosage_form_idx']].astype(float).values
    X_scaled = SkStandardScaler().fit_transform(X)

    clf = IsolationForest(
        n_estimators=200,
        contamination=0.05,
        random_state=42,
        n_jobs=-1,
    )
    pred = clf.fit_predict(X_scaled)
    scores = clf.decision_function(X_scaled)

    feat_pdf['anomaly_score'] = np.round(scores, 2)
    feat_pdf['is_anomaly'] = (pred == -1).astype(int)
    feat_pdf['anomaly_flag'] = feat_pdf['is_anomaly'].map(
        {1: '异常剂量', 0: '正常剂量'}
    )

    anom = feat_pdf[feat_pdf['is_anomaly'] == 1]
    if len(anom) == 0:
        result_pdf = pd.DataFrame(columns=[
            'category', 'dosage_form', 'anomaly_count', 'avg_anomaly_score',
            'avg_strength', 'anomaly_flag',
        ])
    else:
        result_pdf = (
            anom.groupby(['category', 'dosage_form'], as_index=False)
            .agg(
                anomaly_count=('is_anomaly', 'sum'),
                avg_anomaly_score=('anomaly_score', 'mean'),
                avg_strength=('strength_value', 'mean'),
            )
        )
        result_pdf['avg_anomaly_score'] = result_pdf['avg_anomaly_score'].round(2)
        result_pdf['avg_strength'] = result_pdf['avg_strength'].round(2)
        result_pdf['anomaly_count'] = result_pdf['anomaly_count'].astype(int)
        result_pdf['anomaly_flag'] = '异常剂量'
        result_pdf = result_pdf.sort_values('anomaly_count', ascending=False)

    path = _write_csv_pattern_insight(result_pdf, 'anomaly_dose_detection_analysis')
    logger.info(f"保存到: {path} 成功")
    return result_pdf
源码项目、定制开发、文档报告、PPT、代码答疑
希望和大家多多交流 ↓↓↓↓↓