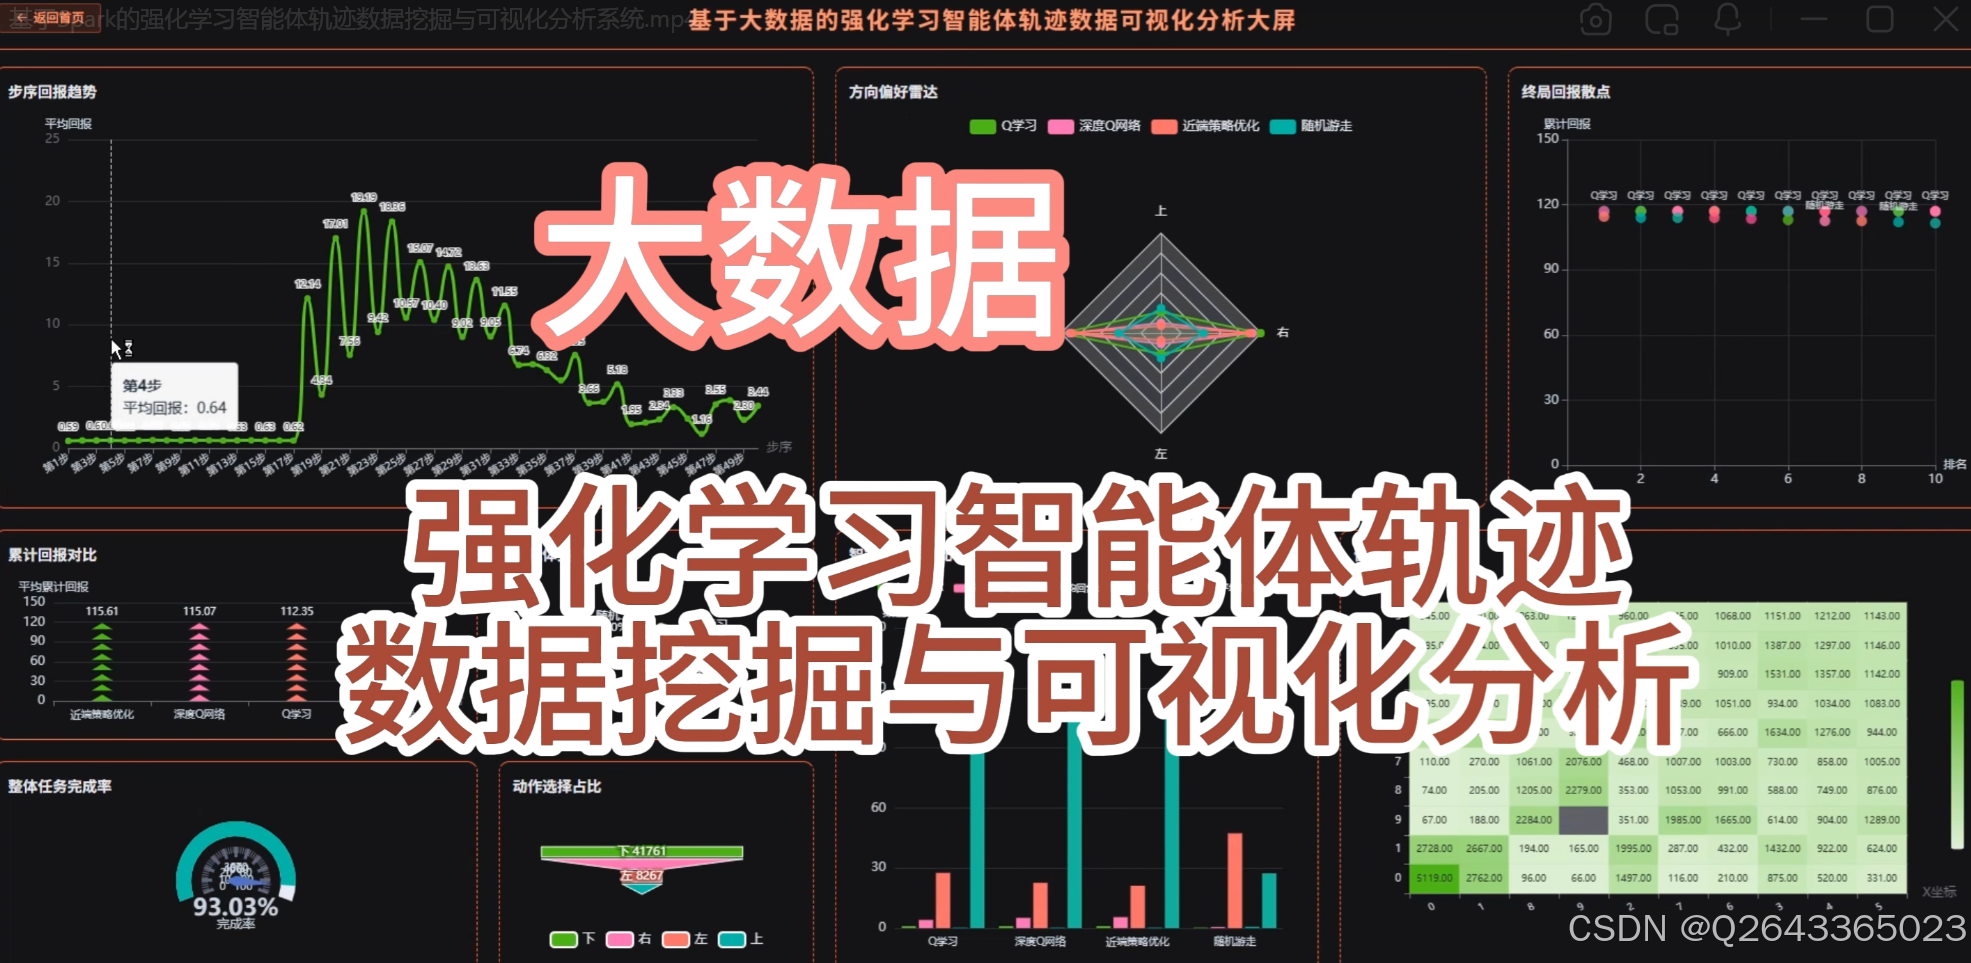
基于 Hadoop 的强化学习智能体轨迹数据挖掘与可视化分析系统
一、项目简介
本系统是一个基于 Spark 大数据平台的强化学习智能体轨迹数据挖掘与可视化分析系统,面向 Gridworld 环境中 Q 学习、深度 Q 网络、近端策略优化、随机游走四类智能体产生的海量轨迹数据,构建了从 HDFS 分布式存储、数据清洗预处理、多维统计分析、机器学习深度挖掘到可视化展示的全链路解决方案。系统基于 PySpark 实现了 16 项覆盖基础统计、行为画像、序列模式与异常检测的多维分析,所有结果均以独立 CSV 文件输出,为智能体性能评估与策略优化提供坚实的数据支撑。
基于Spark的强化学习智能体轨迹数据挖掘与可视化分析系统
二、核心亮点
- 全链路一体化:打通从 HDFS 数据上传、分布式存储、清洗预处理到 16 项多维分析的全流程,无需人工干预,一键完成;
- 多算法融合挖掘:在传统统计分析之外,融合 K-Means 聚类、FP-Growth 频繁模式挖掘、Isolation Forest 异常检测等机器学习算法,实现回合行为画像、动作序列模式发现与轨迹异常点识别;
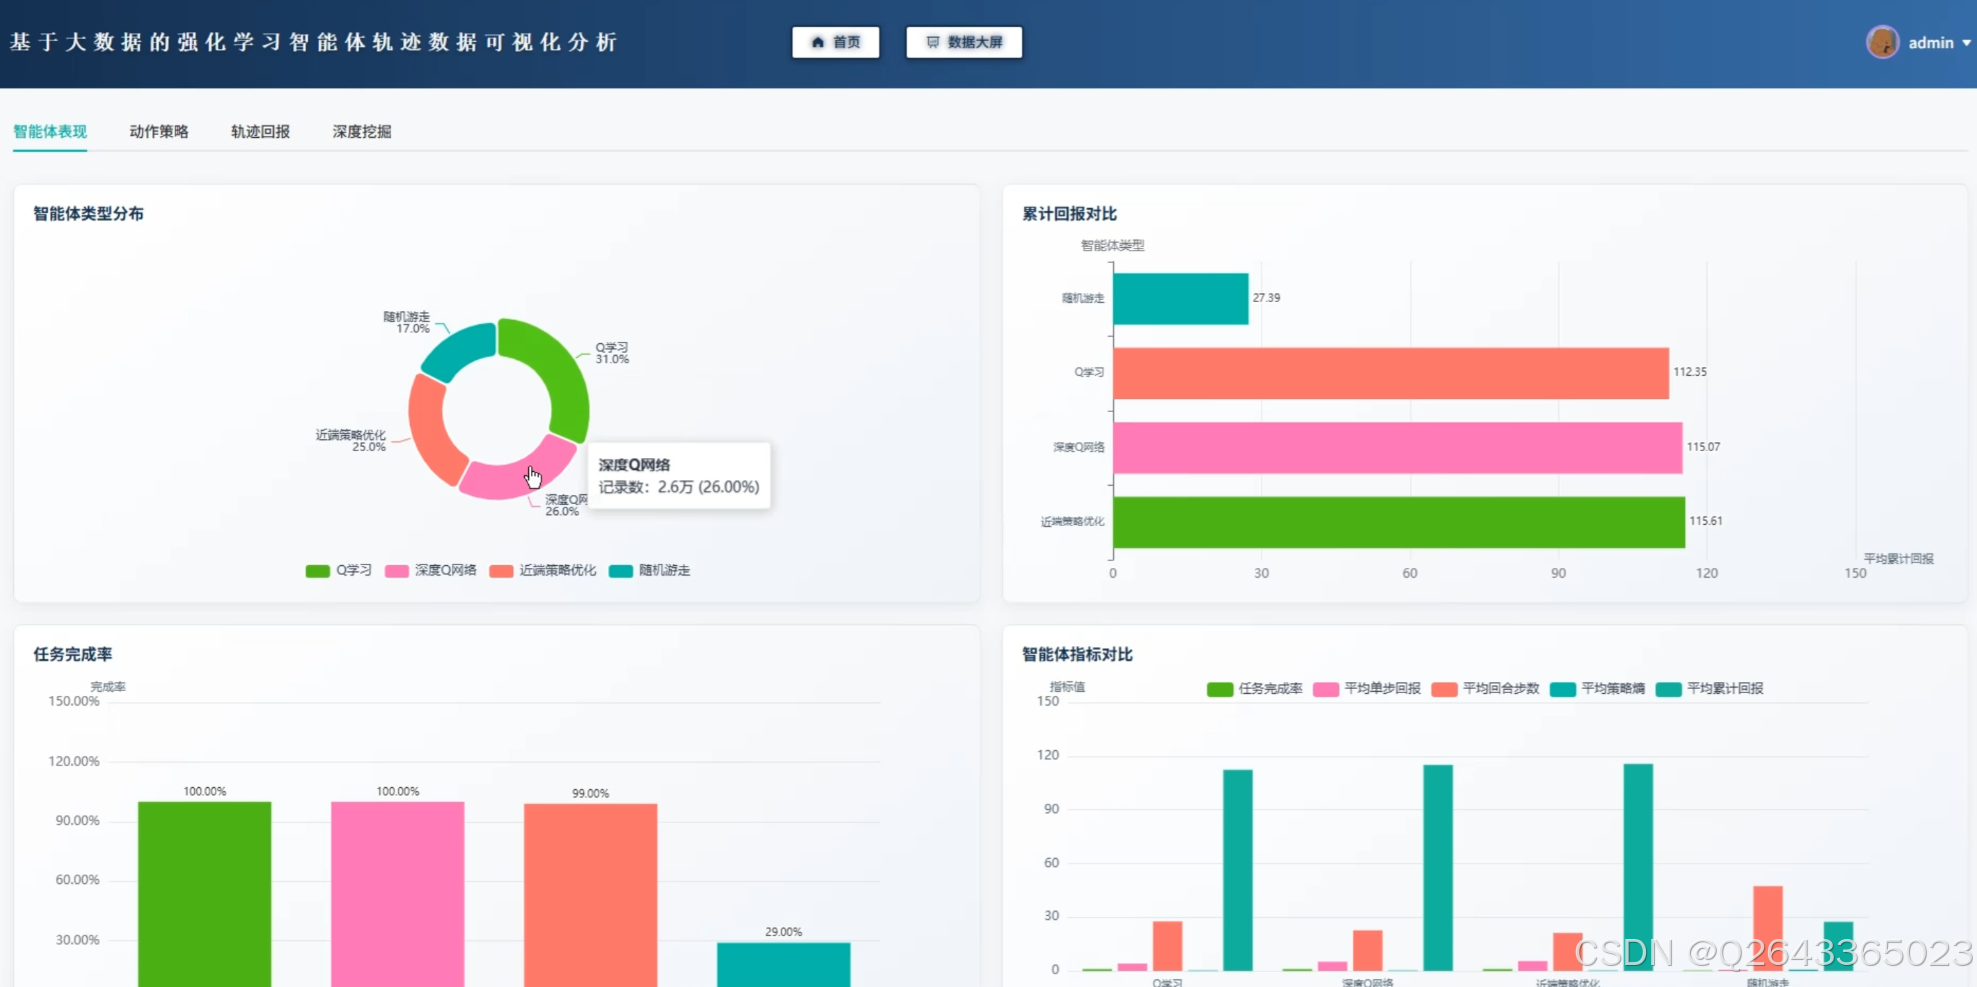
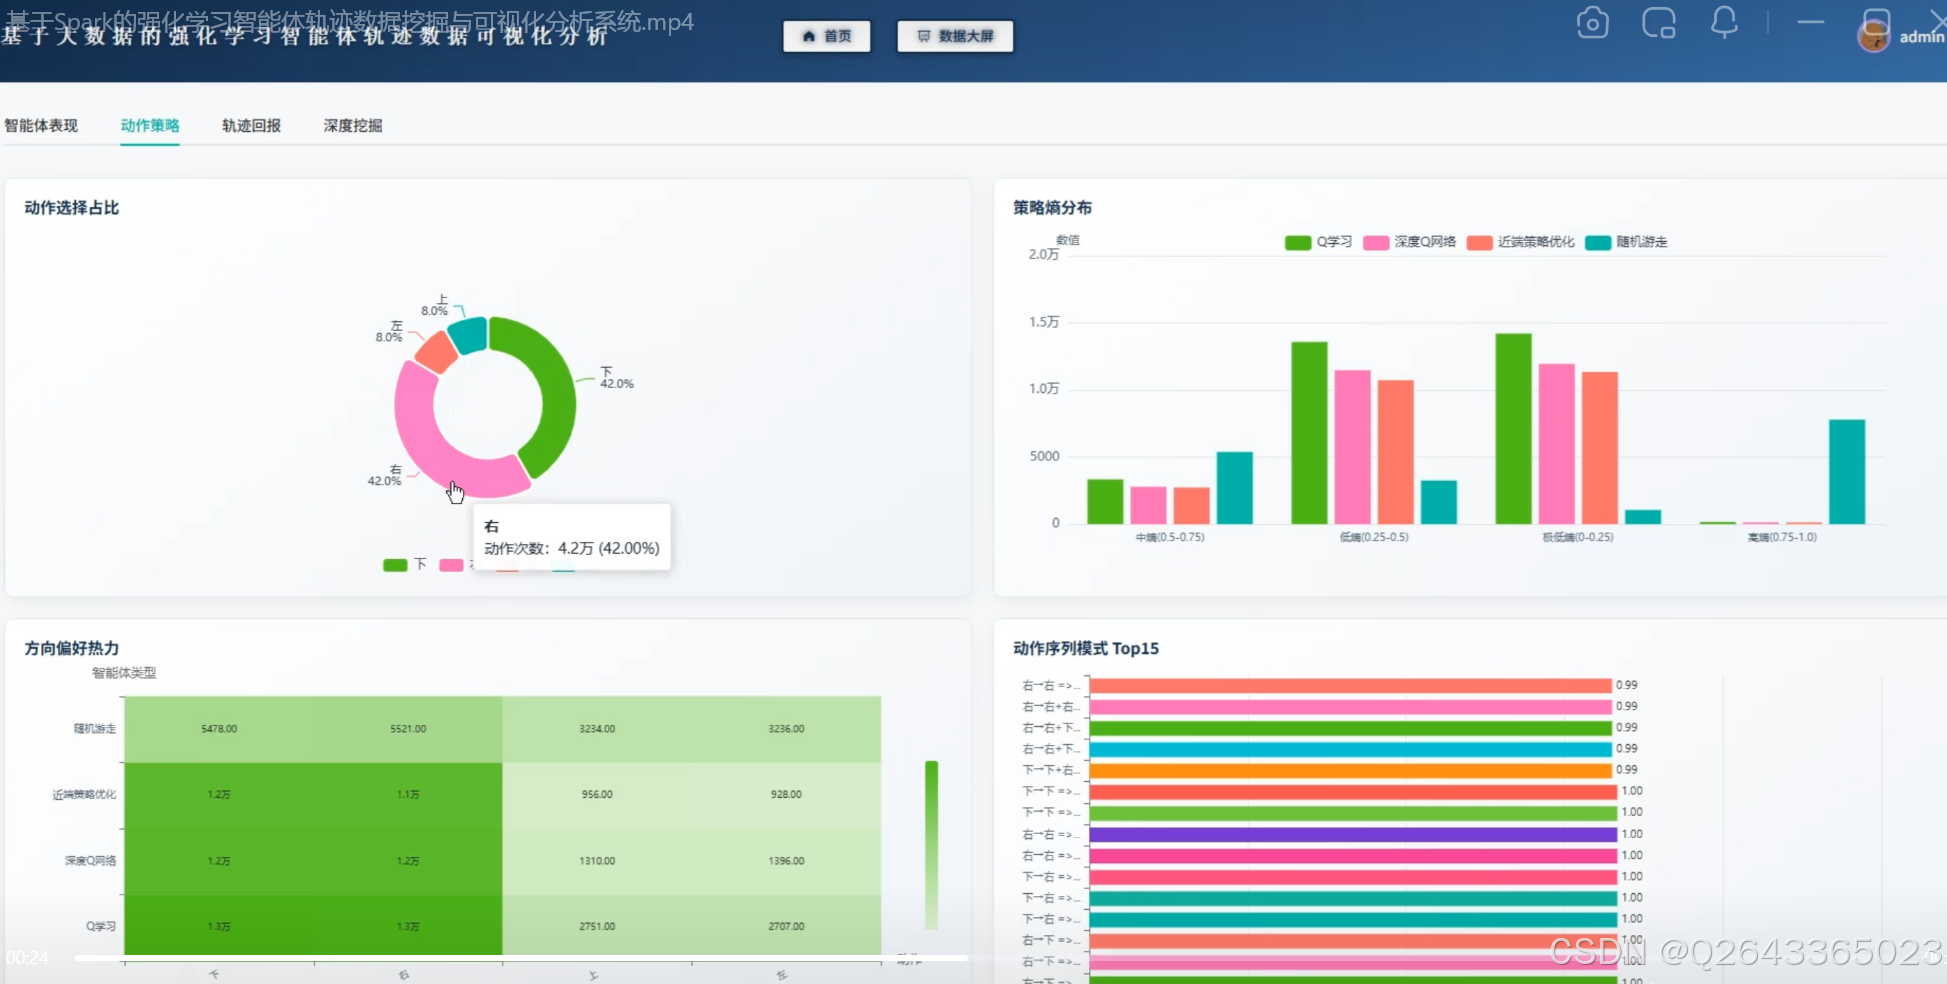
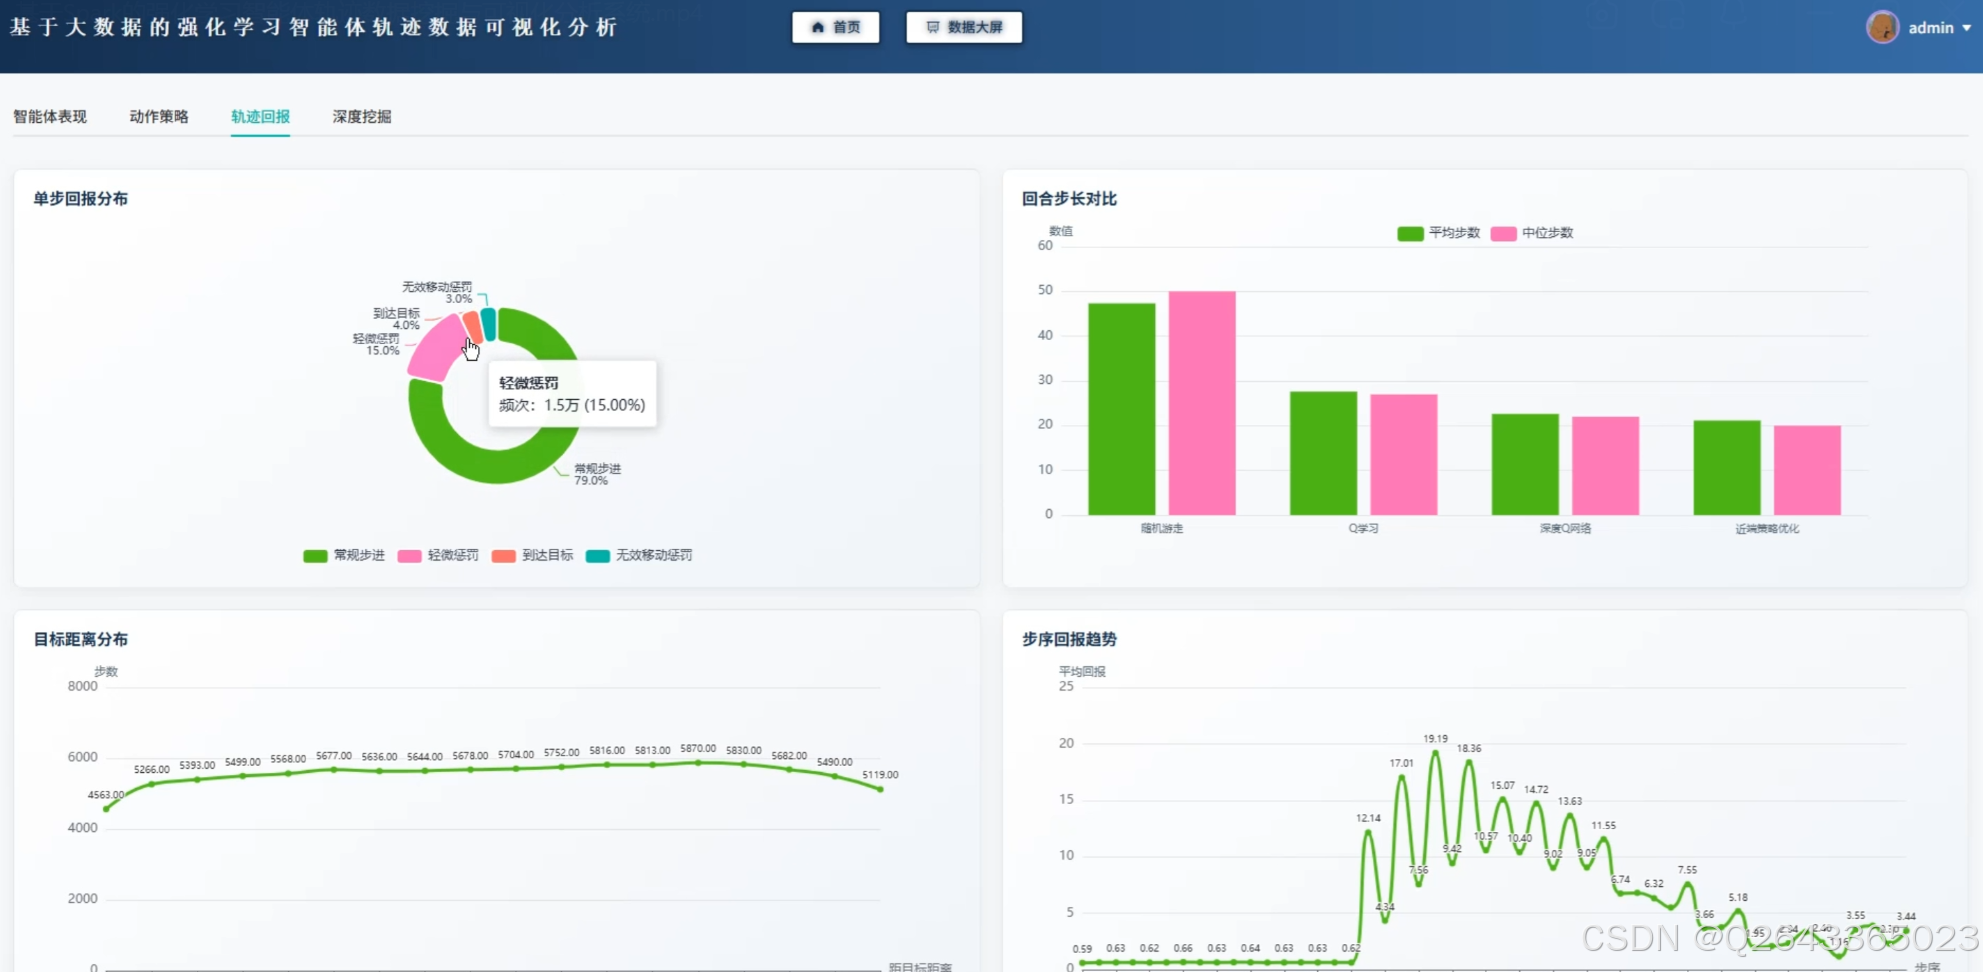
- 多智能体横向对比:围绕任务完成率、累计回报、策略熵、回合步长等核心指标,对四类智能体进行系统性横向对比,评估不同算法的优劣;
- 结果标准化输出:全部 16 项分析结果输出为独立 CSV 文件,字段规范、数值统一保留两位小数,直接对接后续可视化展示模块。
三、系统功能
- 数据接入与存储:一键上传原始轨迹数据至 Hadoop HDFS,自动重建项目目录结构,支持 SafeMode 检测与处理,实现数据分布式存储;
- 数据预处理:解析 JSON 格式的状态坐标信息,映射中英文类别标签(智能体类型、动作方向),统一数据类型,过滤解析失败记录,输出标准化清洗结果;
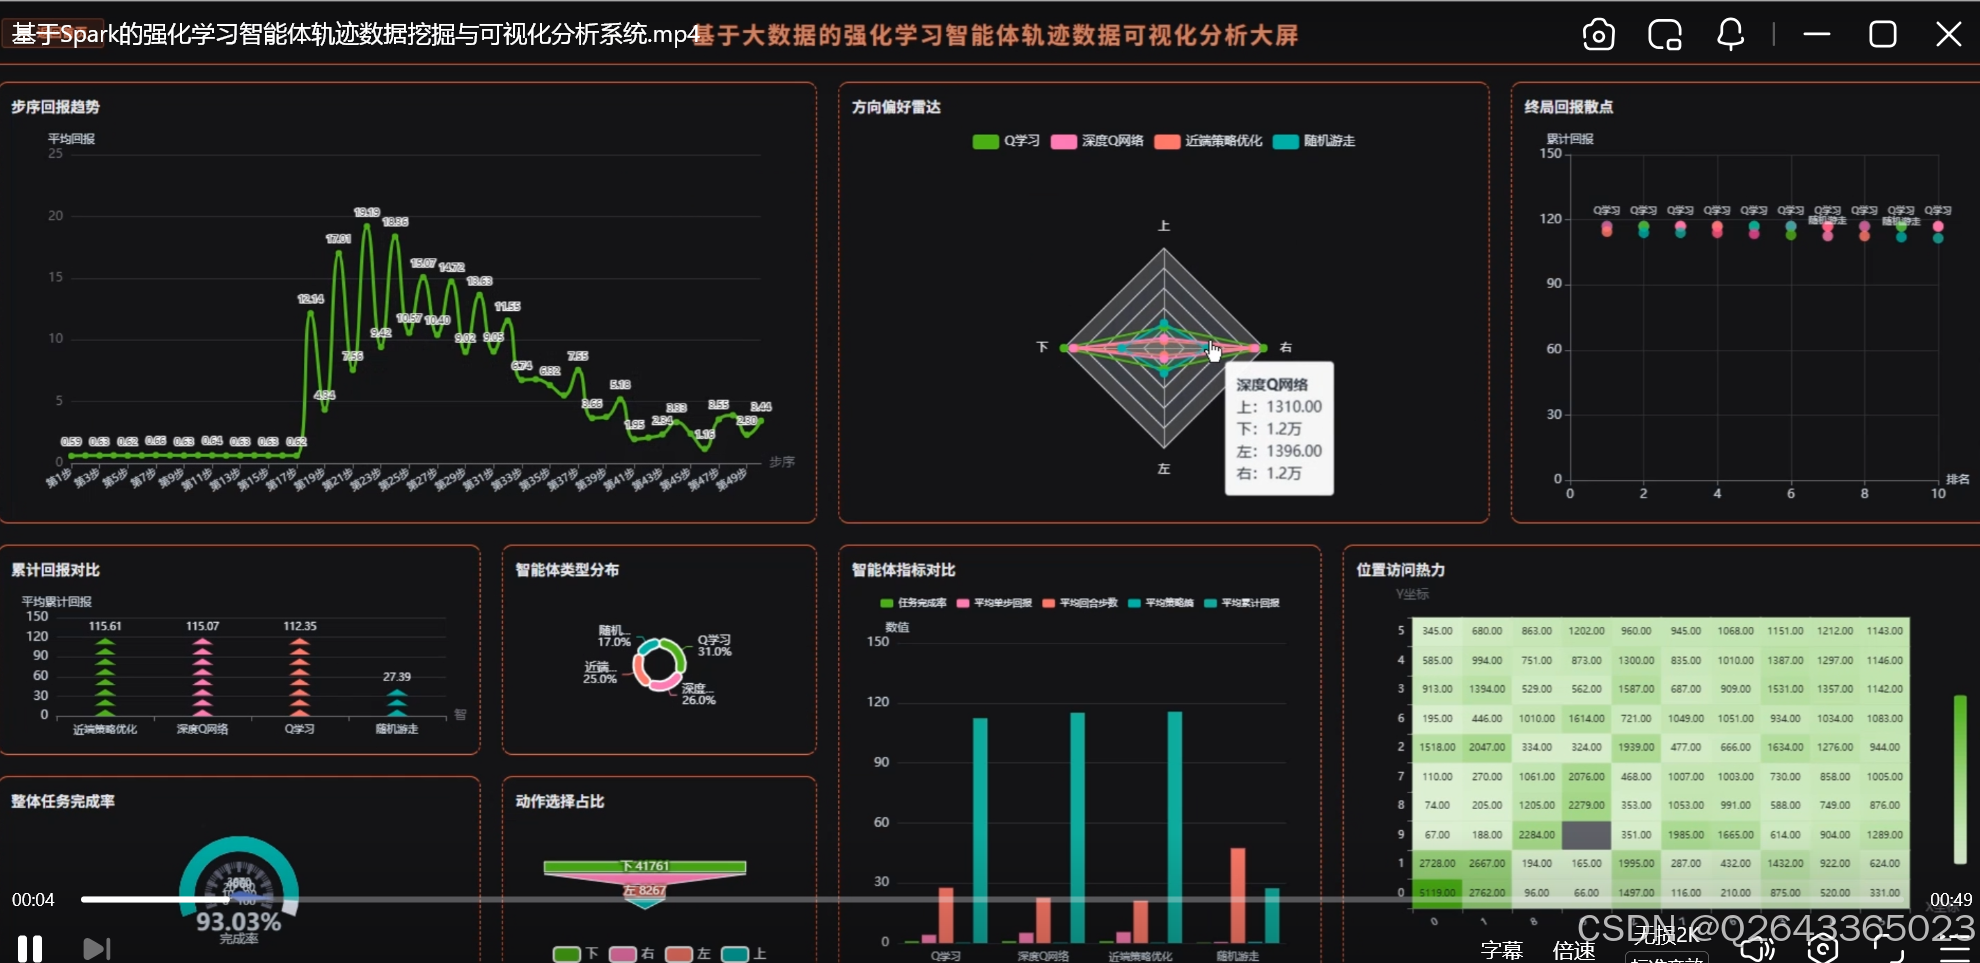
- 基础统计分析:智能体分布、动作选择率、单步回报分布、回合步长度统计、累计回报分析、策略熵分布、目标距离分布、步序回报趋势等;
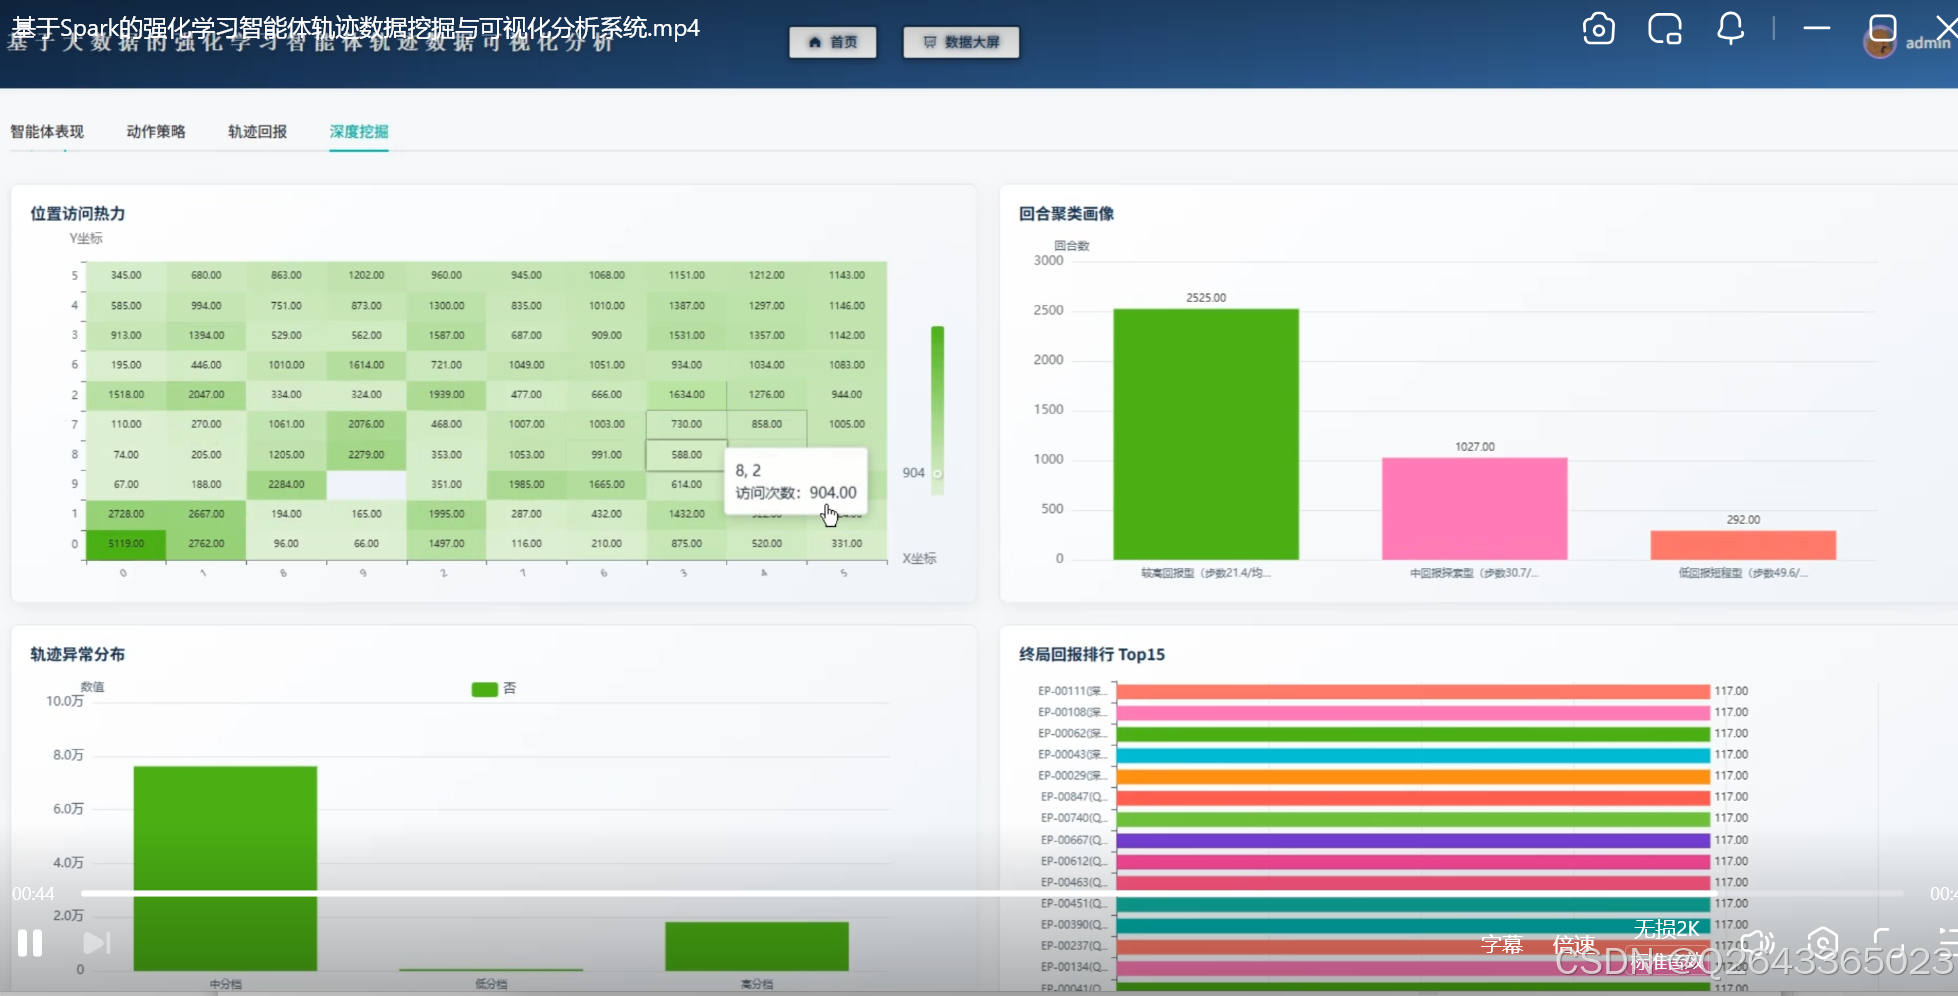
- 智能体性能评估:任务完成率统计、多指标长表对比、方向偏好分析、位置访问热力分析、终局回报 Top 榜单;
- 机器学习深度挖掘:基于 K-Means 的回合特征聚类画像(自动选择最优簇数)、基于 FP-Growth 的动作序列转移模式挖掘、基于 Isolation Forest 的轨迹异常点检测;
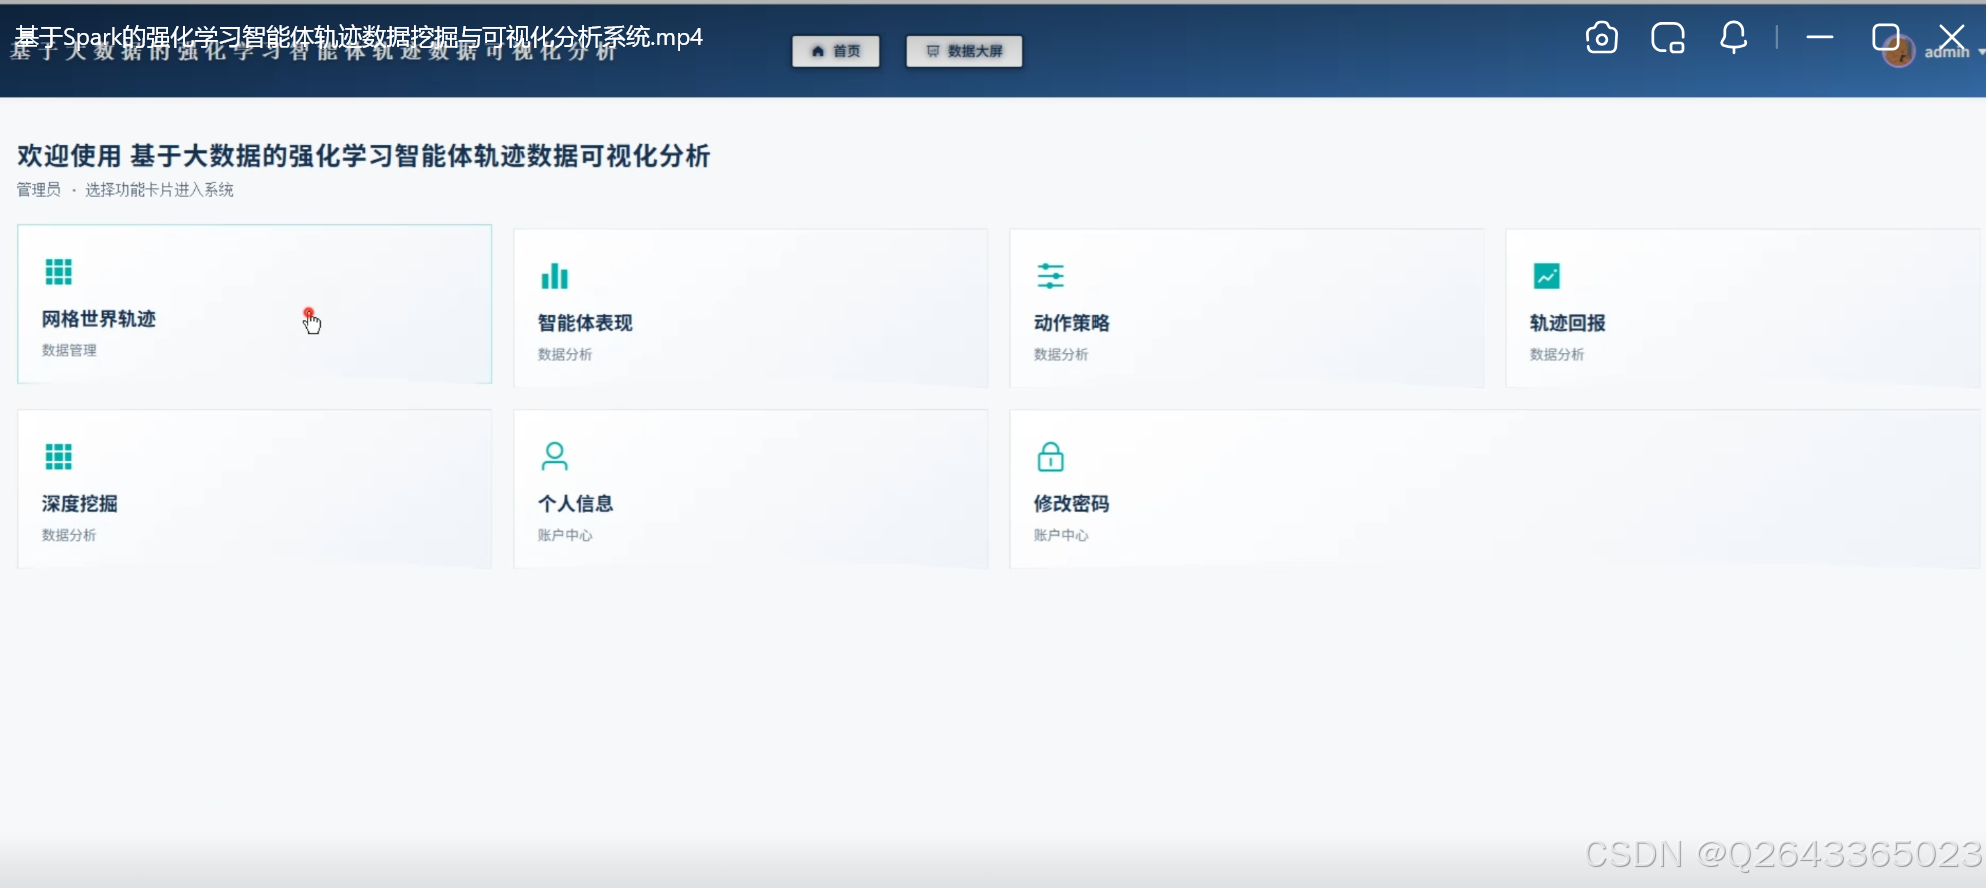
- 可视化数据支撑:全部分析结果以 CSV 格式独立输出,可直接对接 ECharts 等可视化组件进行图表展示。
四、技术环境
| 类别 | 技术选型 |
|---|---|
| 开发语言 | Python |
| 大数据平台 | Hadoop HDFS、PySpark |
| 机器学习库 | Scikit-learn(K-Means、Isolation Forest)、MLlib(FP-Growth) |
| 数据处理库 | Pandas、NumPy |
| 数据格式 | CSV、JSON |
| 操作系统 | Windows / Linux |
| 开发工具 | PyCharm |
五、项目展示
在这里插入图片描述