FPGA开发技巧--BRAM资源优化
前言
最近在优化之前一个项目的资源,总体来说是BRAM资源占用比较多,导致时序不太好收敛,那么我们就萌生了去优化BRAM资源的想法。
优化思路
在我们的项目里面有着大量位宽为128,深度为640的单端口BRAM。并且我们知道xilinx的BRAM可以配置为两个18kbit或一个36kbit。
那么对于我们项目中这种规格的BRAM理论上需要占用的BRAM个数为
128∗64036∗1024=2.2 \frac{128*640}{36*1024}=2.2 36∗1024128∗640=2.2
但是实际占用是4个36k的BRAM。
所以我们可以想办法去优化这种规格的BRAM。
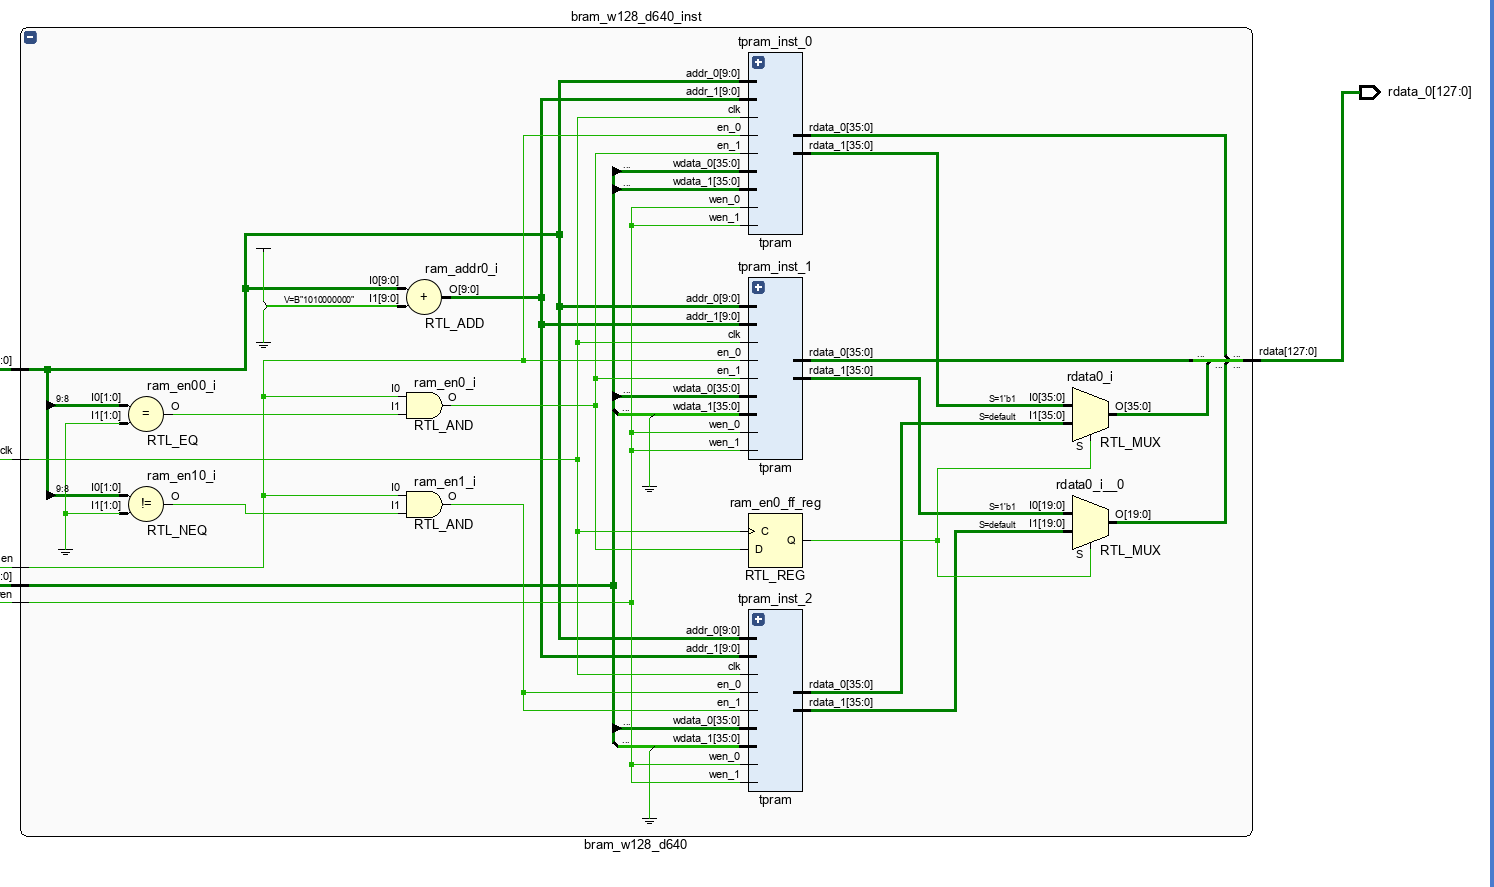
我们可以想到一个xilinx的BRAM位宽是36bit,深度是1024,那么就可以使用这个BRAM的双端口模式来拼接完成一个128*640的单端口BRAM。
比如使用0号BRAM的0-639深度,完成一个36*640规格的RAM,使用1号BRAM的0-639深度,完成第二个36*640规格的RAM,这样我们就有了一个72*640规格的RAM。此时注意到0号和1号BRAM的640-1023深度其实并没有被使用到,那么我们就能利用这部分地址来完成剩余的拼接,但是这个时候剩余的深度只有384不足以完成640深度的RAM,所以我们引入2号BRAM。这样在0号BRAM的640-1024,2号BRAM的0-255,这么多地址空间就能完成一个36*640的RAM,这样我们就完成了108*640的RAM拼接,同理我们可以利用1号RAM的剩余地址和2号RAM的剩余地址完成剩下的20*640的RAM。
这样我们就使用3个RAM完成了128*640的BRAM,相比于之前的方案减少了一个BRAM的占用。虽然这里个数比较少,但是我整个工程中用到这种规格BRAM的地方非常多,所以整体下来BRAM减少了很多。
整体的结构图如下,就是三个BRAM来进行拼接
实际代码
verilog
module bram_w128_d640 (
    input                  clk  ,
    input        [127 : 0] wdata,
    input                  wen  ,
    input        [9 : 0]   addr ,
    input                  en   ,
    output       [127 : 0] rdata
);

wire [9:0] ram_addr0;
wire [9:0] ram_addr1;

assign ram_addr0 = addr + 10'd640;
assign ram_addr1 = addr;

wire ram_en0;
wire ram_en1;

reg ram_en0_ff;

assign ram_en0 = en & (addr[9:8] == 2'b00);
assign ram_en1 = en & (addr[9:8] != 2'b00);

always @(posedge clk ) begin
    ram_en0_ff <= ram_en0;
end

wire [35:0] rdata0;
wire [35:0] rdata2;
wire [35:0] rdata1;
wire [35:0] rdata3;

assign rdata[107:72]  = ram_en0_ff ? rdata0 : rdata2;
assign rdata[127:108] = ram_en0_ff ? rdata1[19:0] : rdata3[19:0];

tpram #(
    .DP   (1024),
    .DW   (36),
    .PIPE (1)
) tpram_inst_0 (
    .clk      (clk        ),
    .wdata_0  (wdata[35:0]),
    .wen_0    (wen        ),
    .addr_0   (addr       ),
    .en_0     (en         ),
    .rdata_0  (rdata[35:0]),
    .wdata_1  (wdata[107:72]),
    .wen_1    (wen        ),
    .addr_1   (ram_addr0  ),
    .en_1     (ram_en0    ),
    .rdata_1  (rdata0     )
);

tpram #(
    .DP   (1024),
    .DW   (36),
    .PIPE (1)
) tpram_inst_1 (
    .clk      (clk         ),
    .wdata_0  (wdata[71:36]),
    .wen_0    (wen         ),
    .addr_0   (addr        ),
    .en_0     (en          ),
    .rdata_0  (rdata[71:36]),
    .wdata_1  ({16'd0, wdata[127:108]}),
    .wen_1    (wen        ),
    .addr_1   (ram_addr0  ),
    .en_1     (ram_en0    ),
    .rdata_1  (rdata1     )
);

tpram #(
    .DP   (1024),
    .DW   (36),
    .PIPE (1)
) tpram_inst_2 (
    .clk      (clk          ),
    .wdata_0  (wdata[107:72]),
    .wen_0    (wen          ),
    .addr_0   (ram_addr1    ),
    .en_0     (ram_en1      ),
    .rdata_0  (rdata2       ),
    .wdata_1  ({16'd0, wdata[127:108]}),
    .wen_1    (wen           ),
    .addr_1   (ram_addr0     ),
    .en_1     (ram_en1       ),
    .rdata_1  (rdata3        )
);

endmodule
注意到这里,我并不是在0号和1号BRAM里面利用了384深度,而是利用了256深度。在2号RAM里面利用了更多的地址空间。
测试代码如下
verilog
module tb_top (

);

reg clk;

initial begin
    clk = 1'b0;
    forever begin
        clk = #5 !clk;
    end
end

reg [127:0] wdata;
reg         wen  ;
reg [9:0]   addr ;
reg         en   ;

reg rd_valid;

wire [127:0] rdata_0;
wire [127:0] rdata_1;

initial begin
    wdata <= 128'd0;
    wen   <=   1'd0;
    addr  <=  10'd0;
    en    <=   1'd0;
    repeat(20) @(posedge clk);
    wdata <= {$random, $random, $random, $random};
    wen   <=   1'd1;
    addr  <=  10'd0;
    en    <=   1'd1;
    repeat(639)begin
        @(posedge clk);
        wdata <= {$random, $random, $random, $random};
        wen   <=   1'd1;
        addr  <=  addr + 10'd1;
        en    <=   1'd1;
    end
    @(posedge clk);
    wdata <= 128'd0;
    wen   <=   1'd0;
    addr  <=  10'd0;
    en    <=   1'd0;
    @(posedge clk);
    addr  <=  10'd0;
    en    <=   1'd1;
    repeat(639)begin
        @(posedge clk);
        addr  <=  addr + 10'd1;
        en    <=   1'd1;
    end
    @(posedge clk);
    addr  <=  10'd0;
    en    <=   1'd0;
    repeat(20) @(posedge clk);
    $display("sim success");
    $finish;
end

always @(posedge clk ) begin
    rd_valid <= en & (!wen);
end

initial begin
    forever begin
        @(posedge clk)begin
            if(rd_valid)begin
                if(rdata_0 != rdata_1)begin
                    $display("sim error rdata_0 : %h, rdata_1 : %h\n", rdata_0, rdata_1);
                    $finish;
                end
                else begin
                    $display("sim success rdata_0 : %h, rdata_1 : %h\n", rdata_0, rdata_1);
                end
            end
        end
    end
end

top top_inst(
    .clk     (clk    ),
    .wdata   (wdata  ),
    .wen     (wen    ),
    .addr    (addr   ),
    .en      (en     ),
    .rdata_0 (rdata_0),
    .rdata_1 (rdata_1)
);
endmodule
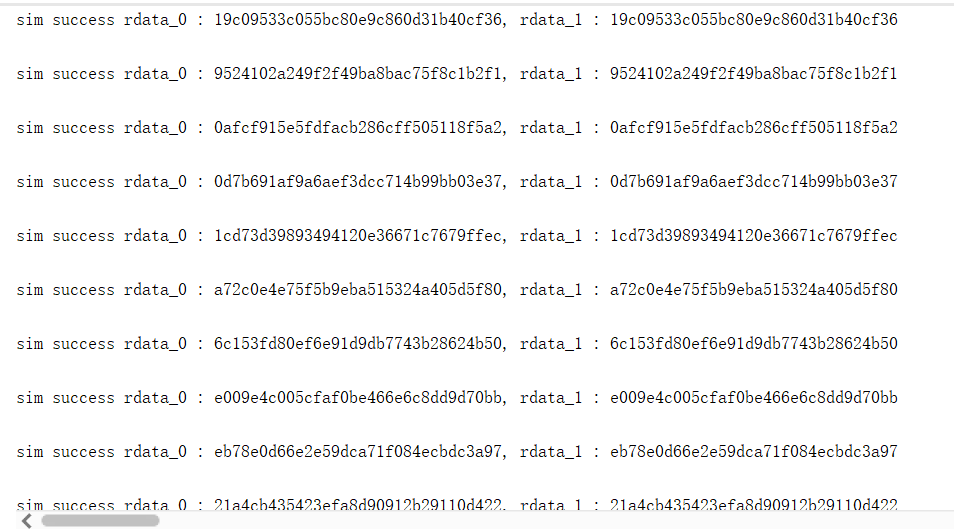
仿真结果如下
资源占用如下
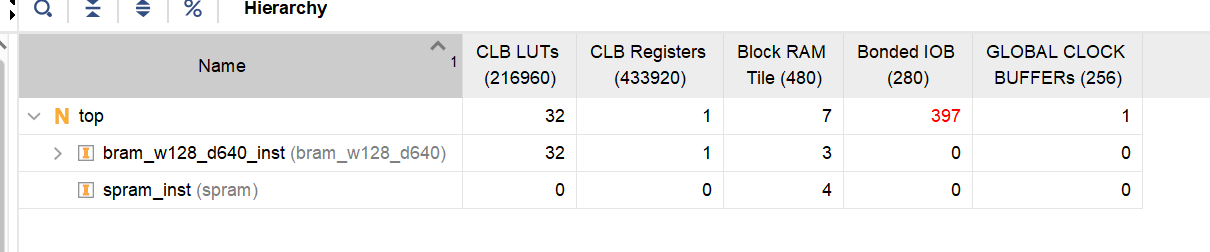
可以看到第一种方案占用了32个LUT,一个FF,3个BRAM
第二种直接使用Xilinx IP核的方案占用了4个BRAM