一、DataHub 出现的背景
传统的数据目录通常解决的是"登记"和"搜索"问题:有哪些表、有哪些字段、谁创建的、文档在哪里。随着数据平台规模扩大,仅靠静态目录会遇到几个明显瓶颈。
第一,数据资产数量增长很快。一个企业可能同时使用 Hive、Iceberg、Snowflake、BigQuery、Kafka、dbt、Airflow、Spark、Tableau、Looker、Superset 等工具。
第二,数据上下文变化很快。字段新增、表废弃、owner 变更、任务依赖调整、指标口径更新、质量状态波动,都是高频事件。如果目录系统只能靠人工维护,很快就会失真。
第三,数据治理从"文档治理"转向"运行时治理"。例如,当某个公开数据集新增了 PII 字段,治理系统最好能实时感知并触发访问控制或审查流程。
二、DataHub 的核心定位
DataHub 是一个面向现代数据栈的开源元数据平台,支持 Data Discovery、Collaboration、Governance 和 end-to-end Observability,并采用 model-first 的理念,以便在不同工具和系统之间释放互操作能力 。因此,DataHub 的定位更接近"元数据中枢",而不是单纯的数据目录页面。
可以把 DataHub 理解为三层能力的组合:
| 层次 | 解决的问题 | DataHub 中的体现 |
|---|---|---|
| 数据资产目录 | 数据在哪里、叫什么、怎么搜索 | Dataset、Dashboard、Chart、Data Job、Data Flow 等实体 |
| 元数据图谱 | 资产之间是什么关系 | Entity、Aspect、Relationship、URN、血缘 |
| 治理与自动化 | 如何让元数据参与实际管理流程 | 标签、术语、Owner、Domain、Policy、Actions、事件订阅 |
DataHub 的关键思想是:把元数据当作可建模、可查询、可订阅、可治理的生产级数据,而不是附属文档。
三、架构原理
DataHub 的整体架构可以概括为:数据源通过采集框架或 SDK 产生元数据变更,元数据服务写入存储,并通过 Kafka 事件驱动搜索索引、图索引、动作框架和外部订阅系统更新。
sql
                +-----------------------------+
                |        数据源与工具生态       |
                |-----------------------------|
                | DB / Lake / Warehouse       |
                | BI / Dashboard / Chart      |
                | dbt / Airflow / Spark       |
                | Kafka / ML / Quality Tools  |
                +--------------+--------------+
                               |
                               | Pull / Push
                               v
+------------------+    +------+-------+     +------------------+
| CLI / YAML Recipe|    | SDK / API    |     | UI Ingestion     |
| 批式采集          |    | 程序化写入    |     | 页面配置采集       |
+--------+---------+    +------+-------+     +---------+--------+
         |                     |                       |
         +---------------------+-----------------------+
                               |
                               v
                  +------------+-------------+
                  | Metadata Service / GMS   |
                  | 元数据写入、校验、查询      |
                  +------+-----------+-------+
                         |           |
                         |           |
              +----------v--+     +--v----------------+
              | Metadata DB |     | Kafka Metadata    |
              | 持久化 Aspect|     | Events            |
              +-------------+     +--+----------------+
                                    |
                                    v
                 +------------------+------------------+
                 | Search Index / Graph Index / Actions |
                 | 搜索、关系遍历、血缘、自动化响应       |
                 +------------------+------------------+
                                    |
                                    v
                      +-------------+-------------+
                      | Web UI / GraphQL / REST   |
                      | 搜索、治理、血缘、集成调用   |
                      +---------------------------+
1.元数据模型
DataHub 采用 schema-first 的元数据建模方式,它使用 LinkedIn 的 Pegasus schema language,也就是 PDL,并扩展了一组注解来建模元数据;存储、服务、索引和采集层都直接建立在这个元数据模型之上,从客户端到存储层保持强类型 。
它的模型可以用四个关键词理解:Entity、Aspect、Relationship、URN。
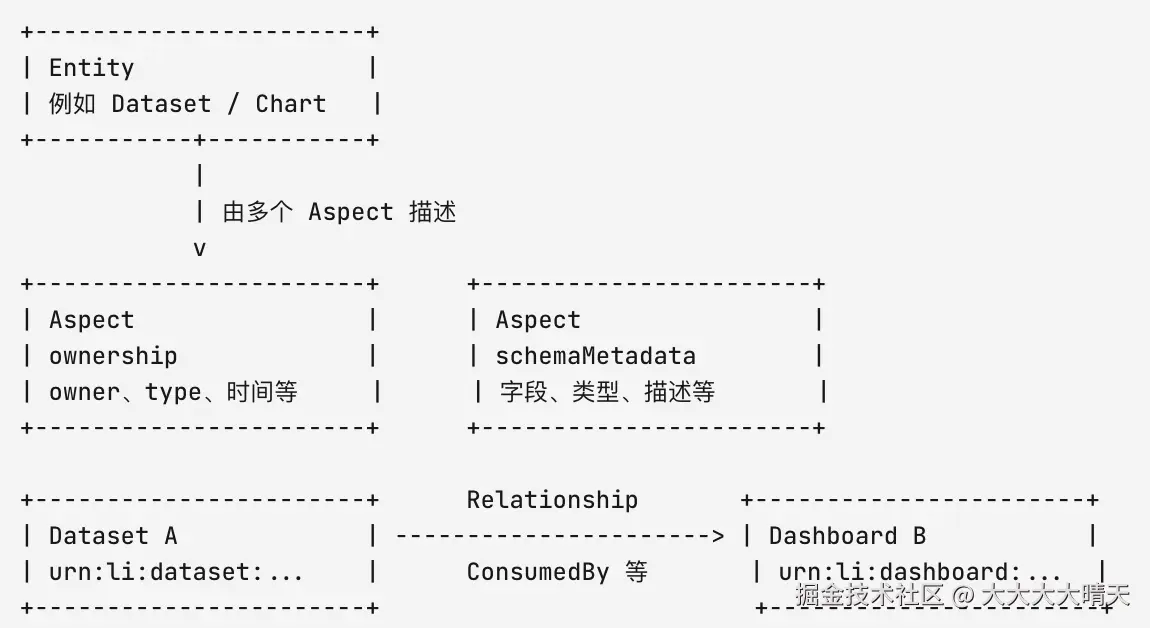
其中:
| 概念 | 含义 | 示例 |
|---|---|---|
| Entity | 元数据图谱中的主节点 | Dataset、Chart、Dashboard、CorpUser、DataJob |
| Aspect | 描述 Entity 某个侧面的属性集合,也是 DataHub 中最小的原子写入单位 | ownership、globalTags、glossaryTerms、status |
| Relationship | 两个 Entity 之间的命名边,可以双向遍历 | OwnedBy、Contains |
| URN | Entity 的字符串化唯一标识 | urn:li:dataset:(...) |
Aspect 是 DataHub 中最小的原子写入单位,多个 Aspect 可以独立更新;Relationship 通过 Aspect 中的外键属性和 @Relationship 注解声明,并支持双向遍历 。
2.事件机制
DataHub 的实时性主要依赖元数据事件:Metadata Change Proposal、Metadata Change Log、Platform Event 等,这些事件最初使用 PDL 定义,并转换为 Avro 后写入或读取 Kafka。典型链路如下:
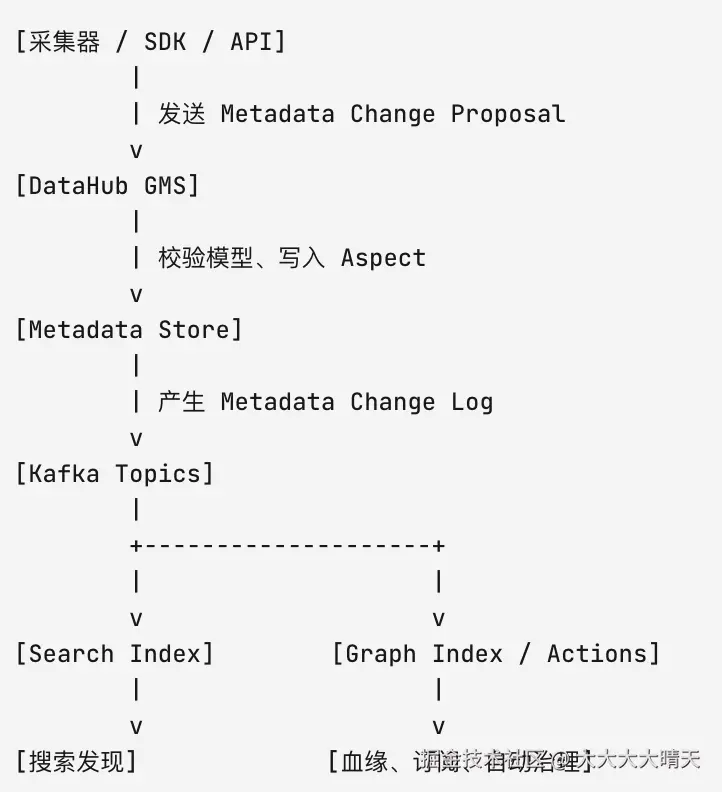
Metadata Change Proposal 可以理解为"请求变更某个 Entity 的某个 Aspect";Metadata Change Log 表示已经写入元数据图谱的变更;Platform Event 则表示 DataHub 在业务逻辑层产生的事件,例如 Entity Change Event。这套事件模型让 DataHub 不只是保存元数据,还能把元数据变化传播给搜索、图谱、自动化和外部系统。
3.采集方式
DataHub 的采集方式可以用 Pull 和 Push 两类理解。
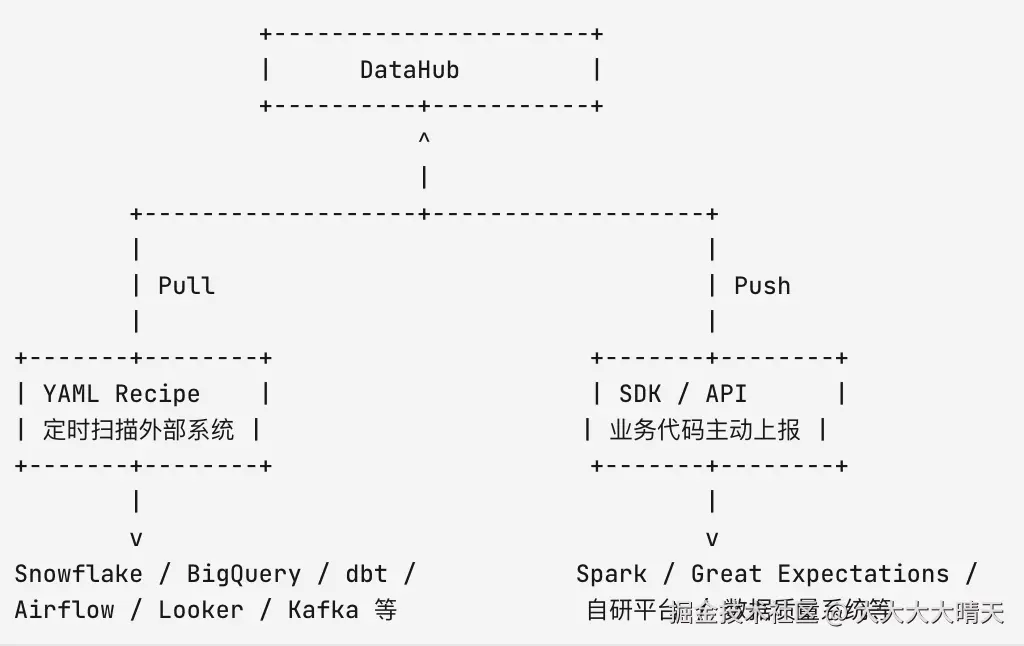
Pull-based 集成适合周期性扫描已有系统,例如 Snowflake、BigQuery、dbt、Looker、Airflow 等;Push-based 集成适合在代码运行过程中主动上报元数据,例如通过 Python SDK、Java SDK、Spark、Great Expectations 等方式写入 。
常见落地路线是:先用 CLI + YAML recipe 接入核心数仓和调度系统,再逐步通过 SDK 将自研平台、数据质量结果、指标平台和审批流程中的元数据写入 DataHub。
四、功能特性
DataHub 的功能可以分为数据发现、血缘分析、治理协作、采集集成、API 与自动化几类。
| 功能 | 说明 | 价值 |
|---|---|---|
| 数据搜索与发现 | 在统一目录中搜索 Dataset、Dashboard、Chart 等资产 | 快速定位数据资产,减少重复建表和口径误用 |
| 元数据采集 | 支持从数据库、数仓、BI、调度、流系统等采集元数据 | 让平台资产自动进入目录 |
| 血缘分析 | 支持上游和下游依赖分析 | 评估变更影响,辅助故障定位 |
| Owner 与文档 | 为资产维护负责人、说明、链接、机构记忆等 | 降低跨团队沟通成本 |
| 标签与术语 | 支持 Tags、Glossary Terms 等治理语义 | 标识敏感字段、核心指标、业务主题 |
| API 与 SDK | 支持 GraphQL、OpenAPI、Python SDK、Java SDK、CLI | 方便与平台工程、CI/CD、数据治理流程集成 |
| 事件订阅 | 基于元数据事件驱动外部动作 | 构建自动治理、通知、审计和质量联动 |
DataHub 的 ingestion framework 和 CLI 可从 50+ 数据源拉取元数据,也可以通过 Python 或 Java SDK 将元数据从自有管道和应用中推送到目录;采集方式包括 CLI + YAML recipe、Python SDK、Java SDK 和 UI Ingestion 。
DataHub 的优势不在于某一个单点功能,而在于它把数据发现、元数据建模、血缘、治理和事件机制放在同一个体系中。
- 模型清晰:Entity、Aspect、Relationship 和 URN 让 DataHub 能够表达复杂数据资产及其关系。相比只存表名、字段名和描述的目录系统,这种图谱模型更适合表达"表由哪个任务产出""报表依赖哪些数据集""字段属于哪个业务术语"等关系。
- 实时性较好:DataHub 是 stream-oriented,元数据变化可以在数秒内反映到平台中,也可以被外部系统订阅 。这让它适合承载访问控制联动、敏感字段发现、质量告警传播、变更影响通知等场景。
- 集成面广:支持 Snowflake、BigQuery、Redshift、dbt、Databricks、Looker、Tableau、Power BI、Airflow、Spark、Kafka、PostgreSQL、MySQL、Hive、Glue、S3、Iceberg、Unity Catalog 等来源 ,这对异构大数据平台尤其重要。
- 面向工程化:DataHub 支持 CLI、GraphQL、OpenAPI、Python SDK、Java SDK 等接口,这意味着它不是只能靠 UI 人工维护,而是可以纳入平台工程体系。
五、适用场景
DataHub 适合数据资产复杂、团队协作频繁、治理要求较高的组织。尤其是当数据平台已经从单一 Hive 或数仓演进到湖仓、BI、调度、质量、指标、机器学习并存时,DataHub 的价值会更明显。
| 场景 | DataHub 的作用 |
|---|---|
| 数据资产盘点 | 汇总多个系统中的表、视图、文件、Topic、报表、任务 |
| 数据血缘治理 | 分析表、字段、任务、报表之间的上下游关系 |
| 变更影响分析 | 修改字段、下线表、调整任务前识别受影响对象 |
| 数据治理 | 标注 Owner、标签、术语、Domain、敏感信息 |
| 数据质量联动 | 把质量结果、Profile、运行状态写入资产上下文 |
| 平台自助服务 | 让业务和分析人员通过搜索、文档、血缘自行理解数据 |
| AI 数据上下文 | 为 AI Agent 提供可信的数据目录、字段、血缘和语义上下文 |
但 DataHub 不一定适合所有团队。如果团队规模较小、数据源单一、资产数量有限,并且主要痛点只是"写几份表说明",那么直接维护轻量文档或数仓内置 Catalog 可能成本更低。
六、部署使用
DataHub 部署支持 Self-hosted via Docker、Kubernetes Helm,其中 Docker 适合开发和小团队,Kubernetes Helm 推荐用于生产级自托管部署 。
本地体验最常见的方式是 Docker Quickstart:
bash
# macOS / Linux
brew install datahub-project/tap/datahub

# 或使用 pip
python3 -m pip install --upgrade acryl-datahub

# 启动本地 DataHub
datahub docker quickstart启动后,可通过http://localhost:9002访问 DataHub Web 应用,默认账号密码为datahub / datahub。
一个典型的 Snowflake 采集 recipe 形态如下:
yaml
source:
  type: snowflake
  config:
    account_id: my_account
    username: my_user
    password: my_password
    role: DATAHUB_ROLE
    warehouse: COMPUTE_WH

sink:
  type: datahub-rest
  config:
    server: http://localhost:8080
执行采集:
r
datahub ingest -c snowflake_recipe.yml除了 CLI + YAML recipe,DataHub 还支持 Python SDK、Java SDK 和 UI Ingestion;其中 UI Ingestion 可在 DataHub UI 的 Ingestion 页面配置并运行。
七、工程落地建议
建议不要一开始就把 DataHub 当作"全量治理平台"推进,而是从高价值资产入手。
第一阶段可以接入核心数仓、调度系统和 BI 系统。目标是让用户能查到表、字段、负责人、文档和基础血缘。
第二阶段可以接入 dbt、数据质量平台、指标平台和权限系统。目标是让 DataHub 从"能搜"变成"可信"。
第三阶段可以基于事件和 API 做自动化治理。例如,当高价值表缺失 Owner、核心字段缺少描述、敏感字段进入公开数据集、下游报表依赖废弃表时,自动触发提醒、审批或修复流程。
一个较稳妥的路线如下:
rust
阶段 1:资产可见
数据源接入 -> 表字段采集 -> Owner/描述补齐 -> 搜索可用

阶段 2:关系可信
调度接入 -> dbt 接入 -> BI 接入 -> 血缘可用

阶段 3:治理联动
标签/术语 -> 质量结果 -> 事件订阅 -> 自动化动作

阶段 4:平台化
API 集成 -> 自研系统写入 -> AI Agent 使用元数据上下文