Redis基础入门:Redis是什么、为什么快以及核心特性详解
- Redis基础入门:Redis是什么、为什么快以及核心特性详解
- [一、什么是 Redis?](#一、什么是 Redis?)
- [二、Redis 是 Key-Value 型数据库](#二、Redis 是 Key-Value 型数据库)
- [三、Redis 的 Value 不只是字符串](#三、Redis 的 Value 不只是字符串)
- [四、Redis 是基于内存运行的](#四、Redis 是基于内存运行的)
- [五、Redis 为什么这么快?](#五、Redis 为什么这么快?)
- 六、原因一:基于内存操作
- 七、原因二:高效的数据结构
- [八、原因三:IO 多路复用](#八、原因三:IO 多路复用)
- [九、Redis 是单线程吗?](#九、Redis 是单线程吗?)
- [十、"单线程"不等于整个 Redis 只有一个线程](#十、“单线程”不等于整个 Redis 只有一个线程)
- 十一、单线程为什么还能这么快?
- [十二、Redis 命令为什么具有原子性?](#十二、Redis 命令为什么具有原子性?)
- [十三、既然数据在内存中,Redis 重启后数据怎么办?](#十三、既然数据在内存中,Redis 重启后数据怎么办?)
- [十四、RDB 持久化](#十四、RDB 持久化)
- [十五、AOF 持久化](#十五、AOF 持久化)
- [十六、Redis 支持主从复制](#十六、Redis 支持主从复制)
- 十七、主从结构有什么作用?
- [十八、Redis 支持分片集群](#十八、Redis 支持分片集群)
- 十九、主从与分片解决的问题不同
- [二十、Redis 支持多语言客户端](#二十、Redis 支持多语言客户端)
- [二十一、Redis 的核心特点](#二十一、Redis 的核心特点)
- [二十二、Redis 和 MySQL 是什么关系?](#二十二、Redis 和 MySQL 是什么关系?)
- [二十三、Redis 为什么经常被用作缓存?](#二十三、Redis 为什么经常被用作缓存?)
- [二十四、Redis 常见应用场景](#二十四、Redis 常见应用场景)
- [二十五、Redis 整体工作模型](#二十五、Redis 整体工作模型)
- 二十六、几个容易产生误解的地方
-
- [1. Redis 基于内存,所以数据一定会丢失?](#1. Redis 基于内存,所以数据一定会丢失?)
- [2. Redis 是单线程,所以性能低?](#2. Redis 是单线程,所以性能低?)
- [3. Redis 整个程序只有一个线程?](#3. Redis 整个程序只有一个线程?)
- [4. Redis 就是缓存?](#4. Redis 就是缓存?)
- [5. Redis 可以完全替代 MySQL?](#5. Redis 可以完全替代 MySQL?)
- 二十七、常见面试问题
-
- [Q1:Redis 是什么?](#Q1:Redis 是什么?)
- [Q2:Redis 为什么快?](#Q2:Redis 为什么快?)
- [Q3:Redis 是单线程的吗?](#Q3:Redis 是单线程的吗?)
- [Q4:Redis 的单条命令为什么具有原子性?](#Q4:Redis 的单条命令为什么具有原子性?)
- [Q5:Redis 数据在内存中,如何防止重启后全部丢失?](#Q5:Redis 数据在内存中,如何防止重启后全部丢失?)
- [Q6:Redis 如何提高可用性?](#Q6:Redis 如何提高可用性?)
- [Q7:Redis 如何突破单机内存限制?](#Q7:Redis 如何突破单机内存限制?)
- 二十八、总结
Redis基础入门:Redis是什么、为什么快以及核心特性详解
在了解 NoSQL 的基本概念之后,接下来就可以正式认识 Redis。
Redis 是后端开发中使用非常广泛的一种 NoSQL 数据库,在缓存、分布式系统、排行榜、计数器、Session 共享、消息通信等场景中都十分常见。
想要进一步掌握 Redis,首先需要弄清楚几个基础问题:
text
Redis 到底是什么?

Redis 中的数据如何存储?

Redis 为什么这么快?

Redis 所说的"单线程"是什么意思?

Redis 数据放在内存中,宕机后怎么办?

Redis 能否组成集群?
本文就从这些问题入手,建立 Redis 的整体认识。
一、什么是 Redis?
Redis 诞生于 2009 年,全称为:
text
Remote Dictionary Server即:
text
远程字典服务器Redis 是一种:
基于内存的 Key-Value 型 NoSQL 数据库。
可以把这句话拆成三个关键词:
text
基于内存

Key-Value

NoSQL
理解这三个关键词,基本就理解了 Redis 最核心的定位。
二、Redis 是 Key-Value 型数据库
传统关系型数据库通常使用:
text
表
行
列
组织数据。
例如 MySQL:
text
user 表

id     name     age
1      Jack     20
2      Rose     18
Redis 的数据组织方式不同。
Redis 基本的数据模型是:
text
Key → Value例如:
text
name → Jack

age → 20

user:1 → 用户信息
可以把 Redis 想象成一个巨大的 Map:
java
Map<String, Object>通过一个 Key 找到对应的 Value。
例如:
text
Key:name
Value:Jack
或者:
text
Key:user:1001
Value:某个用户的信息
因此 Redis 的核心访问方式可以简单概括为:
text
通过 Key 操作 Value三、Redis 的 Value 不只是字符串
虽然 Redis 是 Key-Value 型数据库,但这里的 Value 并不意味着只能保存普通字符串。
Redis 支持多种数据结构。
常见的包括:
text
String
Hash
List
Set
Sorted Set
除此之外,Redis 还提供了:
text
Bitmap
HyperLogLog
Geo
Stream
等数据结构。
因此:
text
Key → Value中的 Value 实际可以非常丰富。
例如保存一个简单字符串:
text
name → "Jack"保存一个计数器:
text
article:1001:views → 100保存一个用户对象:
text
user:1001
    ↓
Hash
    ↓
name → Jack
age  → 20
保存一个列表:
text
message:list
    ↓
List
    ↓
message1
message2
message3
保存排行榜:
text
game:rank
    ↓
Sorted Set
这也是 Redis 功能非常丰富的重要原因。
四、Redis 是基于内存运行的
Redis 一个非常核心的特点就是:
主要数据存储在内存中。
传统关系型数据库的大量数据最终需要保存到磁盘。
而 Redis 在处理数据时,主要直接操作:
text
RAM也就是内存。
可以简单理解为:
text
传统数据库

程序
 ↓
数据库
 ↓
磁盘
Redis 则更多是:
text
程序
 ↓
Redis
 ↓
内存
内存访问速度通常远高于磁盘访问,因此 Redis 能够提供非常低的访问延迟。
五、Redis 为什么这么快?
Redis 高性能并不是由单一因素决定的,而是多方面设计共同作用的结果。
可以先概括为:
text
基于内存

高效的数据结构

高效的事件模型

IO 多路复用

较少的线程竞争

C 语言实现
其中最核心的因素之一,就是:
text
基于内存六、原因一:基于内存操作
CPU 访问内存的速度远高于访问磁盘。
Redis 大多数数据操作直接在内存中完成:
text
客户端
  ↓
Redis
  ↓
内存中的数据
避免了频繁的磁盘随机 IO。
因此对于:
text
查询热点数据

读取用户 Session

访问验证码

查询排行榜

统计访问次数
这类需要频繁读写的数据,Redis 非常适合。
七、原因二:高效的数据结构
Redis 并不是简单地把所有数据都保存成字符串。
它针对不同场景设计了不同的数据结构。
例如:
text
String
 ↓
字符串、数字、缓存

Hash
 ↓
对象数据

List
 ↓
有序列表

Set
 ↓
不重复集合

Sorted Set
 ↓
排行榜
不同的数据结构底层又会采用合适的数据组织方式,从而提高操作效率。
因此 Redis 的性能不仅来自:
text
内存还来自:
text
优秀的数据结构设计八、原因三:IO 多路复用
Redis 需要同时处理大量客户端连接。
如果:
text
一个客户端
=
一个线程
那么客户端数量非常大时,就会创建大量线程。
线程越多,意味着:
text
线程创建成本

线程切换成本

内存消耗

锁竞争
都会增加。
Redis 使用事件驱动和 IO 多路复用等机制,可以让较少的线程高效处理大量网络连接。
简单理解:
text
客户端 A ─┐
客户端 B ─┤
客户端 C ─┼──→ IO 多路复用 → Redis
客户端 D ─┤
客户端 E ─┘
系统会关注哪些连接真正发生了 IO 事件,再进行相应处理。
因此不需要为每一个连接都长期创建独立的处理线程。
九、Redis 是单线程吗?
学习 Redis 时,经常会听到:
Redis 是单线程的。
这句话需要正确理解。
更加准确地说:
Redis 的核心命令处理长期采用以单线程事件循环为核心的设计。
例如两个客户端先后发送命令:
text
客户端 A
 ↓
SET name Jack

客户端 B
 ↓
GET name
核心命令通常会按照顺序进行处理:
text
命令 A
 ↓
执行完成
 ↓
命令 B
 ↓
执行完成
而不是让多个线程同时修改同一份数据。
十、"单线程"不等于整个 Redis 只有一个线程
这是一个非常容易混淆的问题。
所谓 Redis 单线程,主要讨论的是:
text
核心命令执行路径并不意味着整个 Redis 进程从头到尾只有一个线程。
Redis 内部还可能使用其他线程完成部分后台工作。
特别是从 Redis 6 开始,可以通过 IO 线程处理部分网络读写工作。
因此比较准确的理解是:
text
核心命令执行
    ↓
以单线程模型为核心

部分网络 IO / 后台任务
    ↓
可以由其他线程参与
所以不能简单理解成:
text
Redis = 整个程序只有一个线程十一、单线程为什么还能这么快?
很多人的第一反应是:
text
多线程不是应该比单线程更快吗?并不一定。
如果任务本身非常快,多线程反而会增加额外成本。
例如:
text
线程切换

线程同步

加锁

解锁

竞争共享资源
Redis 中大量操作本身就在内存中完成,单个命令执行时间通常很短。
采用串行处理可以减少:
text
线程上下文切换

锁竞争

并发控制
带来的额外开销。
可以简单理解为:
text
Redis命令
   ↓
执行非常快
   ↓
按顺序快速处理
   ↓
减少线程竞争
因此:
单线程并不等于低性能。
Redis 的设计重点是让单次请求足够快,同时高效处理大量连接。
十二、Redis 命令为什么具有原子性?
由于核心命令通常按照顺序执行:
text
命令 A
 ↓
命令 B
 ↓
命令 C
一条命令执行时,不会被另一条普通命令执行过程随意插入。
因此 Redis 很多单条命令天然具备很好的原子性。
例如:
text
INCR counter用于:
text
counter = counter + 1如果多个客户端同时执行:
text
INCR counterRedis 会依次完成这些操作。
不会简单出现:
text
线程 A 读取 counter

线程 B 同时读取 counter

线程 A 修改

线程 B 覆盖
这种典型的共享变量竞争过程。
这也是 Redis 非常适合:
text
计数器

库存控制中的部分原子操作

限流

状态标记
等场景的重要原因之一。
需要注意的是:
单条命令具有原子性,不代表多个独立命令组合起来天然就是一个不可分割的整体。
多个命令之间如果存在一致性要求,还需要结合 Redis 的事务、Lua 脚本等机制分析。
十三、既然数据在内存中,Redis 重启后数据怎么办?
Redis 的主要数据存储在内存中。
那么就会产生一个非常重要的问题:
text
服务器断电
    ↓
内存数据消失
    ↓
Redis数据怎么办?
为了解决这个问题,Redis 提供了:
text
数据持久化也就是:
把内存中的数据以一定方式保存到磁盘。
Redis 中常见的持久化方式主要包括:
text
RDB

AOF
十四、RDB 持久化
RDB 可以简单理解为:
在特定时间点,对 Redis 数据生成快照。
例如:
text
Redis内存数据
      ↓
生成快照
      ↓
RDB文件
      ↓
保存到磁盘
Redis 重启后,可以读取这个文件恢复数据。
它类似于:
text
给当前 Redis 数据拍了一张快照十五、AOF 持久化
AOF 的思想则不同。
它主要记录:
text
Redis执行过的写操作例如客户端执行:
text
SET name Jack

SET age 20

INCR count
AOF 可以记录相应的写操作。
Redis 重启后,再通过这些操作恢复数据。
简单理解:
text
写命令
 ↓
记录
 ↓
AOF
 ↓
磁盘
因此 Redis 虽然主要基于内存运行,但并不意味着:
text
Redis只能保存临时数据通过持久化机制,可以提高数据的耐久性。
十六、Redis 支持主从复制
单机 Redis 存在明显问题。
例如服务器发生故障:
text
Redis服务器
    ↓
宕机
    ↓
整个Redis不可用
为了提高数据安全性以及系统可用性,可以使用多个 Redis 节点。
其中一种基础结构就是:
text
主节点
  ↓
复制数据
  ↓
从节点
也就是常说的:
text
主从复制例如:
text
       Redis Master
            │
       ┌────┴────┐
       ↓         ↓
Redis Replica  Redis Replica
主节点上的数据变化,可以同步到从节点。
十七、主从结构有什么作用?
主从结构可以解决多个问题。
例如:
text
Master
 ↓
负责写操作

Replica
 ↓
保存副本
这样可以增强数据冗余能力。
在合适的架构中,还可以让副本承担部分读取压力:
text
写请求
 ↓
Master

读请求
 ↓
Replica
从而分担访问压力。
不过:
主从复制本身并不等于完整的自动高可用方案。
当主节点发生故障时,如果希望自动完成故障发现和节点切换,通常还会涉及 Sentinel 或 Cluster 等机制。
十八、Redis 支持分片集群
假设一台 Redis 服务器只有:
text
16GB 内存但是现在需要保存:
text
50GB 数据显然一台服务器已经无法满足需求。
这时就可以把数据拆分到多台 Redis 节点:
text
全部数据
   │
   ├── 一部分 → Redis A
   │
   ├── 一部分 → Redis B
   │
   └── 一部分 → Redis C
这就是分片思想。
Redis Cluster 就可以利用多个节点分担数据存储和访问压力。
因此:
text
单机资源有限
    ↓
增加节点
    ↓
数据分片
    ↓
提升整体存储和处理能力
这属于典型的:
text
水平扩展十九、主从与分片解决的问题不同
这两个概念非常容易混淆。
可以简单理解为:
| 方式 | 核心目的 |
|---|---|
| 主从复制 | 数据冗余、读取扩展、高可用基础 |
| 分片集群 | 拆分数据、扩大容量、提升整体处理能力 |
例如:
text
主从
 ↓
同一份数据复制到多个节点
而:
text
分片
 ↓
不同数据分散到不同节点
可以用一个简单的例子理解。
主从:
text
Master:A B C

Replica:A B C
分片:
text
Node1:A

Node2:B

Node3:C
两种机制解决的是不同层面的问题。
实际 Redis Cluster 中还可以给不同主节点配置副本,从而同时兼顾:
text
分片
+
副本
二十、Redis 支持多语言客户端
Redis 本质上是一个独立运行的服务端程序。
各种编程语言都可以通过 Redis 协议与它进行通信。
因此 Redis 并不是:
text
Java专属数据库例如:
text
Java
Python
Go
C#
Node.js
PHP
C / C++
都可以连接 Redis。
整体结构可以理解为:
text
Java ──────┐
Python ────┤
Go ────────┤
Node.js ───┼──→ Redis Server
C# ────────┤
PHP ───────┘
对于 Java 开发来说,常见的 Redis 客户端技术还包括:
text
Jedis

Lettuce

Spring Data Redis
因此 Redis 可以非常方便地集成到不同技术栈中。
二十一、Redis 的核心特点
现在可以把 Redis 的特点集中起来:
| 特点 | 说明 |
|---|---|
| Key-Value | 使用键和值组织数据 |
| 数据结构丰富 | 支持 String、Hash、List、Set、Sorted Set 等 |
| 基于内存 | 大部分数据操作直接在内存完成 |
| 低延迟 | 适合高频访问场景 |
| 命令执行模型简单 | 核心命令以单线程事件循环为主 |
| 原子操作丰富 | 很多单条命令天然具有原子性 |
| 支持持久化 | 可以使用 RDB、AOF 保存数据 |
| 支持复制 | 可以构建主从结构 |
| 支持集群 | 可以通过数据分片进行水平扩展 |
| 客户端丰富 | 多种编程语言都能连接 Redis |
因此 Redis 并不是简单的:
text
内存中的 Map而是一个具备:
text
数据结构

持久化

复制

集群

网络通信

高性能事件模型
等完整能力的数据存储系统。
二十二、Redis 和 MySQL 是什么关系?
理解 Redis 时还有一个很重要的问题:
text
用了 Redis
是不是就不需要 MySQL 了?
通常不是。
两者擅长解决的问题不同。
MySQL 更擅长:
text
结构化数据

复杂查询

关系查询

事务

长期可靠存储
Redis 更擅长:
text
高频访问

低延迟查询

缓存

计数

排行榜

临时状态

分布式场景中的辅助数据
因此实际项目中经常采用:
text
            ┌──→ Redis
应用程序 ───┤
            └──→ MySQL
Redis 和 MySQL 往往不是替代关系,而是互相配合。
二十三、Redis 为什么经常被用作缓存?
假设一个查询请求每秒执行数万次:
sql
SELECT *
FROM product
WHERE id = 1001;
如果每次都直接访问数据库:
text
用户请求
   ↓
MySQL
   ↓
磁盘 / 缓冲池
   ↓
返回结果
数据库压力会不断增大。
如果商品信息很少发生变化,就可以把热点数据放入 Redis:
text
          ┌── 命中 ──→ Redis ──→ 返回
用户请求 ─┤
          └── 未命中 → MySQL
之后大量请求就可以直接读取 Redis。
因此:
text
Redis
 ↓
承担大量高频查询

MySQL
 ↓
负责核心业务数据持久化
就可以显著降低数据库压力。
这也是 Redis 最典型的应用场景之一。
二十四、Redis 常见应用场景
掌握 Redis 的特点以后,就很容易理解它为什么能够解决很多实际问题。
缓存
text
热点商品

用户信息

配置信息

文章详情
特点是:
text
读取频繁
+
要求响应快
Session 共享
分布式项目中可能有多台服务器:
text
Server A
Server B
Server C
如果 Session 只保存在某台服务器本地,就可能产生共享问题。
可以将登录状态放到 Redis:
text
Server A ─┐
Server B ─┼──→ Redis
Server C ─┘
实现多个应用实例共享数据。
验证码
例如:
text
手机号
  ↓
验证码
验证码通常只需要保存:
text
1分钟
5分钟
Redis 支持 Key 过期机制,非常适合这种短生命周期数据。
计数器
例如:
text
文章阅读量

商品访问次数

接口调用次数

点赞数
Redis 提供原子递增、递减相关操作,可以方便地实现计数。
排行榜
例如游戏积分:
text
张三  1000

李四  900

王五  800
Redis 的:
text
Sorted Set非常适合维护:
text
排行榜

热度榜

积分榜
分布式锁
在多个服务实例同时访问共享资源时,经常需要控制并发。
Redis 也可以用于实现:
text
分布式锁不过正确实现分布式锁还需要考虑:
text
原子性

超时时间

锁误删

续期

故障恢复
等问题,不能简单理解为执行一次 SETNX 就完全解决。
二十五、Redis 整体工作模型
现在可以建立这样一张整体图:
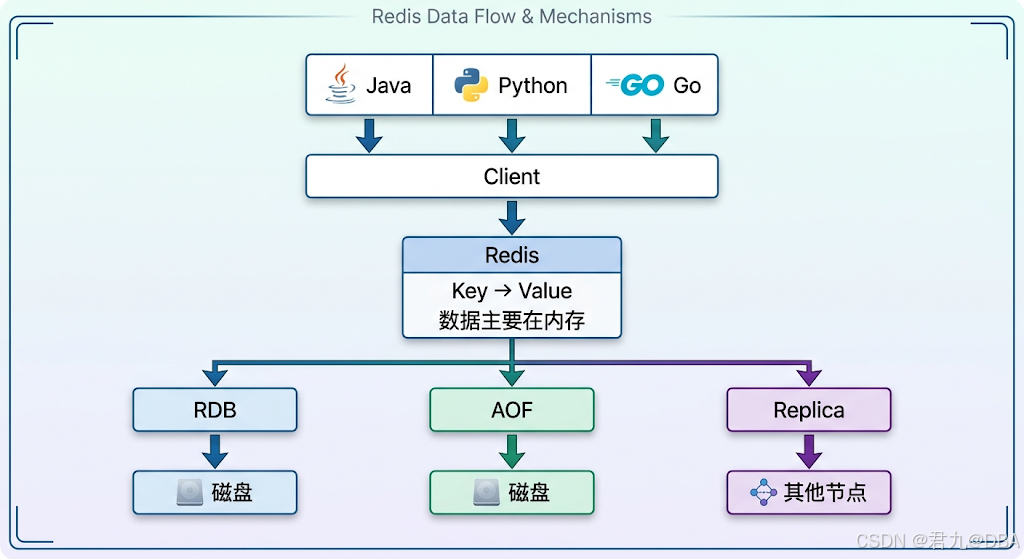
如果单机能力不足:
text
              Redis Cluster
                    │
         ┌──────────┼──────────┐
         ↓          ↓          ↓
       Node A     Node B     Node C
         ↓          ↓          ↓
       数据A       数据B       数据C
这样 Redis 就从:
text
单机内存数据库扩展成了:
text
支持持久化、复制和分布式扩展的数据系统二十六、几个容易产生误解的地方
1. Redis 基于内存,所以数据一定会丢失?
不准确。
Redis 可以使用:
text
RDB

AOF
将数据持久化到磁盘。
但是持久化策略不同,能够提供的数据安全程度也不同。
2. Redis 是单线程,所以性能低?
不准确。
Redis 核心命令执行采用单线程模型,反而减少了大量线程竞争和上下文切换,再结合内存访问以及高效的网络模型,可以获得很高的性能。
3. Redis 整个程序只有一个线程?
不准确。
核心命令处理模型和整个进程的线程数量是两个不同概念。
Redis 内部也会使用线程处理部分后台任务和网络 IO。
4. Redis 就是缓存?
不准确。
缓存只是 Redis 最常见的用途之一。
Redis 还可以应用于:
text
排行榜

计数

Session

消息通信

分布式协调

实时数据
等场景。
5. Redis 可以完全替代 MySQL?
通常不能。
Redis 和关系型数据库擅长解决的问题不同。
典型架构反而是:
text
Redis
+
MySQL
配合使用。
二十七、常见面试问题
Q1:Redis 是什么?
Redis 是一种基于内存的 Key-Value 型 NoSQL 数据库,支持丰富的数据结构,同时提供持久化、复制、集群等能力,具有低延迟、高性能等特点。
Q2:Redis 为什么快?
主要可以从以下几个方面理解:
text
① 数据主要存储在内存

② 使用高效的数据结构

③ 使用事件驱动和 IO 多路复用

④ 核心命令执行模型减少了线程竞争

⑤ 使用 C 语言实现并进行了大量工程优化
其中最核心的因素之一是:
text
内存访问Q3:Redis 是单线程的吗?
更准确地说,Redis 的核心命令处理长期采用以单线程事件循环为核心的模型。
但 Redis 整个进程并不是只能有一个线程,部分后台工作以及网络 IO 可以由其他线程参与。
Q4:Redis 的单条命令为什么具有原子性?
核心命令通常按照顺序执行,一条普通命令在执行过程中不会被另一条普通命令随意插入,因此很多单条 Redis 命令天然具有原子性。
Q5:Redis 数据在内存中,如何防止重启后全部丢失?
Redis 提供持久化机制,主要包括:
text
RDB

AOF
可以将数据以不同方式保存到磁盘。
Q6:Redis 如何提高可用性?
可以通过:
text
主从复制

Sentinel

Redis Cluster
等机制进一步构建高可用架构。
Q7:Redis 如何突破单机内存限制?
可以通过 Redis Cluster 对数据进行分片:
text
数据
 ↓
多个主节点
从而利用多台机器的资源实现水平扩展。
二十八、总结
认识 Redis,可以先牢牢记住一句话:
Redis 是一个基于内存、采用 Key-Value 模型并支持多种数据结构的高性能 NoSQL 数据库。
它最核心的特点可以归纳为:
text
Redis
│
├── Key-Value
│
├── 丰富的数据结构
│
├── 基于内存
│
├── 低延迟、高性能
│
├── 原子操作丰富
│
├── 支持持久化
│   ├── RDB
│   └── AOF
│
├── 支持复制
│
├── 支持分片集群
│
└── 支持多语言客户端
再把 Redis 为什么快串起来:
text
基于内存
    +
高效数据结构
    +
IO多路复用
    +
事件驱动模型
    +
减少线程竞争
    ↓
高性能、低延迟
最后,从实际开发角度来看,Redis 最重要的价值并不是简单替代数据库,而是利用自身的低延迟、高性能和丰富数据结构,解决传统关系型数据库并不擅长的一些问题。
典型架构往往是:
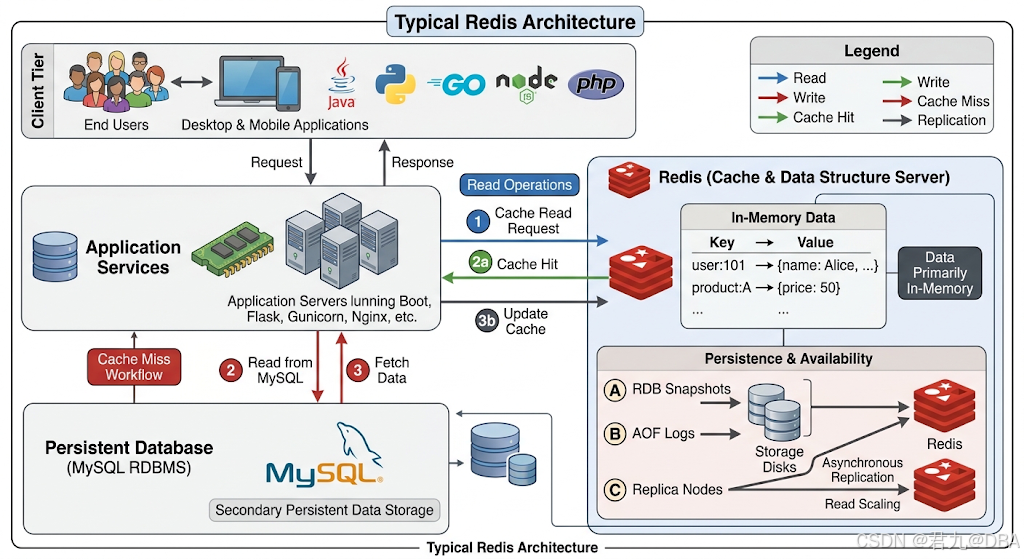
Redis 负责高频、低延迟的数据访问场景,MySQL 等关系型数据库负责核心业务数据和持久化存储,两者配合才能更好地支撑高并发应用。
若有转载,请标明出处:https://blog.csdn.net/CharlesYuangc/article/details/165087260