摘要:AI 全栈开发岗位,大量业务基于大模型 API 开发应用。河南宁渡科技有限公司宁渡课堂整理大模型接口开发、SSE 流式输出、接口异常处理面试核心知识点。
很多 AI 应用开发,不会从头训练大模型,而是调用第三方 LLM API,完成上层应用搭建。这块是 AI 全栈工程师日常工作,也是面试高频考察模块。
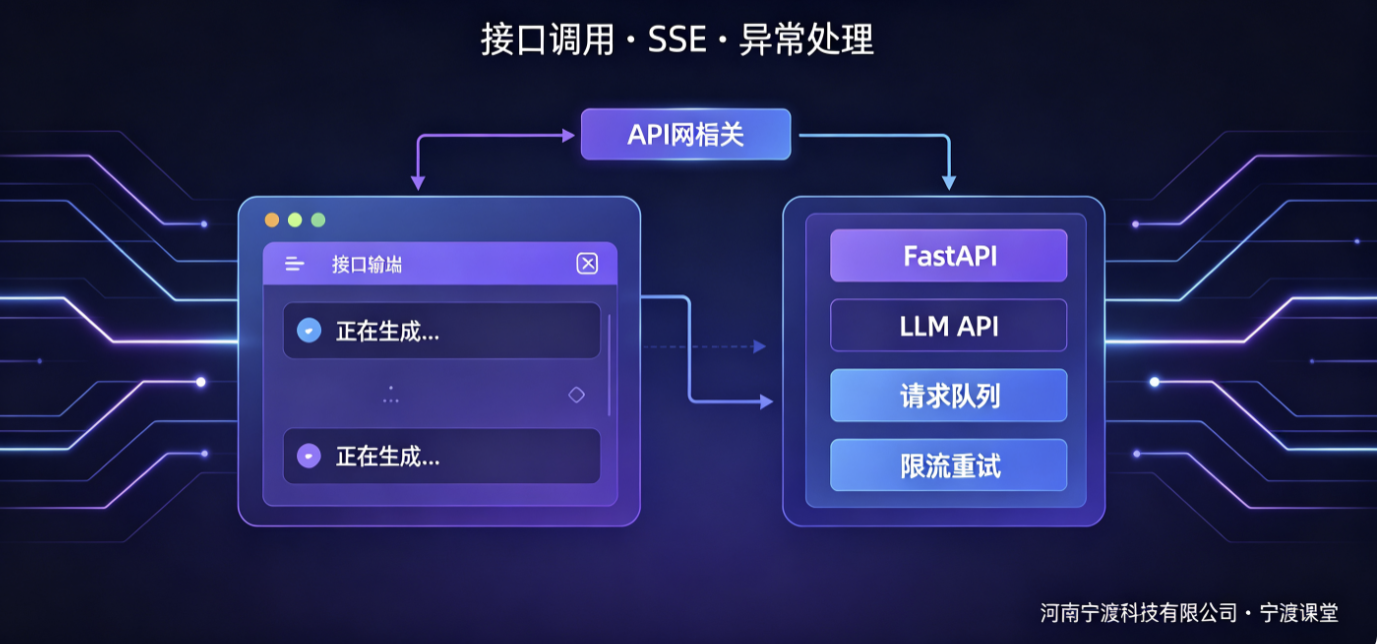
一、什么是 SSE 流式输出,原理是什么?
SSE 全称 Server-Sent Events,服务端推送事件。客户端发起一次 HTTP 长连接,服务端持续不断返回增量文本,前端实时展示打字效果,就是我们看到的 AI 对话逐字输出。 和 WebSocket 区别:SSE 单向通信,服务端向客户端推送;WebSocket 双向通信。大模型对话场景 SSE 足够,实现简单。面试常问:SSE 断线重连机制。
二、调用大模型 API,需要考虑哪些异常场景?
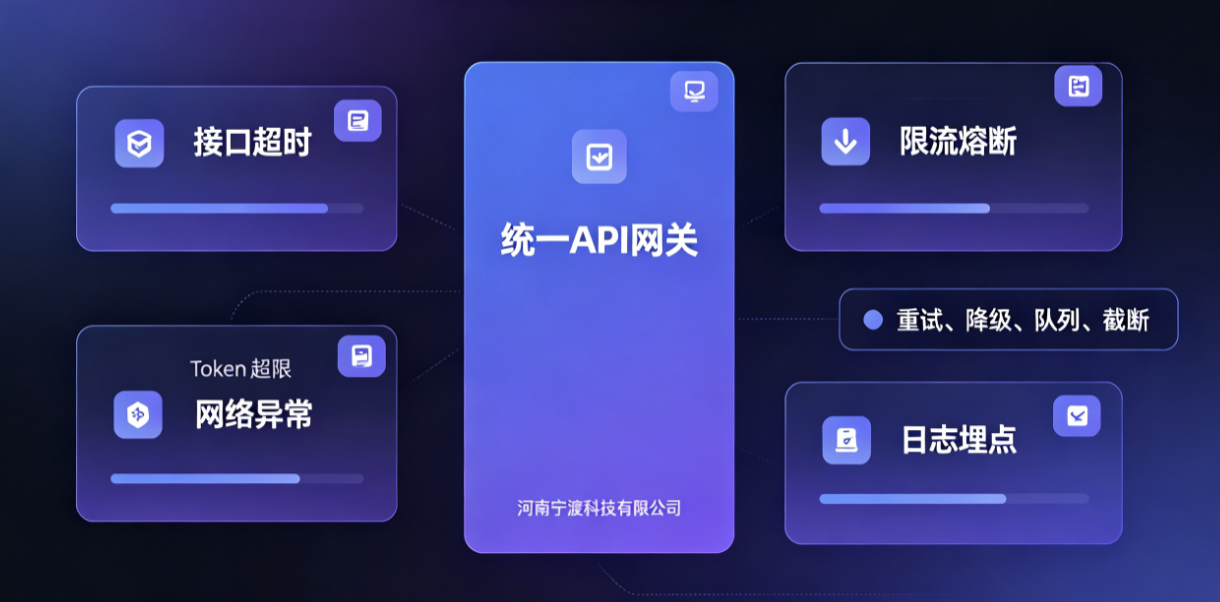
- 接口超时:大模型生成文本耗时不确定,需要设置超时时间,做超时重试;
- 限流:API 服务商有 QPS 限制,增加请求队列;
- 网络异常:增加重试机制,熔断降级;
- token 超限:提前计算输入 token,超出上下文窗口做截断。
三、Temperature 参数作用
temperature 控制模型输出随机性。取值 0~1 之间,数值越低,输出确定性越高、更保守,适合知识库问答;数值越高,创造性越强,适合文案创作。
四、Function Call 函数调用面试考点
Function Call 让大模型能够识别用户意图,调用自定义工具函数,例如联网查询、数据库查询、计算器。 执行流程:大模型判断需要调用工具 → 生成函数参数 → 后端执行函数拿到结果 → 结果传回大模型,整合回答用户。 适用场景:知识库之外的实时数据查询、外部系统联动,Agent 智能体核心能力。
五、AI 应用后端架构
后端常用 Python FastAPI,封装统一 AI 服务网关,管理模型请求、鉴权、日志、限流。接收前端对话请求,处理 prompt 组装、调用向量库、调用大模型 API,返回流式结果。
面试答题小提示
讲项目的时候,讲清楚:接口封装、流式返回、异常捕获、日志埋点,面试官会认为你具备工程落地能力,不只是懂理论。宁渡课堂 AI 全栈实战项目,手把手实现 SSE 对话接口与 Function Call 工具调用。