🔥个人主页:爱和冰阔乐
📚专栏传送门:《数据结构与算法》 、C++、 《Linux操作系统》
🐶学习方向:C++方向学习爱好者
⭐人生格言:得知坦然 ,失之淡然
🏠博主简介
文章目录
- 前言
- 一、先把日志模块准备好
-
- [1.1 为什么不只使用 `printf`](#1.1 为什么不只使用
printf) - [1.2 生成日志与刷新日志分开](#1.2 生成日志与刷新日志分开)
- [1.3 为什么日志输出也要加锁](#1.3 为什么日志输出也要加锁)
- [1.4 时间函数的线程安全](#1.4 时间函数的线程安全)
- [1.1 为什么不只使用 `printf`](#1.1 为什么不只使用
- 二、实现一个简单日志器
-
- [2.1 输出策略](#2.1 输出策略)
- [2.2 `Logger` 与临时消息对象](#2.2
Logger与临时消息对象) - [2.3 简单测试](#2.3 简单测试)
- 三、为什么需要线程池
-
- [3.1 来一个任务就创建一个线程的问题](#3.1 来一个任务就创建一个线程的问题)
- [3.2 线程池仍然是生产者消费者模型](#3.2 线程池仍然是生产者消费者模型)
- [3.3 固定线程数怎么选](#3.3 固定线程数怎么选)
- 四、固定线程池完整实现
-
- [4.1 线程池需要哪些状态](#4.1 线程池需要哪些状态)
- [4.2 `ThreadPool.hpp`](#4.2
ThreadPool.hpp) - [4.3 为什么使用 `unique_lock`](#4.3 为什么使用
unique_lock) - [4.4 为什么任务必须在锁外执行](#4.4 为什么任务必须在锁外执行)
- [4.5 为什么捕获任务异常](#4.5 为什么捕获任务异常)
- 五、线程池怎样安全退出
-
- [5.1 工作线程的三种状态](#5.1 工作线程的三种状态)
- [5.2 `Stop` 的执行顺序](#5.2
Stop的执行顺序) - [5.3 排空退出和立即退出](#5.3 排空退出和立即退出)
- [5.4 不要让工作线程销毁自己的线程池](#5.4 不要让工作线程销毁自己的线程池)
- 六、运行线程池
-
- [6.1 测试代码](#6.1 测试代码)
- [6.2 可以继续扩展哪些功能](#6.2 可以继续扩展哪些功能)
- 总结
- 参考资料
前言
前面已经把互斥锁、条件变量和生产者消费者模型写完了,这一篇把它们真正组合起来:先实现一个够用的日志模块,再实现固定数量线程的线程池。
这里不追求一次写出工业级日志库和通用线程池。我们主要把几个关键问题想清楚:任务为什么不能来一个就创建一个线程,工作线程没有任务时怎么等待,任务应该在锁内还是锁外执行,以及线程池析构时怎样让所有线程正常退出。
本文使用的接口与范围
示例使用 C++17 的 std::thread、std::condition_variable 和 std::filesystem,编译时需要添加 -pthread。文中的线程池用于理解任务队列、等待谓词和停止流程,不是直接替代成熟线程池库的生产版本。若编译器较旧,std::filesystem 可能还需要额外链接选项,应以实际工具链为准。
一、先把日志模块准备好
1.1 为什么不只使用 printf
以前写测试代码时,直接使用 printf 或 cout 没有问题。但项目运行时间一长,只在显示器上打印很难排查问题:终端关闭后消息就没了,也不知道某条输出来自哪个文件、哪一行、哪个线程。
一条实用日志至少应包含:
- 时间;
- 日志等级;
- 具体内容。
文件名、行号、进程 ID 和线程 ID 不是每个场景都必须有,但调试并发程序时非常有用。
常见等级可以这样理解:
| 等级 | 适合记录的内容 |
|---|---|
DEBUG |
调试阶段需要的细节 |
INFO |
程序正常运行过程中的关键事件 |
WARNING |
出现异常迹象,但程序还能继续工作 |
ERROR |
当前操作失败,需要排查 |
FATAL |
关键功能无法继续,程序通常需要退出 |
等级名称只是一套约定。真正重要的是团队对每个等级的使用范围保持一致,不能把所有消息都打成 ERROR。
1.2 生成日志与刷新日志分开
我原稿把日志分成两个动作,这个思路是对的:
- 组装一条完整日志;
- 把日志刷新到终端或文件。
第二步可以用策略模式实现。日志对象只负责形成字符串,具体输出位置由 ConsoleLogStrategy 或 FileLogStrategy 决定。这样切换输出位置时,不需要修改每个 LOG(...) 调用。
1.3 为什么日志输出也要加锁
多个工作线程可能同时写日志。如果每条日志由多次 operator<< 拼接,线程间输出可能交叉,最终一行同时包含两条消息。
因此刷新策略要保护真正的输出动作。锁的粒度应是一条完整日志,而不是每写一个字符就加一次锁。对于文件输出,目录只需要初始化一次,后续以追加方式打开文件。
1.4 时间函数的线程安全
localtime 可能返回指向共享静态对象的指针,多个线程同时调用时会互相覆盖。Linux/POSIX 环境可以使用 localtime_r,让调用者提供 struct tm 存储空间。
cpp
inline std::string CurrentTime()
{
    std::time_t now = std::time(nullptr);
    std::tm local_time{};
    localtime_r(&now, &local_time);

    char buffer[32];
    std::snprintf(buffer, sizeof(buffer),
                  "%04d-%02d-%02d %02d:%02d:%02d",
                  local_time.tm_year + 1900,
                  local_time.tm_mon + 1,
                  local_time.tm_mday,
                  local_time.tm_hour,
                  local_time.tm_min,
                  local_time.tm_sec);
    return buffer;
}
二、实现一个简单日志器
2.1 输出策略
cpp
#pragma once
#include <filesystem>
#include <fstream>
#include <iostream>
#include <memory>
#include <mutex>
#include <string>

class LogStrategy
{
public:
    virtual ~LogStrategy() = default;
    virtual void Write(const std::string &message) = 0;
};

class ConsoleLogStrategy final : public LogStrategy
{
public:
    void Write(const std::string &message) override
    {
        std::lock_guard<std::mutex> lock(_mutex);
        std::cout << message << '\n';
    }

private:
    std::mutex _mutex;
};

class FileLogStrategy final : public LogStrategy
{
public:
    explicit FileLogStrategy(std::string file = "./log/thread_pool.log")
        : _file(std::move(file))
    {
        std::filesystem::path path(_file);
        if (path.has_parent_path())
            std::filesystem::create_directories(path.parent_path());
    }

    void Write(const std::string &message) override
    {
        std::lock_guard<std::mutex> lock(_mutex);
        std::ofstream out(_file, std::ios::app);
        if (out)
            out << message << '\n';
    }

private:
    std::string _file;
    std::mutex _mutex;
};
基类析构函数必须是虚函数,否则以后通过基类指针销毁派生策略时会出问题。策略对象内部各自持有一把锁,保证同一种输出目标上的一条日志不会被拆开。
2.2 Logger 与临时消息对象
cpp
#pragma once
#include <cstdio>
#include <ctime>
#include <memory>
#include <mutex>
#include <sstream>
#include <string>
#include <sys/syscall.h>
#include <unistd.h>

enum class LogLevel { Debug, Info, Warning, Error, Fatal };

inline const char *ToString(LogLevel level)
{
    switch (level)
    {
    case LogLevel::Debug:   return "DEBUG";
    case LogLevel::Info:    return "INFO";
    case LogLevel::Warning: return "WARNING";
    case LogLevel::Error:   return "ERROR";
    case LogLevel::Fatal:   return "FATAL";
    }
    return "UNKNOWN";
}

class Logger
{
public:
    Logger() : _strategy(std::make_shared<ConsoleLogStrategy>()) {}

    void UseConsole()
    {
        std::lock_guard<std::mutex> lock(_strategy_mutex);
        _strategy = std::make_shared<ConsoleLogStrategy>();
    }

    void UseFile(const std::string &file)
    {
        auto next = std::make_shared<FileLogStrategy>(file);
        std::lock_guard<std::mutex> lock(_strategy_mutex);
        _strategy = std::move(next);
    }

    class Message
    {
    public:
        Message(Logger &logger, LogLevel level,
                const char *file, int line)
            : _logger(logger)
        {
            _stream << '[' << CurrentTime() << ']'
                    << '[' << ToString(level) << ']'
                    << "[pid:" << getpid() << ']'
                    << "[tid:" << syscall(SYS_gettid) << ']'
                    << '[' << file << ':' << line << "] ";
        }

        template <class T>
        Message &operator<<(const T &value)
        {
            _stream << value;
            return *this;
        }

        ~Message()
        {
            _logger.Flush(_stream.str());
        }

    private:
        Logger &_logger;
        std::ostringstream _stream;
    };

    Message operator()(LogLevel level, const char *file, int line)
    {
        return Message(*this, level, file, line);
    }

private:
    void Flush(const std::string &message)
    {
        std::shared_ptr<LogStrategy> strategy;
        {
            std::lock_guard<std::mutex> lock(_strategy_mutex);
            strategy = _strategy;
        }
        strategy->Write(message);
    }

private:
    std::mutex _strategy_mutex;
    std::shared_ptr<LogStrategy> _strategy;
};

inline Logger logger;
#define LOG(level) logger(level, __FILE__, __LINE__)
使用临时 Message 对象的好处是可以保留熟悉的流式写法:
cpp
LOG(LogLevel::Info) << "task " << task_id << " finished";整条语句结束时,临时对象析构,已经拼好的字符串一次性交给刷新策略。这里没有让多个线程共同修改同一个字符串流,每个线程在栈上创建自己的 Message。
策略切换也要同步。代码先把当前 shared_ptr 复制到局部变量,再释放策略锁并真正输出,避免文件 I/O 长时间占着 _strategy_mutex。
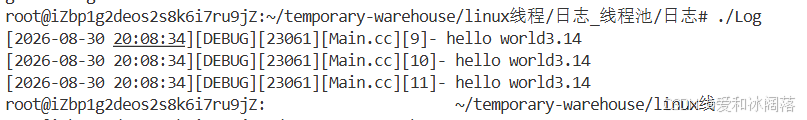
2.3 简单测试
cpp
int main()
{
    LOG(LogLevel::Debug) << "console message";
    logger.UseFile("./log/thread_pool.log");
    LOG(LogLevel::Info) << "file message";
    LOG(LogLevel::Warning) << "queue is almost full";
}
这个实现没有日志轮转、异步写盘、过滤器和批量刷新,因此不应替代 spdlog、glog 等成熟库。自己写一遍的目的,是为后面的线程池准备输出工具,并把多线程日志中最基本的锁范围想明白。
三、为什么需要线程池
3.1 来一个任务就创建一个线程的问题
如果每收到一个短任务就 pthread_create,处理完再 pthread_join 或分离线程,线程创建、栈空间准备、内核调度对象管理和销毁成本会反复发生。请求突然增多时,线程数量也可能跟着失控。
线程池的做法是提前创建固定数量的工作线程。任务到来后只放进队列,空闲线程从队列取任务执行,不再为每个任务重新创建线程。
我原稿用餐厅预制菜类比池化:资源提前准备好,需要时直接复用。这个类比抓住了核心,但线程池不是"任务提前算好",而是执行任务的线程提前创建好。
3.2 线程池仍然是生产者消费者模型
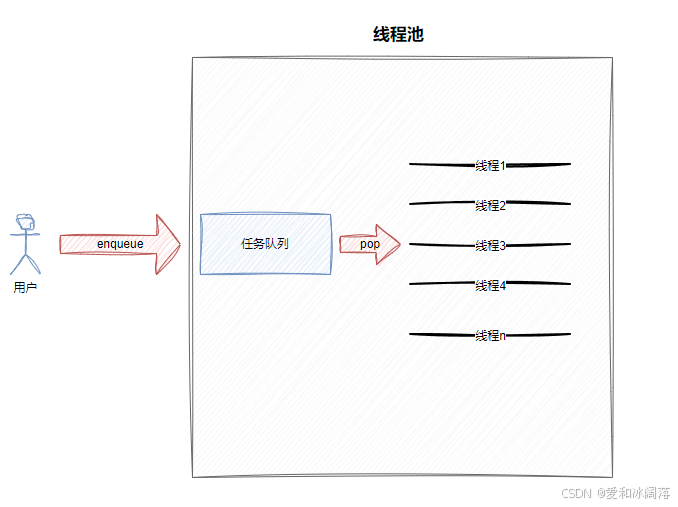
提交任务的线程是生产者,任务队列是交易场所,工作线程是消费者:
- 外部线程把任务放入队列;
- 条件变量唤醒一个工作线程;
- 工作线程取走任务;
- 在队列锁外执行任务;
- 再回到队列等待下一个任务。
线程池只限制工作线程数量。若任务提交速度长期大于处理速度,无界队列仍会不断增长。真正用于服务端时,要考虑有界队列、拒绝策略或上游限流。
3.3 固定线程数怎么选
没有一个线程数适合所有程序。CPU 密集任务通常从硬件并发数附近开始测试;任务经常等待磁盘或网络时,可以适当多一些线程。但线程越多不等于越快,过多线程会增加切换、栈内存和缓存失效成本。
最可靠的办法仍然是结合任务类型、机器配置和实际负载压测,而不是抄一个固定公式。
四、固定线程池完整实现
4.1 线程池需要哪些状态
一个最小可用线程池需要:
- 工作线程数组;
- 任务队列;
- 保护队列和状态的互斥锁;
- 队列为空时供工作线程等待的条件变量;
- 是否停止接收任务的标记。
退出时采用"排空队列再结束"的策略:调用 Stop 后不再接收新任务,已经进入队列的任务继续执行;队列为空以后,工作线程退出循环。
4.2 ThreadPool.hpp
cpp
#pragma once
#include <condition_variable>
#include <cstddef>
#include <functional>
#include <mutex>
#include <queue>
#include <stdexcept>
#include <thread>
#include <utility>
#include <vector>

class ThreadPool
{
public:
    using Task = std::function<void()>;

    explicit ThreadPool(std::size_t thread_count)
    {
        if (thread_count == 0)
            throw std::invalid_argument("thread_count must be positive");

        _workers.reserve(thread_count);
        for (std::size_t i = 0; i < thread_count; ++i)
            _workers.emplace_back(&ThreadPool::WorkerLoop, this, i);
    }

    ~ThreadPool()
    {
        Stop();
    }

    ThreadPool(const ThreadPool &) = delete;
    ThreadPool &operator=(const ThreadPool &) = delete;

    void Submit(Task task)
    {
        {
            std::lock_guard<std::mutex> lock(_mutex);
            if (_stopping)
                throw std::runtime_error("submit on stopped thread pool");
            _tasks.push(std::move(task));
        }
        _condition.notify_one();
    }

    void Stop()
    {
        {
            std::lock_guard<std::mutex> lock(_mutex);
            if (_stopping)
                return;
            _stopping = true;
        }

        _condition.notify_all();
        for (std::thread &worker : _workers)
        {
            if (worker.joinable())
                worker.join();
        }
    }

private:
    void WorkerLoop(std::size_t worker_id)
    {
        LOG(LogLevel::Info) << "worker " << worker_id << " started";

        while (true)
        {
            Task task;
            {
                std::unique_lock<std::mutex> lock(_mutex);
                _condition.wait(lock, [this] {
                    return _stopping || !_tasks.empty();
                });

                if (_stopping && _tasks.empty())
                    break;

                task = std::move(_tasks.front());
                _tasks.pop();
            }

            try
            {
                task();
            }
            catch (const std::exception &error)
            {
                LOG(LogLevel::Error)
                    << "worker " << worker_id
                    << " task failed: " << error.what();
            }
            catch (...)
            {
                LOG(LogLevel::Error)
                    << "worker " << worker_id
                    << " task failed: unknown exception";
            }
        }

        LOG(LogLevel::Info) << "worker " << worker_id << " stopped";
    }

private:
    std::vector<std::thread> _workers;
    std::queue<Task> _tasks;
    std::mutex _mutex;
    std::condition_variable _condition;
    bool _stopping{false};
};
4.3 为什么使用 unique_lock
std::condition_variable::wait 需要在等待时释放锁,醒来后再加锁,因此它接收 std::unique_lock<std::mutex>。普通 lock_guard 不提供这种可解锁、再加锁的控制接口。
谓词写成 _stopping || !_tasks.empty(),表示有任务或者线程池开始停止时,工作线程都应该醒来继续判断。
4.4 为什么任务必须在锁外执行
工作线程只在锁内完成三件事:检查状态、取队头任务、删除队头任务。拿到局部 task 后立刻离开作用域,释放队列锁,然后再执行任务。
如果把 task() 放在锁内,某个任务执行 3 秒,其他工作线程就会 3 秒都拿不到队列锁。虽然创建了多个线程,任务仍然接近串行执行。
队列锁保护的是线程池内部状态,不应该保护任务自己的业务过程。任务若访问其他共享数据,应使用业务自己的同步手段。
4.5 为什么捕获任务异常
若异常一直逃出工作线程入口,程序通常会调用 std::terminate。一个任务抛错不应该直接带走整个线程池,所以这里在工作循环中捕获异常并写日志。
但不能空着 catch (...) 什么也不做。至少要记录任务失败,否则线程池表面还在运行,错误却完全丢失。
五、线程池怎样安全退出
5.1 工作线程的三种状态
线程池运行期间,工作线程大致处于三种状态:
- 队列为空,在条件变量下等待;
- 拿到队列锁,正在取任务;
- 已经释放队列锁,正在执行任务。
退出不能直接把这些线程"一股脑取消"。异步取消可能让线程停在持锁、分配内存或修改业务状态的中间位置,资源很难收拾。
5.2 Stop 的执行顺序
本文采用下面的退出顺序:
- 在锁内把
_stopping设为true; notify_all唤醒所有仍在等待的工作线程;- 工作线程继续取完队列中的旧任务;
- 观察到"停止且队列为空"后退出循环;
Stop对每个工作线程执行join。
只修改标记却不广播,空闲工作线程可能永远睡在条件变量上,析构函数会卡在 join。只广播却不修改谓词,线程醒来后又会发现队列为空,重新等待。
5.3 排空退出和立即退出
线程池通常要明确两种语义:
| 退出方式 | 已排队任务 | 适合场景 |
|---|---|---|
| 排空退出 | 全部执行完 | 正常停机、希望不丢任务 |
| 立即退出 | 放弃尚未开始的任务 | 故障止损、任务已失去意义 |
本文代码是排空退出。若要立即退出,工作线程的判断和任务队列清理都要一起修改,不能只把某个条件改掉。
5.4 不要让工作线程销毁自己的线程池
如果某个任务直接析构它所在的线程池,Stop 可能尝试 join 当前线程自己,形成死锁或错误。线程池的所有权应由更外层对象管理,停止动作也应在工作线程之外发起。
六、运行线程池
6.1 测试代码
cpp
#include <chrono>
#include <iostream>
#include <thread>
#include "Log.hpp"
#include "ThreadPool.hpp"

int main()
{
    logger.UseConsole();
    ThreadPool pool(3);

    for (int task_id = 0; task_id < 8; ++task_id)
    {
        pool.Submit([task_id] {
            LOG(LogLevel::Info) << "task " << task_id << " begin";
            std::this_thread::sleep_for(std::chrono::milliseconds(120));
            LOG(LogLevel::Info) << "task " << task_id << " end";
        });
    }

    pool.Stop();
    std::cout << "all tasks finished\n";
}
bash
g++ -std=c++17 -O2 -pthread main.cc -o thread_pool
./thread_pool
运行这段程序时,不同任务的开始顺序和结束顺序可能变化,这是正常的调度结果。观察重点不是固定输出顺序,而是每条日志是否完整、8 个任务是否都执行结束,以及三个工作线程能否在 Stop 后退出。
6.2 可以继续扩展哪些功能
这个版本跑通以后,可以逐步增加:
- 有界任务队列与提交超时;
- 返回
future的任务提交接口; - 任务优先级;
- 运行中任务数、排队数和拒绝数统计;
- 日志文件轮转与异步写入;
- 明确区分排空退出和立即退出。
扩展时不要一次把所有功能塞进去。先固定线程池最基本的状态机,再加监控和策略,否则退出路径很容易失控。
总结
日志模块负责把并发程序中的关键状态留下来,线程池负责复用一组工作线程处理任务。线程池本质上仍是生产者消费者模型:提交方生产任务,工作线程消费任务,队列和条件变量协调二者速度。
实现时最容易写错的地方不是 pthread_create,而是锁的范围和退出过程:队列状态在锁内修改,任务在锁外执行;停止时先修改谓词,再唤醒全部线程,最后逐个 join。
下一篇收尾线程安全专题,继续讨论单例模式、可重入函数、死锁和 STL/智能指针的线程安全边界。
参考资料
【Linux】信号量到底在数什么:从PV操作到RingQueue环形队列生产者消费者模型
【Linux】多线程抢票为什么会出错?从 mutex、futex 到 RAII,讲清线程互斥
【Linux】epoll 真的是 O(1) 吗?从阻塞 I/O、select/poll 到 LT/ET 与 Reactor 一次讲透