一、单层感知机与线性可分性
神经网络的思想起点,是 1958 年 Rosenblatt 提出的感知机(Perceptron)。它本质上是一个二分类的线性模型:
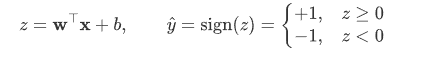
其中 \\mathbf{w} 是权重向量,b 是偏置,\\mathbf{x} 是输入特征。几何意义上,\\mathbf{w}\^\\top \\mathbf{x} + b = 0 定义了一条决策超平面,感知机的学习过程就是不断调整 \\mathbf{w}, b 让这个平面把两类样本分开。
1、感知机学习规则
对误分类样本 (\\mathbf{x}_i, y_i),参数按如下规则更新:
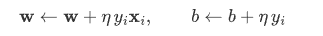
\\eta 是学习率。如果数据是线性可分的,感知机收敛定理保证它能在有限步内找到分离超平面。
2、线性不可分的天花板
但单层感知机的表达能力被死死钉在"线性"上。最经典的例子是 XOR(异或):
| x1 | x2 | y |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
这四个点在平面上无法用一条直线分开((0,0) 与 (1,1) 同类,却被 (0,1)、(1,0) 包围)。这正是 1969 年 Minsky 在《Perceptrons》中揭示的致命缺陷,也直接导致了神经网络的第一次寒冬。结论:单层线性模型 = 只能学线性边界。
二、为什么需要隐藏层与非线性激活
要突破线性,思路很自然:堆叠多层,并在层与层之间插入非线性激活函数。
1、没有非线性会怎样?
假设网络只有线性层(激活是恒等函数),两层叠加:
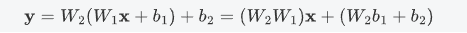
合并后仍是 \\tilde{W}\\mathbf{x} + \\tilde{b} 的形式------多层退化为单层 。所以"非线性"不是锦上添花,而是多层网络拥有更强表达能力的必要条件。
2、常用激活函数对比
| 激活函数 | 公式 | 优点 | 缺点 |
|---|---|---|---|
| Sigmoid | \\sigma(z)=\\frac{1}{1+e\^{-z}} | 输出 (0,1),早期经典 | 易梯度消失、均值非零 |
| Tanh | \\tanh(z) | 零中心,收敛更快 | 仍会梯度消失 |
| ReLU | \\max(0,z) | 计算快、缓解梯度消失 | 死神经元(负区梯度为 0) |
| LeakyReLU | \\max(\\alpha z, z) | 缓解死神经元 | 需调 \\alpha |
直觉:激活函数把"线性变换 + 非线性扭曲"交替进行,使得网络能够拟合任意复杂的非线性决策边界。
3、万能逼近定理
1989 年 Cybenko 证明:一个包含足够多神经元单隐藏层的前馈网络,配合非线性激活,可以以任意精度逼近任意连续函数 (在紧集上)。这从理论层面回答了"为什么要多层/非线性"------单层加宽就够了,但实践中深而窄 比浅而宽更高效,后续文章会展开。
三、前向传播的矩阵推导
现代网络用矩阵运算一次性处理整个 batch,这是工程实现的核心。记第 l 层:
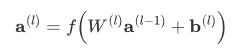
维度约定(以全连接为例):
-
输入 \\mathbf{a}\^{(0)} \\in \\mathbb{R}\^{n_0}
-
权重 W\^{(l)} \\in \\mathbb{R}\^{n_l \\times n_{l-1}}
-
偏置 \\mathbf{b}\^{(l)} \\in \\mathbb{R}\^{n_l}
-
输出 \\mathbf{a}\^{(l)} \\in \\mathbb{R}\^{n_l}
一次前向传播就是按顺序把每层"线性变换 + 偏置 + 激活"串起来。如果是 mini-batch(样本数 B),则 \\mathbf{A}\^{(0)} \\in \\mathbb{R}\^{B \\times n_0},矩阵维度随之扩展为 B \\times n_l,运算逻辑完全一致。
四、NumPy 手写三层网络并对照 PyTorch
下面用一个 784 → 128 → 64 → 10 的三层网络做前向推理,验证"手算"与"向量化"结果一致,并对照 PyTorch 写法。
4.1 NumPy 向量化实现
python
import numpy as np
def relu(z):
return np.maximum(0, z)
# 三层全连接: 784 -> 128 -> 64 -> 10
sizes = [784, 128, 64, 10]
rng = np.random.default_rng(7)
# He 初始化:适配 ReLU,方差 = 2 / n_in
W = [rng.standard_normal((sizes[i+1], sizes[i])) * np.sqrt(2.0 / sizes[i])
for i in range(3)]
b = [np.zeros(sizes[i+1]) for i in range(3)]
x = rng.standard_normal(sizes[0])
def forward(x):
a = x
for i in range(3):
a = relu(W[i] @ a + b[i]) # 矩阵乘法 + 偏置 + 激活
return a
y = forward(x)
print(y.shape) # (10,)
print(np.linalg.norm(y)) # 输出向量范数4.2 交叉验证:循环实现 vs 向量化
为了确认矩阵公式没有写错,我用逐元素循环重写了同一份前向,并在固定随机种子下对比:
python
def forward_loop(x):
a = x.copy()
for i in range(3):
z = np.zeros(sizes[i+1])
for j in range(sizes[i+1]):
s = b[i][j]
for k in range(sizes[i]):
s += W[i][j, k] * a[k]
z[j] = s
a = relu(z)
return a
y_loop = forward_loop(x)
print(np.abs(y - y_loop).max()) # 两者最大差异实测结果(固定 seed=7):
| 指标 | 数值 |
|---|---|
| 向量化输出前 5 维 | [0, 2.3645, 0.5596, 1.8162, 0] |
| 循环实现输出前 5 维 | [0, 2.3645, 0.5596, 1.8162, 0] |
| 两种实现最大差异 | 3.11e-15(完全一致) |
| 输出向量 L2 范数 | 3.4708 |
| 输出非零占比 | 70.0%(ReLU 引入的稀疏性) |
差异在浮点误差量级(1e-15),说明矩阵化推导正确。动手做这种交叉验证,是调试自定义网络的第一步。
4.3 对照 PyTorch 写法
上述逻辑用 PyTorch 表达几乎一一对应,读者可在自己机器上确认输出一致:
python
import torch
Wt = [torch.tensor(W[i], dtype=torch.float32) for i in range(3)]
bt = [torch.tensor(b[i], dtype=torch.float32) for i in range(3)]
xt = torch.tensor(x, dtype=torch.float32)
a = xt
for i in range(3):
a = torch.relu(Wt[i] @ a + bt[i])
print(a.numpy()[:5])五、权重初始化与深度权衡
网络能跑通,不代表能训好。权重初始化直接决定训练初期的梯度健康度:
-
全零/常数初始化:所有神经元更新方向一致,等价于一个神经元,表达能力崩溃。
-
过大初始化:激活值饱和(如 Sigmoid 两端),梯度趋近 0,训练停滞。
-
合理缩放初始化:
-
Xavier / Glorot (W \\sim \\mathcal{N}(0, 2/(n*{in}+n*{out}))):适合 Tanh/Sigmoid,保持各层方差稳定。
-
He / Kaiming(\\sigma = \\sqrt{2/n_{in}}):专为 ReLU 族设计,本文 4.1 用的就是它。
-
深度与表达能力的权衡
| 维度 | 浅而宽 | 深而窄 |
|---|---|---|
| 参数量 | 大 | 相对小 |
| 表达效率 | 低 | 高(指数级区域数) |
| 训练难度 | 易过拟合 | 易梯度问题 |
"深"能指数级提升对复杂函数的刻画效率,但越深,信号在层间传播时越容易出现梯度消失/爆炸 ------这恰好引出我们下一篇要啃的硬骨头:反向传播与梯度消失。
六、总结与下一篇预告
本文从感知机的线性局限出发,论证了隐藏层 + 非线性激活是多层网络具备表达能力的根本原因,推导了前向传播的矩阵形式,并用 NumPy 实现三层网络、以 1e-15 级的一致性验证了正确性。同时点明了权重初始化与网络深度对训练的关键影响。
核心收获:
-
单层感知机只能学线性边界,XOR 是其经典反例;
-
没有非线性激活,多层等于单层;
-
前向传播本质是"线性变换 + 偏置 + 激活"的链式矩阵运算;
-
用循环实现交叉验证向量化结果,是自定义网络的必备调试习惯。
下一篇预告:《反向传播算法详解与梯度消失实战分析》------我们将手推链式法则下的梯度公式,写数值梯度校验代码,并实测 10 层网络下 Sigmoid 的梯度是如何"消失"的。
参考资料
-
Rosenblatt, F. (1958). The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain. Psychological Review.
-
Cybenko, G. (1989). Approximation by Superpositions of a Sigmoidal Function. Mathematics of Control, Signals and Systems.
-
Glorot, X., & Bengio, Y. (2010). Understanding the Difficulty of Training Deep Feedforward Neural Networks. AISTATS.
-
He, K., et al. (2015). Delving Deep into Rectifiers: Surpassing Human-Level Performance on ImageNet. ICCV.
往期回顾
- 文为「神经网络基石」专栏首篇,下一篇:《反向传播算法详解与梯度消失实战分析》。
思考题:如果把本文三层网络的隐藏层激活全部换成线性函数,输出会等价于什么?欢迎在评论区写下你的推导。
如果这篇对你建立"从公式到代码"的认知有帮助,欢迎 点赞 / 收藏 / 关注,后续文章会持续拆解反向传播、CNN、RNN、Transformer 等核心模块。你的支持是我更新最大的动力。
📚 本篇出自专栏《 深学之路:从感知机到智能体》 ------ 从感知机到大模型智能体的完整深度学习连载(基础+工程化 20 篇已完结,续作含扩散模型 / RAG / Agent 等)。每篇附可运行代码与原创实验,收藏专栏不迷路。