Apache Hudi 概述:从 Parquet 更新难题到数据湖 Upsert
前言
在数据仓库和数据湖场景中,Parquet 应该是大家非常熟悉的一种文件格式。列式存储、压缩率高、对分析类查询友好,这些特点让它非常适合承载海量明细数据。因此在实际的大数据系统中,我们经常会把数据以 Parquet 的形式存放在 HDFS、S3、OSS 等存储系统上。
但 Parquet 也有一个很明显的特点:它非常适合批量写入和批量读取,却并不擅长频繁修改其中的少量记录。
假设有一张积累了 10 亿条订单的订单表,其中有 100 万条订单的状态从 unpaid 变成了 paid。如果数据放在 MySQL 中,我们很自然会想到:
sql
UPDATE orders
SET status = 'paid'
WHERE order_id = 1002;
数据库本身提供了行级更新能力,我们只需要找到对应的记录并修改字段即可。但如果这些订单已经变成了一个个 Parquet 文件,事情就没有这么简单了。
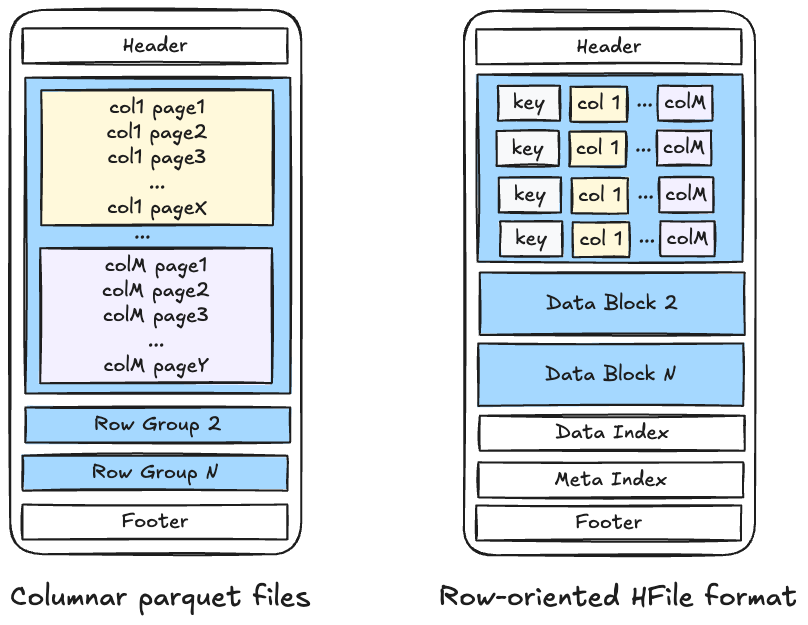
Parquet 本质上是一种面向分析场景设计的列式文件格式,文件内部按照 Row Group、Column Chunk 等结构组织数据,并且通常还会进行编码和压缩。
Parquet 文件格式本身并没有像数据库那样提供行级 UPDATE 语义 ,因此我们不能简单地找到 order_id=1002,然后在原文件中把 unpaid 原地改成 paid。
在实际的数据湖场景中,一条记录发生变化,往往意味着我们首先要知道它位于哪个数据文件,然后读取相关数据、完成合并,并生成新的文件版本。
如果只是偶尔更新几个文件,这似乎还不算什么问题。但当数据规模达到几十亿甚至上百亿,并且每天都有大量记录持续发生变化时,问题很快就会暴露出来:一条记录到底在哪个文件里?更新少量数据是否需要重写大量文件?新旧文件同时存在时应该读取哪一个?如果写到一半任务失败,又该如何保证表仍然处于一个正确的状态?
当这些问题放在一起时,我们真正缺少的其实已经不只是一个"修改 Parquet 文件的方法",而是一套能够管理数据更新、文件版本以及提交状态的机制。
这正是 Apache Hudi 想要解决的问题。
一、 Apache Hudi 是什么
Apache Hudi 可以先简单理解为:在数据湖文件之上增加一层"表管理能力"。
Hudi 并不是要替代 Parquet。很多 Hudi 表的 Base File 依然可以使用 Parquet,区别在于,Hudi 不再把这些文件当成一堆彼此独立的数据文件,而是通过一套表级元数据把它们组织和管理起来。
在此基础上,Hudi 提供了事务、Upsert/Delete、索引、版本管理、Compaction、Clustering、并发控制等能力。
官方目前将 Hudi 定位为一个开放的数据湖仓平台,它希望把数据库中常见的可变数据管理能力带到数据湖中。换句话说,Hudi 关注的不只是"数据怎么存",还包括"数据发生变化以后应该怎么管理"。
因此,普通 Parquet 数据集和 Hudi 表之间最大的区别,并不是底层文件格式发生了变化,而是这些文件开始拥有了"表"的语义。
对于普通的 Parquet 数据集来说,我们更多是在管理目录和文件:某个分区下面有哪些 Parquet,查询引擎就去读取这些文件。而在 Hudi 中,除了真正存放数据的 Base File、Log File 之外,还会维护 Timeline、Metadata、Index 等信息,用来描述一张表当前有哪些有效数据、记录发生过哪些变化,以及一次写入是否已经成功完成。
这也意味着,我们面对的不再只是"某个目录下面有哪些 Parquet 文件",而是一张可以持续进行 Insert、Update、Delete,并且能够管理数据版本和提交状态的表。
二、 Hudi 的几个核心概念
那么,Hudi 到底是怎么把一堆原本相对独立的数据文件,组织成一张可以持续更新的"表"的?
在继续讲 CoW、MoR 和 Upsert 之前,需要先认识几个最基本的概念。这里第一次接触的同学没必要一开始就把所有术语都研究透,先弄清楚一件事即可:Hudi 是怎么识别一条记录、怎么组织数据文件,又是怎么管理这些文件的不同版本的。
1. Record Key
对于一张会不断发生更新的表来说,首先要解决的问题其实很简单:新来的一条数据,到底是全新的记录,还是之前某条记录的新版本?
这就需要 Record Key。
比如订单表中的order_id,如果 order_id 在业务上能够唯一标识一笔订单,那么它就很适合作为 Record Key。互联网广告场景中也是一样,一次竞价通常会产生一个唯一的 bid_id。后面即使陆续到达曝光、点击、安装、转化等事件,只要它们最终关联到同一个 bid_id,我们就知道这些变化属于同一次竞价。
Record Key 的意义就在这里:当以后又来了一条的数据时,Hudi 才有依据判断:这不是一条全新的订单,而是原来的那条记录可能发生了变化。
2. Partition
接触分布式的小伙伴们对Partition想必再熟悉不过。顾名思义,Partition解决的是另外一个问题:数据在存储上应该放在哪里?
例如我们按照日期组织订单数据:dt=2026-09-14,广告数据也可以按照 req_date 进行分区。
这样做的目的,一方面是让数据在存储上有清晰的组织方式,另一方面也能让查询尽可能只扫描相关分区,而不是每次都读取整张表。
所以 Record Key 和 Partition 很容易一起出现,但它们解决的完全不是同一个问题。
3. File Group
进入某个 Partition 后,Hudi 不会单纯把每个 Parquet 文件看作彼此毫无关系的独立文件,而是进一步使用 File Group 来组织数据。
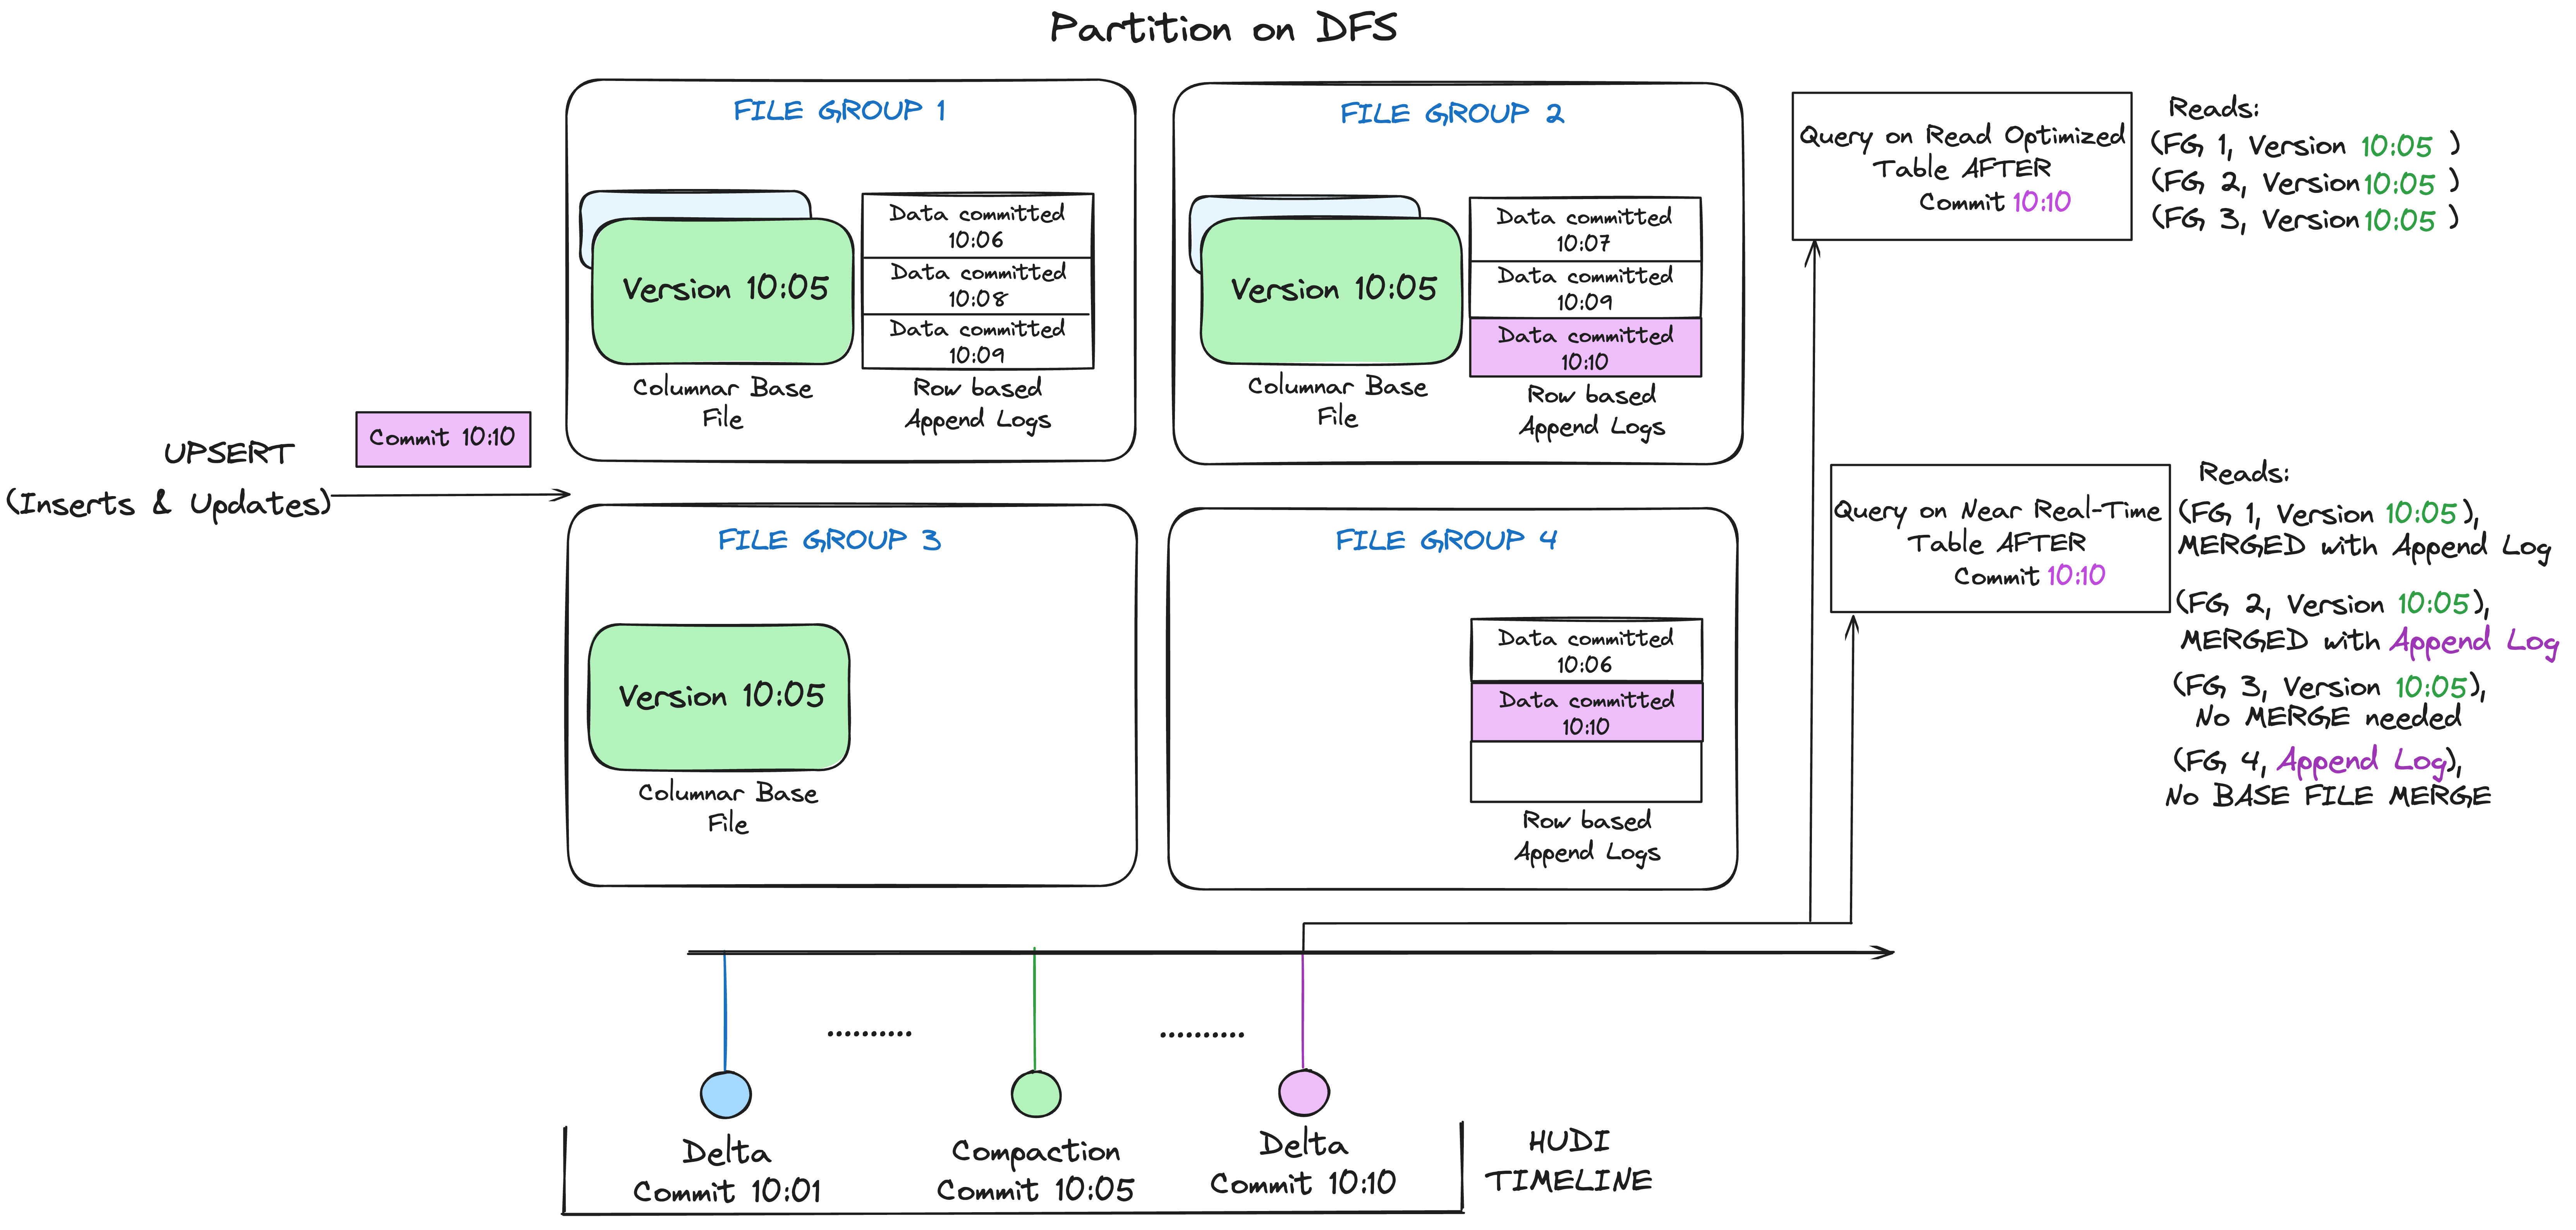
每个 File Group 都有自己的 File ID。可以先把 File Group 理解成 Hudi 管理数据文件时的一个逻辑单位:某一批记录一旦被组织进一个 File Group,后续这些记录发生更新时,新生成的文件版本仍然会围绕这个 File Group 继续演进。
Hudi 在执行 Update 时,真正关心的往往不是这条记录现在到底在哪个具体文件里,而是先定位它属于哪个 File Group.
即具体文件可能随着一次次更新发生变化,但 File Group 这个逻辑归属可以保持稳定。
4.File Slice、Base File 和 Log File
既然数据会不断更新,那么同一个 File Group 自然也不可能永远只有一个文件。
Hudi 使用 File Slice 来描述一个 File Group 在某个时间阶段对应的文件集合。这个概念第一遍看起来有点绕,但其实不用想得太复杂,可以先把它理解成:File Group 在某个时间点上的一个数据版本。
一个 File Slice 中,通常会包含一个 Base File;对于 Merge On Read 表来说,还可能包含一组与之对应的 Log File。
Base File 最常见的格式就是 Parquet,它保存的是某个阶段相对完整的数据。而 Log File 记录的则是 Base File 生成以后又发生的增量变化。
比如某条记录原来在 Base File 中是:
order_id = 1002
status   = unpaid
后来状态发生变化,在 MOR 表中,这次变化并不一定马上重写整个 Base File,而可以先记录在 Log File 中:
order_id = 1002
status   = paid
因此,同一个 File Group 随着时间推进,可能不断产生新的 File Slice。Base File 和 Log File 到底如何变化,也正是后面我们要讲 CoW 和 MoR 两种表类型的核心区别。
5. Timeline
假设一张 Hudi 表已经运行了很长时间,目录里可能同时存在新旧 Base File、多个 Log File,甚至还有某次失败写入留下来的文件。
Hudi 还必须知道:哪些操作已经成功完成,哪些文件属于当前有效版本。
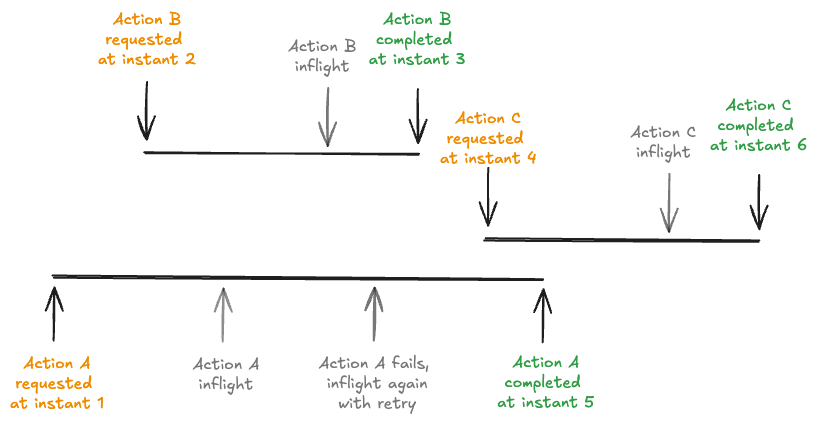
这就是 Timeline 的作用。如果把 Parquet / Log File 看作真正存放业务数据的地方,那么 Timeline 更像这张表的"操作历史"。
Hudi 会记录这张表发生过哪些写入、哪些操作已经完成、哪些还在执行,以及 Compaction、Cleaning、Rollback 等表服务。官方把 Timeline 称为 Hudi 表状态的 source of truth,也就是判断表当前状态的重要依据。
理解到这里以后,一张 Hudi 表就不再只是"某个目录下面放着很多 Parquet 文件"了。它实际上同时具备了业务记录的标识、数据分区、文件版本组织,以及表状态管理这几层能力。
三、Hudi 两种表类型:CoW 与 MoR
前面已经知道,Hudi 会通过 File Group、File Slice 等结构管理数据的不同版本。那么当一条已经存在的记录再次发生更新时,新的数据到底应该怎样落盘?
同样是一条 Update,Hudi 到底选择什么时候完成新旧数据的合并?
Hudi 提供了两种最基本的表类型:Copy On Write(CoW) 和 Merge On Read(MoR)。
两者最终都希望让我们看到一张正确的最新表,只不过它们选择了不同的时机去完成新旧数据的合并。
简单来说,CoW 更倾向于在写入阶段把事情处理完,而 MoR 则允许先记录增量变化,再在后续读取或者 Compaction 时完成合并。
1. Copy On Write:写入时完成合并
CoW 的思路比较直接:更新发生时就把新旧数据合并好,然后生成新的 Base File。
可以理解成"写入时复制并生成新的文件版本"。假设某个 Base File 中原来保存着下面几条订单:
text
1001   unpaid
1002   unpaid
1003   paid
现在 order_id=1002 的状态变成了 paid。
Hudi 并不会直接打开原来的 Parquet 文件,把其中的 unpaid 原地修改成 paid。对于 CoW 表来说,Hudi 会读取受到这次更新影响的 Base File,把旧数据和新的更新记录进行合并,然后重新生成一个新的 Base File。
新的文件中,数据就会变成:
text
1001   unpaid
1002   paid
1003   paid
旧的 Base File 并不会继续作为当前最新版本使用,后续查询会读取新生成的文件版本。
CoW 的好处也正来自这里。数据在写入完成以后就已经整理好了,读取时只需要读取最新的 Base File,不需要再额外处理增量日志。
但它的代价同样很明显。如果一个几百 MB 的 Base File 中只有少量记录发生变化,为了完成这次更新,仍然可能需要重新生成整个 Base File。更新越频繁,这种文件重写带来的写放大就越明显。
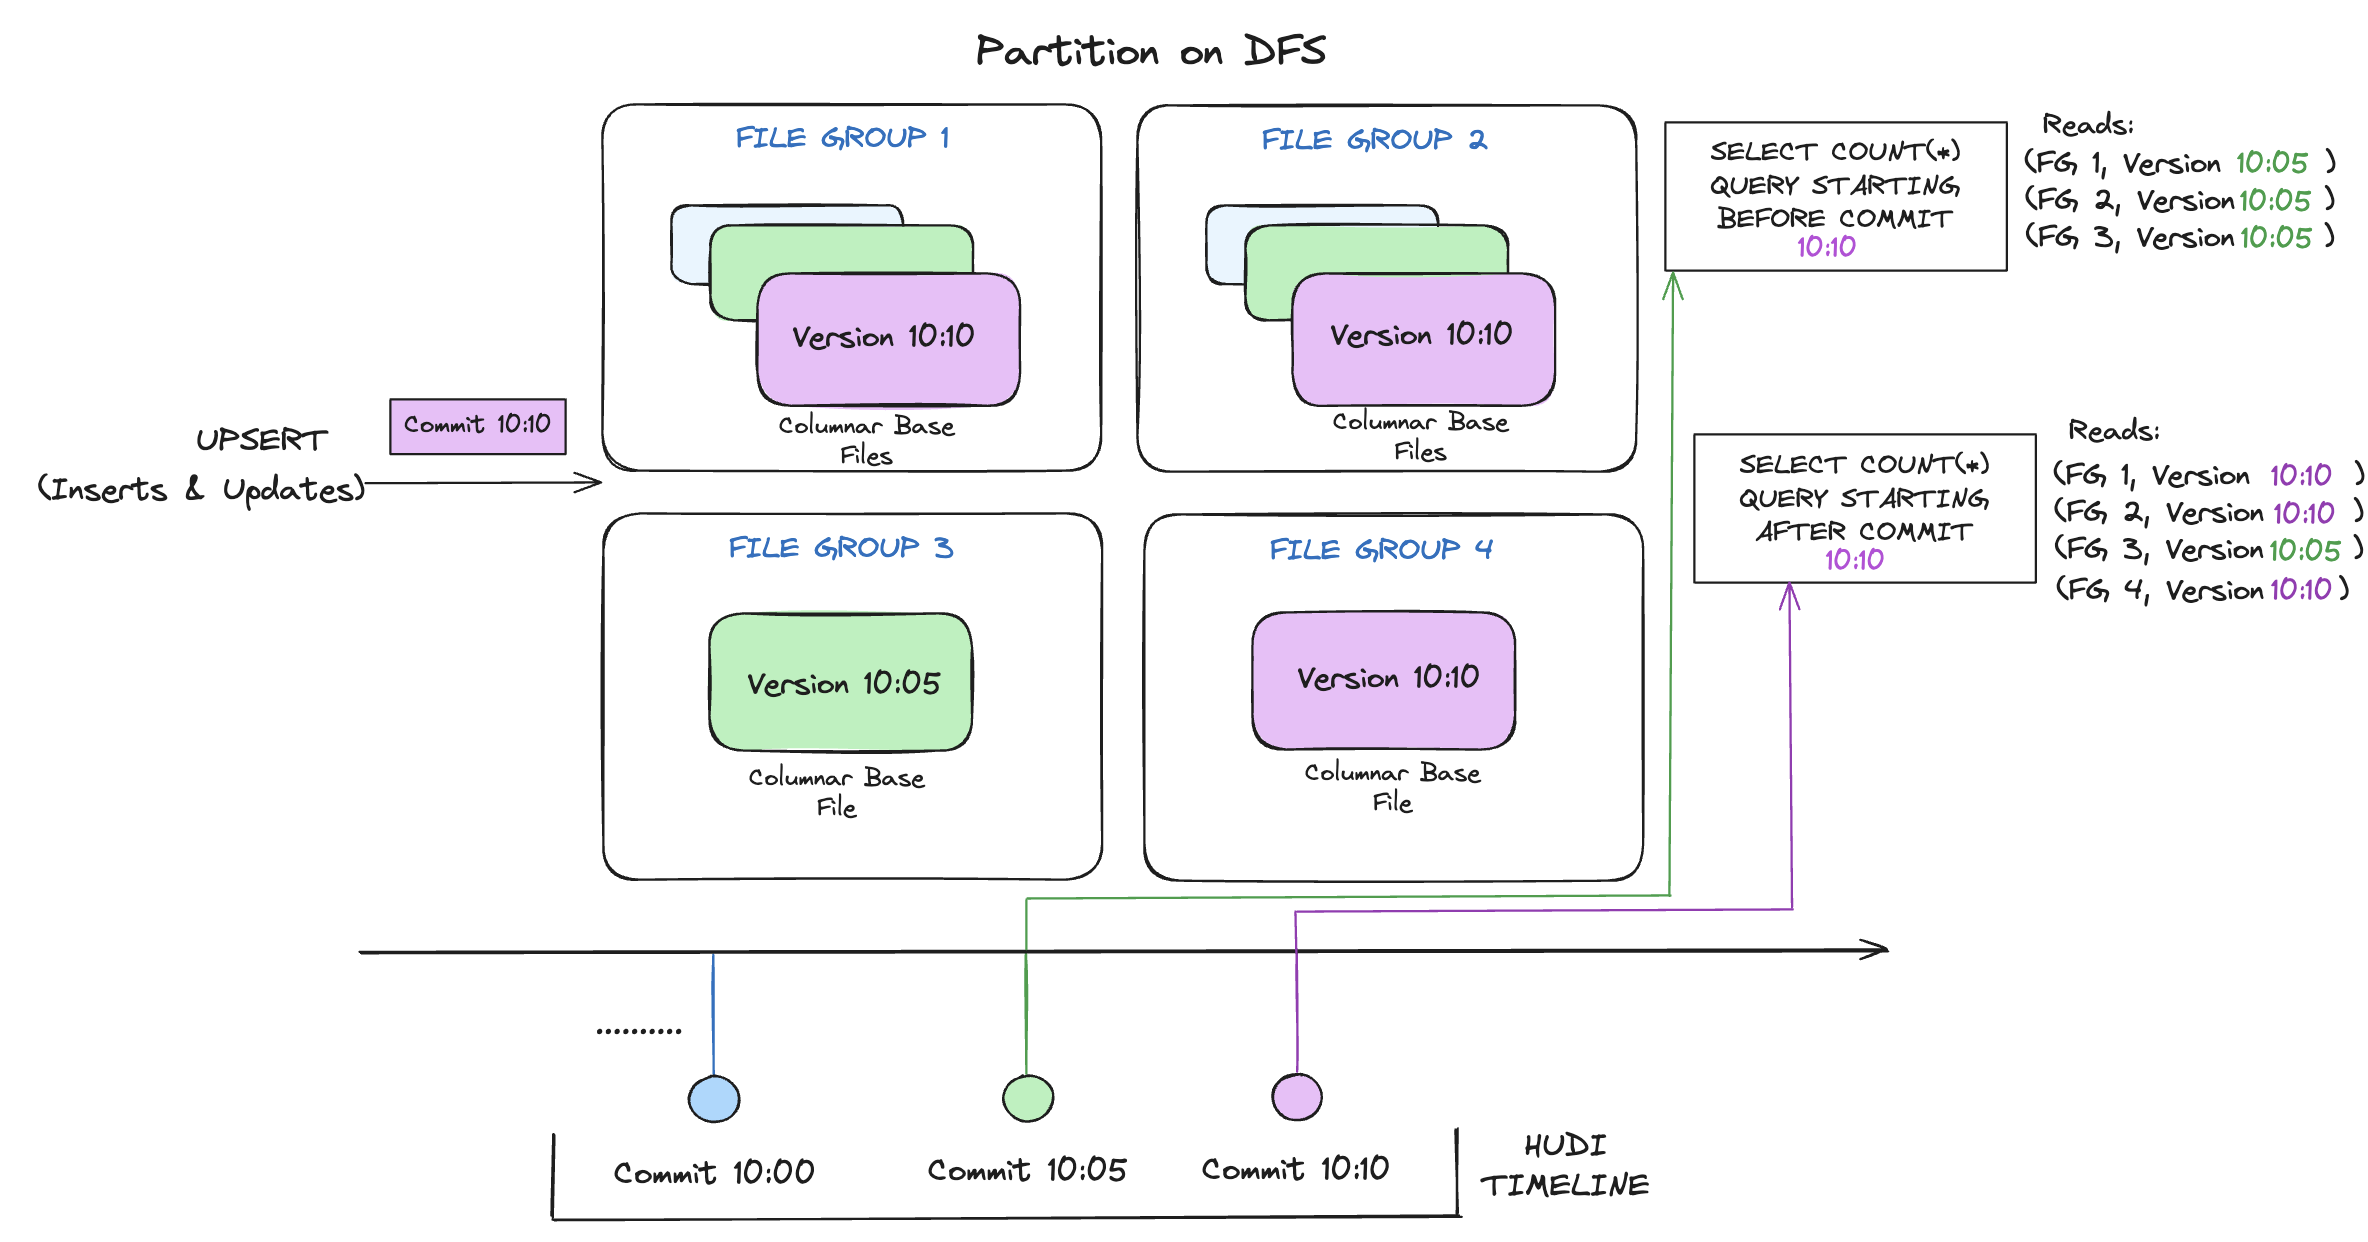
因此,CoW 的核心特点可以理解为:**把更多合并成本放在写入阶段,以换取更加直接的读取过程。**官方同样将 CoW 描述为更偏向 read-heavy workload 的表类型。
2. Merge On Read:先记录变化,再逐步合并
Merge On Read 的思路与 CoW 不同。
如果每次少量更新都立即重写一个较大的 Base File,在更新比较频繁的场景下成本会很高。因此 MoR 允许把一部分增量变化先写入 Log File,而不是每次都立刻重新生成 Base File。
还是以 order_id=1002 为例。最开始,Base File 中保存的是:
1002 unpaid后来订单完成支付,产生了一次更新:
1002 paid过了一段时间,这笔订单又进入发货状态:
1002 shipped在 MoR 表中,这些变化可以暂时保留在 Log File 中 。此时磁盘上的状态可能是:Base File 仍然保存着 unpaid,而后续的 paid、shipped 则记录在与这个 Base File 对应的 Log File 中。
这并不意味着查询结果会一直停留在 unpaid。当我们读取最新的 Snapshot 时,Hudi 会结合 Base File 和相关 Log File 中的变化进行合并,最终得到这条订单当前真正的状态,也就是:
1002 shipped因此,MoR 本质上是把"文件重写"这件事情推迟了。更新刚到来的时候,可以先以增量形式写入 Log File,从而避免每次少量变化都立即重写较大的 Base File。
当然,这些 Log File 也不能无限累积。如果一个 File Slice 后面挂着越来越多的 Log,那么每次读取最新数据都需要进行越来越多的合并工作。
为了解决这个问题,MoR 中还有一个非常重要的 Table Service:Compaction。
Compaction 会读取某个 File Slice 中已有的 Base File 和积累的 Log File,把其中的数据重新合并,最终生成一个新的 Base File。完成之后,之前分散在 Base 和 Log 中的最新状态就重新整理到了新的 Base File 中。
所以,MoR 并不是"不重写 Parquet",而是不要求每一次 Update 都立刻重写 Parquet,而是允许把多次增量变化积累起来,再在合适的时候统一整理。
因此,CoW 和 MoR 的区别,本质上是在选择什么时候付出合并成本。
- CoW 倾向于在写入阶段就完成合并。每次 Update 都可能伴随着 Base File 的重新生成,因此写入成本相对更高,但数据一旦写入完成,查询时只需要读取最新的 Base File,整体逻辑更加直接。
- MoR 则允许把部分增量变化先写入 Log File,避免每次少量更新都立即重写 Base File。不过,这部分成本并没有消失,而是被延后到了读取和 Compaction 阶段:在 Log 尚未被合并之前,Snapshot Query 可能需要同时读取 Base File 和 Log File 才能得到最新结果。
到底选择哪一种,并没有绝对答案,而是要看实际业务中更新频率、查询方式、实时性要求以及能够接受的读写成本。
以我目前接触的互联网广告场景为例,一次竞价产生之后,后续还可能不断收到曝光、点击、安装、转化等事件,这些事件会持续补充或更新同一个 bid_id 对应的宽表记录。相比每次后链路事件到达都立即重写 Base File,这类更新频繁、增量变化持续到达 的场景更适合采用 MoR,将增量更新先写入 Log File,再通过后续的 Compaction 统一整理。因此,我们实际使用的 Hudi 表也选择了 Merge On Read。
四、一次 Upsert 大概发生了什么
前一节我们讨论了 CoW 和 MoR,解决的是"数据发生更新以后应该怎么落盘"的问题。但在真正写入之前,其实还有一个更基础的问题:Hudi 怎么知道这条数据到底是新增,还是对已有记录的一次更新?
这就是 Upsert 要解决的事情。
Upsert 可以理解为 Insert 和 Update 的结合。假设这一批数据中同时来了两条订单:
order_id=1002, status=paid
order_id=1006, status=unpaid
其中 1002 在 Hudi 表中已经存在,那么这次写入应该更新原来的订单;而 1006 如果从来没有出现过,就应该作为一条新的记录插入。
问题是,当一张 Hudi 表已经有几十亿甚至上百亿条数据时,为了判断 1002 是否存在,显然不可能每次都把所有 Parquet 文件扫描一遍。Hudi 必须想办法先找到这条记录原来存在哪里。
这时候 Index 就派上用场了。
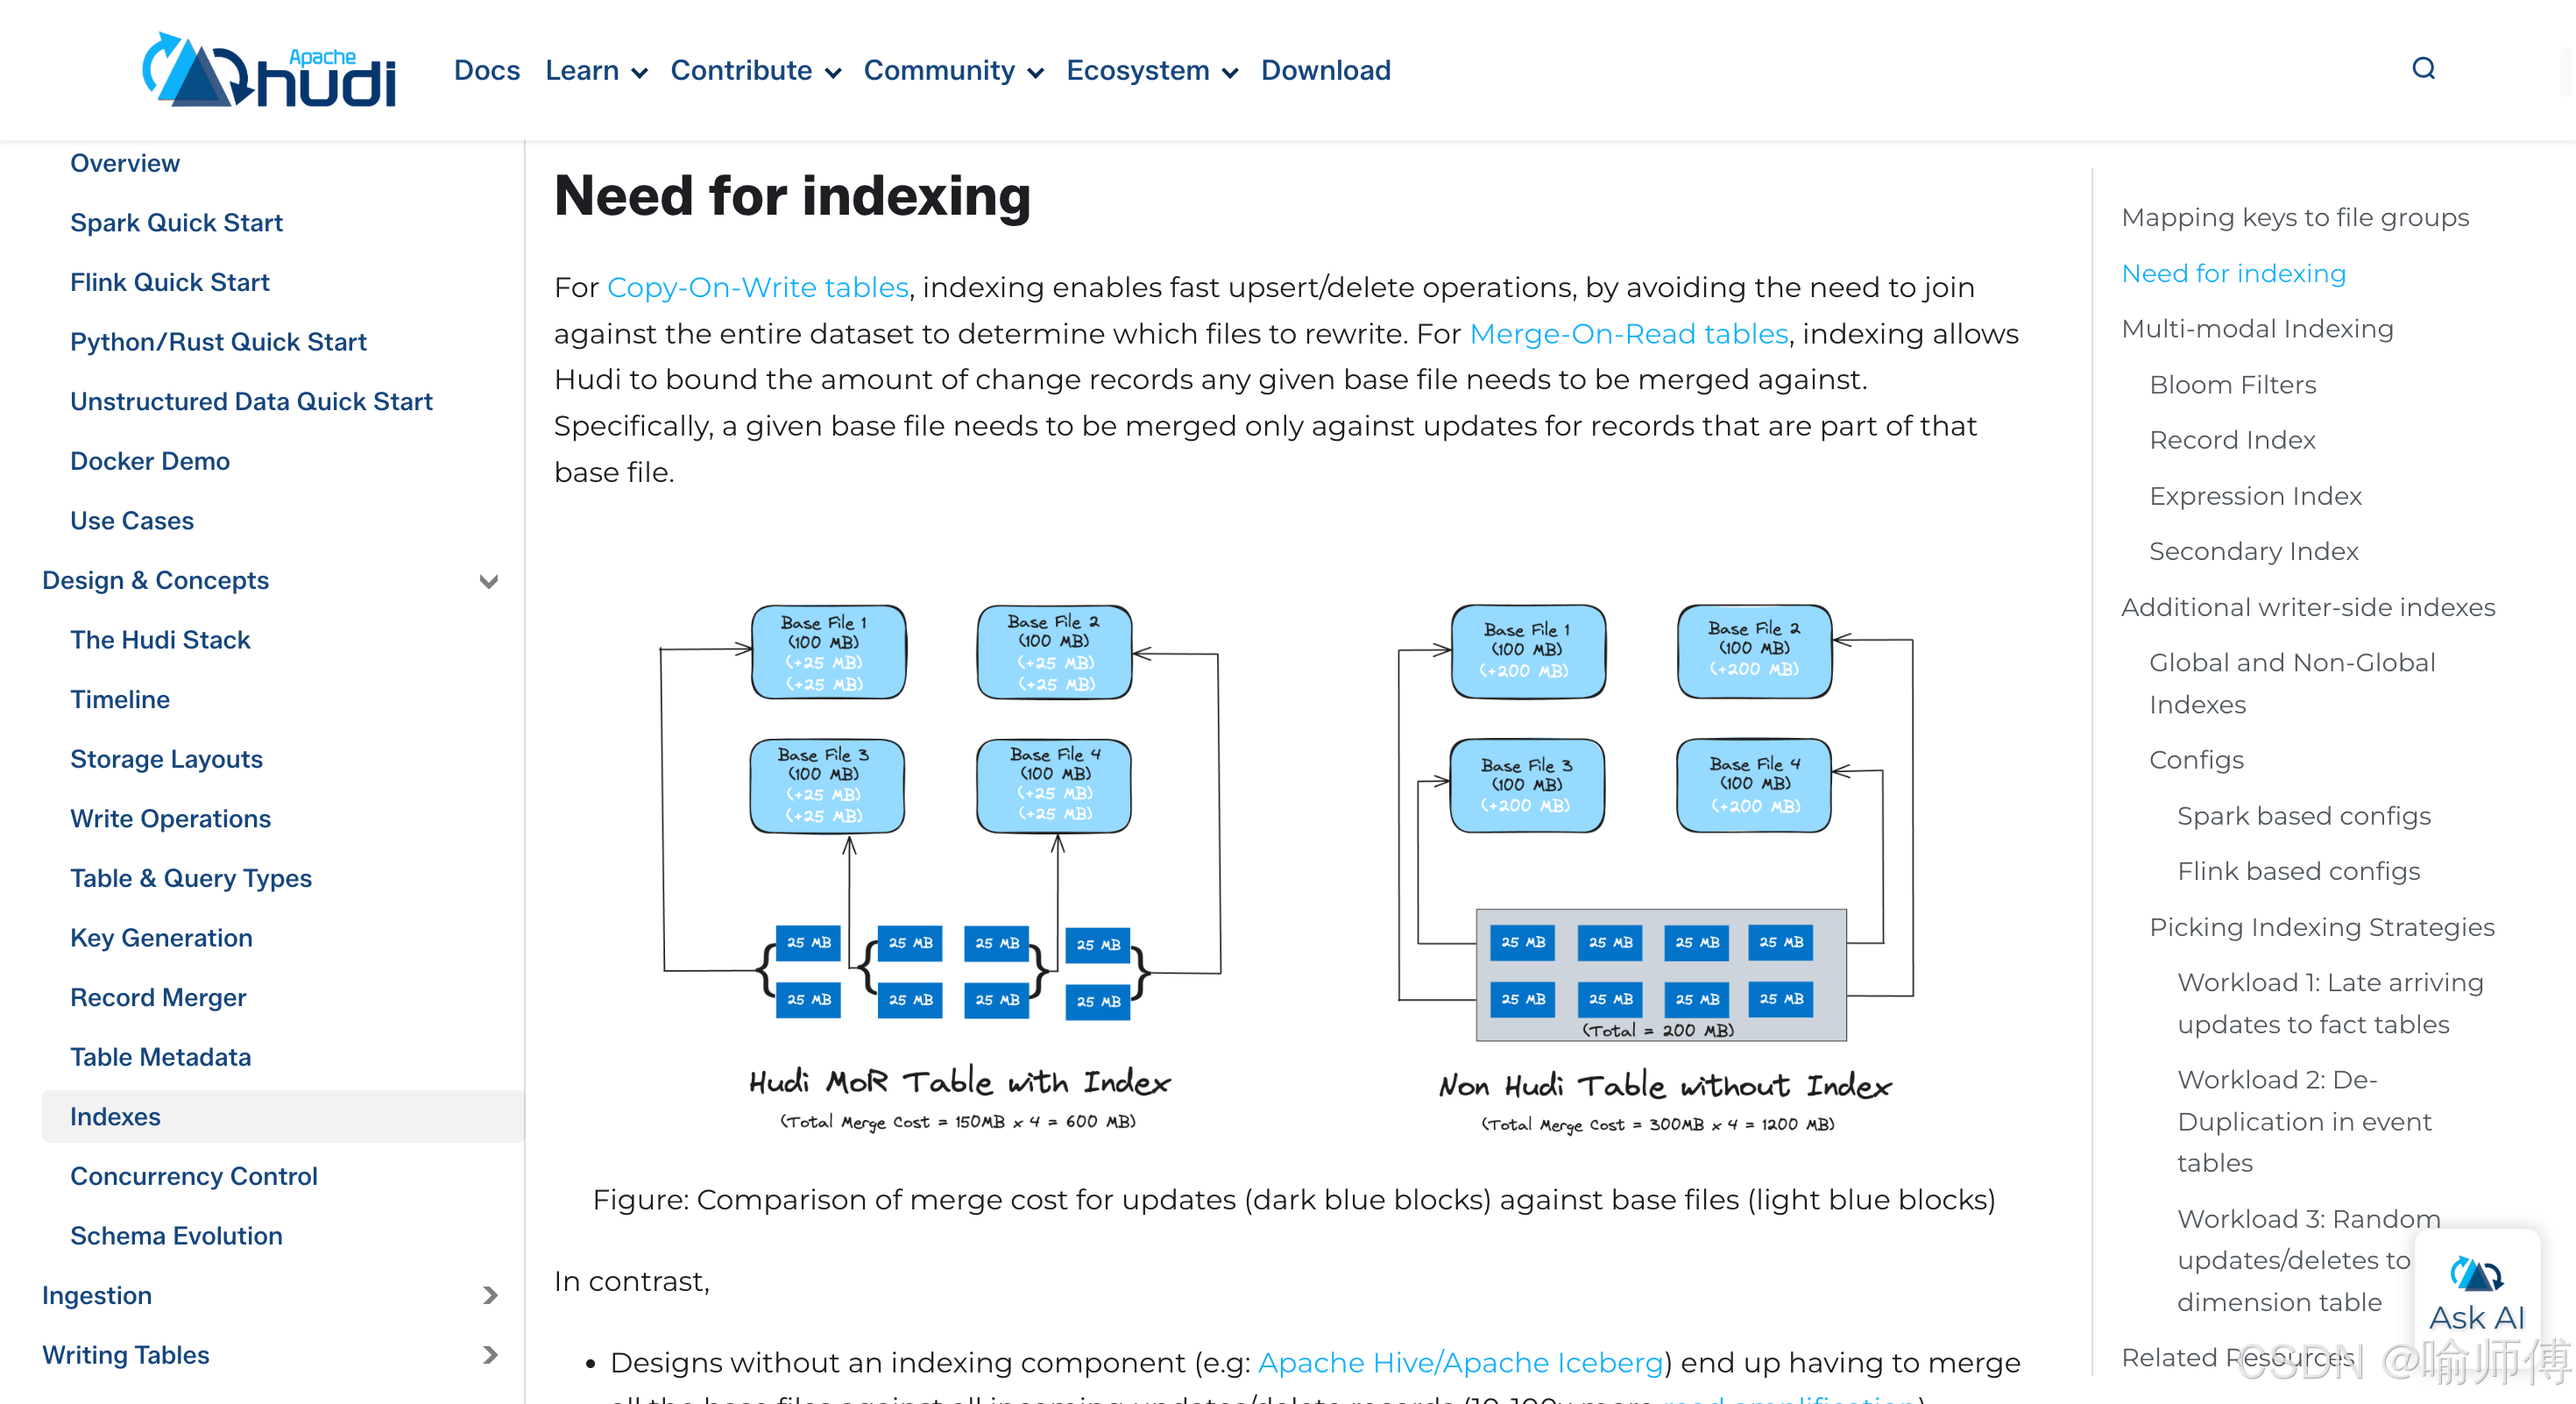
Hudi 提供了不同的索引机制,具体实现方式并不完全相同,但它们在 Upsert 过程中都有一个很重要的目标:帮助 Writer 判断某个 Record Key 是否已经存在,并尽可能定位到它所在的 File Group。
例如目前组内使用的 Bloom Index 会利用 Bloom Filter 快速排除大量"不可能包含这个 Record Key"的文件。假设一个分区下面有很多 Base File,当 order_id=1002 到来以后,Hudi 不需要逐个读取所有文件,而是可以先过滤掉大部分不可能命中的文件,再对剩下的候选文件继续判断。
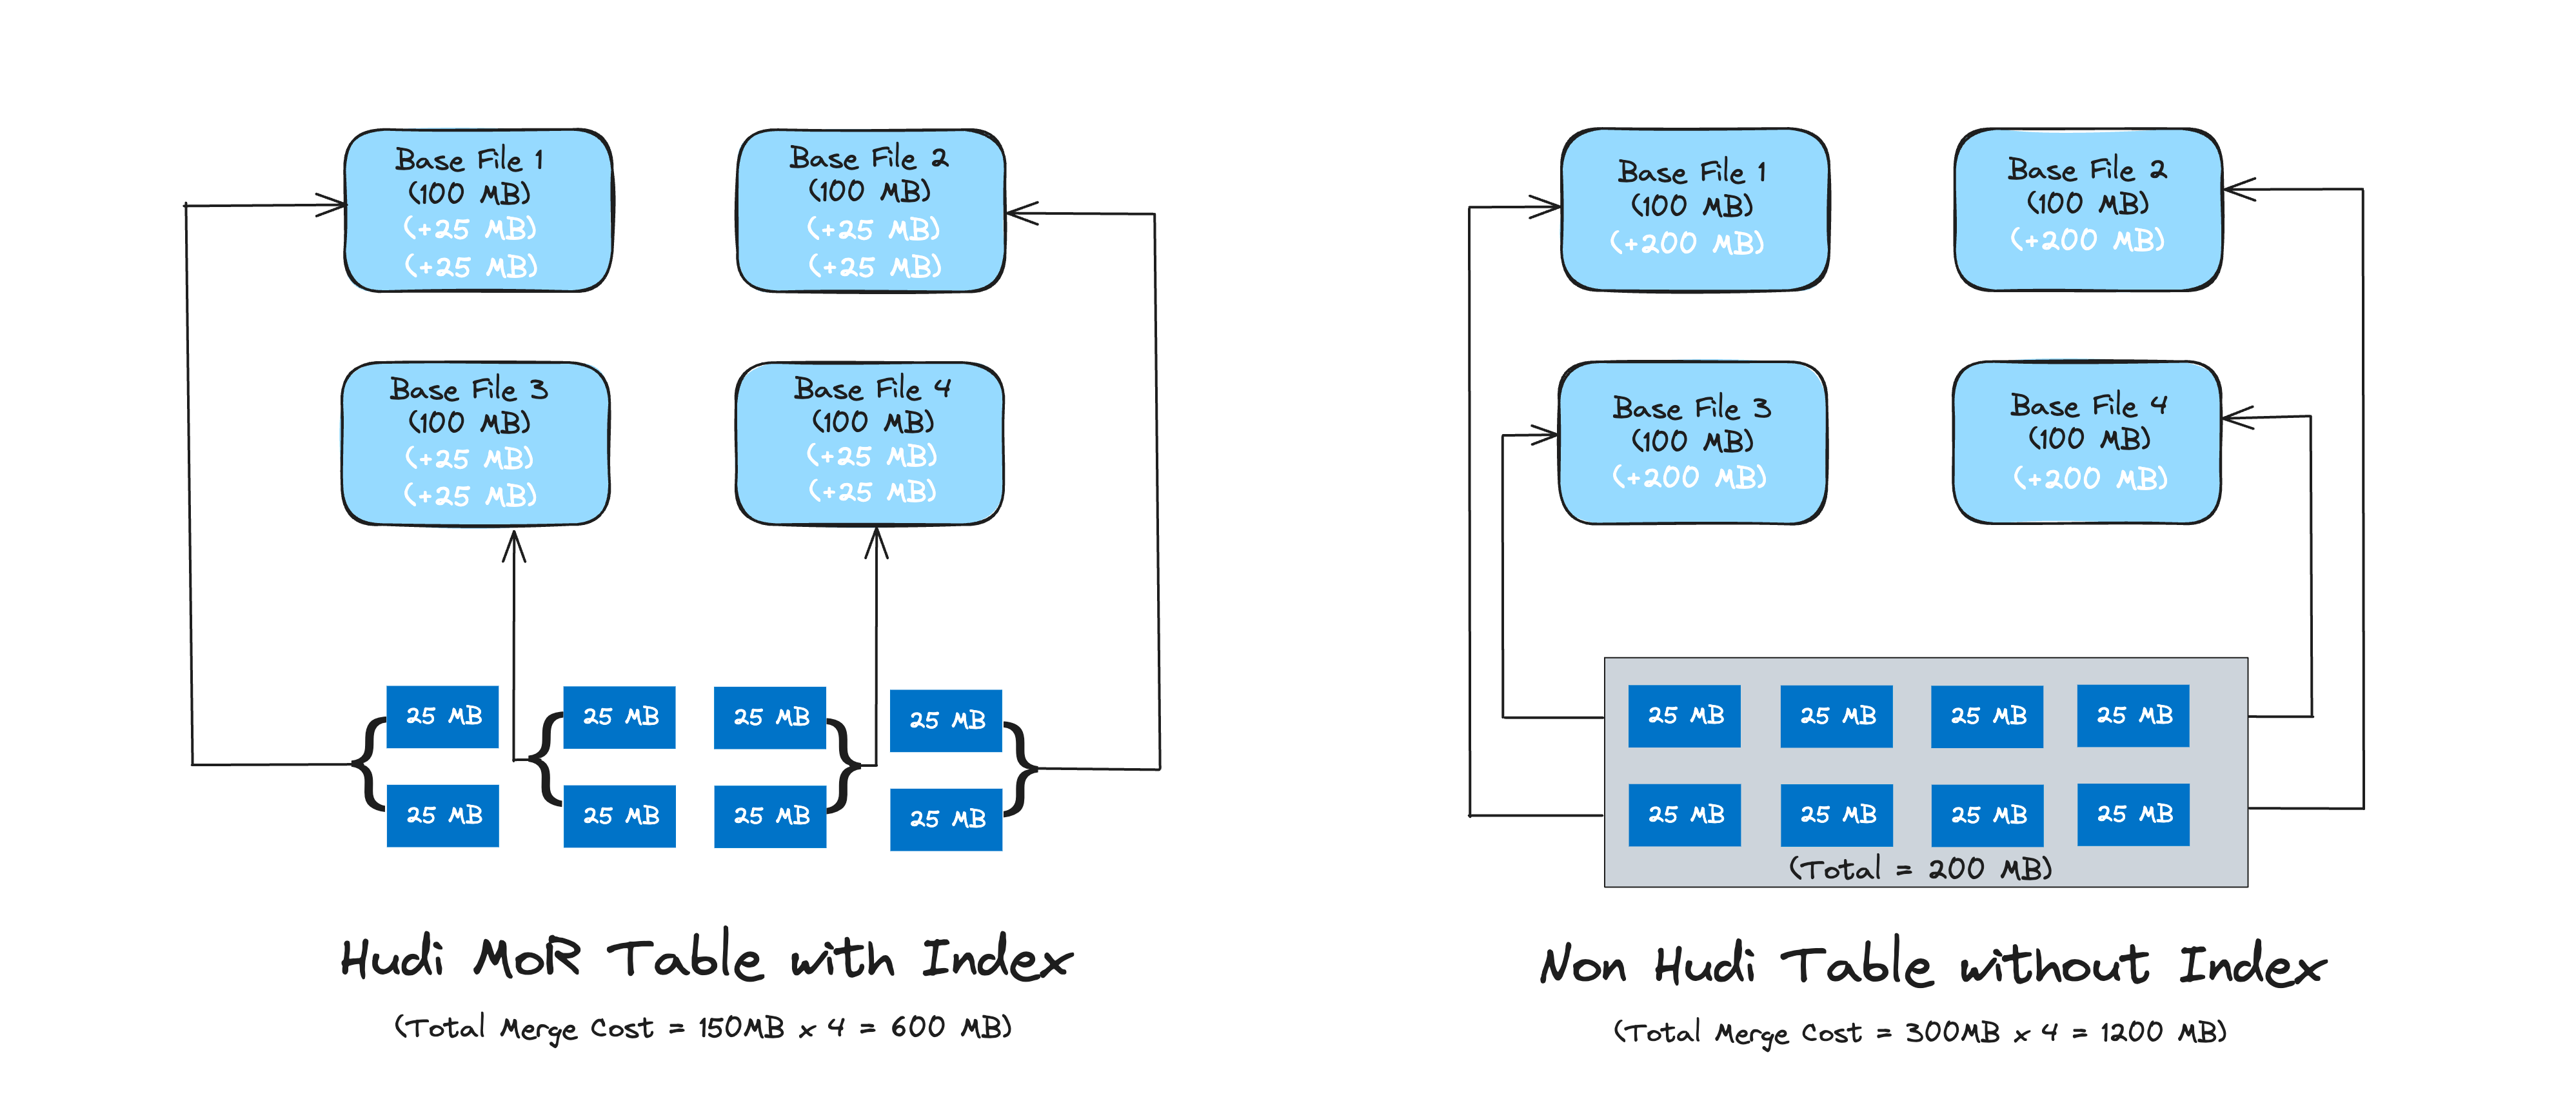
这里其实也能看出 Hudi Index 和传统数据库索引的一点区别。我们平时说 MySQL 索引,首先想到的可能是加速 SELECT;而 Hudi 中的 Index 很重要的一个用途,是服务于写入过程------当一条旧记录再次到来时,帮助 Hudi 找到它原来属于哪个 File Group。
接下来 Hudi 还需要考虑一个问题:新的数据应该怎么和原来的数据合并?
如果只是订单状态从 unpaid 变成 paid,这个问题还比较简单。但真实业务里的更新往往复杂得多。
比如用户画像或者广告生命周期宽表,一条记录可能并不是一次性完整产生的。一次广告竞价最开始只有请求和竞价信息,之后又陆续到达曝光、点击、安装、转化等后链路事件。后面到来的数据可能只包含其中几个字段,而不是一条完整的新记录。
这时候,简单地让"新的一整行覆盖旧的一整行"就不一定正确了。
有些字段可能希望保留第一次发生的时间,有些字段可能需要累计,还有些字段则允许新值覆盖旧值。因此,同一个 Record Key 对应的新旧数据到底如何形成最终记录,还会涉及 Hudi 的 Record Merger、Payload,以及业务本身定义的更新规则。
这一点其实非常重要:Hudi 可以提供记录合并的机制,但什么样的数据才算业务上正确的新状态,并不一定能够靠一个统一的 update_time 来决定。
我们实际接触的广告宽表就是一个很典型的例子。同一个 bid_id 后面会不断补充 click、install、conversion 等信息,不同字段甚至可能拥有完全不同的更新逻辑。因此,在真正写入 Hudi 之前,业务层往往已经需要先处理一部分字段级的合并规则。
等到旧记录的位置找到了,新旧数据也确定了应该如何合并,才真正轮到前一节介绍的 CoW 和 MoR。
如果是一张 CoW 表,受影响的 Base File 会在本次写入过程中完成数据合并并生成新的 Base File;如果是一张 MoR 表,则可以把这次增量变化先写入 Log File,之后再通过读取时合并或者 Compaction 整理到新的 Base File 中。
也就是说,Index、Record Merge 和 CoW/MoR 其实解决的是三个不同的问题:Index 负责找旧数据,Merge 负责决定新旧记录最后应该变成什么样,而 CoW/MoR 决定这些变化最终以什么方式落到文件上。
文件写完以后,这次 Upsert 也还不能马上被认为已经成功。一次写入可能同时涉及多个 Partition、多个 File Group 和多个 Spark Task,如果任务执行到一半失败,存储中可能已经出现了一部分新文件。Hudi 不能因为这些文件已经存在,就直接把它们当成表的有效数据。
因此,最后还需要通过 Timeline 管理这次写入的提交状态。只有当这次操作真正完成之后,它才会成为 Hudi 表中的一个有效版本;如果写入过程中发生异常,也可以通过 Rollback 等机制处理未完成的操作。
所以回过头来看,Upsert 远不只是"有就更新,没有就插入"这么一句话。它背后实际上包含了对旧记录的定位、新旧数据的合并、物理文件的更新,以及最终提交状态的管理。
这也是 Hudi 和"直接往对象存储里写一批 Parquet 文件"之间非常重要的区别:Hudi 管理的不只是数据文件本身,还管理这些数据是如何一步步变成表中正式版本的。
五、Hudi 怎么查询
前面我们已经把一条数据从 Upsert、Merge 一直到最终提交的过程串了起来。数据成功写入以后,还有一个很自然的问题:面对一张不断发生变化的 Hudi 表,我们到底应该读取哪个版本的数据?
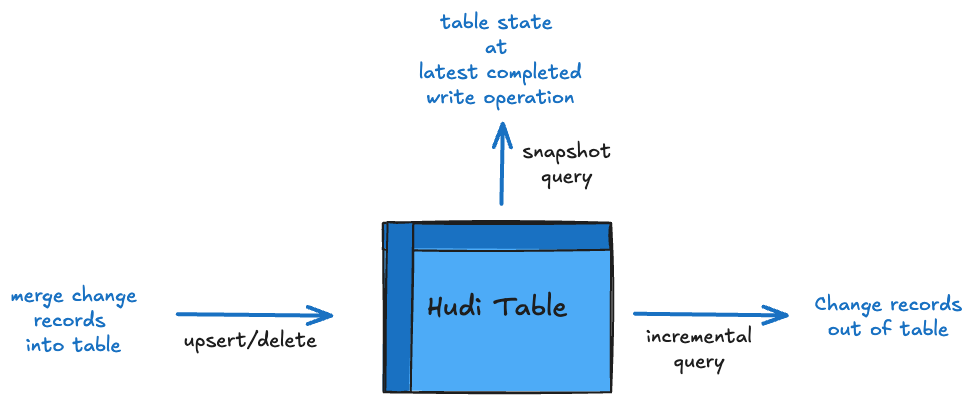
如果只是普通的 Parquet 数据集,这个问题通常并不存在。目录里有哪些文件,查询引擎就读取哪些文件。但 Hudi 不一样,一条记录可能经历多次更新,同一个 File Group 也可能同时存在 Base File 和 Log File,因此"读取这张表"本身就有了不同的含义。
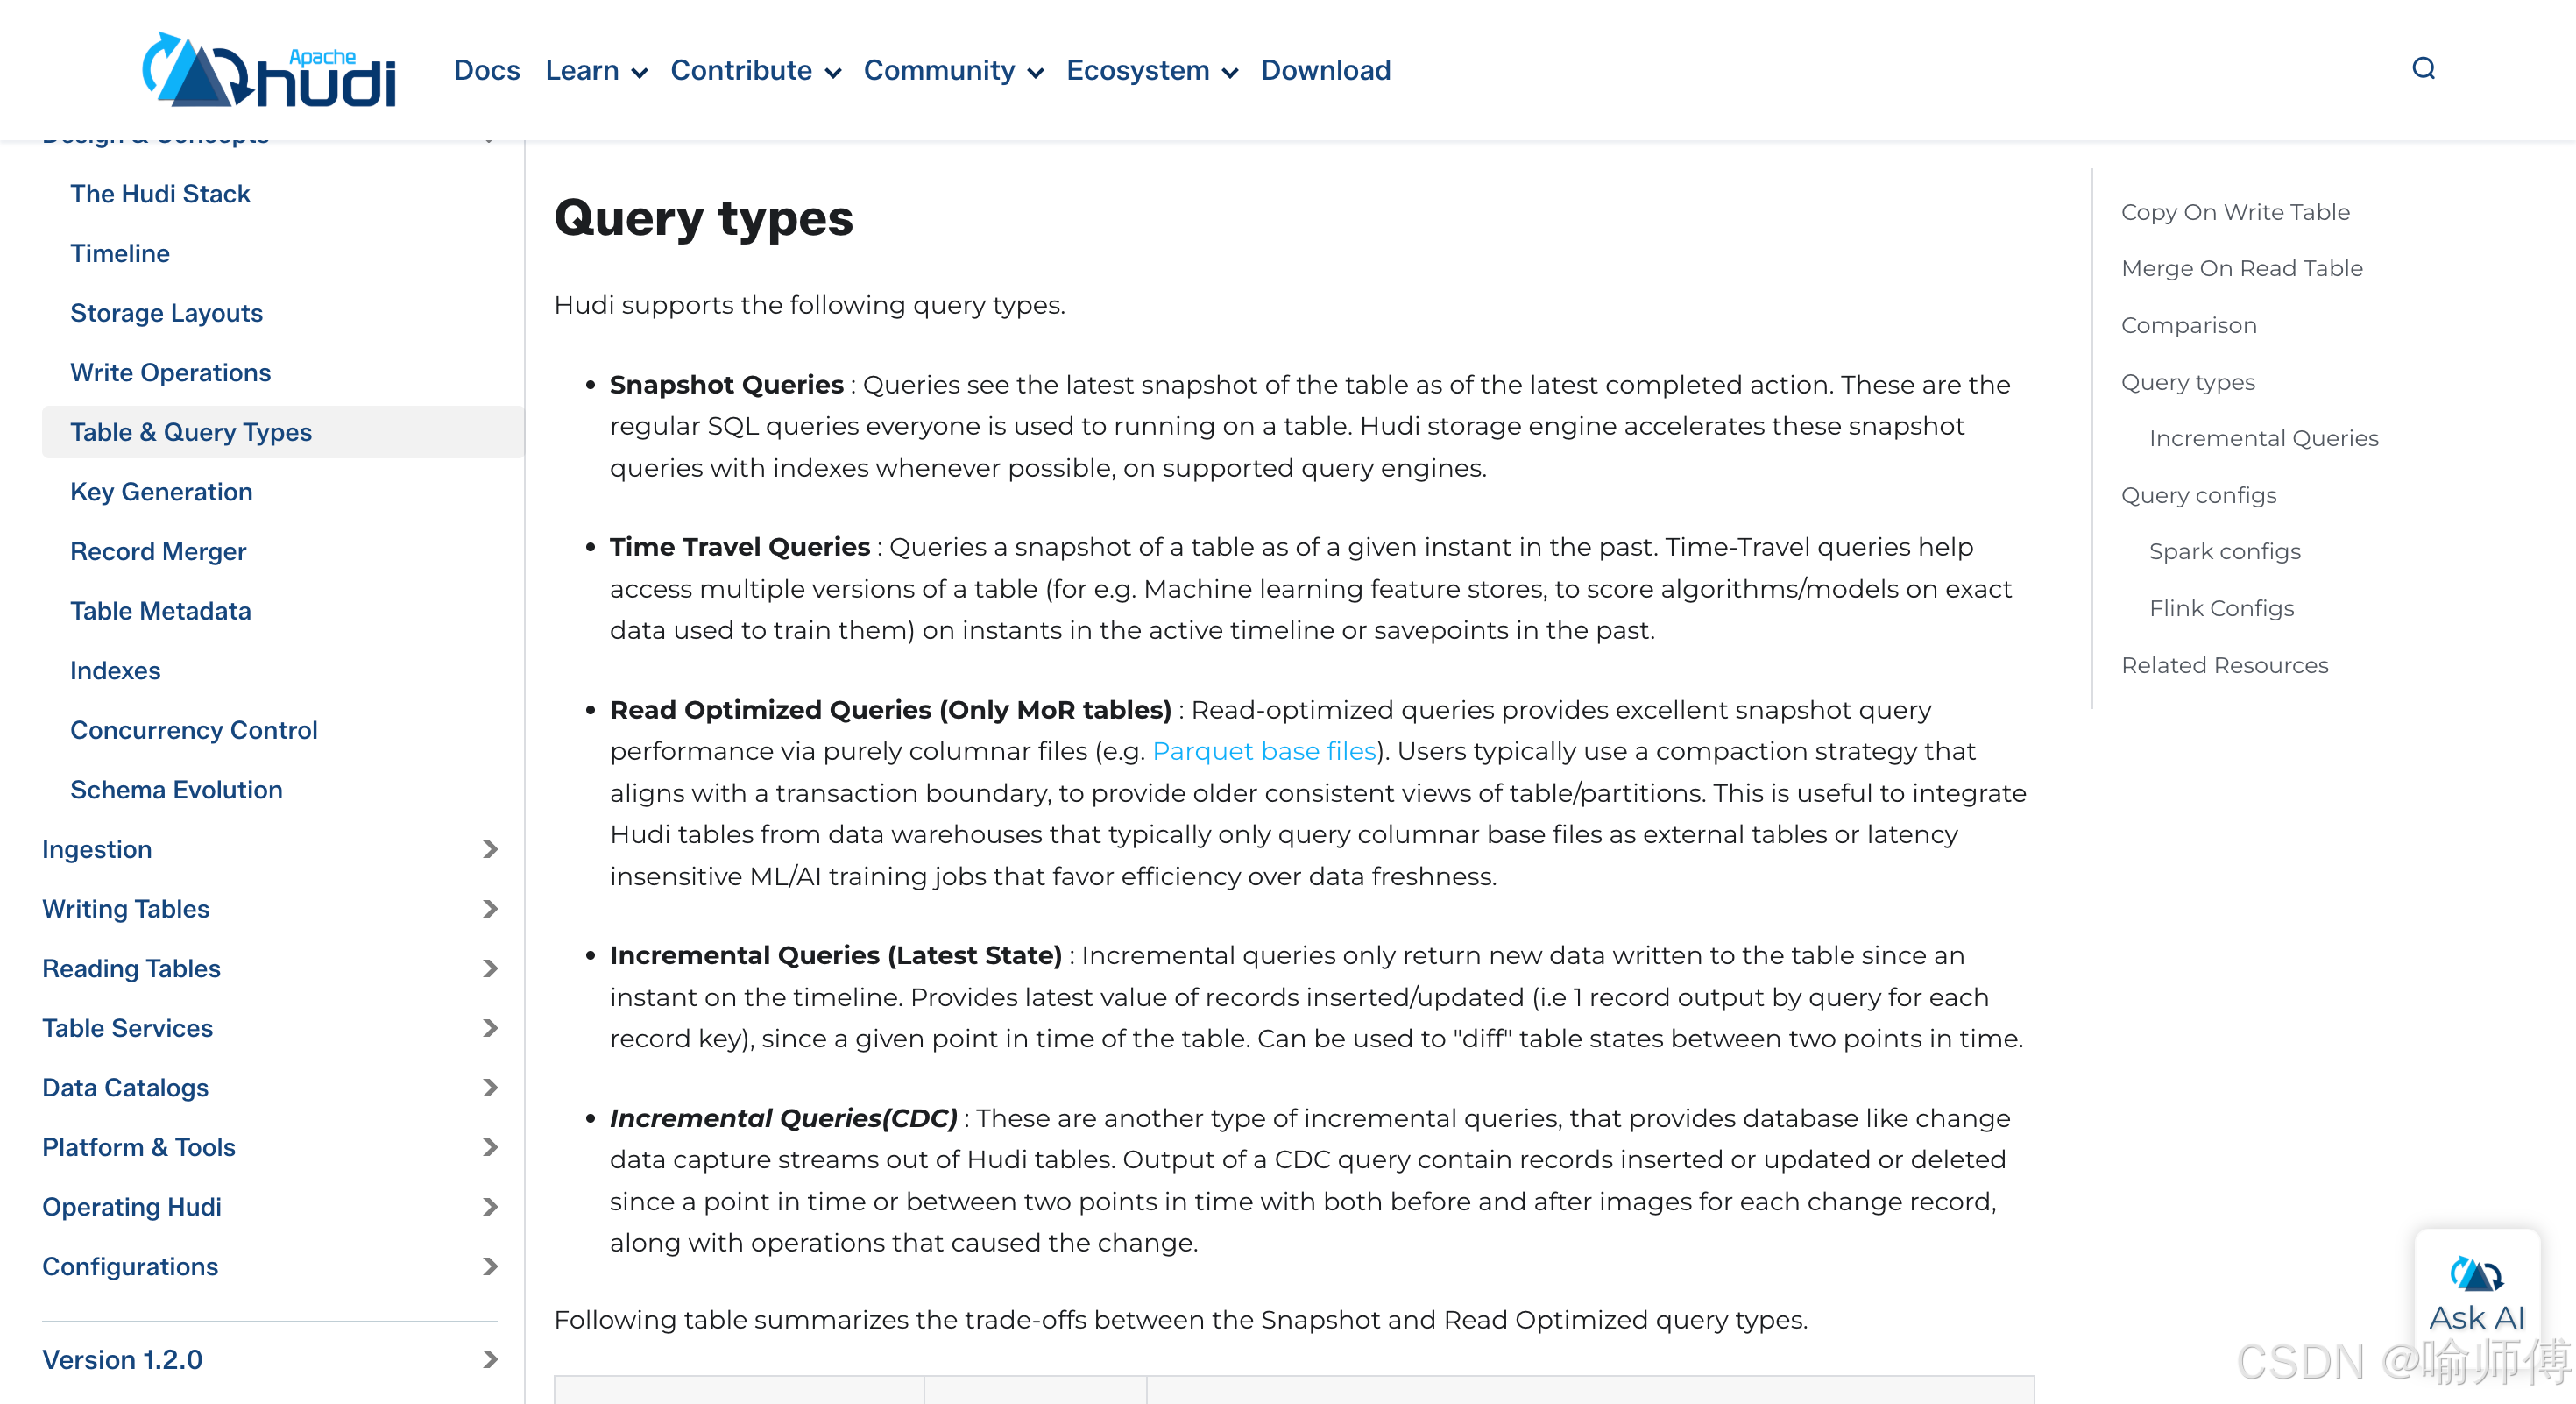
1.Snapshot Query
最常见的是 Snapshot Query 。它关心的是这张表当前最新的已提交状态,也就是我们平时最容易理解的"现在这张表是什么样"。官方目前也是这样定义 Snapshot Query:读取截至最新已完成操作时的表快照。
-
对于 CoW 表来说,这件事情比较简单,因为更新在写入阶段已经合并到了新的 Base File 中,查询最新的 Base File 即可。
-
对于 MoR 表来说,如果最近的变化还保存在 Log File 中,Snapshot Query 就需要结合 Base File 和 Log File 才能还原出最新结果。也就是说,即使磁盘上的 Base File 还是旧状态,只要后面的 Log 中已经记录了新的变化,Snapshot Query 依然能够看到最新的数据。
例如一笔订单最开始是:
order_id=1002, status=unpaid后来更新为 paid,又更新为 shipped。如果这是一张 MoR 表,而后两次变化暂时还在 Log File 中,那么直接看 Base File 可能仍然只能看到 unpaid,但通过 Snapshot Query 得到的应该是当前最新状态 shipped。
2.Time Travel
不过,有时候我们并不关心"现在",而是想知道:**昨天某个时间点,这张表是什么样?**这就是 Time Travel(时间旅行)。
因为 Hudi 会通过 Timeline 管理一张表不同时间点的状态,所以我们可以指定过去的某个 instant,查询当时对应的表快照。比如某条订单今天已经变成了 shipped,但如果回到昨天晚上,它当时可能还只是 paid。Time Travel 读取的就是那个时间点对应的状态。官方目前将它定义为查询过去某个 instant 对应的 Snapshot。
当然,这并不意味着历史数据会被永久保存。Hudi 还存在 Cleaning、Timeline Archival 等机制,因此到底能回到多早以前,最终还是取决于表的历史数据和版本保留策略。这里我们先知道 Time Travel 能解决"过去是什么样"这个问题即可。
3.Incremental Query
还有一种场景在数据仓库中非常常见:下游任务昨天已经处理过这张表,今天只想知道从上一次处理完成以后,又有哪些记录发生了变化。
即从时间 A 到时间 B,到底有哪些数据发生了变化?
如果每次都重新扫描整张几十亿行的大表,显然会浪费大量计算资源。Hudi 的 Incremental Query 就是为这种场景准备的。
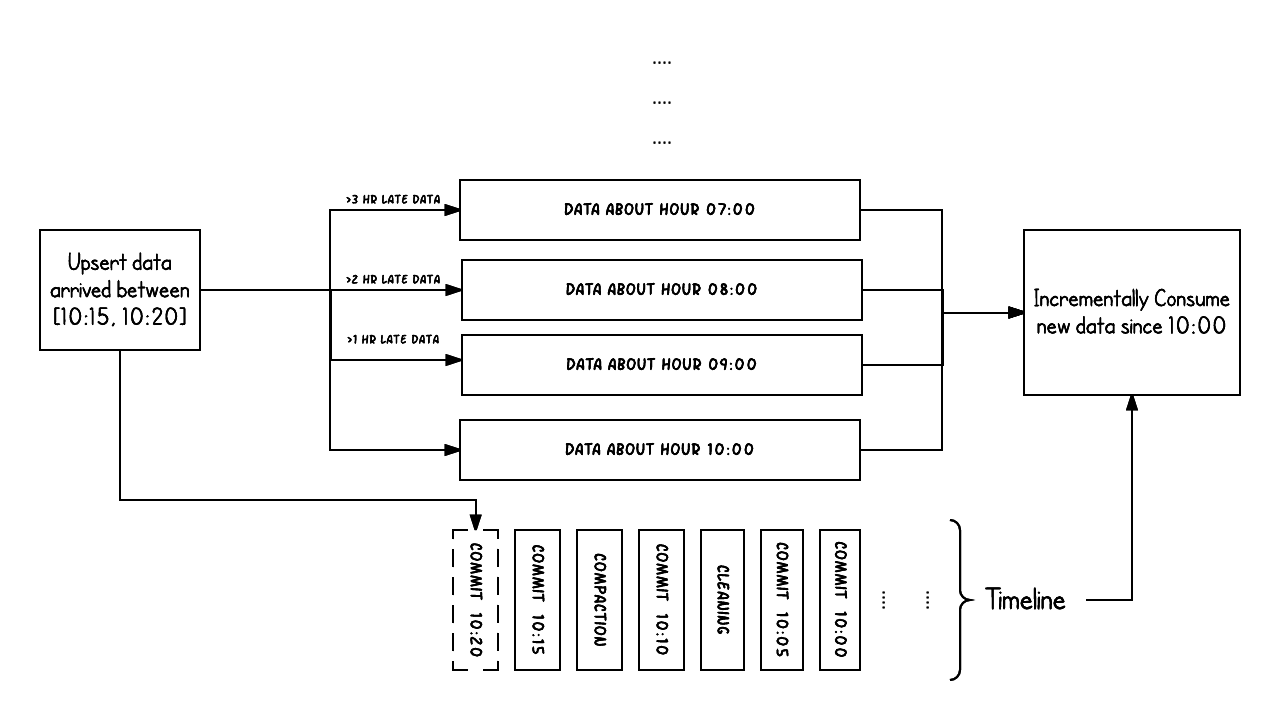
它可以根据 Timeline 上的 instant,从某个时间点开始只读取后续新写入或者发生更新的数据,而不是重新消费整张表。
当前官方文档中的 latest-state incremental query,会返回指定时间范围内发生变化的 Record Key 的最新值,因此很适合用来构建增量 ETL 和上下游数据同步任务。
4.Read Optimized Query
对于 MoR 表,还有一种比较特殊的读取方式,叫 Read Optimized Query。
前面提到,MoR 的最新变化可能还停留在 Log File 中。如果每次查询都要求读取 Base File 并合并 Log,虽然能获得最新数据,但也会增加额外的读取和 Merge 成本。
Read Optimized Query 选择了另一种方式:只读取已经整理好的 Base File,不去合并还没有完成 Compaction 的 Log File。 这样可以保持纯 Parquet 列式读取的效率,但代价是看到的数据可能会比 Snapshot Query 稍旧一些。
官方也明确指出,Read Optimized 是 MoR 特有的查询方式,它以数据新鲜度换取更低的查询延迟。
因此,这几种查询方式其实并不难区分。Snapshot 关心的是当前最新状态,Time Travel 关心过去某个时间点的状态,Incremental 关心一段时间内发生了哪些变化,而 Read Optimized 则是在 MoR 表中选择只读取已经整理好的 Base File。
它们背后其实都依赖同一个基础:Hudi 不仅保存数据文件,还通过 Timeline 管理数据在不同时间点的版本状态。
这也是为什么我们前面一直在强调 Timeline。没有这些版本和提交信息,Hudi 就很难准确回答"现在是什么样""过去是什么样"以及"这段时间到底发生了什么变化"这些问题。
6. 什么样的场景适合使用 Hudi
到了现在这个阶段,我越来越觉得,学习一个技术框架最重要的并不是记住多少 API 和配置,而是知道它解决什么问题,以及什么时候应该选择它。
尤其是在 AI 已经能够帮助我们写代码、查参数、补配置的情况下,工程师真正需要培养的能力,反而越来越偏向方案判断和技术取舍。因为工具可以告诉你 Hudi 怎么写,甚至可以帮你生成一套完整配置,但它很难替你决定:当前这个业务到底有没有必要使用 Hudi。
技术选型并不是找"功能最多"的框架,而是在当前业务约束下,选择成本和收益最匹配的方案。Hudi 能解决更新问题,但同时也会带来索引、Compaction、文件管理和运维复杂度。如果业务根本没有持续更新的需求,那么"不使用 Hudi"本身也可能是更好的设计。
所以学到这里,比继续记更多概念更重要的问题其实是:什么样的数据场景值得引入 Hudi?
答案并不是"数据很多",也不是"底层用了 Parquet"就应该上 Hudi。Hudi 真正擅长处理的是这样一类问题:数据规模已经比较大,同时这些数据又不是写进去以后就不再变化,而是会持续发生新增、更新甚至删除。
换句话说,如果你的数据本身就是 Append Only,例如日志写进去以后基本不会修改,那么普通 Parquet 加上合理的分区设计可能已经足够,引入 Hudi 反而会带来 Timeline、Compaction、Cleaning、索引等额外的维护成本。
CDC 是一个很典型的例子。假设 MySQL 中的订单状态一直在发生变化,我们可以通过 Debezium、Canal 等工具读取 Binlog,再经过 Kafka、Spark 或 Flink,把这些变化持续同步到 Hudi。相比每天重新生成一份完整快照,这种方式更适合处理持续到来的增量变化,也能让数据湖中的数据更接近业务库的最新状态。
用户画像同样很符合这种模式。一个用户今天增加了一个标签,明天修改了会员等级,后天又补充了新的设备信息,我们通常希望这些变化最终都落到同一个用户实体上,而不是因为一个字段变化就重新生成整张画像表。
以及我目前接触比较多的互联网广告场景,其实也很有代表性。一次竞价产生以后,后面还会陆续出现曝光、点击、安装、转化等事件。这些事件可能跨小时甚至跨天到达,但最终又希望逐步补充到同一个 bid_id 对应的宽表记录中。对于这种"一个业务实体不断被后续事件补充"的场景,持续 Upsert 比单纯追加数据要自然得多,这也是我们实际使用 MoR 表的一个重要原因。
另外,Hudi 的价值也不只体现在写入端。如果下游任务只关心"上一次处理完成以后又发生了哪些变化",Incremental Query 可以让它继续消费新增和更新的数据,而不是每次重新扫描整张历史表。这对于增量 ETL、数据同步以及分层数仓链路都很有意义。
所以当数据湖中的数据开始从"静态文件"变成"持续变化的业务实体"时,Hudi 的价值才真正体现出来。
写在最后
回过头来看,Apache Hudi 的核心思想并没有想象中那么神秘。
数据最终依然存放在 Base File、Log File 这些文件中,只不过 Hudi 在文件之上增加了 Record Key、Index、File Group、Timeline 以及一系列 Table Service,从而让这些原本相对静态的数据文件拥有了类似数据库表一样的可变数据管理能力。
这篇文章本意只是想先把 Hudi 的整体轮廓搭起来。很多真正有意思的问题其实都还没有展开,比如 Bloom Index 到底怎么帮助 Hudi 找到一条旧记录,MoR 的 Log File 和 Compaction 是怎么配合的,复杂业务下新旧 Record 应该如何 Merge,以及 Timeline 又是怎样支撑 Commit、Rollback 和 Time Travel 的。
感兴趣的小伙伴可以关注合集,后续会持续更新。