💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜
目录
- 基于大数据的全国各地景点指数数据可视化分析介绍
- 基于大数据的全国各地景点指数数据可视化分析演示视频
- 基于大数据的全国各地景点指数数据可视化分析演示图片
- 基于大数据的全国各地景点指数数据可视化分析代码展示
- 基于大数据的全国各地景点指数数据可视化分析文档展示
基于大数据的全国各地景点指数数据可视化分析介绍
本系统名为《基于大数据的全国各地景点指数数据可视化分析》,是一套面向旅游景点数据的采集、存储、计算与可视化展示平台。系统以 Hadoop 分布式文件系统作为底层数据存储支撑,将全国各地景点的基础信息、游客流量、热度评分、季节波动等多源数据统一上传至 HDFS 进行管理,再借助 Spark 与 Spark SQL 完成数据清洗、聚合统计与指标计算,通过 Pandas 与 NumPy 对计算结果做进一步整理,最终将处理后的景点指数结果写入 MySQL 数据库,并由 Django 或 Spring Boot 提供后端接口,前端采用 Vue、ElementUI、ECharts、HTML、CSS、JavaScript 与 jQuery 完成页面渲染与图表展示。系统整体包含系统首页、用户管理、景区信息管理和景点指数分析四大模块,用户可以通过首页快速了解平台整体数据概况,在景区信息模块中查看各景点的详细资料,在景点指数分析模块中按照地区、时间、热度等维度观察景点指数的变化趋势,从而直观感受到大数据计算在旅游数据分析场景中的实际作用。
基于大数据的全国各地景点指数数据可视化分析演示视频
基于大数据的全国各地景点指数数据可视化分析演示图片
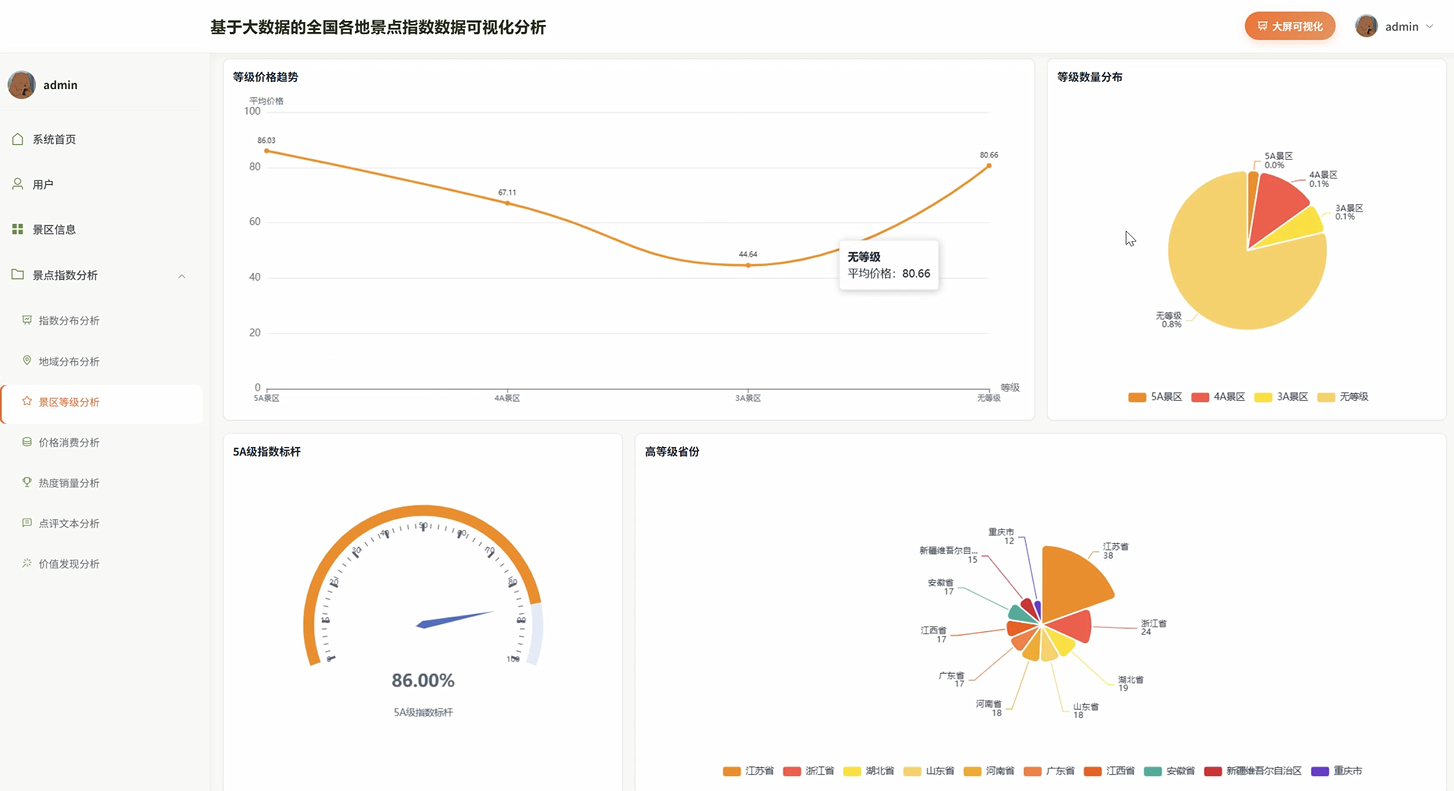
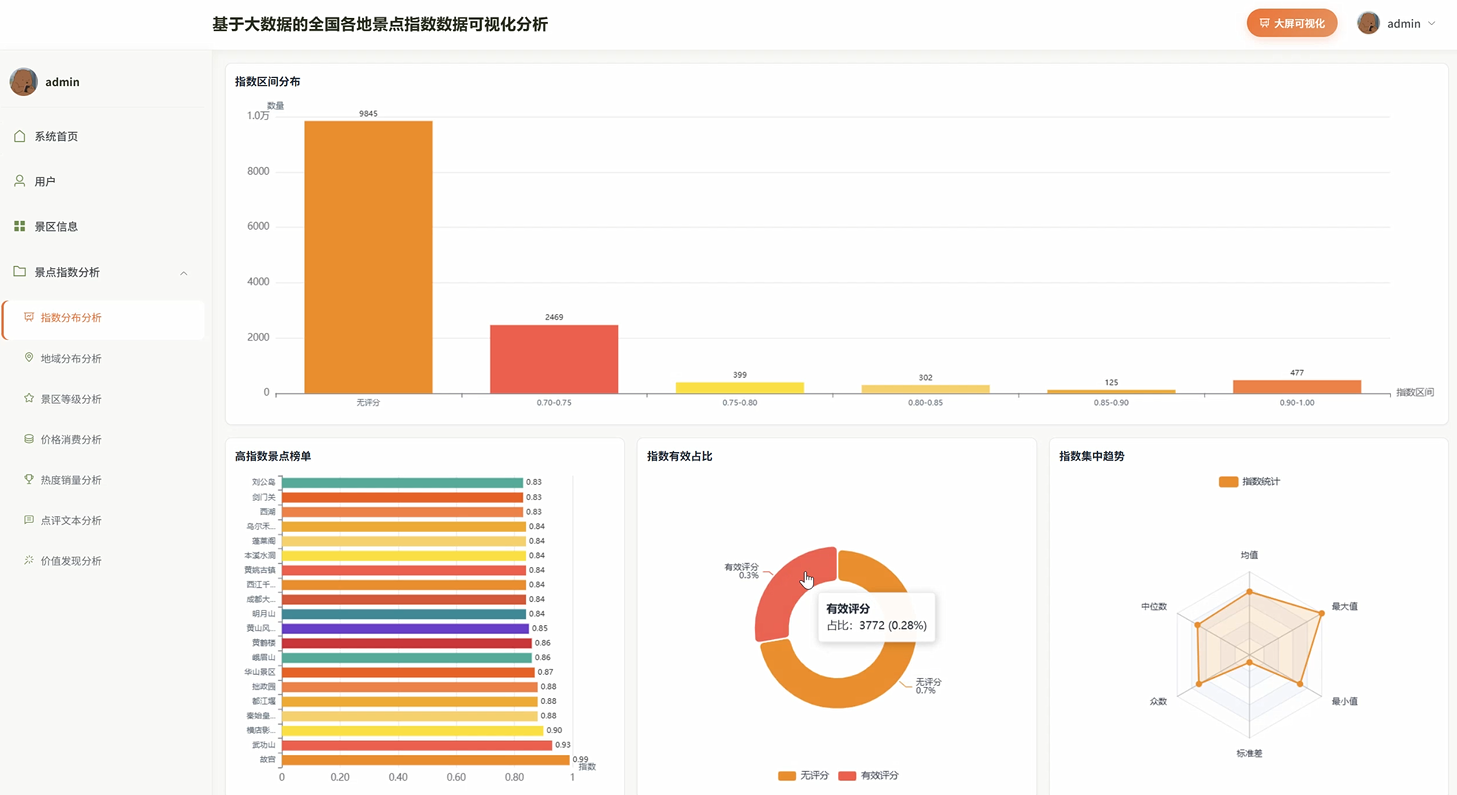
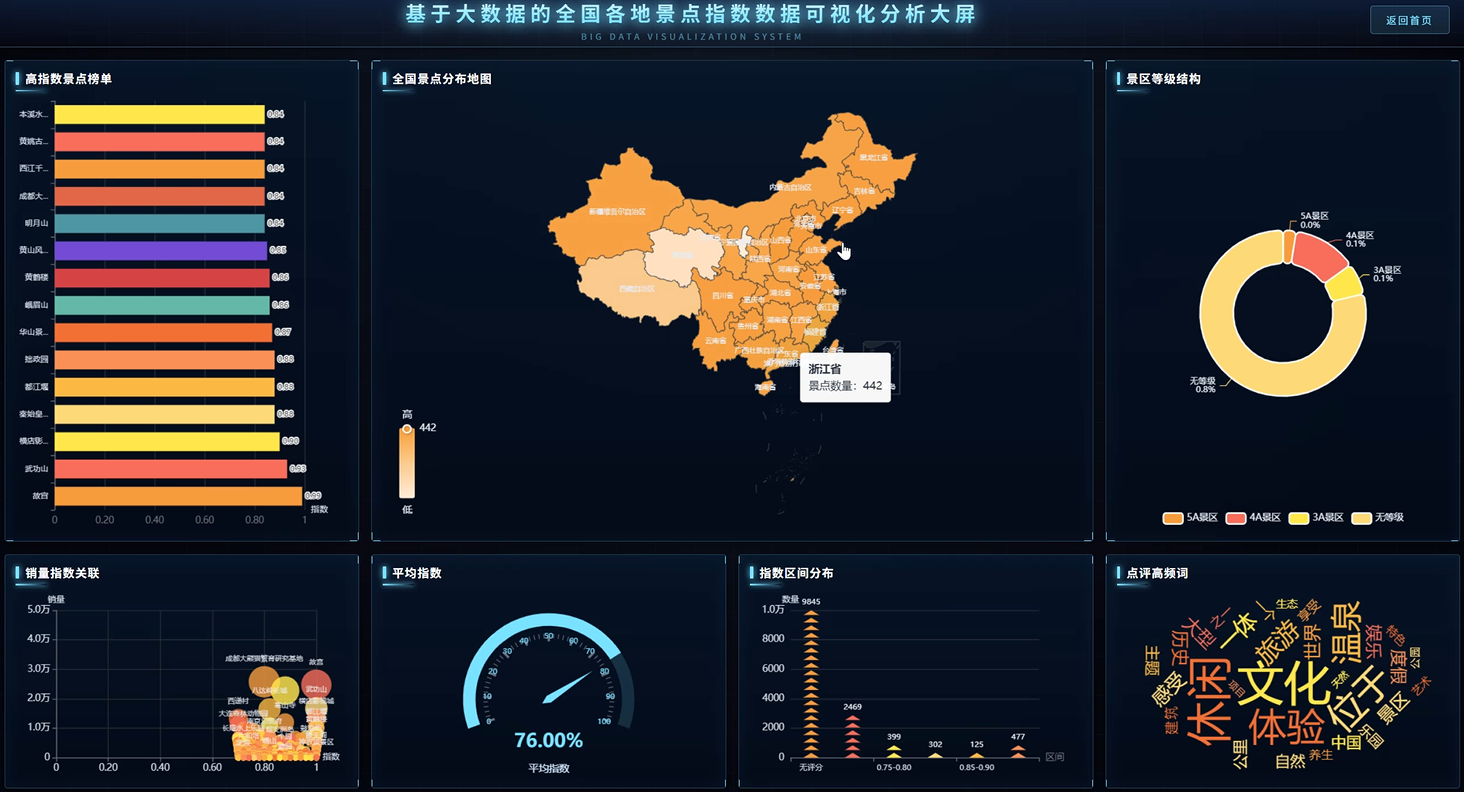
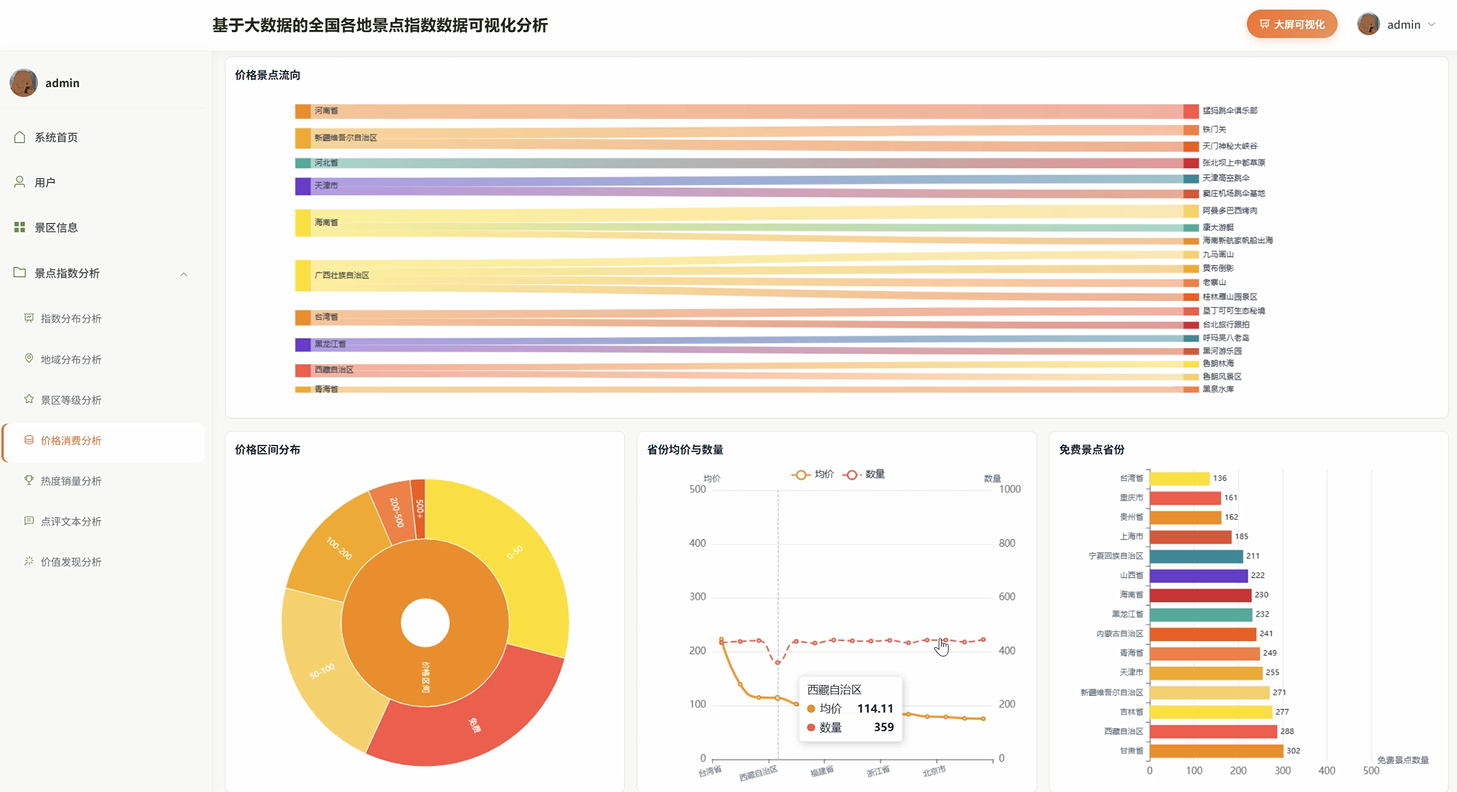
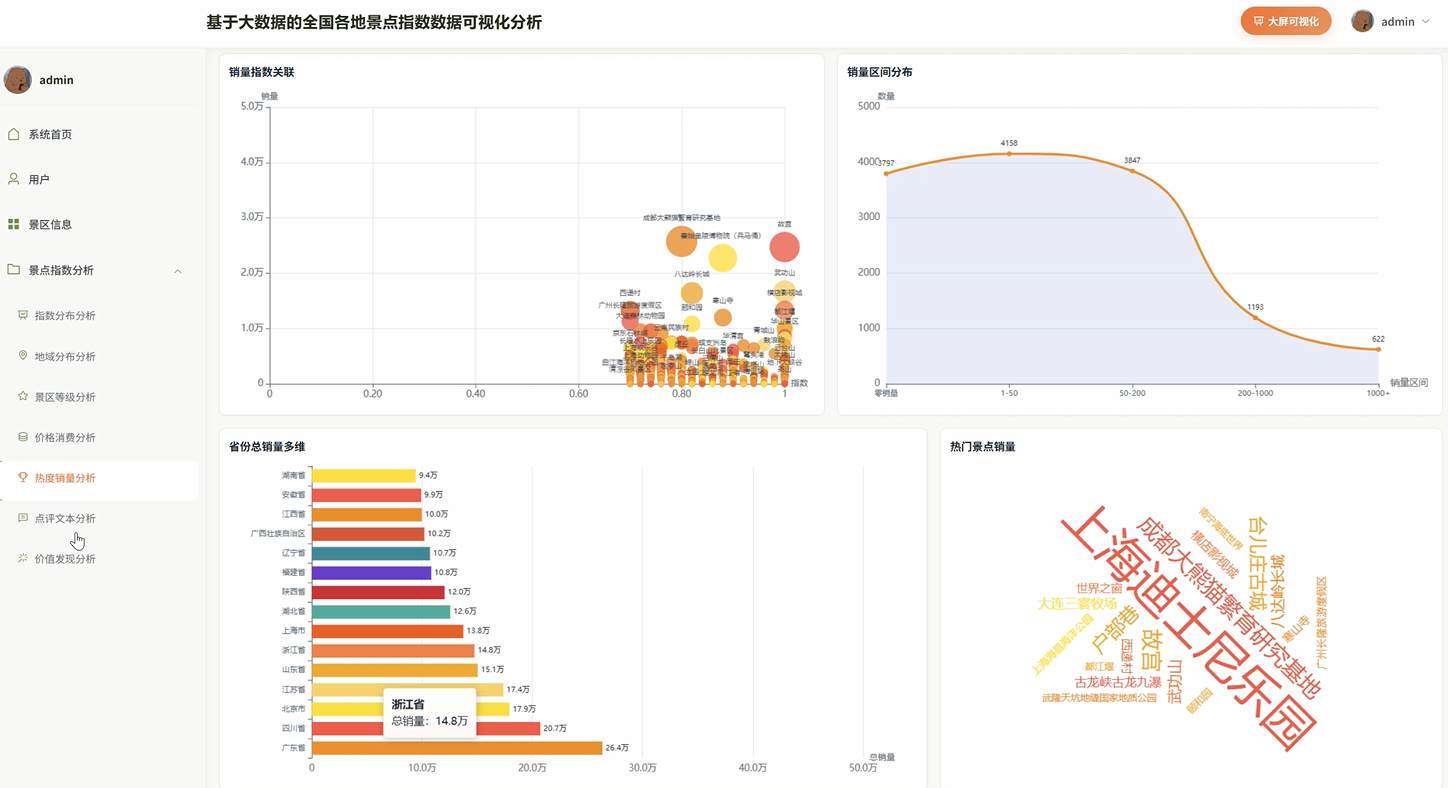
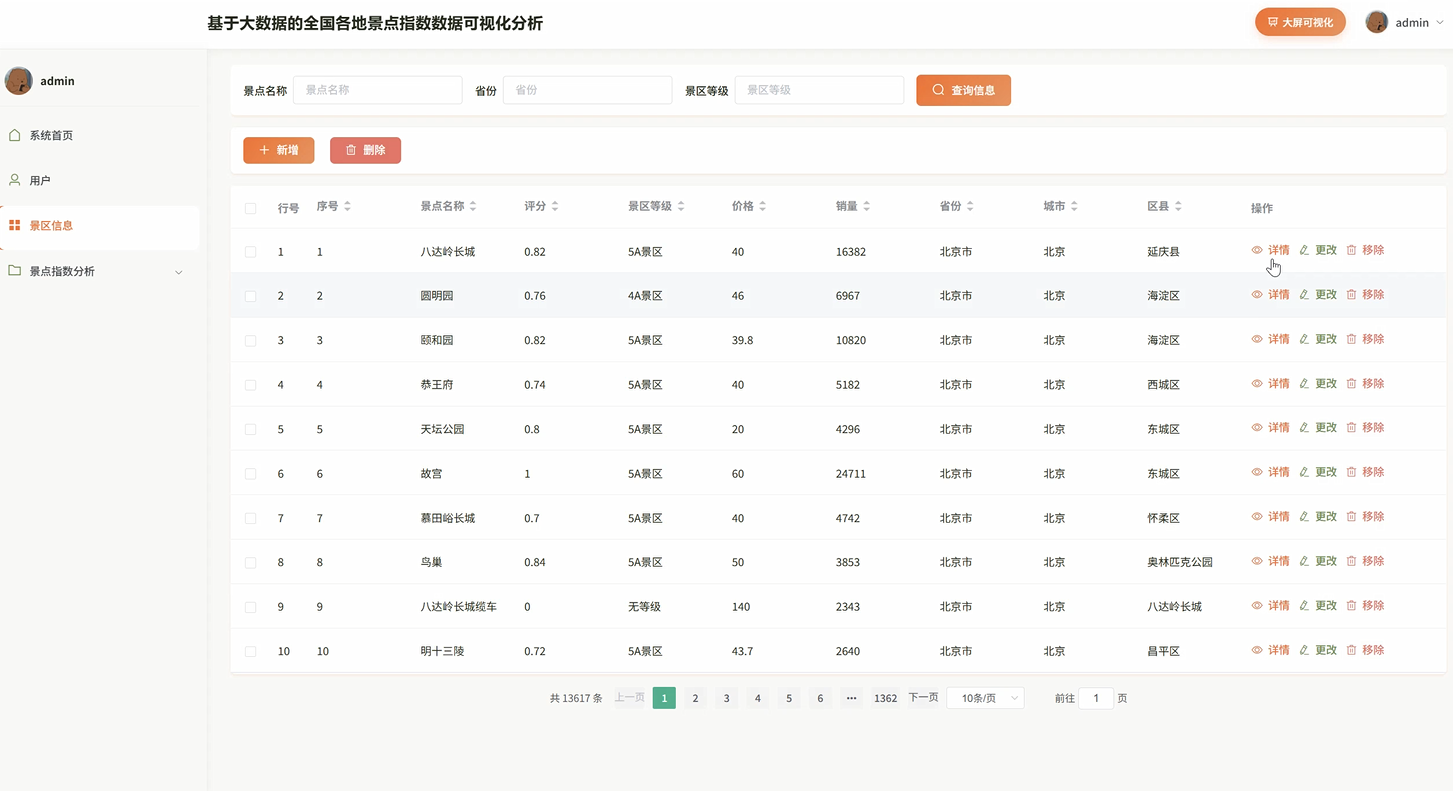
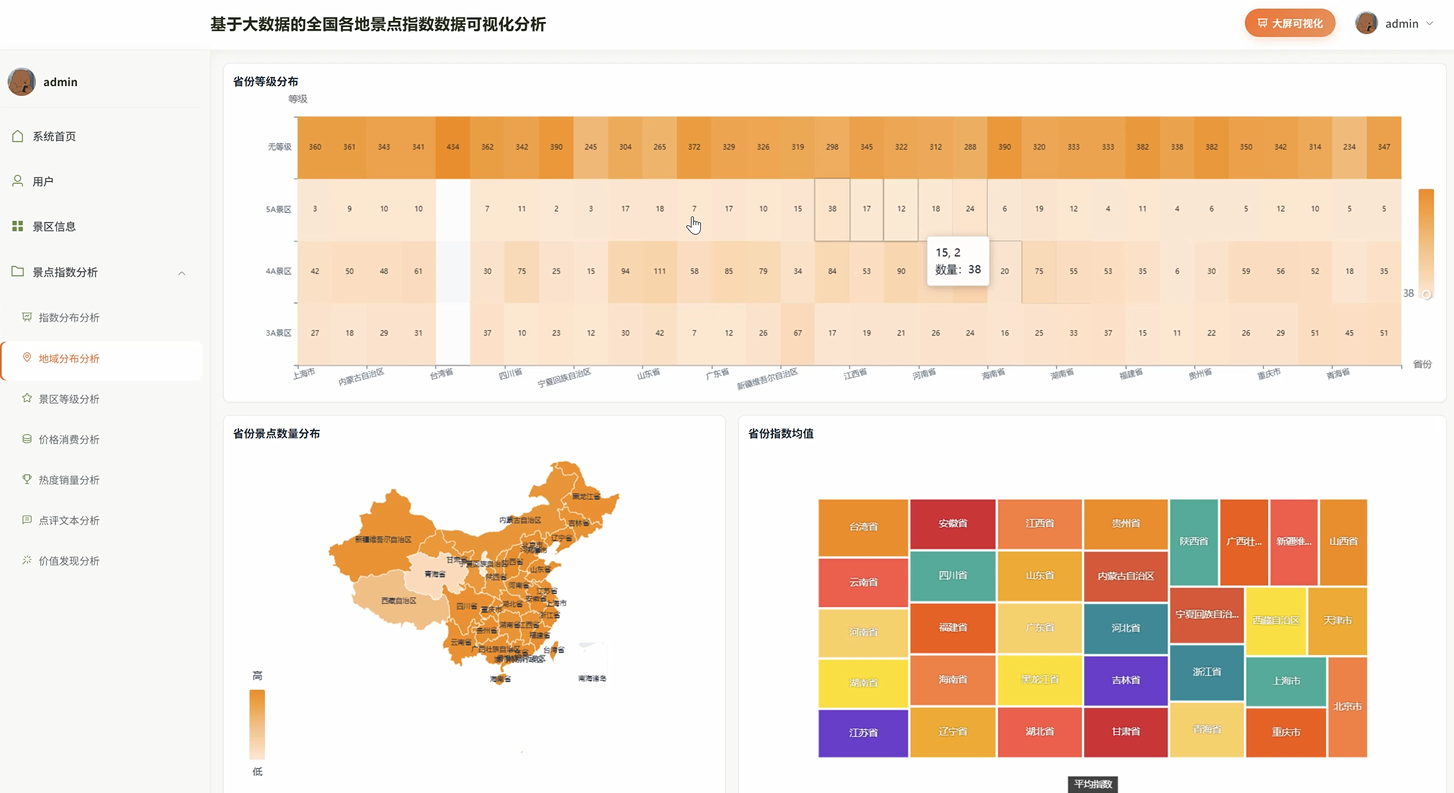
基于大数据的全国各地景点指数数据可视化分析代码展示
python
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, sum, avg, count, desc, when
from django.http import JsonResponse
from django.views.decorators.csrf import csrf_exempt
from django.db import connection
import pandas as pd
import numpy as np
import json
spark = SparkSession.builder.appName("ScenicIndexAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").enableHiveSupport().getOrCreate()
def scenic_info_manage(request):
    if request.method == "POST":
        body = json.loads(request.body)
        scenic_name = body.get("scenic_name")
        province = body.get("province")
        city = body.get("city")
        level = body.get("level")
        if not scenic_name or not province:
            return JsonResponse({"code": 400, "msg": "景区名称和省份不能为空"})
        with connection.cursor() as cursor:
            cursor.execute("SELECT id FROM scenic_info WHERE scenic_name=%s AND province=%s", [scenic_name, province])
            exist = cursor.fetchone()
            if exist:
                return JsonResponse({"code": 409, "msg": "该景区已存在"})
            cursor.execute("INSERT INTO scenic_info(scenic_name, province, city, level) VALUES(%s,%s,%s,%s)", [scenic_name, province, city, level])
        return JsonResponse({"code": 200, "msg": "景区信息添加成功"})
    elif request.method == "GET":
        page = int(request.GET.get("page", 1))
        size = int(request.GET.get("size", 10))
        offset = (page - 1) * size
        with connection.cursor() as cursor:
            cursor.execute("SELECT COUNT(*) FROM scenic_info")
            total = cursor.fetchone()[0]
            cursor.execute("SELECT id, scenic_name, province, city, level FROM scenic_info LIMIT %s OFFSET %s", [size, offset])
            rows = cursor.fetchall()
        result = [{"id": r[0], "scenic_name": r[1], "province": r[2], "city": r[3], "level": r[4]} for r in rows]
        return JsonResponse({"code": 200, "total": total, "data": result})
def scenic_index_analysis(request):
    province = request.GET.get("province", "")
    start_date = request.GET.get("start_date", "")
    end_date = request.GET.get("end_date", "")
    df = spark.read.format("csv").option("header", "true").option("inferSchema", "true").load("hdfs://localhost:9000/scenic/index_data.csv")
    df = df.filter(col("dt").isNotNull())
    if province:
        df = df.filter(col("province") == province)
    if start_date and end_date:
        df = df.filter((col("dt") >= start_date) & (col("dt") <= end_date))
    df.createOrReplaceTempView("scenic_index")
    result_df = spark.sql("SELECT province, city, scenic_name, SUM(visitor_count) AS total_visitor, AVG(heat_score) AS avg_heat, AVG(comment_score) AS avg_comment, COUNT(DISTINCT dt) AS days FROM scenic_index GROUP BY province, city, scenic_name ORDER BY total_visitor DESC")
    pdf = result_df.toPandas()
    pdf["avg_heat"] = pdf["avg_heat"].round(2)
    pdf["avg_comment"] = pdf["avg_comment"].round(2)
    pdf["heat_level"] = np.where(pdf["avg_heat"] >= 80, "高热", np.where(pdf["avg_heat"] >= 50, "中热", "低热"))
    data_list = pdf.to_dict(orient="records")
    with connection.cursor() as cursor:
        cursor.execute("DELETE FROM scenic_index_result WHERE dt=%s", [end_date])
        for row in data_list:
            cursor.execute("INSERT INTO scenic_index_result(province, city, scenic_name, total_visitor, avg_heat, avg_comment, heat_level, dt) VALUES(%s,%s,%s,%s,%s,%s,%s,%s)", [row["province"], row["city"], row["scenic_name"], int(row["total_visitor"]), float(row["avg_heat"]), float(row["avg_comment"]), row["heat_level"], end_date])
    return JsonResponse({"code": 200, "data": data_list})
def index_chart_data(request):
    province = request.GET.get("province", "")
    df = spark.read.format("csv").option("header", "true").option("inferSchema", "true").load("hdfs://localhost:9000/scenic/index_data.csv")
    if province:
        df = df.filter(col("province") == province)
    df.createOrReplaceTempView("scenic_index_chart")
    trend_df = spark.sql("SELECT dt, SUM(visitor_count) AS total_visitor, AVG(heat_score) AS avg_heat FROM scenic_index_chart GROUP BY dt ORDER BY dt")
    trend_pdf = trend_df.toPandas()
    trend_pdf["avg_heat"] = trend_pdf["avg_heat"].round(2)
    dates = trend_pdf["dt"].tolist()
    visitors = trend_pdf["total_visitor"].tolist()
    heats = trend_pdf["avg_heat"].tolist()
    rank_df = spark.sql("SELECT scenic_name, SUM(visitor_count) AS total_visitor FROM scenic_index_chart GROUP BY scenic_name ORDER BY total_visitor DESC LIMIT 10")
    rank_pdf = rank_df.toPandas()
    rank_names = rank_pdf["scenic_name"].tolist()
    rank_values = rank_pdf["total_visitor"].tolist()
    chart_data = {"trend": {"dates": dates, "visitors": visitors, "heats": heats}, "rank": {"names": rank_names, "values": rank_values}}
    return JsonResponse({"code": 200, "chart_data": chart_data})
基于大数据的全国各地景点指数数据可视化分析文档展示
💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜