开篇
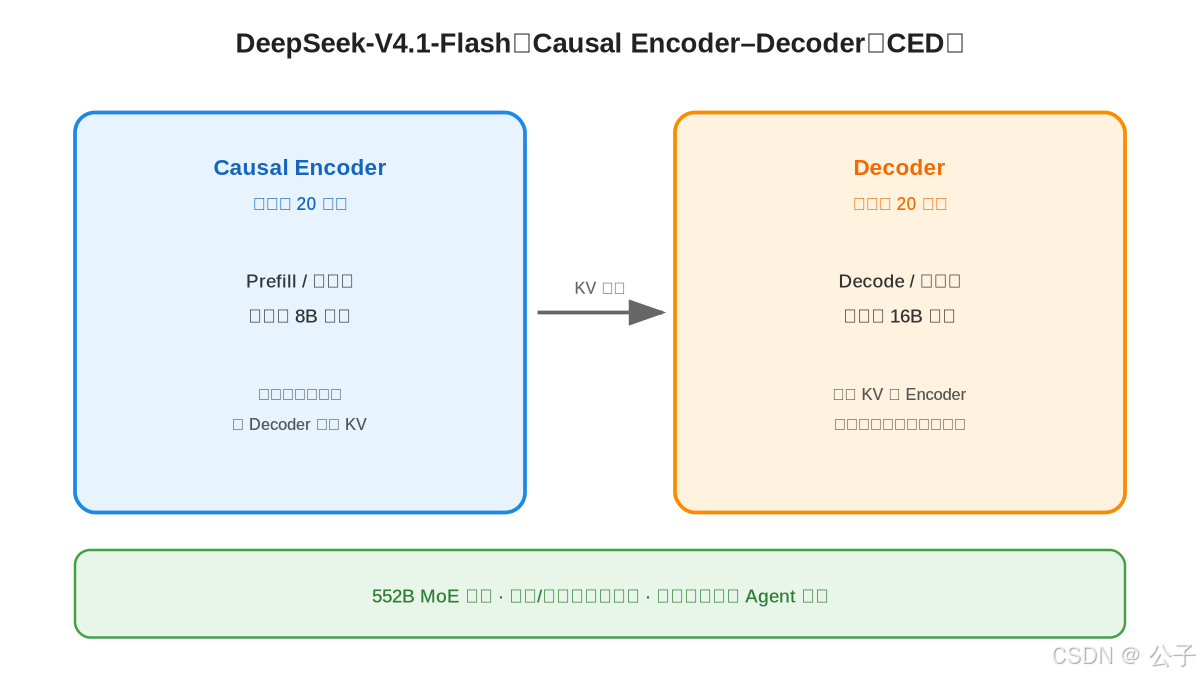
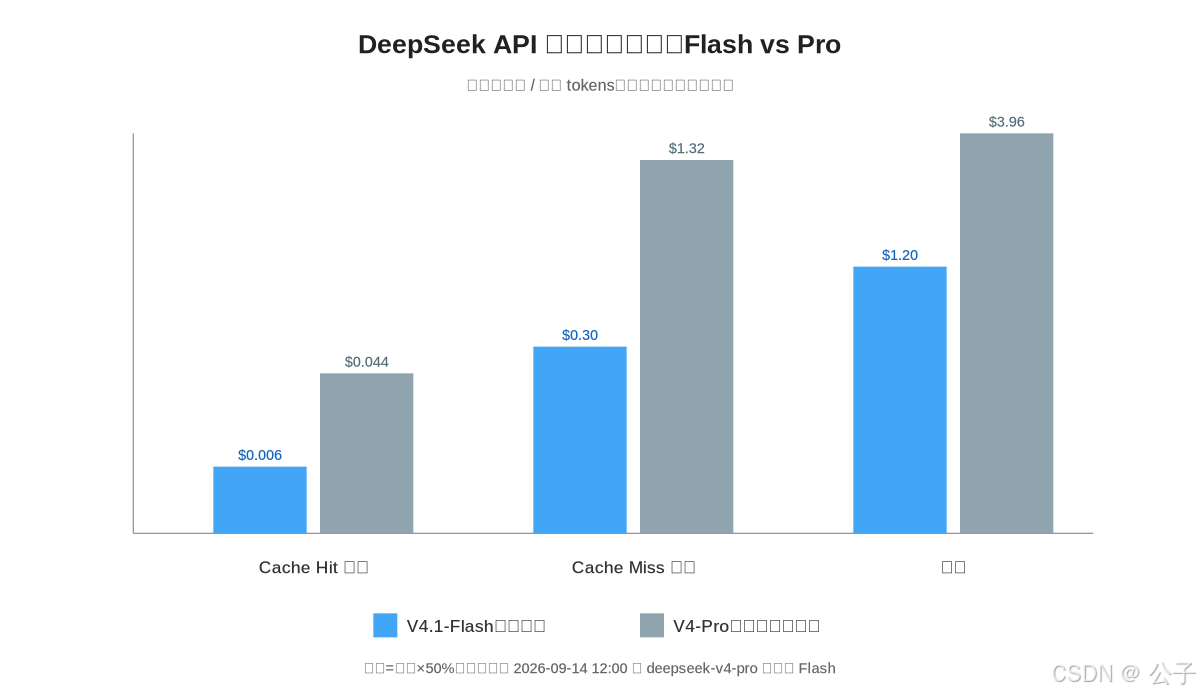
如果你还在用 deepseek-v4-pro 跑 Agent / 代码助手,请先看日历:北京时间 2026 年 9 月 14 日 12:00 之后,这条模型名的请求会被官方全部路由到 DeepSeek-V4.1-Flash ,并按 Flash 单价计费,直到未来的 V4.1 Pro 上线。一句话总结这次更新:> 不是「又出一个更快的小模型」,而是 DeepSeek 用一套新架构,把 长上下文 + 工具调用密集的 Agent 工作负载 的推理成本,从底座上压下来------然后直接用 Flash 替换自家 Pro 的 API 路径。---### 一、V4.1-Flash 是什么?根据官方文档与模型卡(Hugging Face:deepseek-ai/DeepSeek-V4.1-Flash):| 项 | 要点 || --- | --- || 定位 | 新架构家族的「最小号」成员;原生多模态(图文入、文本出) || 骨干 | 552B 参数 MoE || 激活 | Prefill(输入)约 8B ;Decode(输出)约 16B || 结构 | Causal Encoder--Decoder(CED) :40 层 Transformer = 20 层因果 Encoder + 20 层 Decoder || 上下文 | 1M tokens;最大输出 384K || 训练 | 从零预训练约 45T 多模态 tokens;后训练含 SFT / RL / on-policy distillation || 协议 | API 模型名:deepseek-flash;兼容 OpenAI / Anthropic 风格端点;MIT 开源权重 |旧名 deepseek-v4-flash、deepseek-v4-flash-vision-exp 仍可调用,但底层已切到 V4.1-Flash,并按 Flash 价格计费。消费端 App 也更新了 Fast / Expert / Visual 等模式。---### 二、为什么叫「非对称」:CED 到底解决了什么?Agent 场景有个很扎心的事实:读远多于写 。一次工具调用、扫一遍仓库、塞进多张截图,Prefill 请求会反复打爆算力和 KV Cache。CED 的关键思路(官方技术报告摘要):1. 下半层当 Causal Encoder ,负责吃输入、产出高质量隐状态;2. 上半层 Decoder 的全局 KV 不再由本层隐状态各自生成 ,而是从 Encoder 终态投影;3. 于是 Prefill 只需大约一半的激活量(约 8B),Decode 再拉到约 16B------对「输入很重、输出可控」的 Agent 更友好。再叠两把「砍显存」的刀:- Compressed Sparse Attention 2(CSA2) + FP4 KV :全局 KV 压到约 890 bytes/token ,大约是 V4-Flash 的 1/4 HBM ;- SWA Bounded Replay :滑动窗口 KV 按需重放,而不是整段落盘,持久化 / SSD KV 需求约降到 1/8 。