这题问的是:Agent 怎么记住事,又怎么在记不住的时候不崩。
按顺序答:先分清短期和长期、再讲多轮对话怎么接上、然后讲上下文塞满了怎么压、最后用制度问答项目走一遍。每块一句口播。
整件事可以先记成一张图:
短期记忆 = 这一单的对话和状态,放在上下文里。
长期记忆 = 跨会话的偏好和事实,放在库里,用的时候再捞。
上下文快满了 = 先压旧的、留新的,关键信息落成结构化字段。
一、先分清:短期和长期,两套东西
面试最爱问「你们 Agent 的记忆怎么做的」。别只答一句「存聊天记录」。记忆至少分两层:
| 短期记忆 | 长期记忆 | |
|---|---|---|
| 存什么 | 这一单的对话、槽位、调过哪些工具 | 用户偏好、历史事实、知识 |
| 放哪 | 上下文窗口 + 会话状态 | 数据库 / 向量库 |
| 活多久 | 这一单结束就丢 | 跨会话长期保留 |
| 怎么用 | 直接进提示词 | 检索出来再进提示词 |
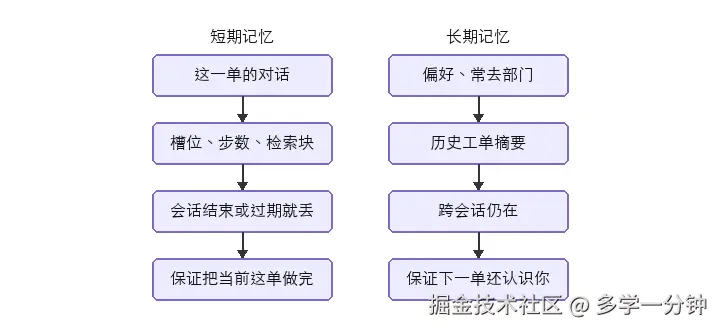
短期记忆是「这一单做到哪」:用户刚说的日期、缺的原因、上一步调了什么。它必须进上下文,模型才接得上。
长期记忆是「这个人是谁」:他常驻上海、偏好邮件通知、上次请假是病假。它不该全塞进上下文,而是需要时检索几条出来。
面试一句话:短期记这一单,长期记这个人;短期进上下文,长期进库再捞。
二、多轮对话:靠会话 ID 把同一单接上
多轮对话不是把历史全堆进提示词。核心是两件事:会话 ID 和 状态。
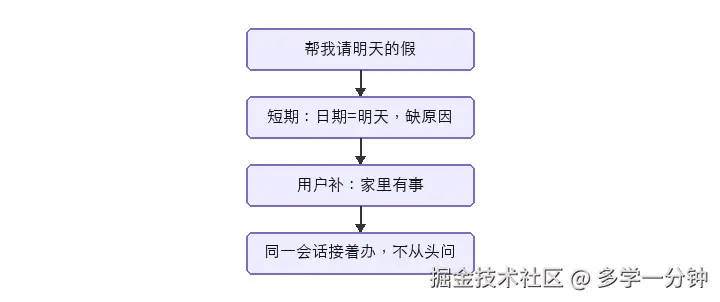
用户每来一条消息,带上同一个 thread_id(会话 ID)。后端拿这个 ID 去捞这一单的状态:之前的对话、已填的槽、走到哪一步。和新消息合并后再跑。
几个必须说清的点:
1. 对话要追加,不能覆盖。 上一轮用户的话丢了,模型就断片。对话列表用追加(add_messages 这类 reducer)。
2. 不是所有字段都追加。 检索到的条款块、意图用覆盖。如果检索块也追加,几轮之后提示词被旧条款塞满,还可能带进已废止版本。
3. 槽位要按键合并。 请假先记「明天」,再补「家里有事」。如果节点只返回 {原因: ...} 又没合并,日期会被整份盖掉。字典槽位要浅合并:新键覆盖旧键,没传的留下。
4. 补槽时别重新判意图。 用户补「原因是家里有事」,路由不要重新判成闲聊。槽位未齐、上一跳是办事,就继续走补槽。
面试一句话:会话 ID 把同一单串起来;对话追加、检索覆盖、槽位合并。
三、上下文预算:窗口是有限的,得会算
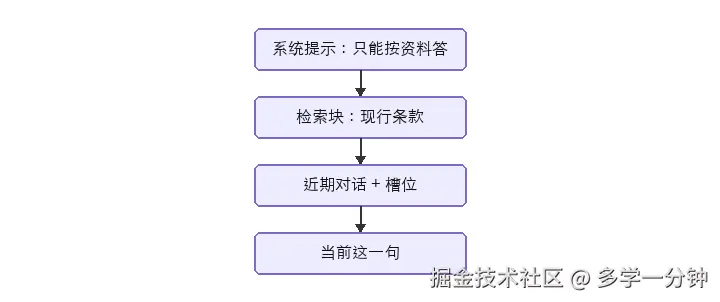
上下文窗口再大也是有限的。系统提示词、工具定义、检索块、历史对话、当前问题,全都要占地方。塞满了要么报错,要么模型开始忽略中间的内容。
所以要有预算意识:先给谁、留多少、超了砍谁。
一个实用的分配顺序:
- 系统提示词和当前问题:永远保留,这是底线。
- 工具定义:只放当前节点需要的 3~8 个,不要全塞。
- 检索块:重排后留 3~8 条,不要整库倒进去。
- 最近几轮对话:保留最近 N 轮,保证接得上。
- 更早的历史:压缩或摘要,不原样保留。
面试一句话:窗口是预算,不是仓库;先保系统提示和当前问题,再按重要性分配。
四、上下文压缩:旧的压成摘要,关键落成字段
对话一长,历史必然超预算。压缩不是简单删掉,而是把旧的压成更短、更稳的形式。
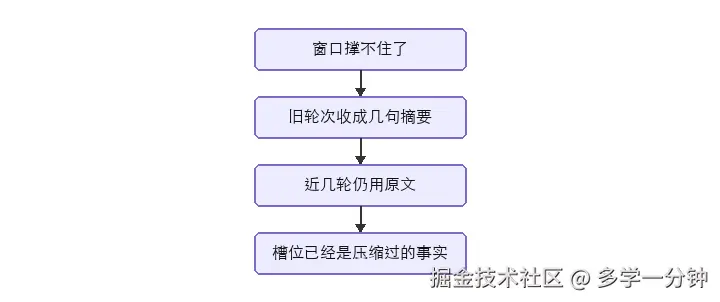
三种常用手段,从轻到重:
1. 滑动窗口。 只留最近 N 轮,更早的直接丢。最简单,但会丢信息。
2. 摘要压缩。 把更早的对话让模型压成一段摘要,替换掉原文。省地方,但摘要可能丢细节、也可能编。
3. 结构化落字段。 把关键信息(日期、原因、单号、偏好)抽成结构化字段存进状态。这是最稳的:不依赖模型记住,代码直接读。
实际做法是组合:最近几轮原样留,更早的压成摘要,关键信息落成字段。
几条原则:
- 压缩要保关键信息。 单号、日期、金额、用户明确说的偏好,不能压没。
- 摘要别让模型自由发挥。 给它明确的模板:谁、要什么、做到哪、还缺什么。
- 压缩有触发条件。 比如超过 N 轮或超过 token 阈值才压,不要每轮都压。
- 压缩后要能接着干。 压完模型还能知道「请假缺原因」,否则等于失忆。
面试一句话:压缩是保信息、去冗余;旧的压成摘要,关键落成字段,别指望模型自己记住。
五、长期记忆:存什么、怎么取、怎么更新
长期记忆不是把所有对话存下来。存什么、怎么取、怎么更新,三件事都要想清楚。
存什么:
- 用户偏好:常驻城市、通知方式、称呼
- 稳定事实:部门、职级、常用项目
- 历史结论:上次报销被拒的原因
怎么取: 和 RAG 一样,按当前问题检索相关的几条,不要全量加载。取多了又变成上下文负担。
怎么更新: 新信息覆盖旧信息,冲突时以最新为准。比如用户说「我搬到北京了」,要更新而不是追加两条矛盾记录。
边界: 长期记忆和 RAG 知识库要分开。知识库是制度全文,长期记忆是「这个用户」。两者检索源不同,别混在一个库里。
面试一句话:长期记忆存偏好和事实,按需检索、冲突覆盖;和知识库分开。
六、总结(大约 40 秒)
记忆分两层:短期记这一单的对话和状态,进上下文;长期记用户偏好和事实,进库按需捞。
多轮对话靠会话 ID 把同一单串起来,对话追加、检索覆盖、槽位合并。
上下文是预算不是仓库,先保系统提示和当前问题,再按重要性分配。
快满了就压缩:最近几轮原样留,更早的压成摘要,关键信息落成结构化字段。
长期记忆存偏好和事实,按需检索、冲突覆盖,和知识库分开。
压轴一句:短期管这一单,长期管这个人;上下文要算预算,压缩要保信息。
七、结合项目:制度问答助手怎么记
还是制度问答助手。用户先说「帮我请明天的假」,隔一轮又补「原因是家里有事」。
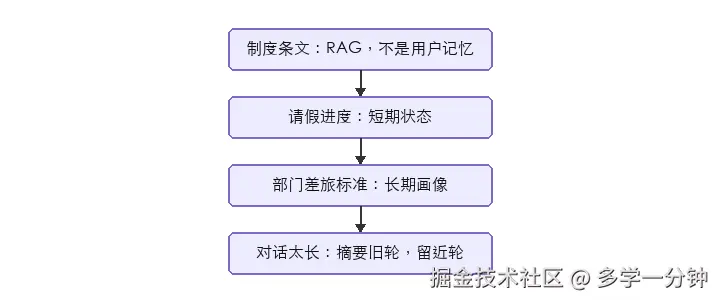
- 短期记忆: 会话 ID 把这两句串成一单。第一句记下日期「明天」,缺原因,本轮结束并问一句。
- 多轮接上: 第二句进来,同一会话,路由看到槽未齐、上一跳是办事,继续补槽,不重新判成闲聊。
- 槽位合并: 原因写进 slots,日期还在,没被覆盖。
- 长期记忆: 用户之前说过「常驻上海」,检索出来,报销时自动按上海标准,不用再问。
- 上下文压缩: 这一单聊了十几轮,最近几轮原样留,更早的压成摘要,单号、日期、原因落成字段。
- 边界: 制度全文走 RAG,用户偏好走长期记忆,两者分开检索。
评测就三句:补槽时有没有丢已填的槽;压缩后还记不记得缺什么;长期偏好有没有在需要时被取出来。
八、面试可能追问(短答)
Q:短期记忆和长期记忆的区别?
A:短期是这一单的对话和状态,进上下文,结束就丢;长期是跨会话的偏好和事实,进库按需检索。
Q:多轮对话就是把历史全塞进提示词吗?
A:不是。靠会话 ID 捞状态,对话追加、检索覆盖、槽位合并。全塞又贵又吵,还会淹没关键信息。
Q:上下文满了怎么办?
A:压缩。最近几轮原样留,更早的压成摘要,关键信息落成结构化字段。有触发条件,不是每轮都压。
Q:压缩会不会把重要信息压没?
A:会。所以单号、日期、金额、明确偏好要落成字段,不依赖摘要。摘要给模板,别让模型自由发挥。
Q:长期记忆和 RAG 知识库是一回事吗?
A:不是。知识库是制度全文,长期记忆是「这个用户」。检索源不同,要分开。
Q:记忆冲突了听谁的?
A:以最新为准,覆盖旧的。用户说搬家了,就更新,不要留两条矛盾记录。
Q:记忆要不要全交给模型自己管?
A:不要。存什么、怎么取、什么时候压,都要代码定规则。模型可以建议,但字段和触发条件写在代码里。