Apache IoTDB 实战测试文档+TimechoDB+Workbench+TS file Viewer+Grafana
介绍
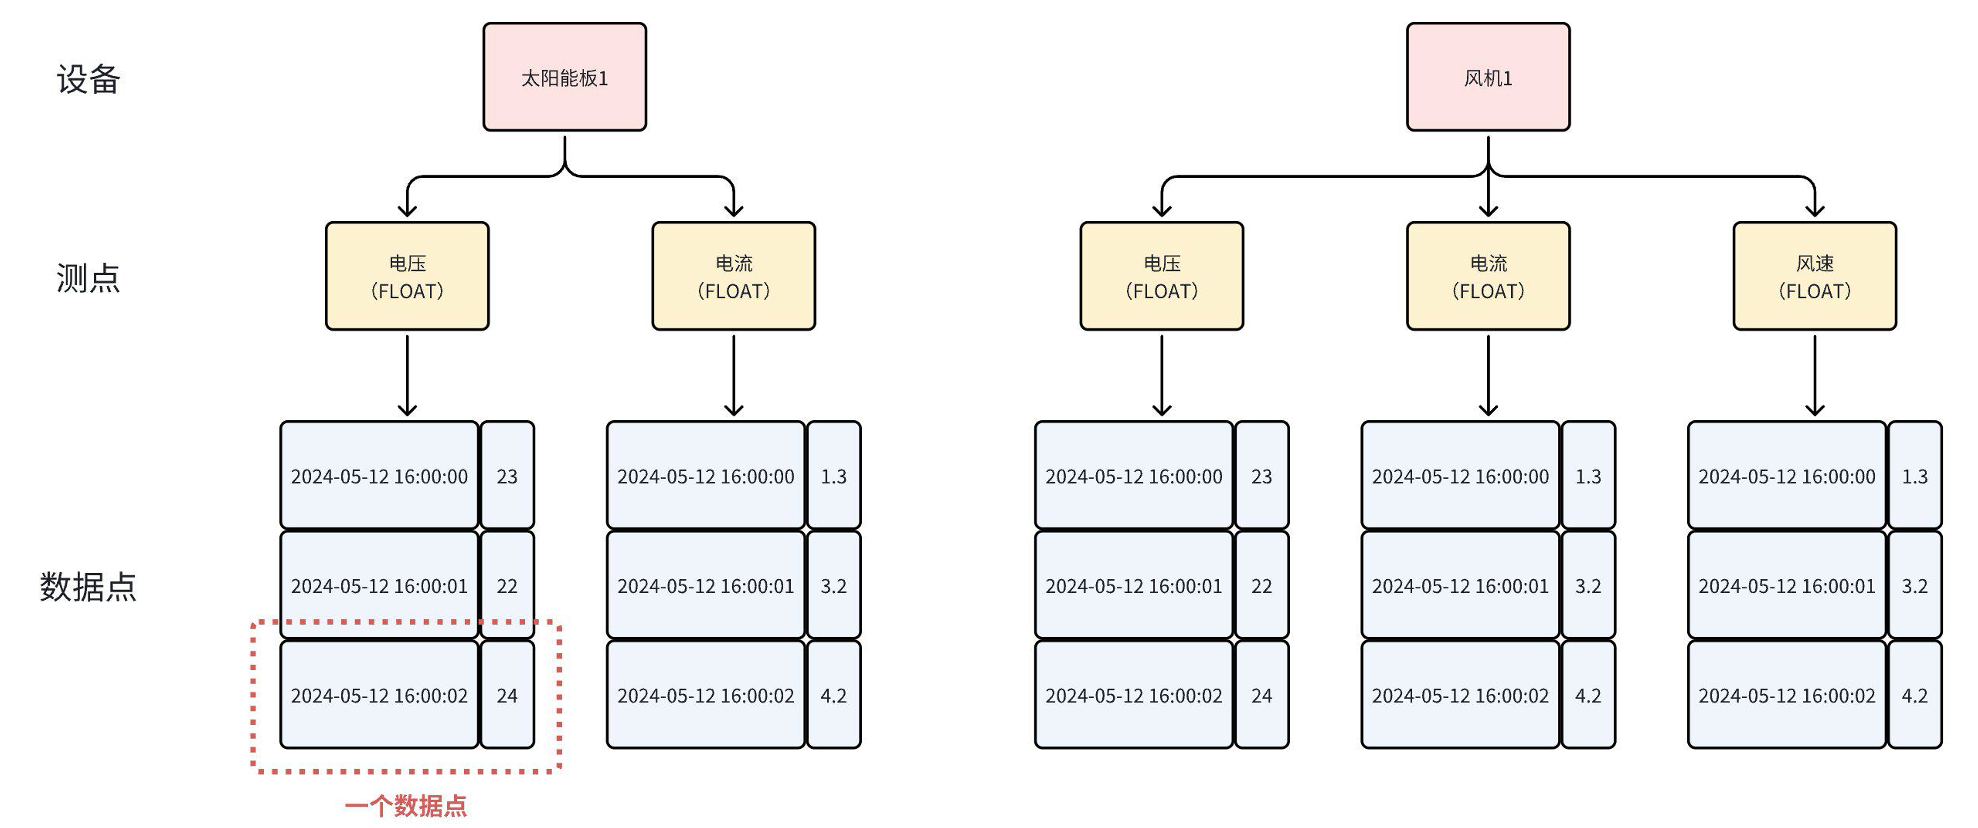
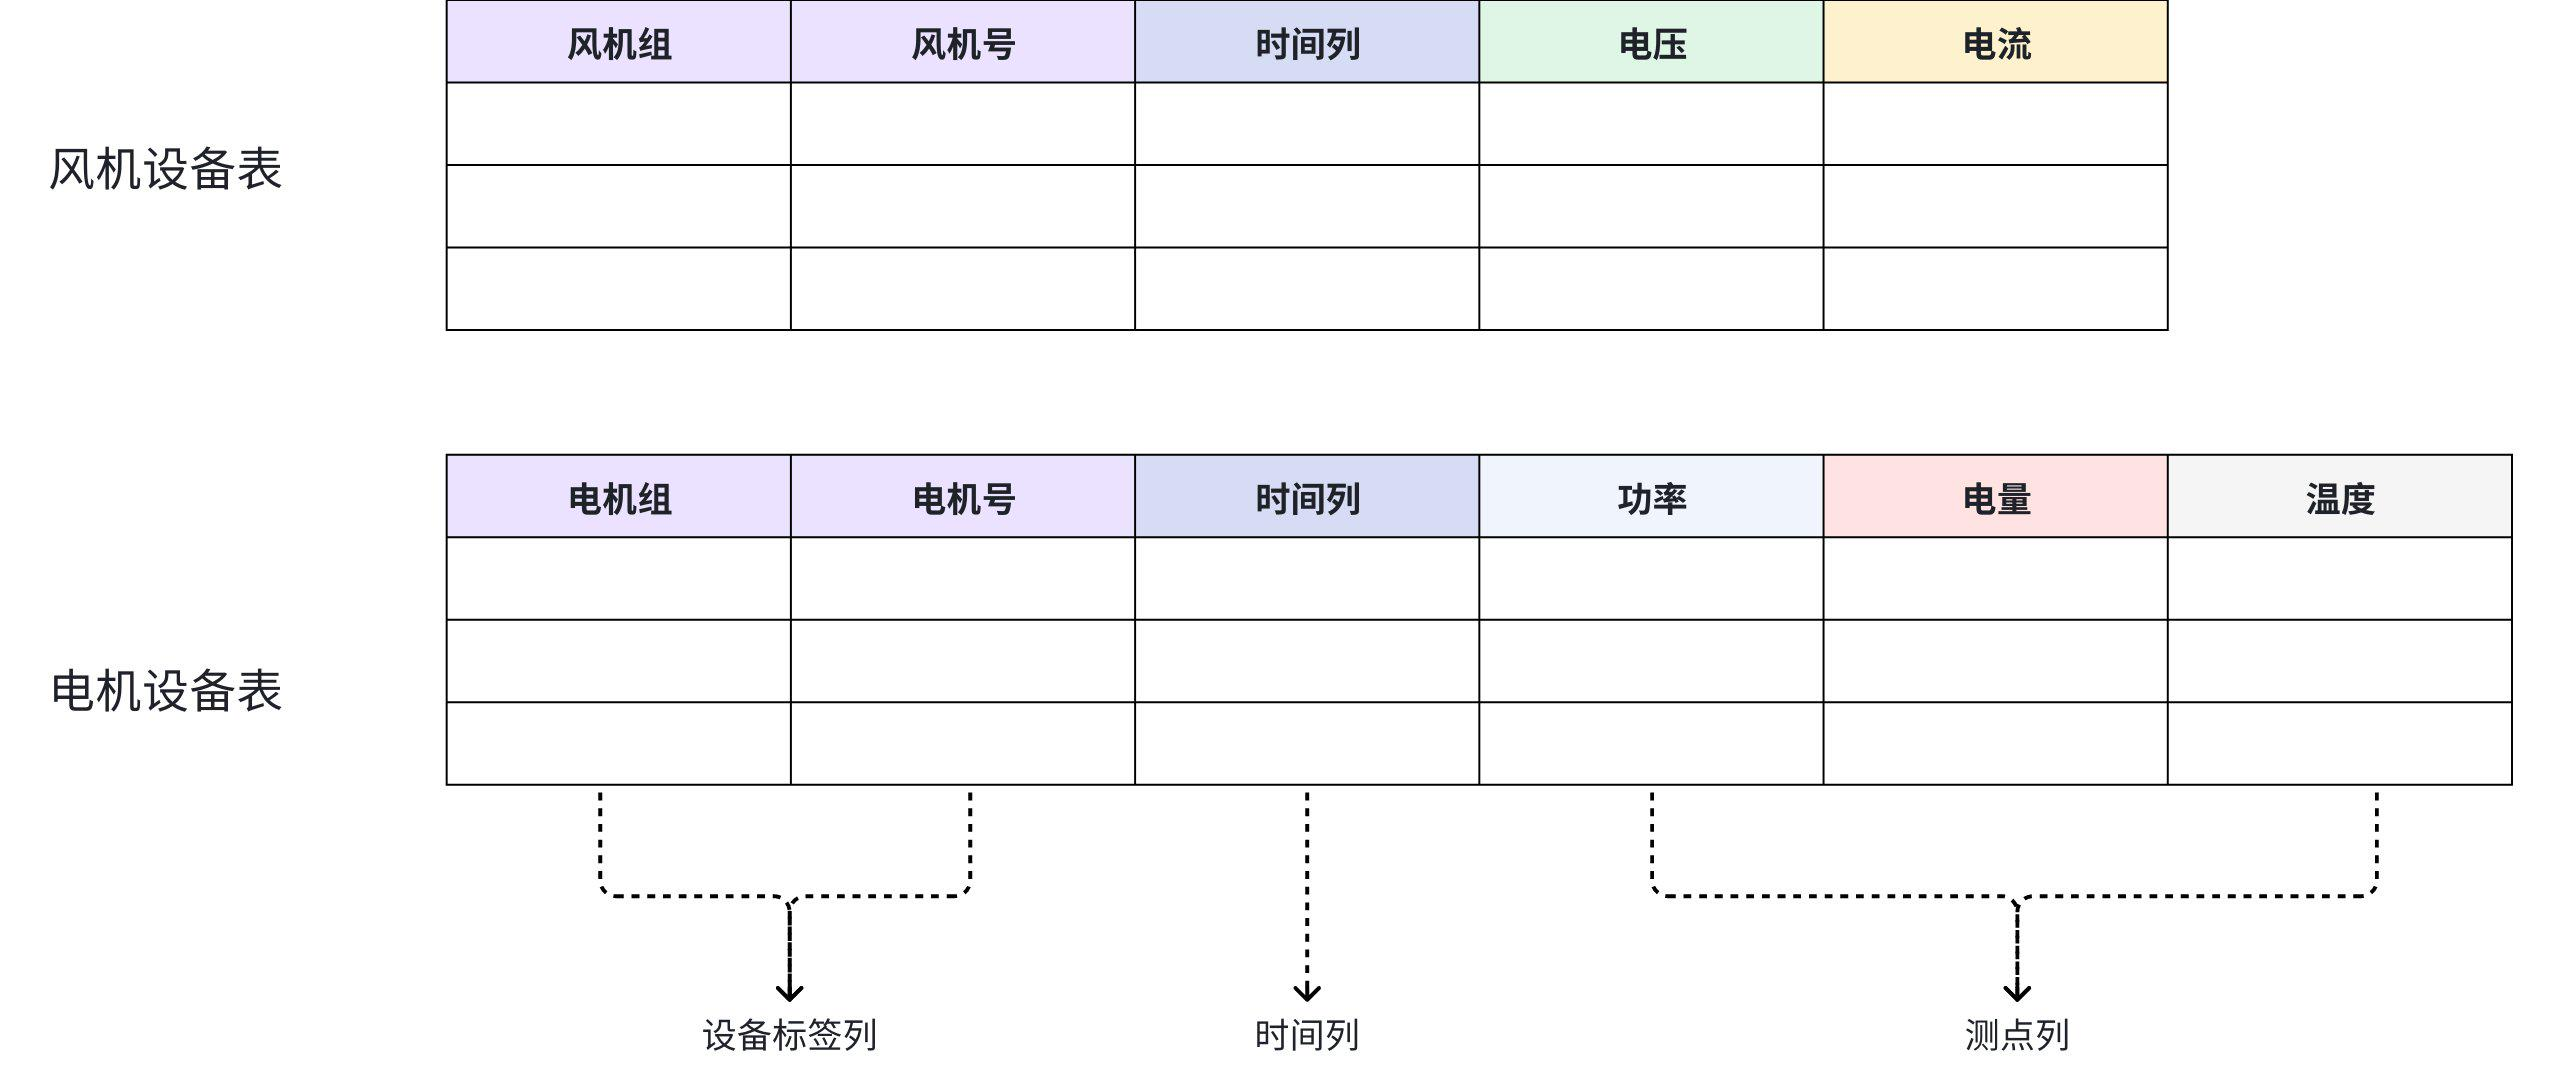
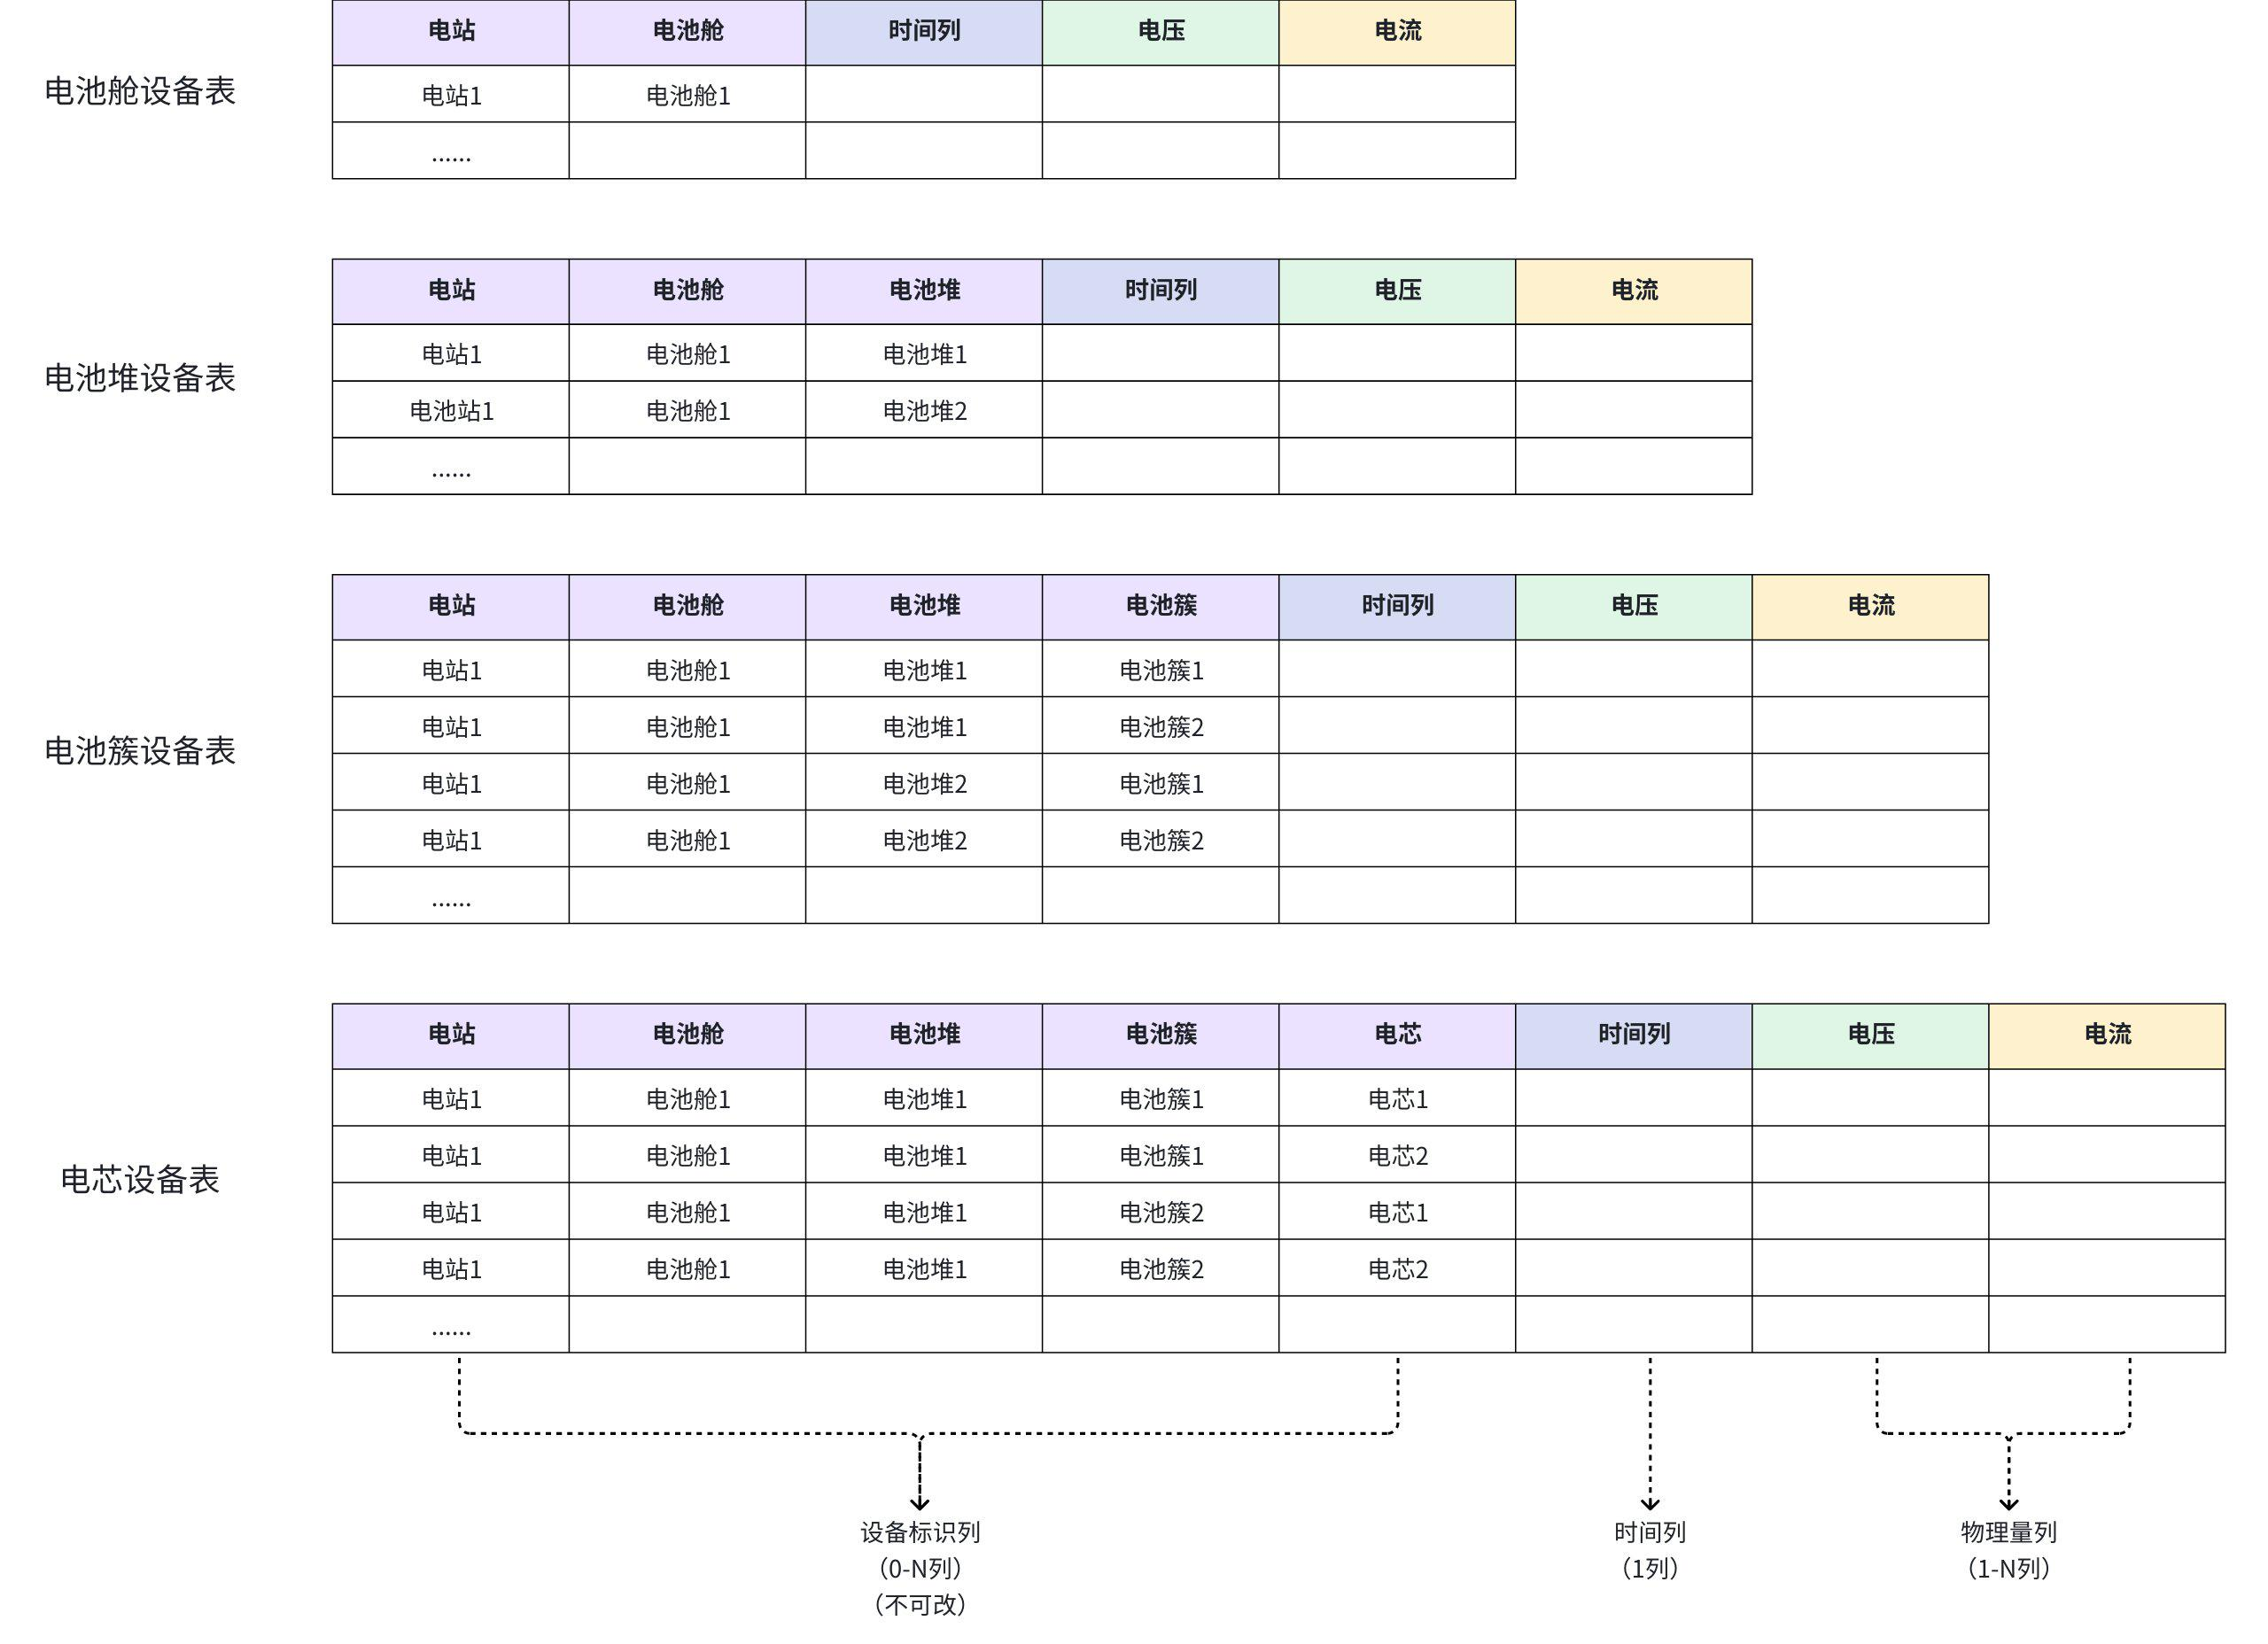
Apache IoTDB 是一款高性能物联网时序数据库,具备灵活的端云部署能力和低成本的高压缩存储优势。它支持百万级设备的高通量读写与乱序处理,并采用契合工业场景的层级化方式管理数据。该系统拥有高可用的分布式架构和丰富的时间序列查询语义,能够进行实时分析与 AI 处理。此外,IoTDB 兼容 SQL 语法并能无缝对接 Hadoop、Grafana 等主流大数据与可视化生态,极大降低了使用和运维门槛。IoTDB 提供了两种数据建模方式------树模型和表模型
相关资料
用户手册
https://iotdb.apache.org/zh/UserGuide/latest/IoTDB-Introduction/IoTDB-Introduction_apache.html
-
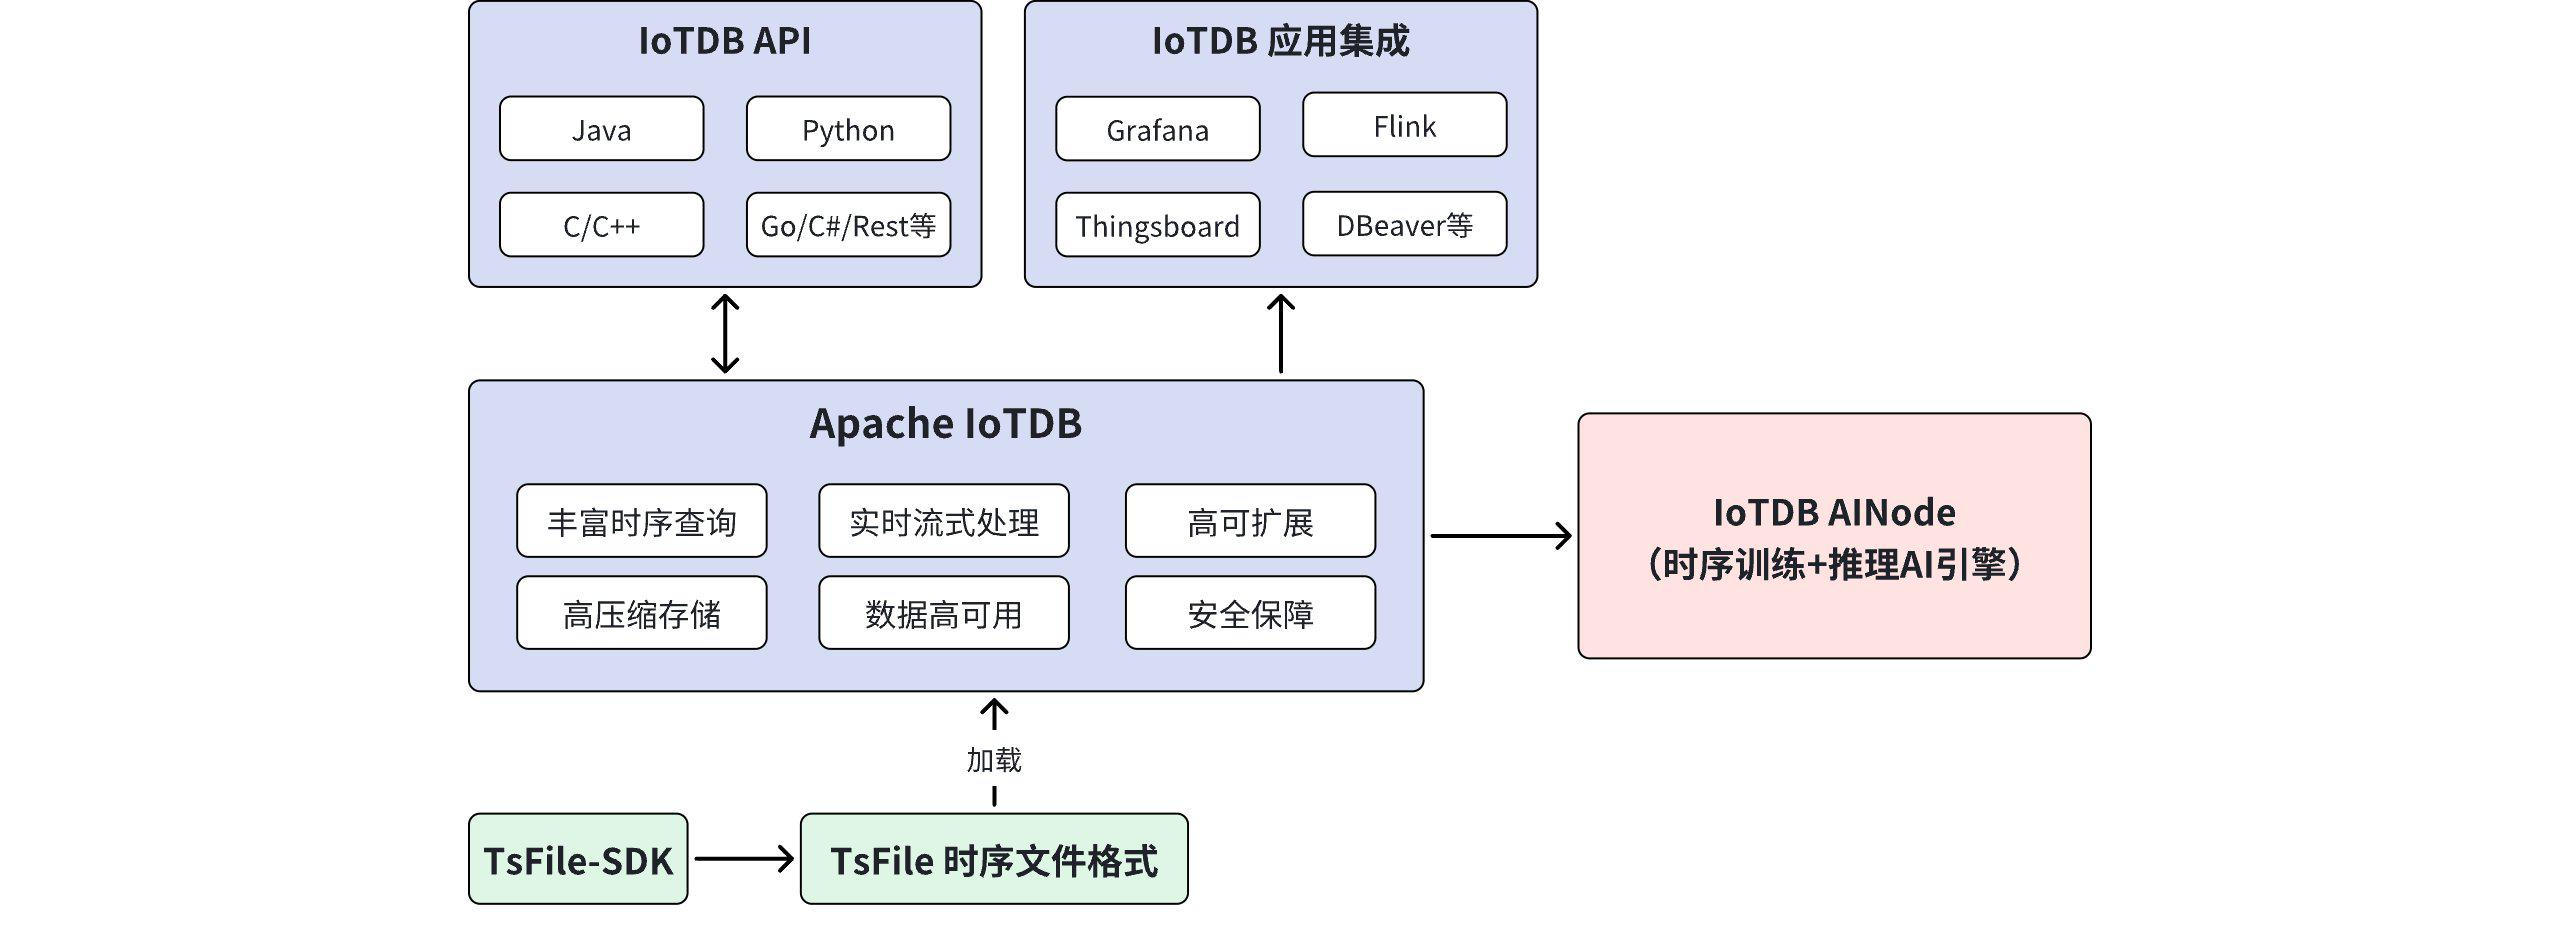
时序数据库(Apache IoTDB):时序数据存储的核心组件,其能够为用户提供高压缩存储能力、丰富时序查询能力、实时流处理能力,同时具备数据的高可用和集群的高扩展性,并在安全层面提供全方位保障。同时 IoTDB 还为用户提供多种应用工具,方便用户配置和管理系统;多语言API和外部系统应用集成能力,方便用户在 IoTDB 基础上构建业务应用。
-
时序数据标准文件格式(Apache TsFile):该文件格式是一种专为时序数据设计的存储格式,可以高效地存储和查询海量时序数据。目前 IoTDB、AINode 等模块的底层存储文件均由 Apache TsFile 进行支撑。通过 TsFile,用户可以在采集、管理、应用&分析阶段统一使用相同的文件格式进行数据管理,极大简化了数据采集到分析的整个流程,提高时序数据管理的效率和便捷度。
-
时序模型训推一体化引擎(IoTDB AINode):针对智能分析场景,IoTDB 提供 AINode 时序模型训推一体化引擎,它提供了一套完整的时序数据分析工具,底层为模型训练引擎,支持训练任务与数据管理,与包括机器学习、深度学习等。通过这些工具,用户可以对存储在 IoTDB 中的数据进行深入分析,挖掘出其中的价值。
-
下面主要围绕这三个核心能力展开测试
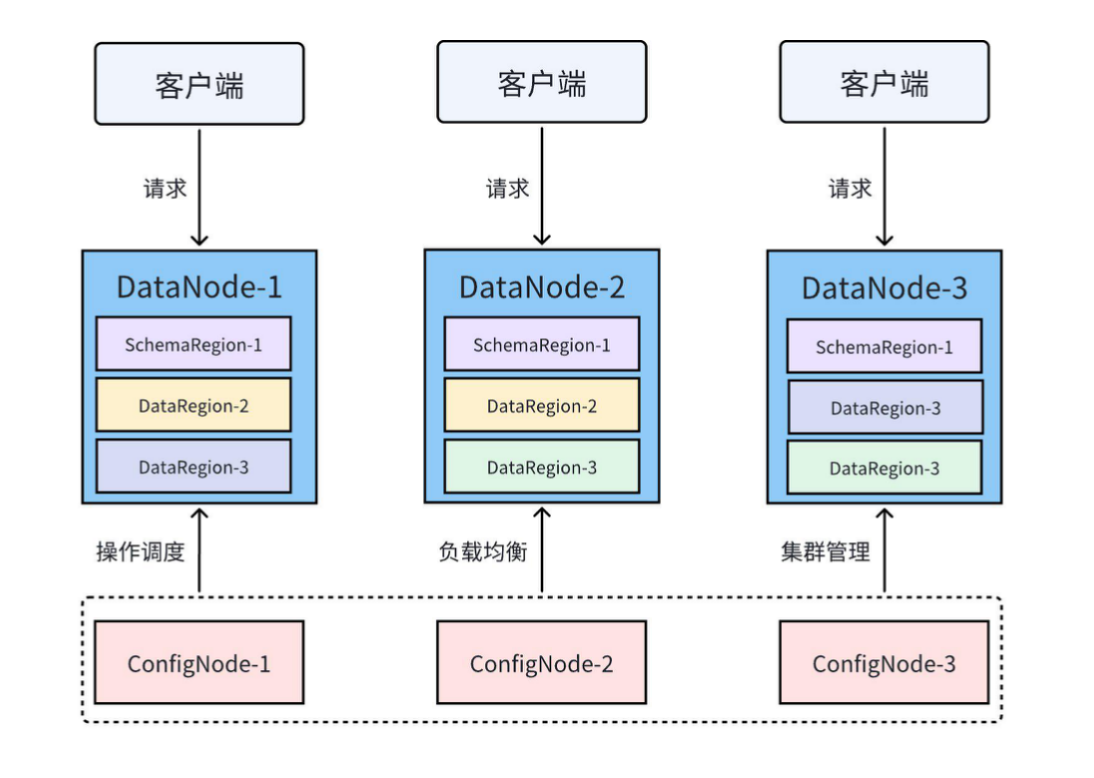
开源安装包下载:
https://iotdb.apache.org/zh/Download/
https://github.com/apache/iotdb
开始使用
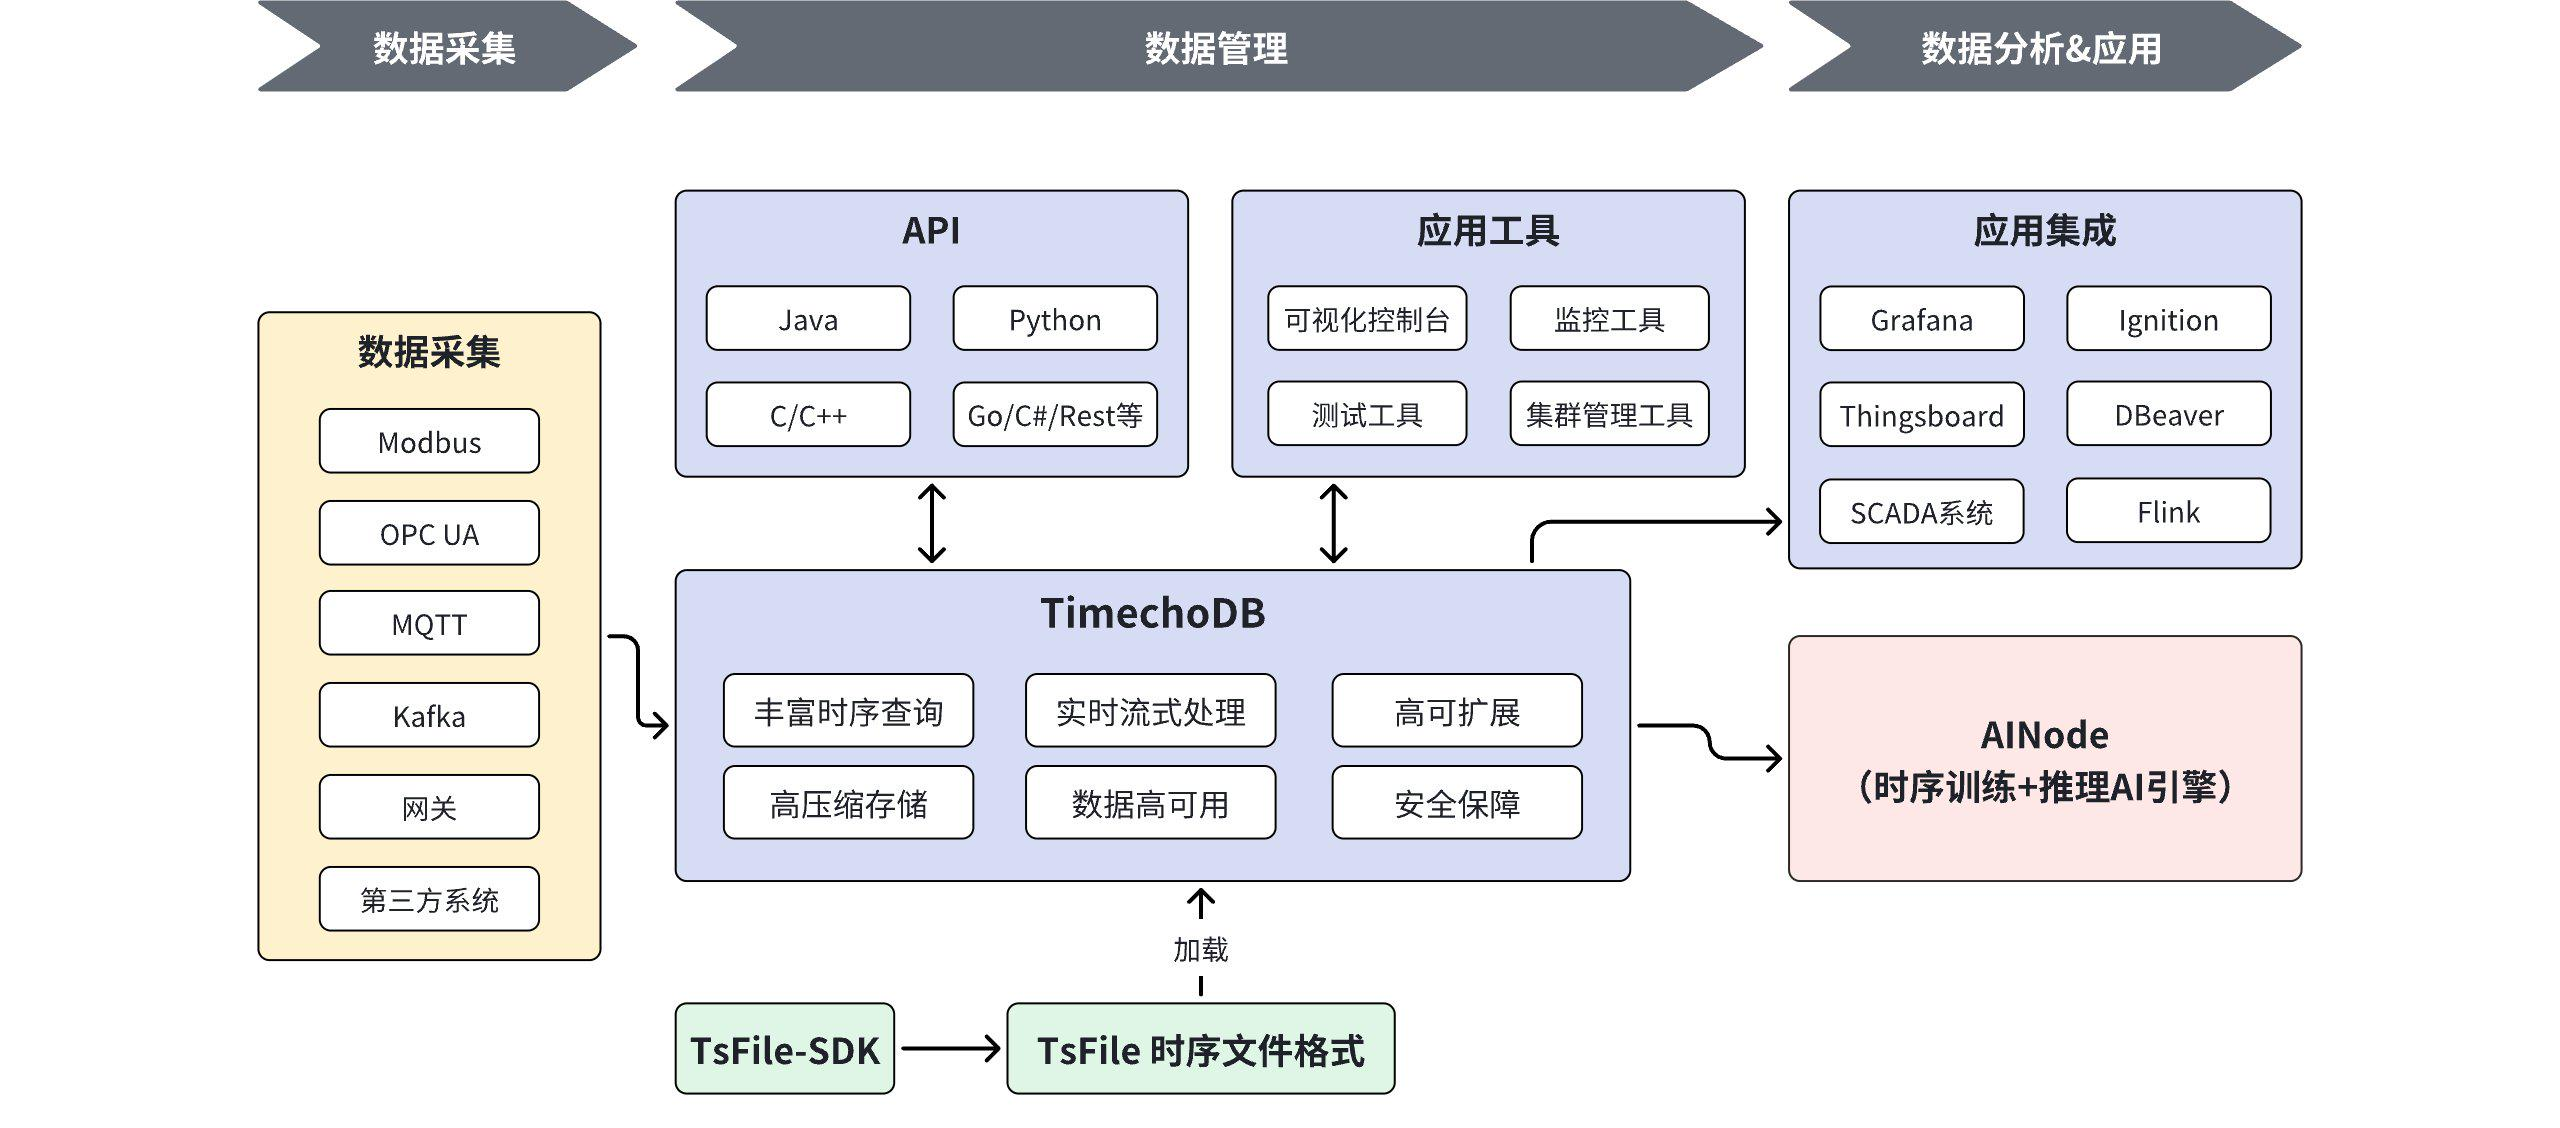
https://thuml.github.io/timer/index_zh.html#body
TimechoDB
运行这个需要java21,但我电脑还有java8的老项目,所以没改环境变量
可以从官方提供的这个链接下载jdk文件https://nas.timecho.com:5001/fsdownload/lI2Ha7XyO/OpenJDK
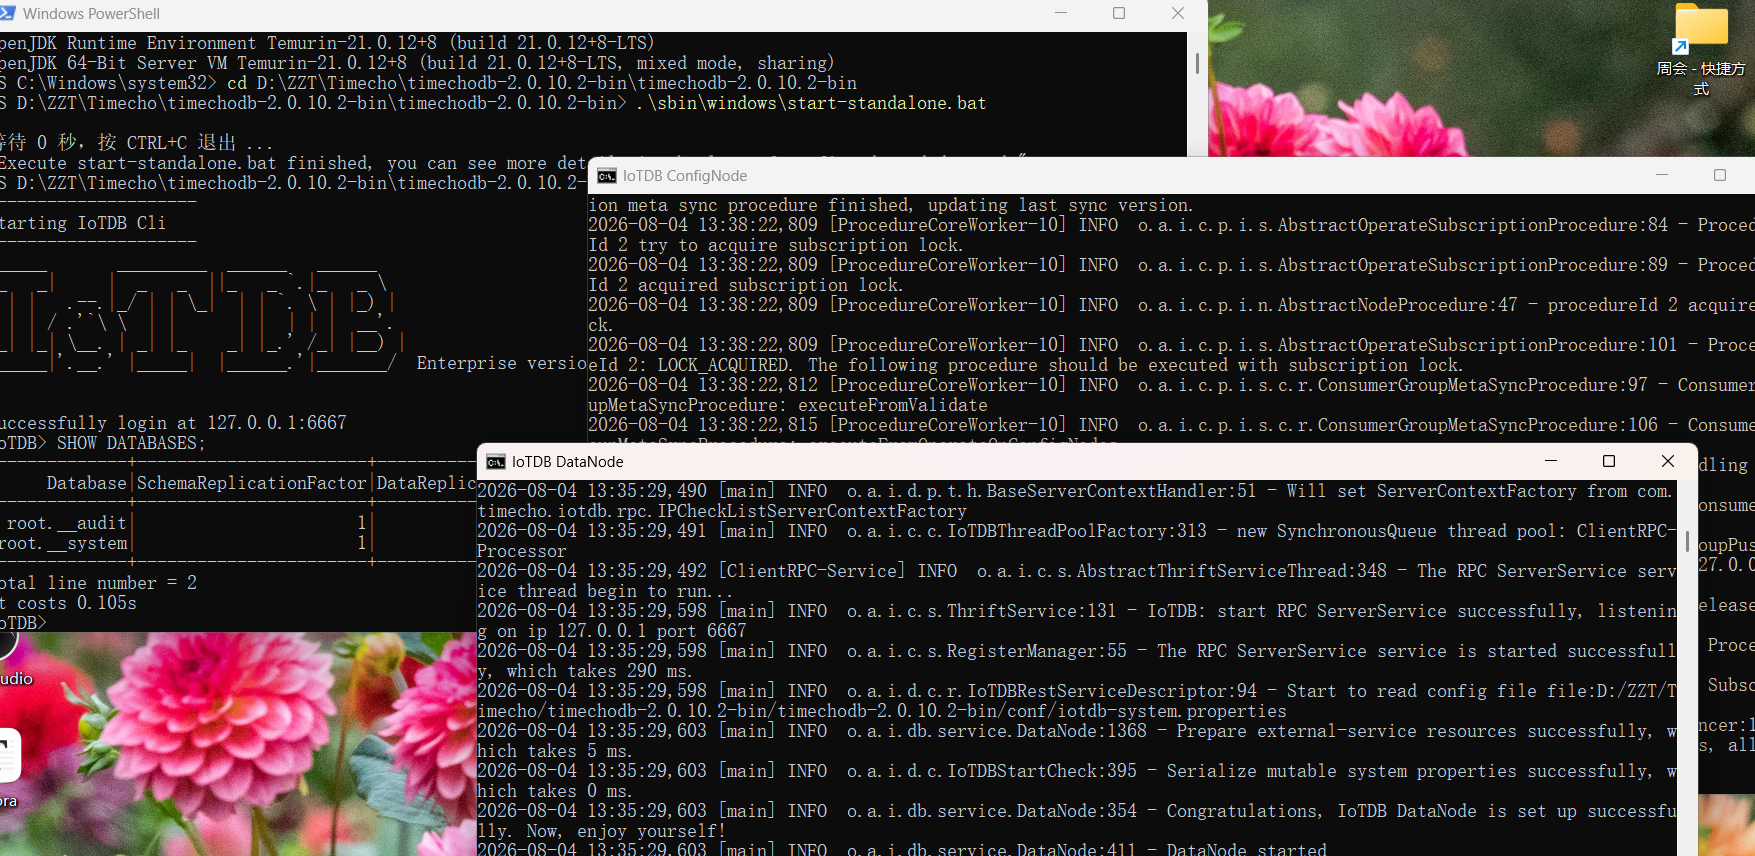
打开一个新的 PowerShell,依次执行:
Plain
$env:JAVA_HOME = "D:\softpath\Java21"
$env:Path = "$env:JAVA_HOME\bin;$env:Path"

java -version
确认显示:
Plain
openjdk version "21.0.12"然后启动数据库:
Plain
cd D:\ZZT\Timecho\timechodb-2.0.10.2-bin\timechodb-2.0.10.2-bin
.\sbin\windows\start-standalone.bat
它会弹出 ConfigNode 和 DataNode 两个命令行窗口。先不要关闭,等待大约 20 秒。
接着在原来的 PowerShell 中运行客户端:
Plain
.\sbin\windows\start-cli.bat看到:
Plain
IoTDB> login successfully
IoTDB>
就说明 TimechoDB 已经成功启动。可以输入:
Plain
SHOW DATABASES;默认连接信息是:
Plain
地址:127.0.0.1
端口:6667
用户名:root
密码:TimechoDB@2021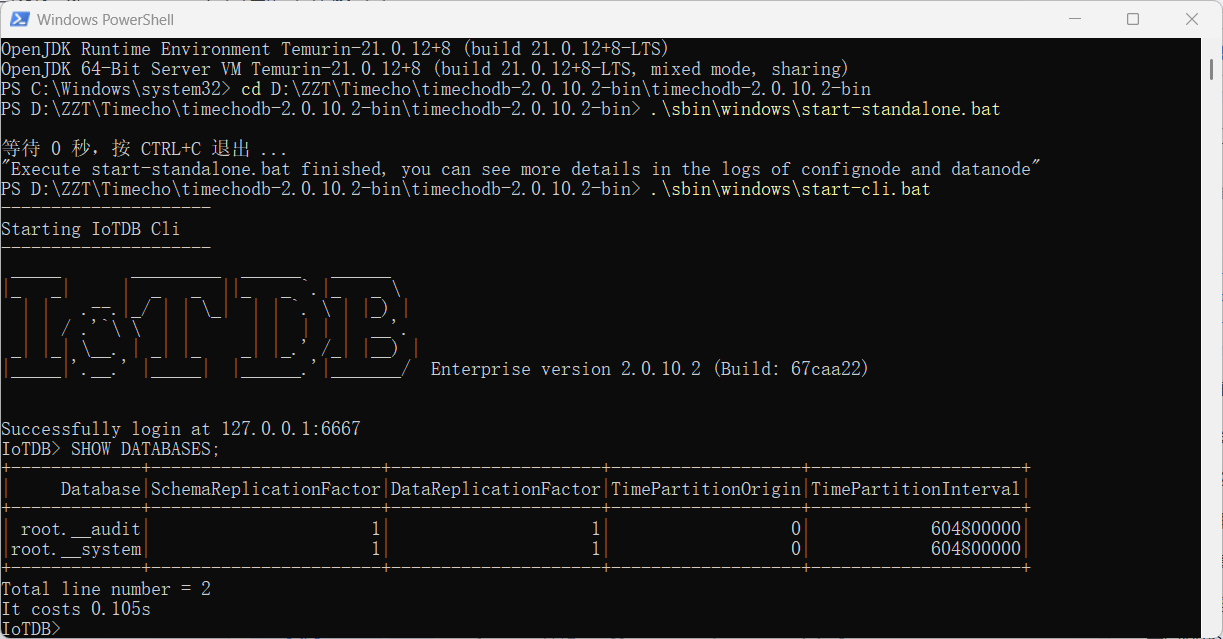
Workbench
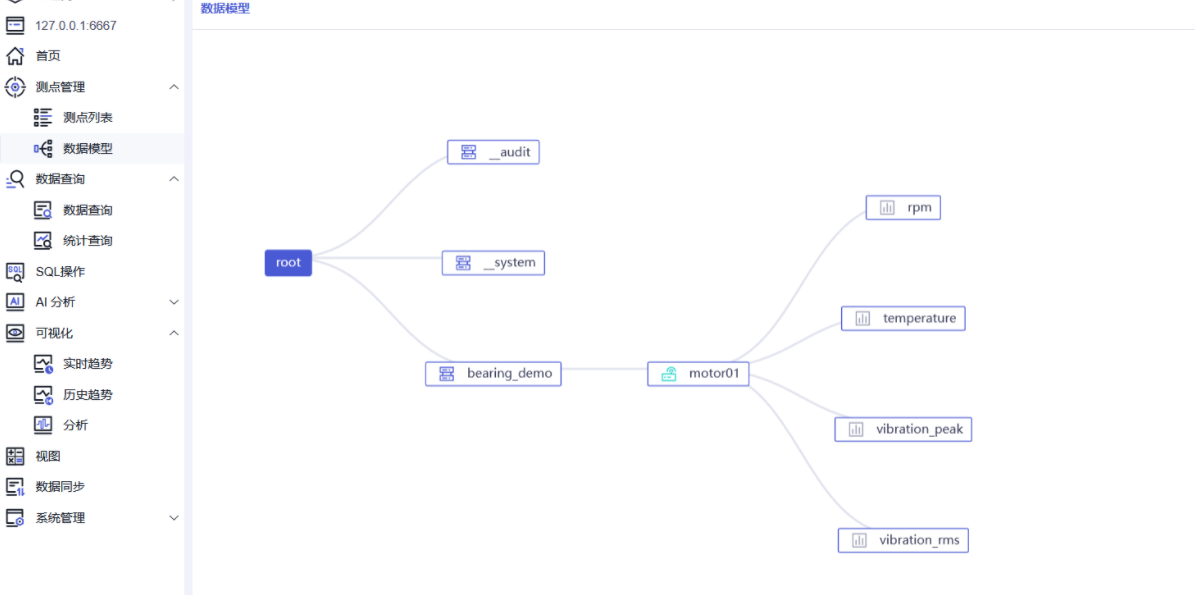
- 这部分说明文档在https://www.timecho.com/docs/zh/UserGuide/latest/Deployment-and-Maintenance/workbench-deployment_timecho.html
- 默认本地端口是9190
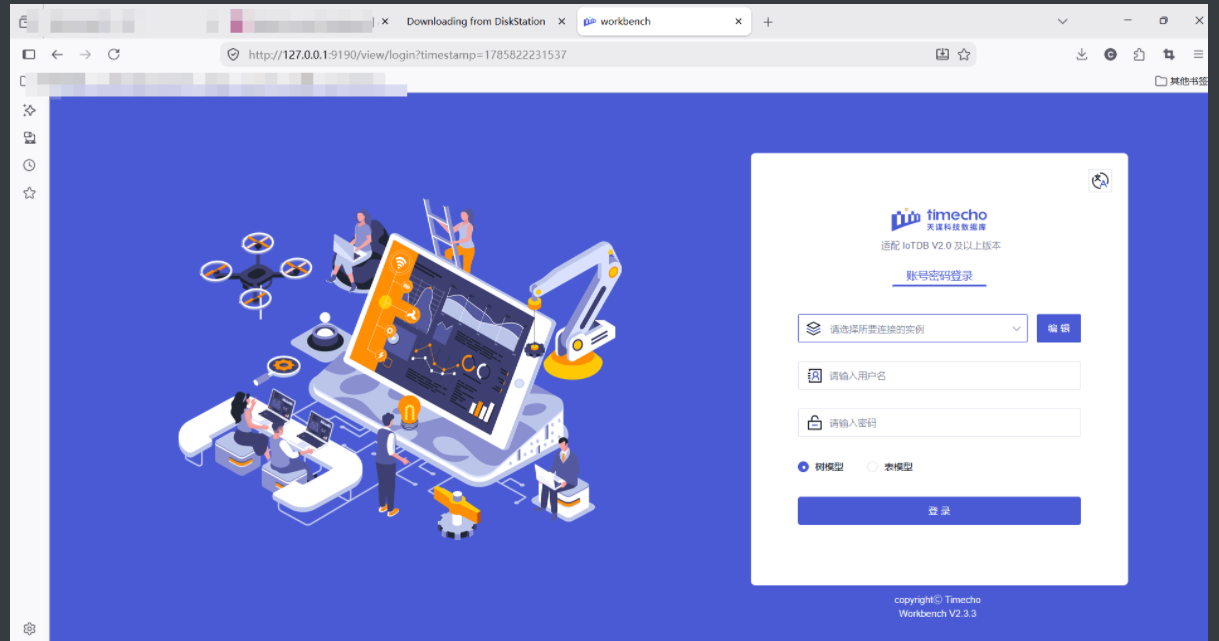
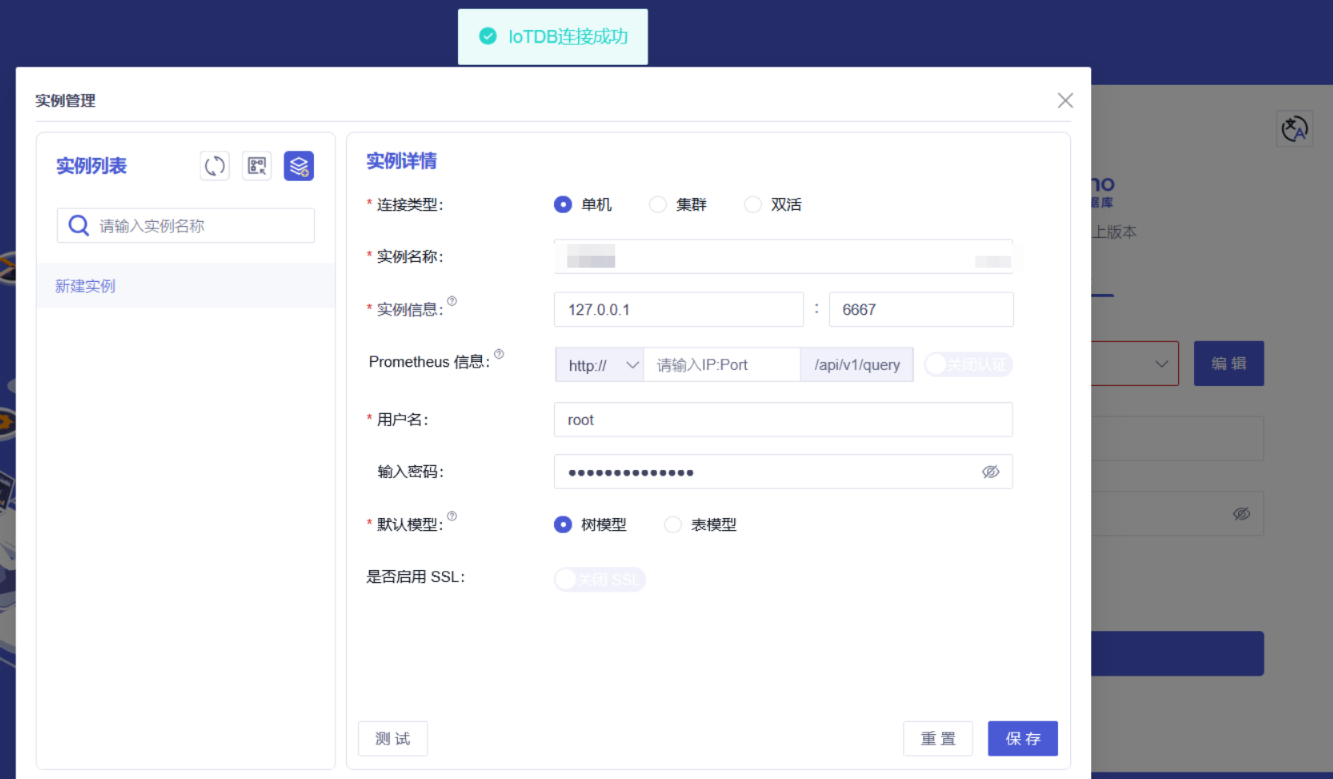
- 登录界面需要连接到现有的时序数据库
TS file Viewer
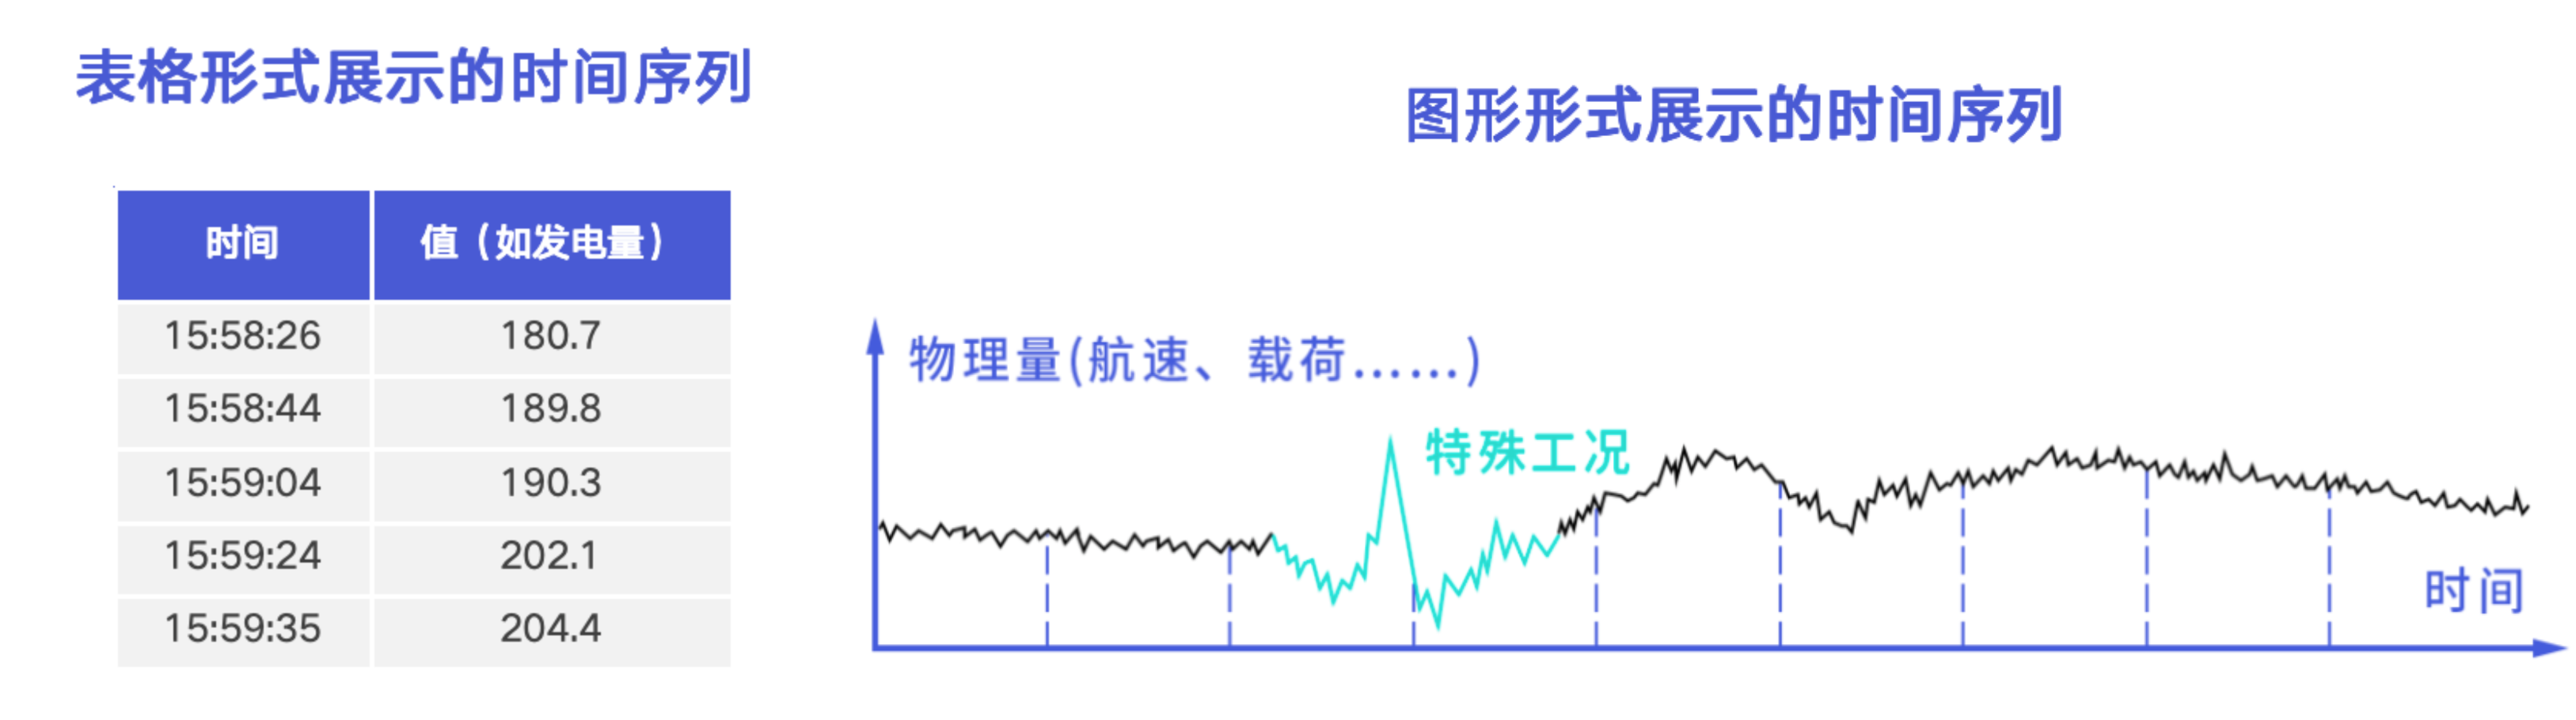
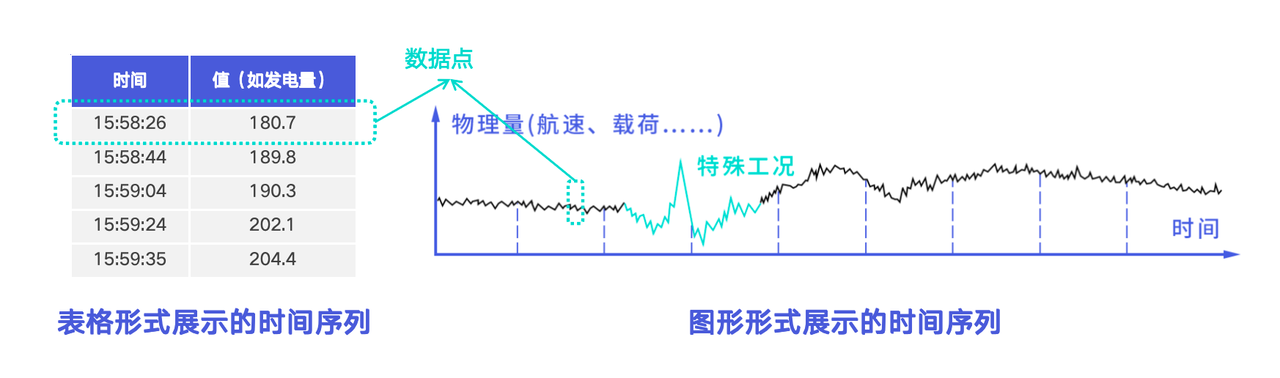
- 这个就是把csv等各种格式的时序数据文件转成tsfile,说是能压缩30多倍
Grafana
https://iotdb.apache.org/UserGuide/latest/Ecosystem-Integration/Grafana-Plugin.html
这个是IOTDB支持的可视化插件
应用场景
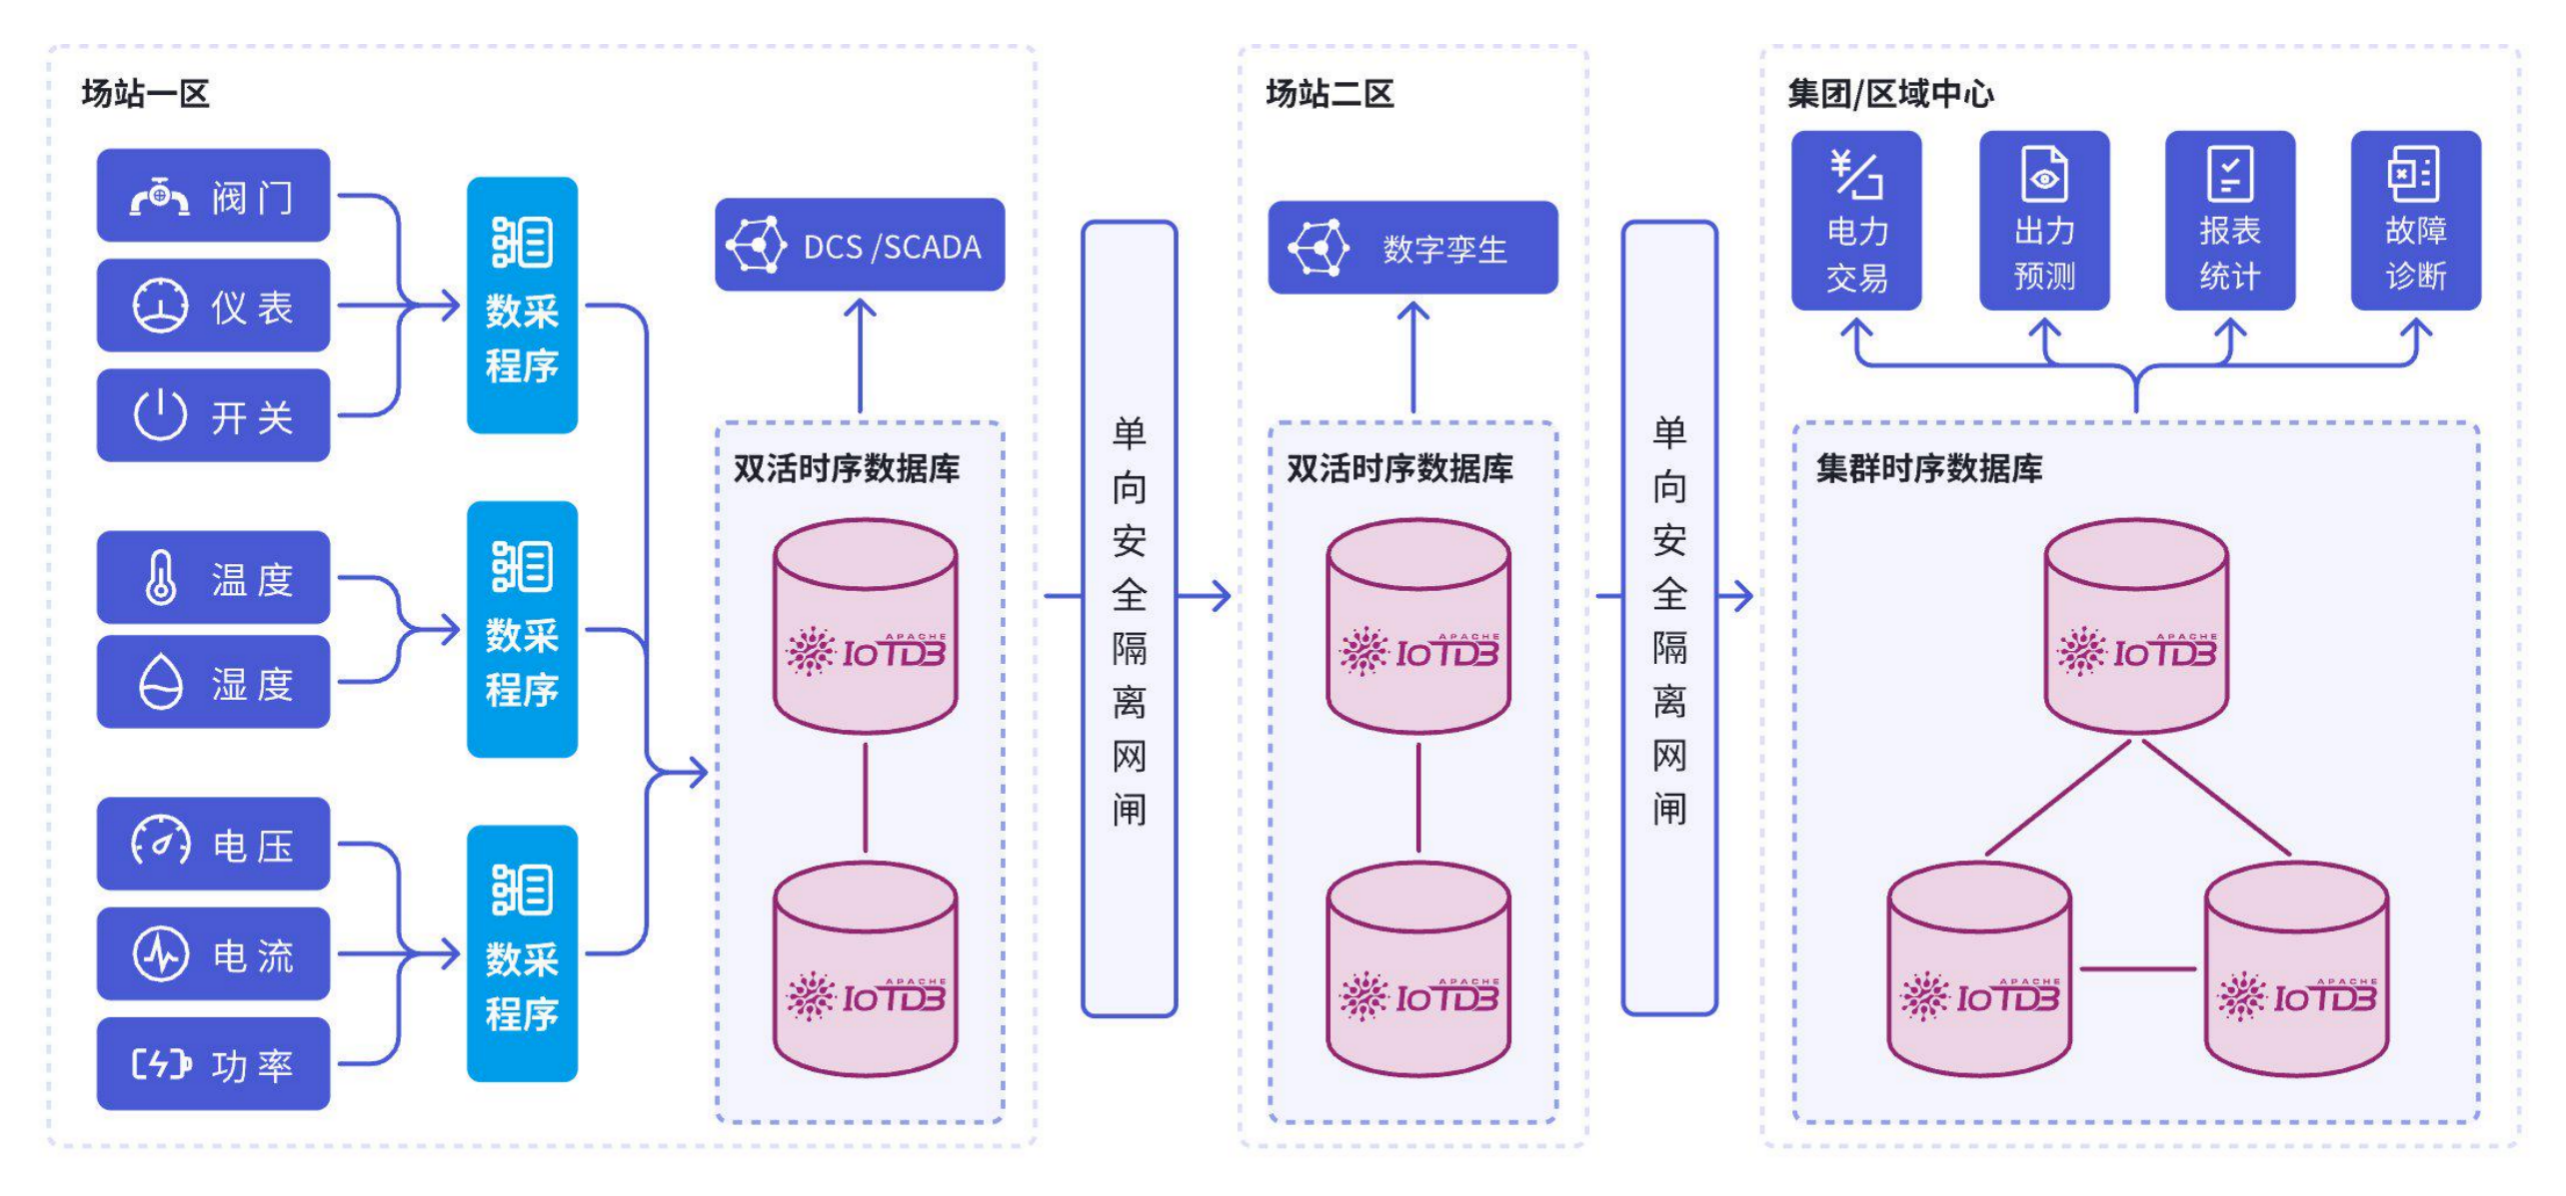
- 能源电力
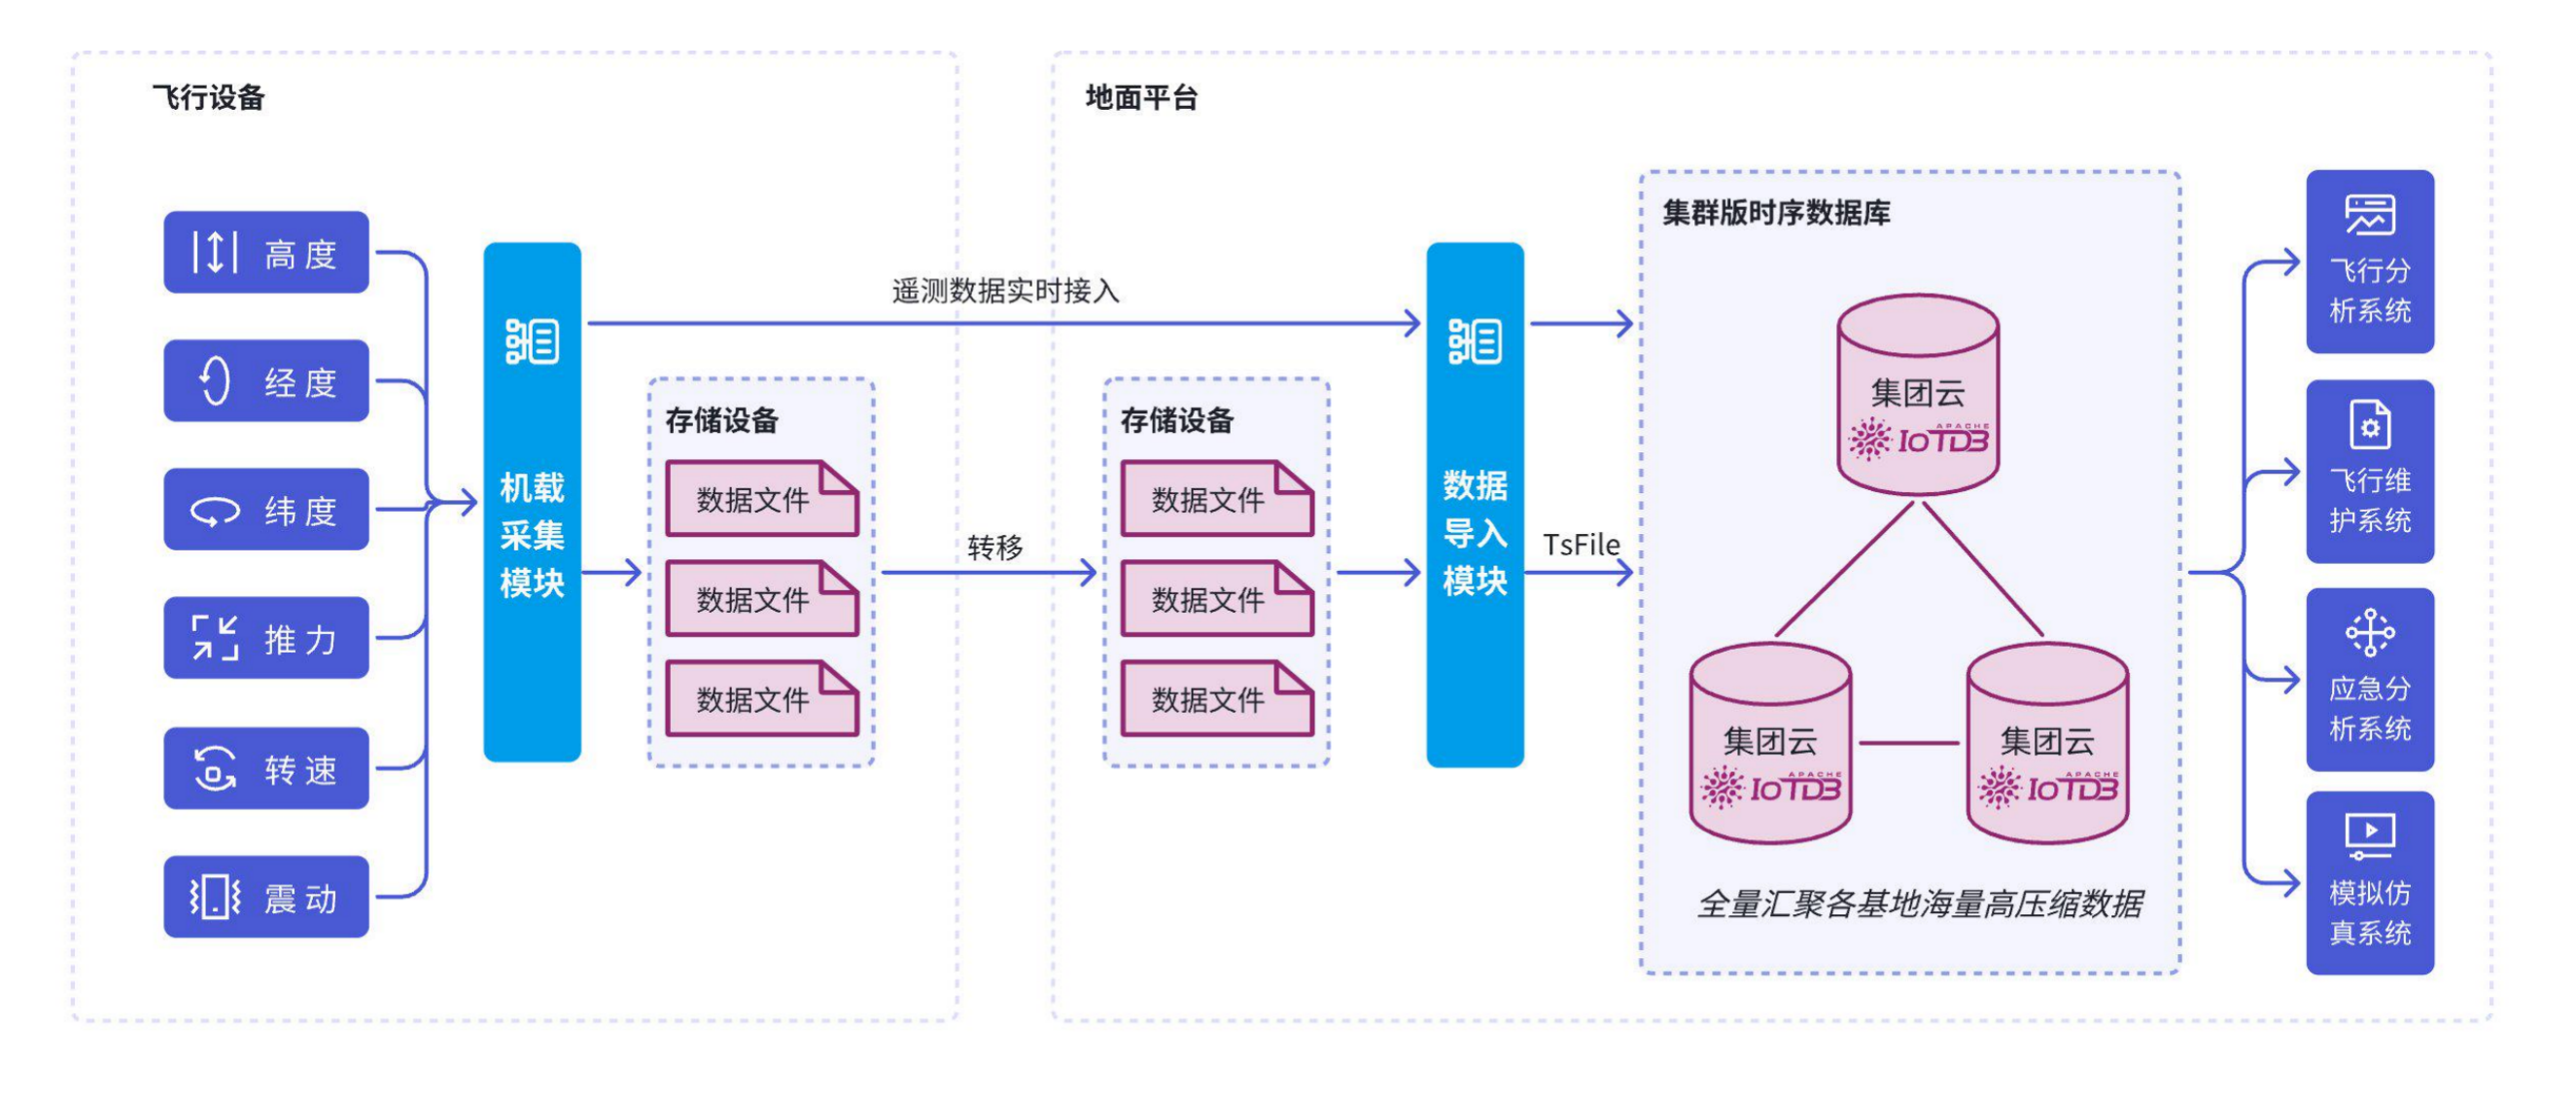
- 航空航天
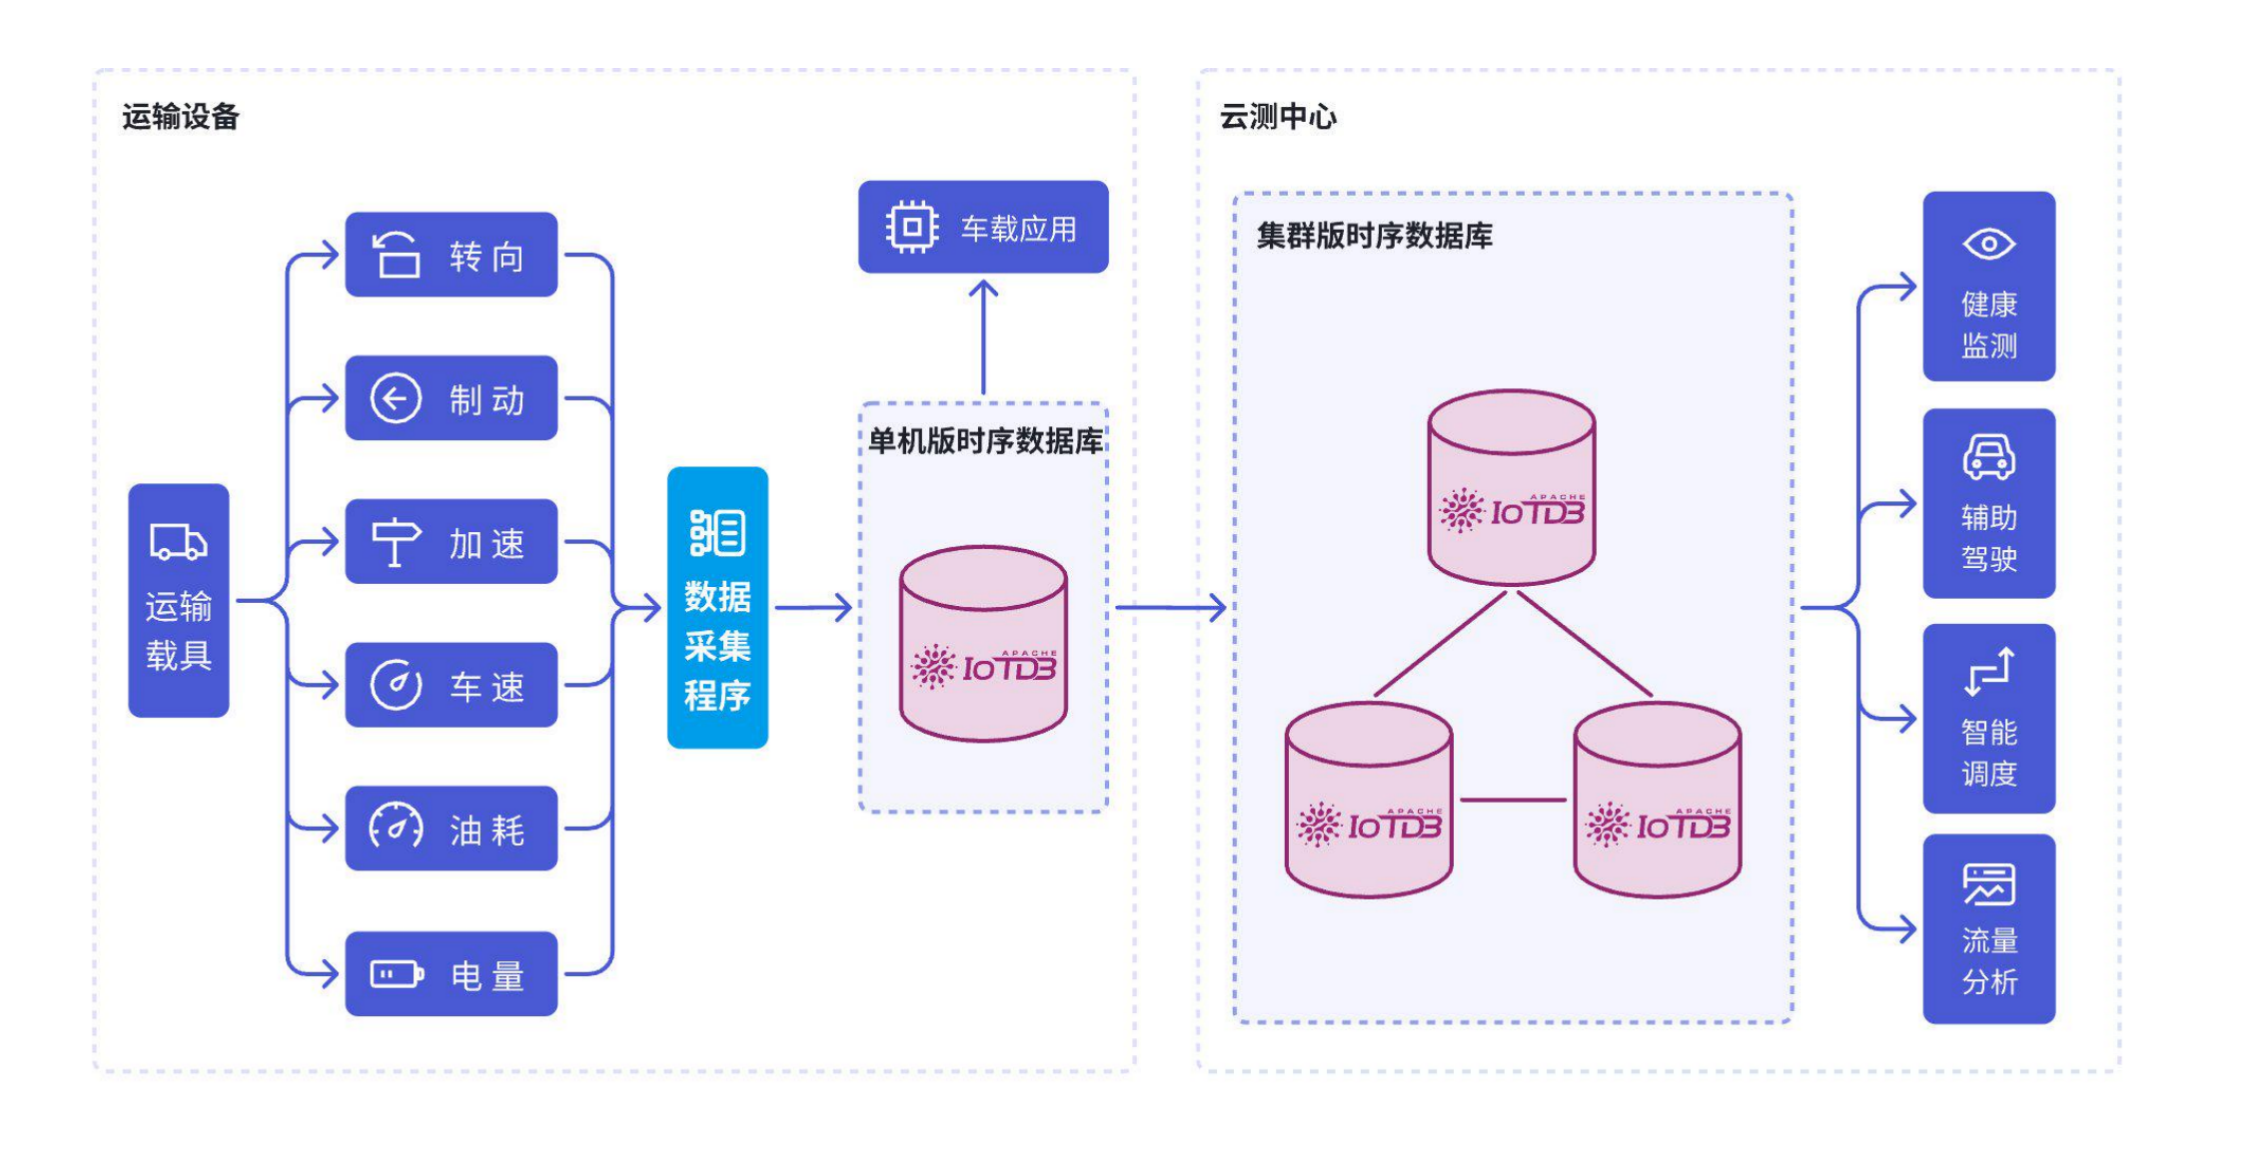
- 交通运输
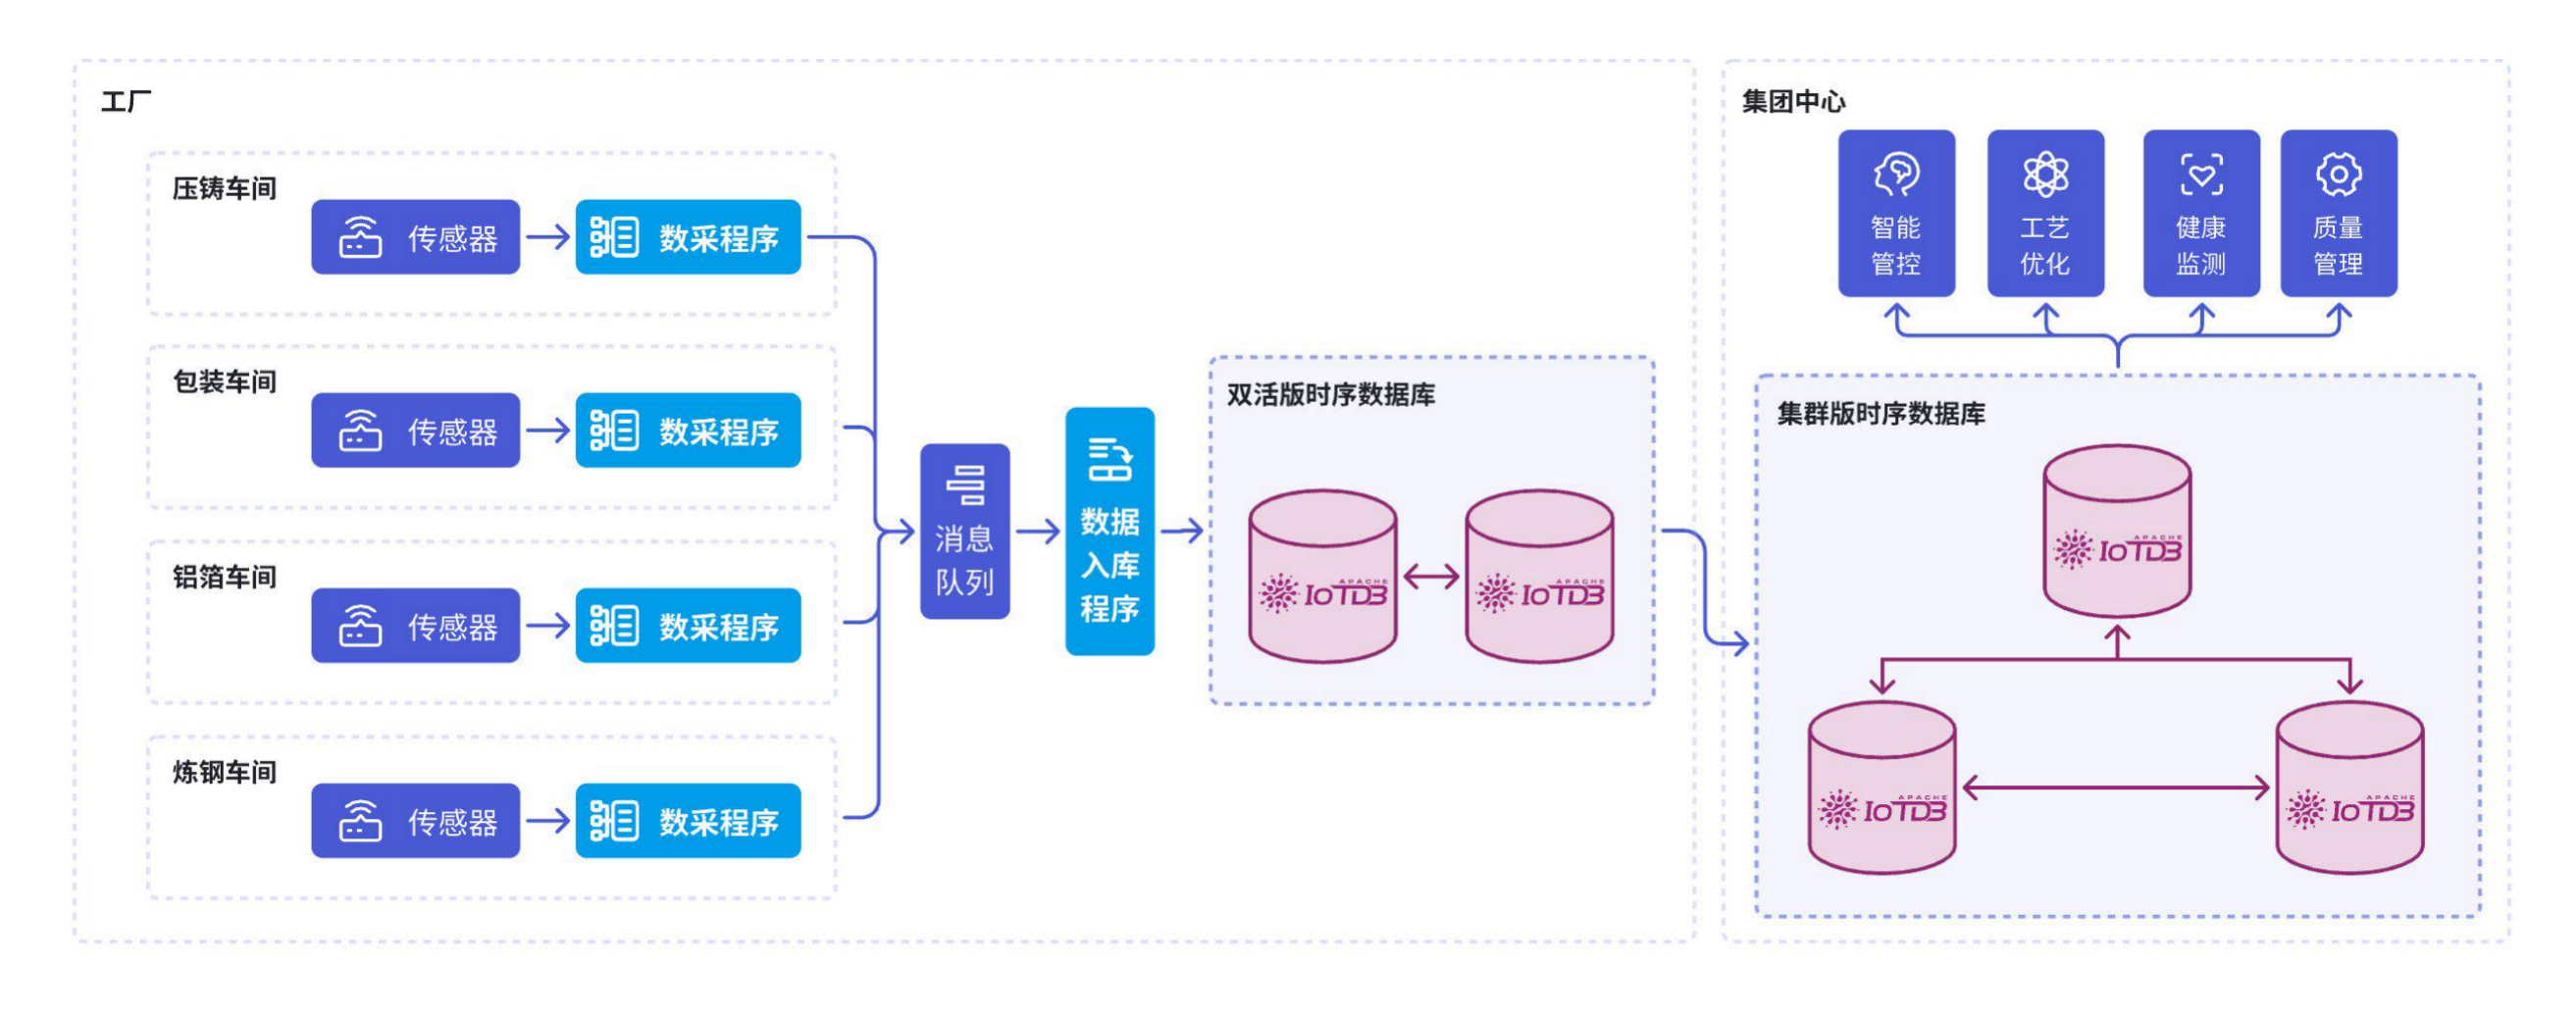
- 智慧工厂
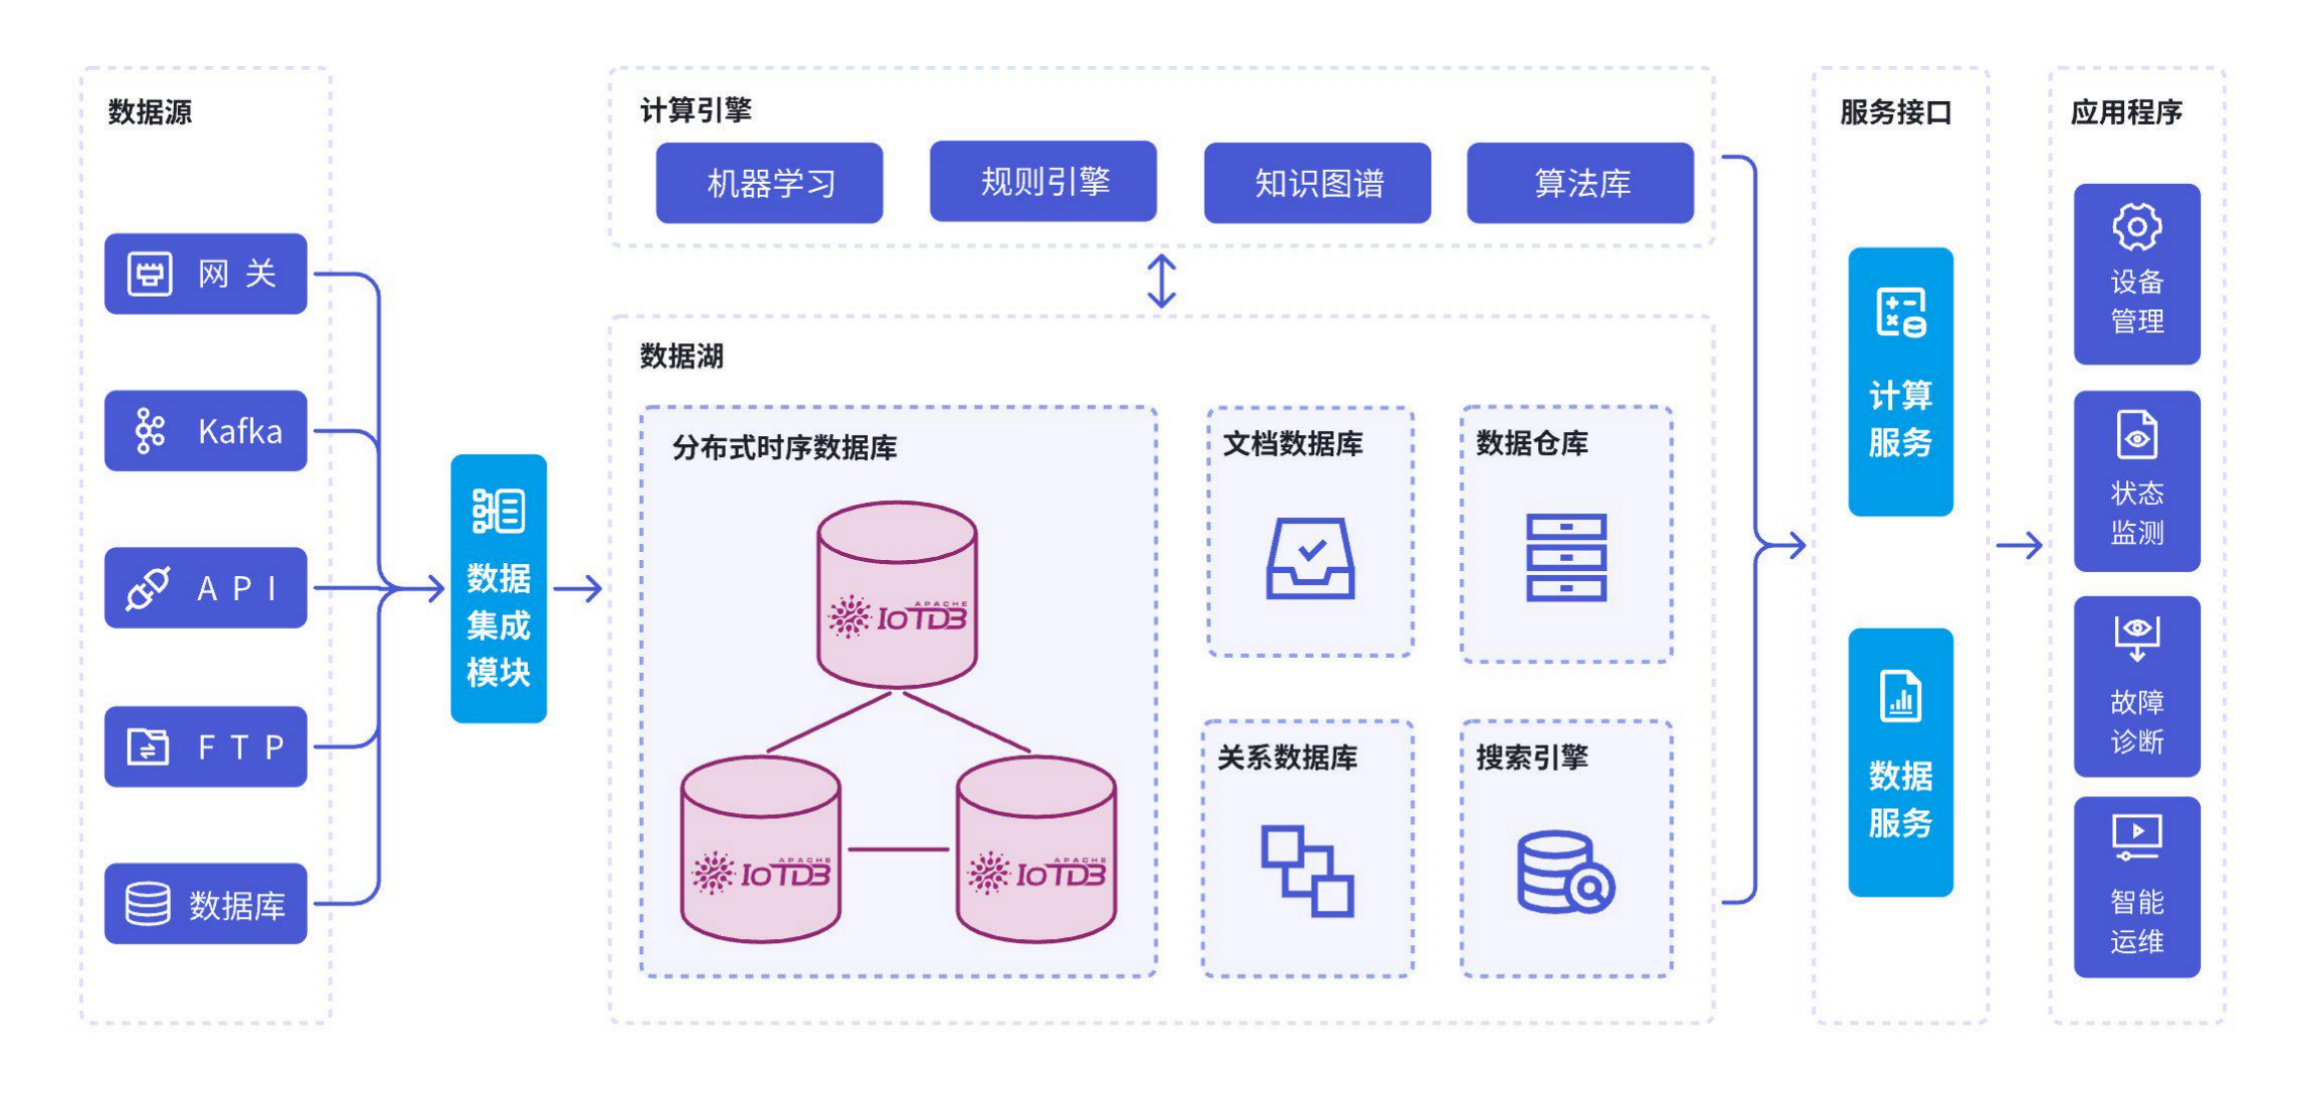
- 物联网
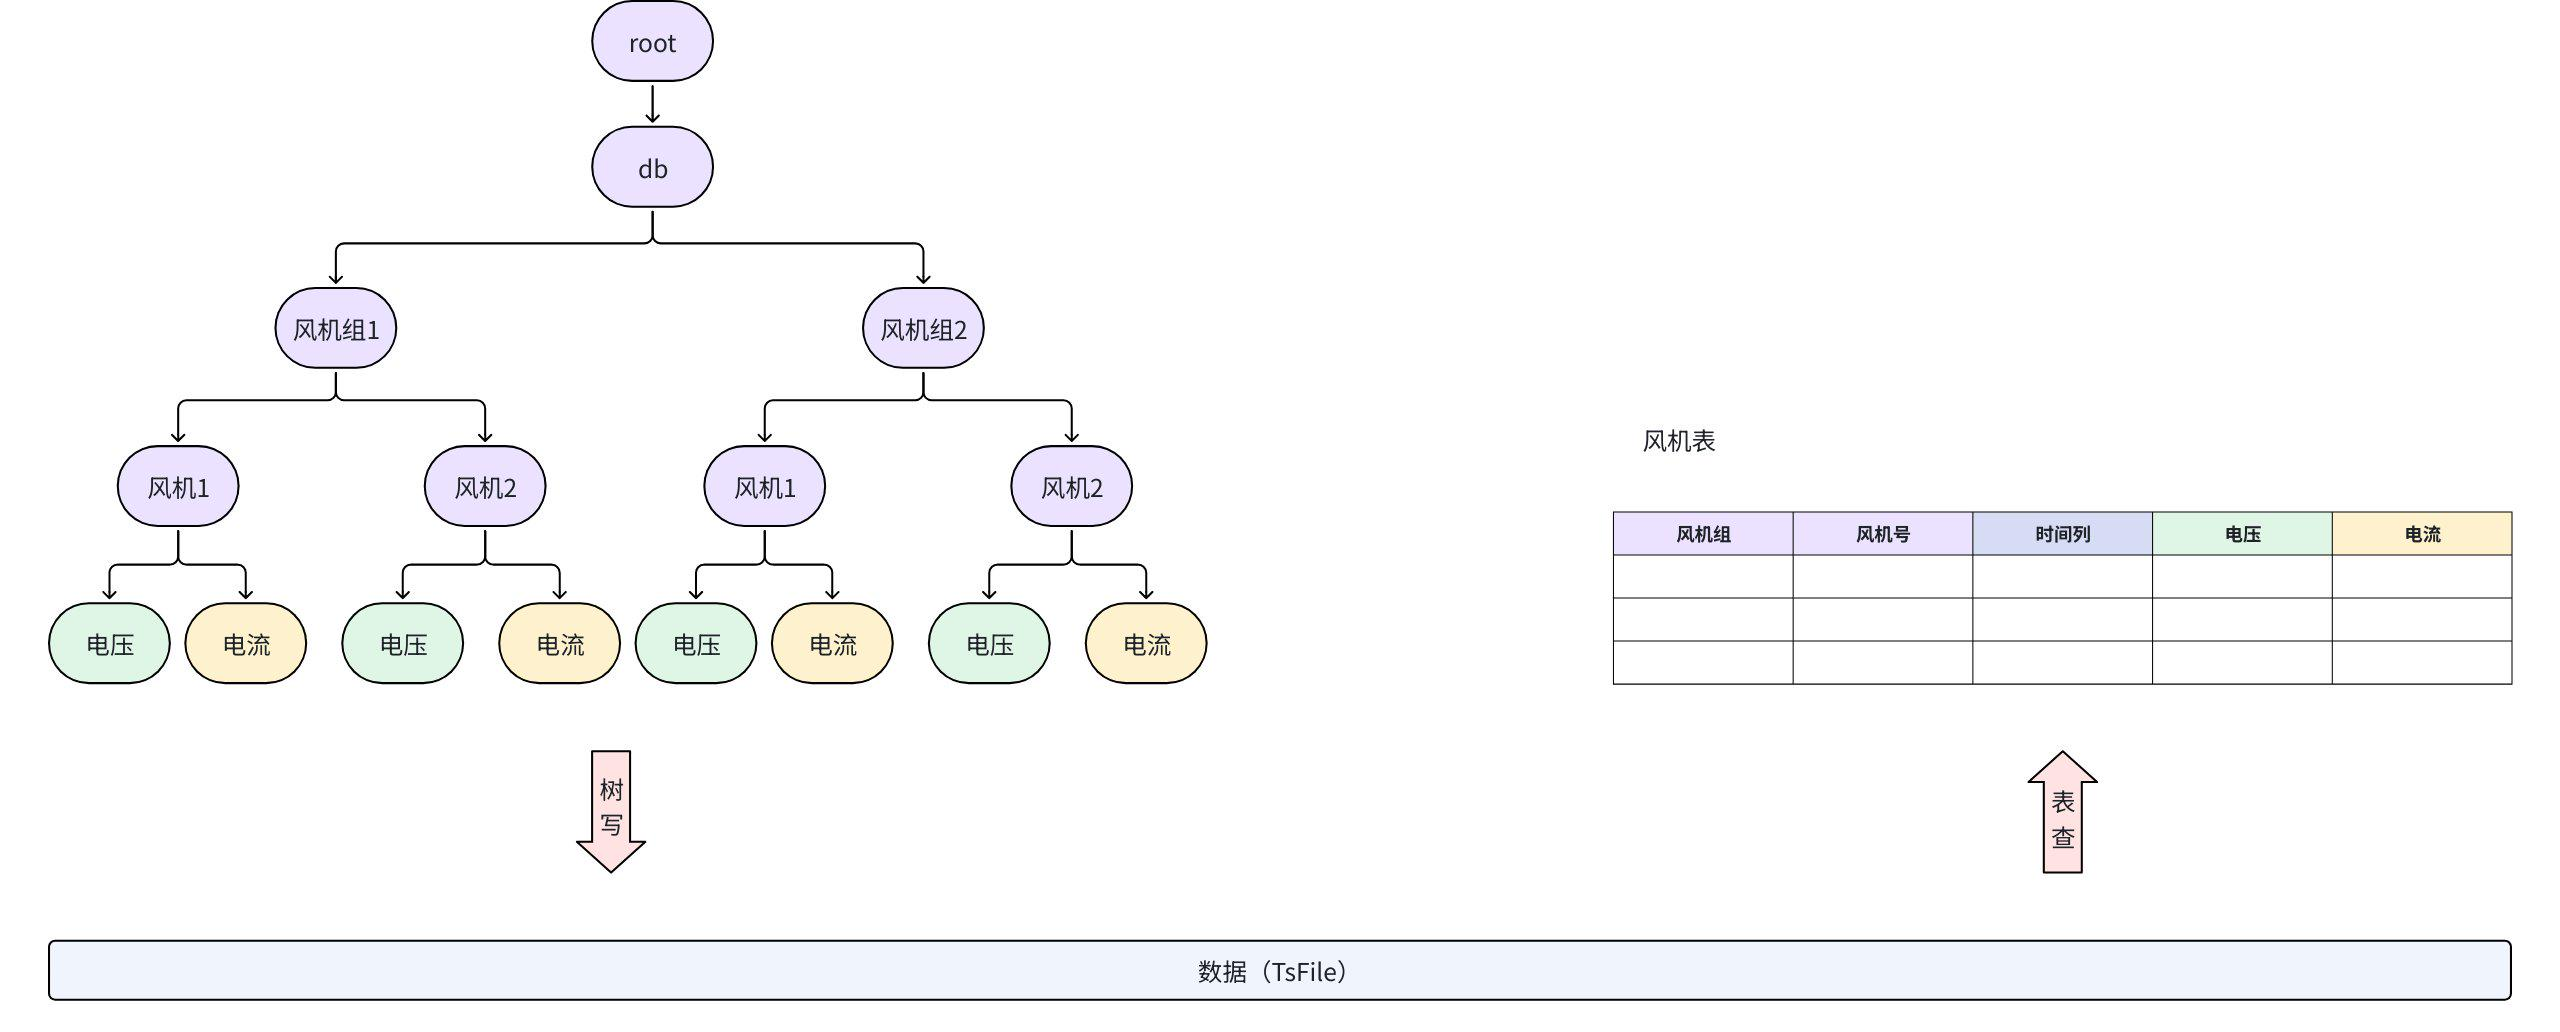
- 树模型和表模型
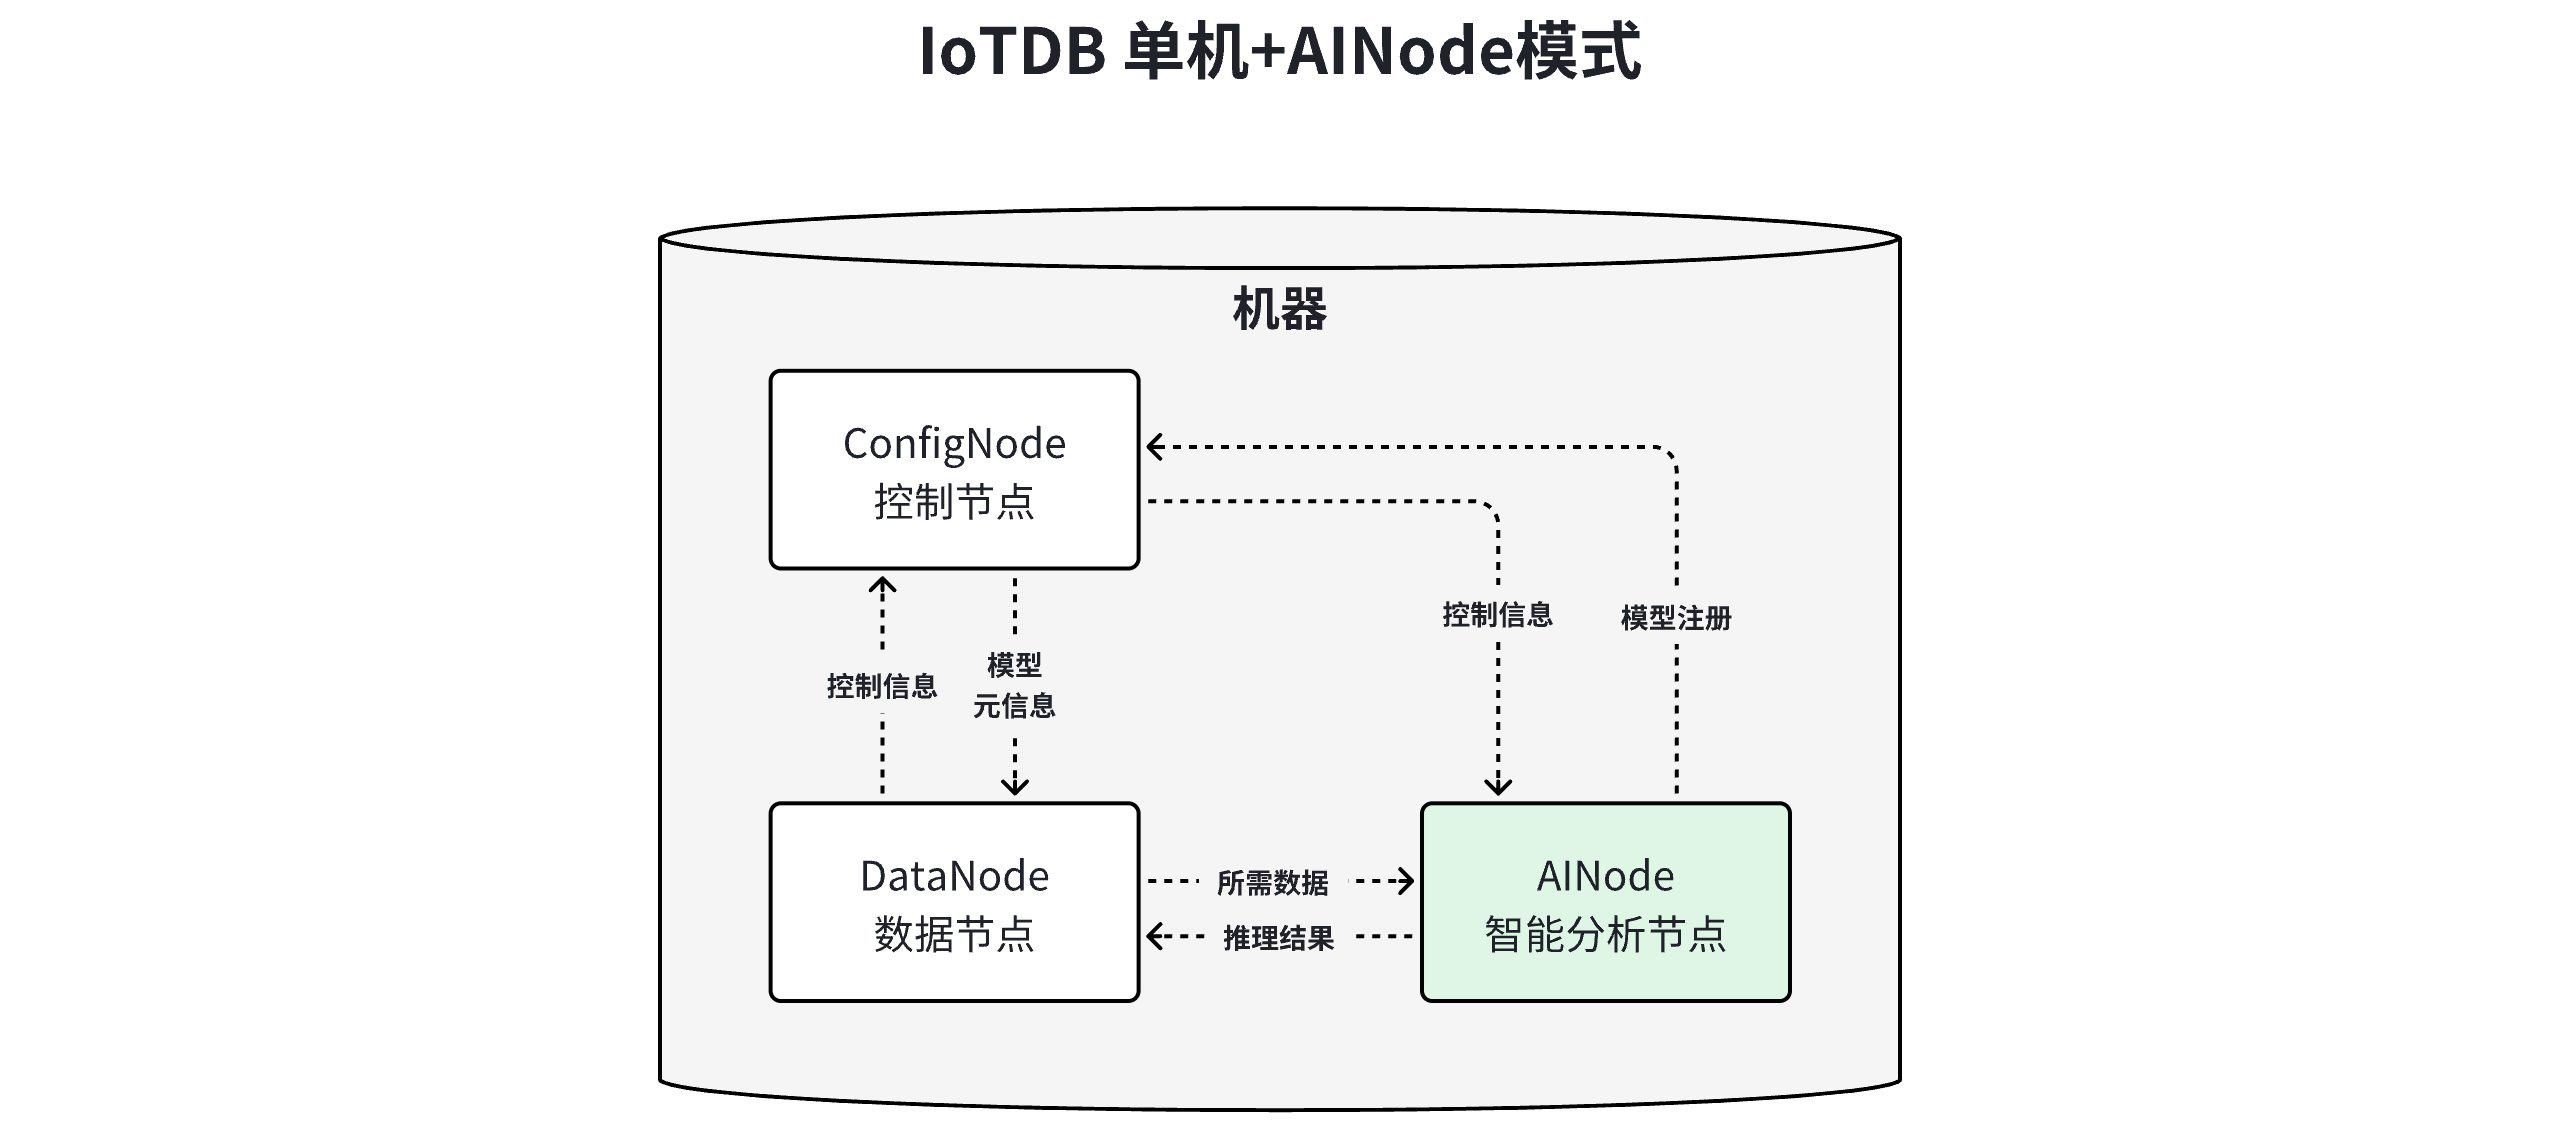
- AI能力
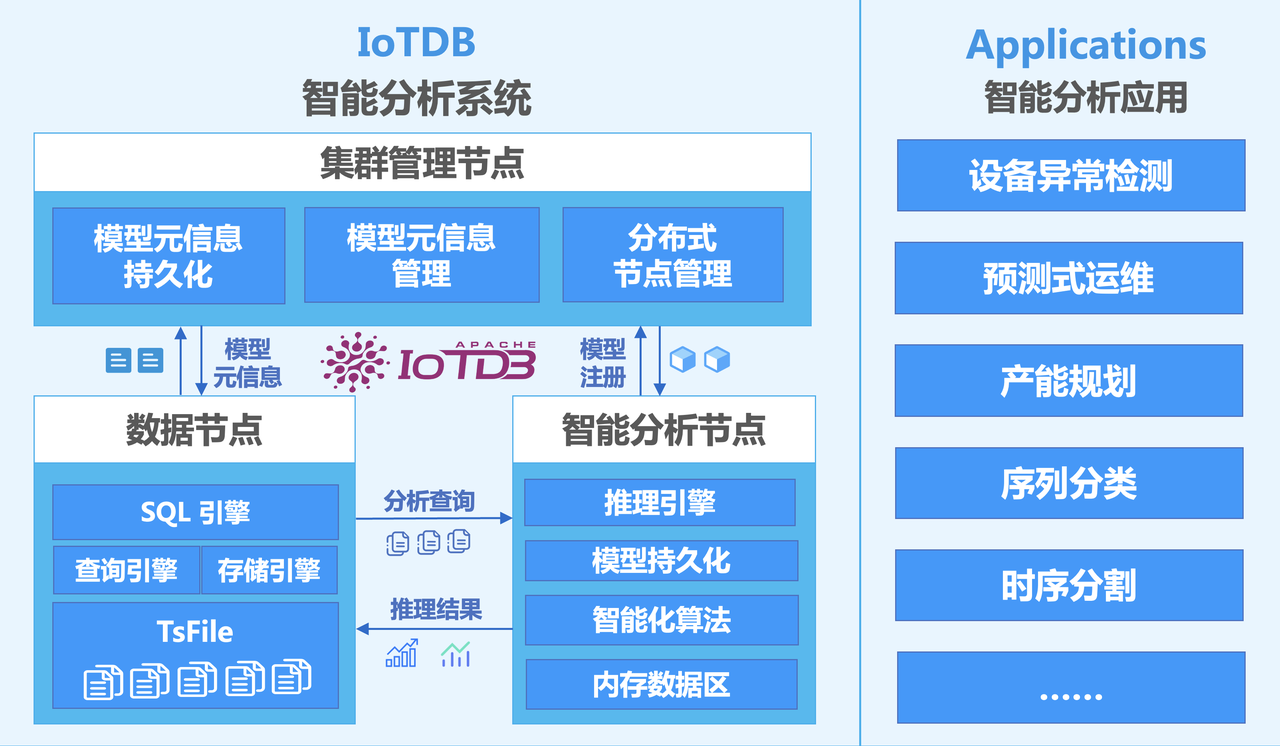
也跟Timecho的售前工程师开会讨论了一下
天谋科技时序数据库及AI产品交流会议纪要
一、会议基本信息
会议主题: 工业设备预测性维护场景及国产时序数据库替换方案交流
参会人员:
- 天谋科技:售前技术团队
会议形式: 线上会议
二、会议概况
本次会议主要围绕工业设备预测性维护场景展开。介绍了现有设备监测业务、数据规模及数据库使用情况,双方重点讨论了以天谋时序数据库替换现有 InfluxDB 的可行性,以及时序数据库、时序大模型与现有预测性维护平台的集成方案。
三、交流内容
现有业务及主要需求
重点需求包括:
- 支持高频时序数据的持续写入和快速查询;支持数据缺失填补、错值修复、降采样和趋势分析;支持单机、双活或集群等不同部署方式;支持现有历史数据迁移;满足国产化、私有化和安全审计要求;后续能够与时序大模型及智能体平台集成。
天谋时序数据库产品介绍
天谋科技介绍了基于 Apache IoTDB 的企业级时序数据库产品。产品面向工业时序数据场景,支持从数据采集、存储、查询分析到运维管理的全流程能力。
主要能力包括:
数据存储方面:
使用 TsFile 作为底层时序文件格式;数据入库时可自动转换为 TsFile,无需业务侧提前转换;支持通过多语言接口离线生成 TsFile;支持文件级迁移,便于边缘端与中心端之间传输数据;通过列式存储和压缩编码降低存储空间占用。
对方介绍,TsFile在部分场景下可实现约5~30倍的空间节省,并提高数据访问和传输效率,实际效果需结合数据特征进行验证。
部署架构方面:
支持单机部署;支持双活部署;支持分布式集群部署;支持端、边、云分层部署;可根据项目规模、资源条件和高可用要求选择部署模式。
数据处理方面:
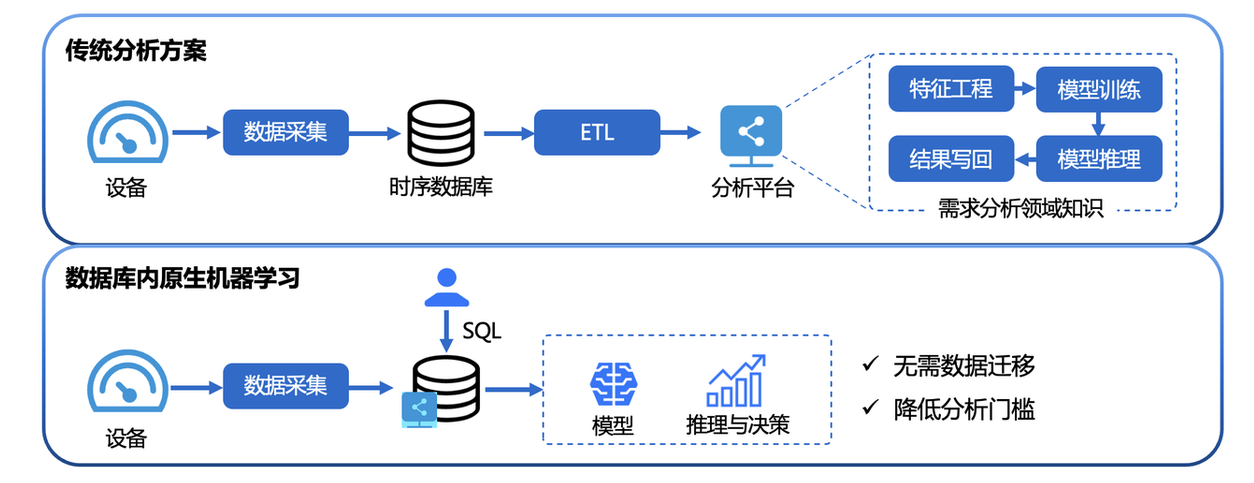
支持数据降采样;支持缺失值填补;支持异常值和错值修复;支持按SQL条件搜索上升、下降等趋势区间;支持基于样本曲线进行时序模式匹配;支持OT场景的树模型和IT场景的表模型。
会议中明确,趋势搜索主要针对时序曲线形态和变化模式,并非传统知识库中的语义RAG检索。
安全及运维方面:
企业版提供白名单、安全审计、系统管理、集群运维及生态集成等相关能力,可用于企业级私有化环境。
数据迁移与系统替换
双方重点讨论了从现有 InfluxDB 向天谋时序数据库迁移的可行性。
对方表示,数据写入数据库后会自动转换为 TsFile格式,外部系统不需要直接操作底层文件格式。对于已有CSV或其他格式数据,可通过导入工具或多语言接口进行转换和迁移。
后续试用阶段需要重点验证:
现有数据模型如何映射到IoTDB;现有查询语句和接口的改造范围;Java及Python程序的接入方式;历史数据导入效率;高频振动数据的写入和查询性能;现有平台切换数据库后的兼容性;数据迁移期间对线上业务的影响。
时序大模型及AI能力
天谋科技介绍了时序数据库与时序大模型平台的整体产品体系,可支持:
数据集构建;模型训练;模型版本管理;在线推理;推理任务管理;边缘侧模型部署;时序数据库与AI平台联合使用。
训练后的模型可作为AI节点部署,用于实时或周期性推理。数据库侧还可通过MCP、Skill等方式与智能体系统集成,为智能问答和自动分析提供数据能力。
应用案例
对方介绍了产品在钢铁、核聚变、石油天然气、储能、航天及船舶等行业的应用情况,主要用于海量工业时序数据的存储、同步、分析和边云协同。
会议中提到的案例包括:
宝武钢铁;核聚变相关项目;中石油;国家管网;储能电站;航天及船舶等工业项目。
其中,国家管网案例采用双活及分层存储架构,以满足生产现场与办公网络之间的数据同步和高可用需求;储能场景重点体现了时序文件压缩和大规模数据同步能力。
具体性能指标及适用条件,后续需结合官方资料和实际试用结果进一步确认。
四、初步结论
-
天谋时序数据库在国产化适配、高频时序数据存储、分布式部署、数据压缩及工业数据处理方面,与现有预测性维护业务具有较高匹配度。
-
产品具备替换现有 InfluxDB 的基础条件,但仍需通过试用验证现有数据模型、接口、查询逻辑和历史数据迁移成本。
-
数据缺失填补、错值修复、趋势搜索及模式匹配等功能,可用于提升工业监测数据的预处理和分析效率。
-
时序大模型平台能够覆盖数据集、训练、推理和模型管理流程,可作为现有异常预警算法和Dify知识库智能体的补充。
-
建议先选择部分设备和典型测点开展小规模验证,再评估数据库全面替换及AI能力集成。